Prendete uno stream di contenuto che un generatore di report potrebbe scrivere, BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET, e togliete il 1 0 0 1 0 0 Tm perché i suoi sei numeri scandiscono la matrice identità. Renderizzate il risultato e "Total" non comincia più dall'origine dello spazio testo. Comincia dove "Invoice" è finita, sulla stessa baseline. Un Tm identità è ridondante solo finché la matrice di testo e la matrice di riga di testo tengono già l'identità: subito dopo BT, o subito dopo un altro Tm identità
La cancellazione è allettante perché gli stessi sei numeri sono davvero peso morto davanti a un cm. Un ottimizzatore di content stream che tratta i due operatori allo stesso modo rimpicciolirà parecchi stream correttamente. Poi incontra un generatore che usa un Tm identità come ritorno di carrello, e il testo si sposta
Perché 1 0 0 1 0 0 Tm non è sempre un no-op?
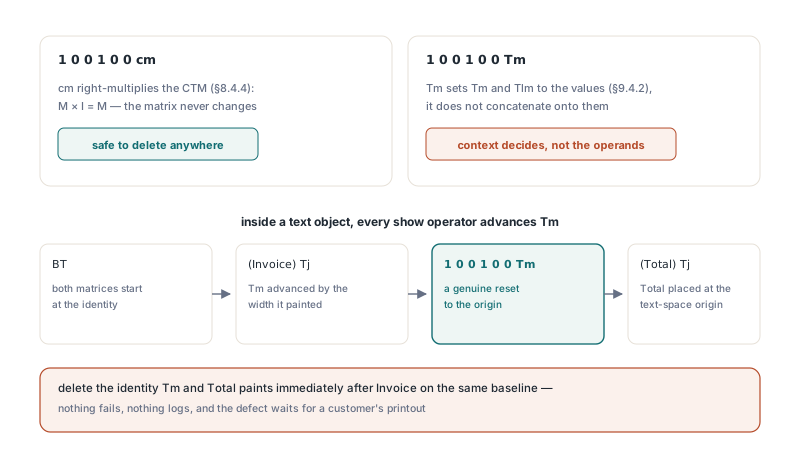
I due operatori fanno aritmetica diversa. ISO 32000-1 §8.4.4 definisce cm come concatenare il suo operando con la matrice di trasformazione corrente; moltiplicate qualsiasi matrice per l'identità e vi ritorna la stessa matrice, così 1 0 0 1 0 0 cm può essere cancellato ovunque appaia. Tm è un assegnamento. Sotto il §9.4.2 imposta sia la matrice di testo sia la matrice di riga di testo ai suoi operandi e butta via ciò che tenevano, quindi se cambia qualcosa dipende interamente dagli operatori davanti a lui
Il §9.4.1 dice che BT fa partire entrambe le matrici dall'identità. Da lì, quasi tutto ciò che sta dentro un oggetto testo muove almeno una delle due. Td, TD, T* e un Tm non identità riposizionano la matrice di riga di testo. Ogni operatore di mostrazione testo (Tj, TJ, ' e ") avanza la matrice di testo della larghezza dei glifi che ha appena dipinto, e gli ultimi due cominciano prima una nuova riga. Una volta che uno di quelli è girato, un Tm identità è un vero salto indietro all'origine. Lo stream della fattura qui sopra dipende da quel salto
Tracciare a mano uno stream sistema la questione in fretta. Passate l'esempio della fattura attraverso il tracker di stato di CTM e matrice di testo dei content stream e il registro mostra cm che concatena sulla CTM mentre Tm sovrascrive entrambe le matrici di testo — due regole di aggiornamento diverse nascoste dietro operandi identici
Come PDF Library for Delphi decide quale Tm identità lasciare cadere
PDF Library for Delphi lascia cadere ogni cm identità durante il suo passaggio peephole, e lascia cadere un Tm identità solo quando una scansione all'indietro da quell'operatore raggiunge BT o un altro Tm identità prima di incontrare qualsiasi cosa possa aver mosso le matrici di testo. Il test per "identità" è numerico: l'operatore ha bisogno di esattamente sei operandi numerici uguali a 1, 0, 0, 1, 0, 0, così anche 1.0 0 0 1.0 0 0 Tm qualifica. Camminando all'indietro, la scansione mette ogni operatore che incontra in uno di due gruppi:
- Fermarsi e conservare il Tm:
Td,TD,T*, unTmnon identità,Tj,TJ,',",ET, qualsiasi operatore che il parser non riconosce, o l'inizio dello stream - Passare oltre e continuare a scandire: operatori che non toccano mai la matrice di testo né la matrice di riga di testo, come
Tf,Tc, i setter di colore,gs, gli operatori di marked-content,Doecm
Un Tm identità precedente chiude la scansione a favore della cancellazione sia che l'ottimizzatore lo stia conservando sia che lo abbia già messo in coda per la rimozione. In entrambi i casi ha lasciato entrambe le matrici all'identità, che è lo stesso stato che BT lascia dietro. Ecco perché una fila di tre operatori Tm identità subito dopo BT collassa al nulla
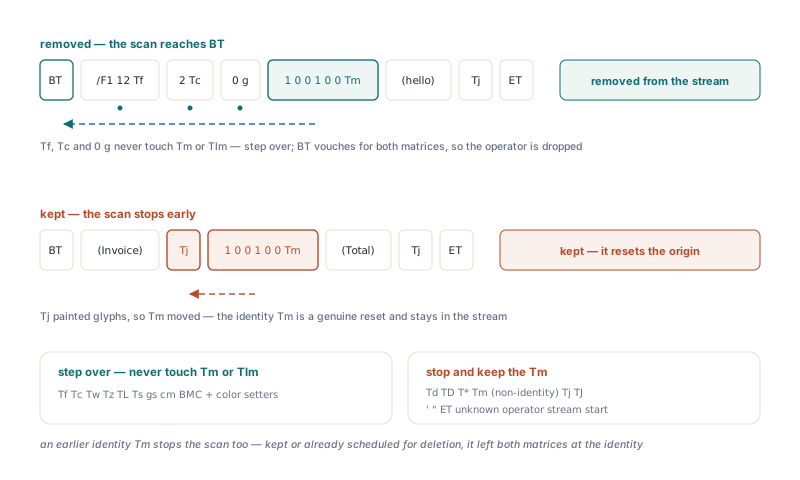
I fermi conservativi sono deliberati. Un operatore sconosciuto potrebbe essere un'estensione vendor che fa qualsiasi cosa, quindi la scansione si rifiuta di ragionare oltre. Dopo ET non c'è alcun oggetto testo aperto, e un Tm identità seduto lì non ha nessun BT che garantisca i valori della matrice. La scansione guarda inoltre uno stream di contenuto alla volta. Questo conta per le pagine il cui /Contents è un array: il PDF lascia che un oggetto testo cominci in uno stream e continui nel successivo, così un layer che si apre in mezzo a un oggetto testo, senza un BT proprio, conserva il suo Tm identità anche quando il layer precedente l'avrebbe reso ridondante
Riteniamo sia il lato giusto su cui sbagliare. Tracciare le matrici attraverso i confini degli stream, o simulare operatori sconosciuti, recupererebbe forse quattordici byte di testo non compresso per file strano. Sbagliare sposta un glifo su una fattura stampata. Il costo e il rischio non sono della stessa lega
Un effetto a catena merita di essere conosciuto perché cambia ciò che vedete nell'output. Lo stesso passaggio rimuove anche gli oggetti testo vuoti dentro, così BT 1 0 0 1 0 0 Tm ET sparisce del tutto: il Tm identità va per primo, e la coppia BT/ET che lascia dietro è vuota
Far girare l'ottimizzatore su uno snippet di content stream
L'ottimizzatore lavora sullo stesso modello TPDFContentProgram parsato che usereste per modificare il testo di pagina a livello di istruzione, come nel passeggiata sulla mappatura carattere-a-byte-di-contenuto. Questo rende facile provare la regola su una stringa prima di fidarvene con un intero documento. L'helper qui sotto parsa uno stream decodificato, fa girare TPDFContentPeepholeOptimizer, ed emette il risultato una istruzione per riga. Impostare CanonicalNumbers prima di Parse rispecchia il passaggio al salvataggio, che riscrive ogni numero a precisione fissa
uses
  PDFlibContentModel, PDFlibContentOptimize;

function OptimizeSnippet(const Source: AnsiString): AnsiString;
var
  Prog: TPDFContentProgram;
  Optimizer: TPDFContentPeepholeOptimizer;
begin
  Result := Source;
  Prog := TPDFContentProgram.Create;
  try
    Prog.CanonicalNumbers := True; // stessa gestione dei numeri del passaggio di salvataggio
    if not Prog.Parse(Source) then
      Exit; // danno strutturale grosso: lasciate in pace i byte
    Optimizer := TPDFContentPeepholeOptimizer.Create(Prog);
    try
      Optimizer.Run; // restituisce il numero di istruzioni rimosse
    finally
      Optimizer.Free;
    end;
    Result := Prog.Emit; // una istruzione per riga, separate da #10
  finally
    Prog.Free;
  end;
end;

// Rimosso: Tm direttamente dopo BT, il secondo di due Tm identità di fila
//   OptimizeSnippet('BT /F1 12 Tf 1 0 0 1 0 0 Tm (hello) Tj ET')
// Conservato: Tm dopo Td, dopo Tj, dopo un Tm non identità, o fuori da BT
//   OptimizeSnippet('BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET')
Fate girare lo stream della fattura attraverso di lui e il Tm identità sopravvive, perché la scansione all'indietro incontra Tj molto prima di raggiungere BT. Mettete /F1 12 Tf, 2 Tc e 0 g tra BT e il Tm identità e va comunque via, dato che nessuno di quelli tocca le matrici di testo. Il caso interessante è BT 10 20 Td 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm. Perde esattamente un operatore. Il primo Tm identità disfa la mossa che Td ha fatto, e solo il secondo è ridondante
Parse restituisce False solo su danni grossolani come una stringa o un dizionario non terminati. Gli operatori sconosciuti parsano bene e restano nel programma, dove fanno da fermi rigidi per la scansione
Quando gira davvero l'ottimizzatore peephole?
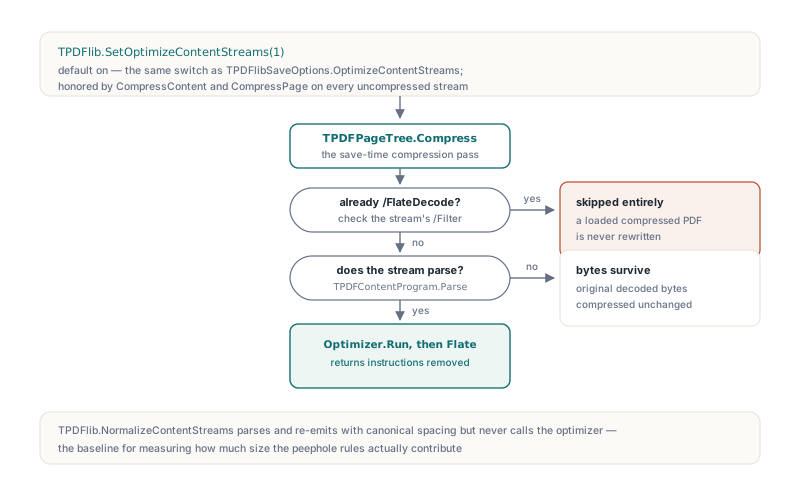
L'ottimizzatore gira solo dentro il passaggio di compressione, e solo sugli stream di contenuto di pagina che non sono già compressi con Flate. TPDFlib.SetOptimizeContentStreams(1) è il default, e lo stesso interruttore appare come campo OptimizeContentStreams di TPDFlibSaveOptions; CompressContent e CompressPage lo onorano entrambi. Uno stream il cui /Filter è già /FlateDecode viene saltato del tutto, quindi caricare un tipico PDF compresso e salvarlo di nuovo lascia i suoi operatori esattamente come erano. Gli stream conservati non compressi vengono decodificati, ottimizzati e poi compressi con Flate. Se uno stream non riesce a parsare, i suoi byte decodificati originali vengono compressi invariati
var
  Lib: TPDFlib;
  Options: TPDFlibSaveOptions;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('report.pdf', '') <> 1 then
      Exit;
    // Gli stream di pagina non compressi passano per le regole peephole, poi Flate
    Lib.SetOptimizeContentStreams(1);
    Lib.CompressContent;
    Lib.SaveToFile('report-optimized.pdf');

    // La stessa scelta tramite le opzioni di salvataggio in bundle; False rinuncia
    Options.CompressContent := True;
    Options.CompressFonts := True;
    Options.CompressImages := True;
    Options.Linearize := False;
    Options.KeepModDate := False;
    Options.OptimizeContentStreams := False;
    Options.GarbageCollect := False;
    Options.PackObjectStreams := True;
    Lib.SaveToFileOptions('report-plain.pdf', Options);
  finally
    Lib.Free;
  end;
end;
Lasciate il default attivo. Ogni trasformazione nel passaggio è equivalente in output, e la regola della matrice identità va dietro a un pattern che molti generatori emettono, aprendo ogni oggetto testo con BT 1 0 0 1 0 0 Tm. Spegnerla ha senso soprattutto quando volete fare il diff del vostro output non compresso contro ciò che avete scritto, o quando vi serve una baseline. Per quella baseline, TPDFlib.NormalizeContentStreams parsa e riemette il contenuto con spaziatura e numeri canonici ma non chiama mai l'ottimizzatore, così il divario di dimensione tra un salvataggio normalizzato e uno ottimizzato è ciò che le regole peephole hanno contribuito. Aspettatevene uno modesto accanto ai guadagni maggiori descritti in ottimizzazione della dimensione dei file PDF con font subsetting
Un test che copre una sola forma non definisce la regola
Un test che dà BT 1 0 0 1 0 0 Tm (hello) Tj ET a un ottimizzatore e asserisce che nessun Tm resta inchioda una forma: un Tm identità direttamente dopo BT viene rimosso. Non dice niente su un Tm identità dopo Td o dopo testo mostrato. Leggere quell'assert singolo come "il Tm identità è sempre rimovibile" è un errore facile, e costoso, perché il campione passa in entrambi i modi. I test per qualsiasi regola come questa hanno bisogno delle forme conservate scritte accanto alle forme rimovibili
L'helper qui sotto conta gli operatori Tm che sopravvivono, poi controlla una tabella di input. Scambiate ExpectTm con l'assert del vostro framework di test; non fa parte della libreria
uses
  SysUtils, PDFlibContentModel, PDFlibContentOps, PDFlibContentOptimize;

function TmCountAfterOptimize(const Source: AnsiString): Integer;
var
  Prog: TPDFContentProgram;
  Optimizer: TPDFContentPeepholeOptimizer;
  I: Integer;
begin
  Result := -1; // -1 segnala un fallimento di parsing
  Prog := TPDFContentProgram.Create;
  try
    if not Prog.Parse(Source) then
      Exit;
    Optimizer := TPDFContentPeepholeOptimizer.Create(Prog);
    try
      Optimizer.Run;
    finally
      Optimizer.Free;
    end;
    Result := 0;
    for I := 0 to Prog.Count - 1 do
      if Prog[I].Op = coTextMatrix then
        Inc(Result);
  finally
    Prog.Free;
  end;
end;

// Helper di controllo vostro, suggerito qui; sostituitelo con un assert vero
procedure ExpectTm(const Source: AnsiString; Expected: Integer);
var
  Actual: Integer;
begin
  Actual := TmCountAfterOptimize(Source);
  if Actual <> Expected then
    raise Exception.CreateFmt('%s: expected %d Tm, got %d',
      [string(Source), Expected, Actual]);
end;

procedure CheckIdentityTmRule;
begin
  // Forme rimovibili
  ExpectTm('BT /F1 12 Tf 1 0 0 1 0 0 Tm (hello) Tj ET', 0);
  ExpectTm('BT 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm (a) Tj ET', 0);
  ExpectTm('BT /F1 12 Tf 2 Tc 0 g 1 0 0 1 0 0 Tm (a) Tj ET', 0);
  // Forme che devono conservare il Tm identità
  ExpectTm('BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET', 1);
  ExpectTm('BT 10 20 Td 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm (a) Tj ET', 1);
  ExpectTm('BT 2 0 0 2 5 5 Tm (a) Tj 1 0 0 1 0 0 Tm (b) Tj ET', 2);
  ExpectTm('1 0 0 1 0 0 Tm (a) Tj', 1);    // nessun BT contenitore
  ExpectTm('BT ET 1 0 0 1 0 0 Tm', 1);     // dopo ET
end;
Le ultime due righe sembrano sciocche finché non vi ricordate che gli array /Contents a layer producono esattamente quei frammenti. Uno stream che comincia a metà di un oggetto testo non ha BT, e un Tm identità dopo ET non appartiene ad alcun oggetto testo. Entrambi restano. La coppia vuota BT ET nell'ultima riga viene rimossa dalla regola dell'oggetto testo vuoto, ecco perché il conteggio controlla gli operatori Tm invece di confrontare stringhe intere
Ciò che la regola lascia andare è l'occasionale Tm identità in mezzo a un oggetto testo, qualche byte per pagina prima ancora che Flate li veda. Ciò che compra è una garanzia su cui poggia il progetto dell'ottimizzatore: nessuna trasformazione nel passaggio cambia la pagina visibile. Un ottimizzatore di dimensione che muove il testo è un bug di rendering con un buon rapporto di compressione
Se generate o fate post-processing di contenuto PDF in Delphi o C++Builder, la PDF Library for Delphi e C++Builder distribuisce il parser dei content stream, questo passaggio peephole e le opzioni di salvataggio mostrate qui sopra, insieme a NormalizeContentStreams per produrre una baseline pulita e non ottimizzata con cui confrontarsi