Mettete in escape correttamente un commento cliente, così che <b>urgent</b> entri nel vostro template HTML come <b>urgent</b>, consegnatelo a un renderer che analizza il markup due volte, e il PDF può tornare con la parola urgent in grassetto. L'escape era corretto. Il renderer lo ha decodificato una volta per passata. Qualsiasi percorso HTML-to-PDF che analizza, riscrive il risultato come HTML e analizza di nuovo deve decodificare le entità esattamente una volta su tutto il viaggio
La versione help desk di questa storia è ordinaria. I ticket vengono esportati in PDF, il commento del cliente siede dentro un <p>, e qualcuno digita parentesi angolari nel box dei commenti. Un nome di tag sconosciuto sparisce semplicemente dalla pagina. Un'ancora con escape diventa un'annotazione link cliccabile in un documento di cui il vostro staff si fida. Il file è valido e si apre ovunque; dice semplicemente una cosa diversa dai dati
Dove il testo con escape torna a essere markup
Il testo con escape diventa markup nel punto in cui un renderer a due passate riscrive in HTML testo già decodificato senza sottoporlo di nuovo a escape. Ciò che la prima analisi ha decodificato è poi sintassi viva per la seconda analisi
Le due passate in DrawHTMLText e DrawHTMLTextBox di PDF Library for Delphi (PDFlibPas) esistono per un buon motivo. La prima analisi spezza l'input in tag e parole. Il renderer poi risolve la cascata del foglio di stile: le regole dei blocchi <style> vengono confrontate con ogni tag, fuse con gli attributi style inline, e l'intera lista di elementi viene riscritta come una stringa HTML normalizzata con ogni tag che porta il proprio stile finale. La passata di layout analizza quella stringa. Il matching dei selettori, flexbox, grid e il resto del supporto CSS descritto in flexbox, CSS grid e layout delle note a piè di pagina nel rendering HTML di PDFlibPas dipendono tutti da quel passaggio intermedio
Il pericolo siede in come le parole tornano fuori. I tag possono essere riscritti dalla loro forma sorgente, ma le parole vengono tenute come testo decodificato, perché è ciò che il line breaker misura. Accodate la parola arrivata da <unsafe> alla stringa normalizzata così com'è, e <unsafe> arriva alla seconda analisi come elemento. Un design che decodifica una volta deve chiudere anche tre perdite minori:
- Se
&non è nell'insieme decodificato,R&Dsi stampa letteralmente e non c'è modo alcuno di mettere sulla pagina la grafia<come testo - Se la fase di disegno sostituisce di nuovo
dopo che il parsing è finito, una grafia di entità letterale sparisce all'ultimo momento - Se un produttore HTML a monte, come un convertitore Markdown o un esportatore di dataset, mette in escape solo le parentesi angolari, una grafia di entità dentro un esempio di codice o un valore di cella viene decodificata in markup
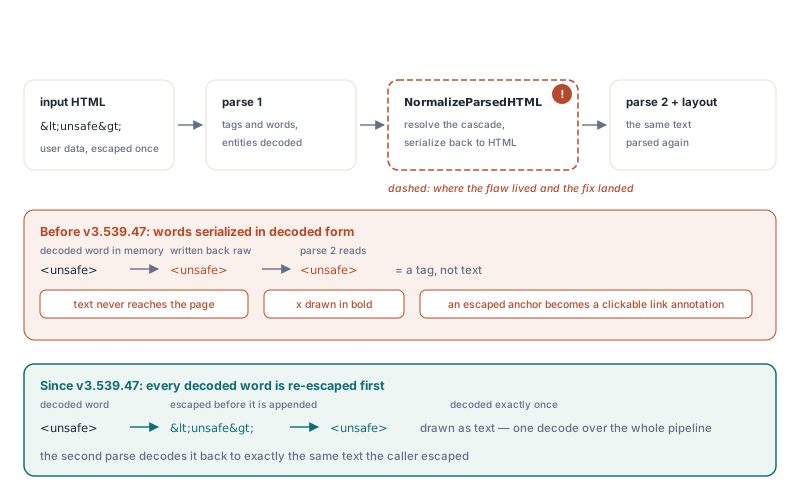
La tabella qui sotto elenca cosa arriva alla pagina per una manciata di input, confrontando un renderer a due passate ingenuo con la pipeline PDFlibPas
| Input che arriva al renderer | Renderer a due passate ingenuo | PDFlibPas |
|---|---|---|
<unsafe> | Analizzato come tag, il testo non arriva mai alla pagina | <unsafe> disegnato come testo |
<b>x</b> | x disegnato in grassetto | <b>x</b> disegnato come testo |
R&D | R&D stampato letteralmente | R&D |
&lt; | &lt; stampato letteralmente | < |
Code span Markdown contenente | Uno spazio non divisibile | disegnato come testo |
Valore di cella del dataset < | < | < |
Come decodifica PDF Library for Delphi ogni entità esattamente una volta?
PDF Library for Delphi decodifica ogni entità esattamente una volta seguendo tre regole insieme: il parser decodifica & per ultimo, la fase di disegno non decodifica niente, e ogni punto che riconverte le parole decodificate in HTML le sottopone prima a escape. Togliete una qualsiasi delle tre e una delle righe della tabella qui sopra passa alla colonna ingenua
Iniziate con ciò che viene decodificato. Nel contenuto testuale il parser riconosce <, >, & e . I riferimenti numerici come A e le entità nominate come " restano testo letterale. Quella lista corta decide come dovete mettere in escape il vostro input, cosa che torna in scena più avanti
L'ordine dentro il decoder conta anche dentro una singola passata. Decodificate & per primo e l'input &lt; diventa <, e la sostituzione immediatamente successiva lo trasforma in <: una doppia decodifica senza alcuna seconda analisi. Il percorso delle parole a 8 bit quindi sostituisce <, > e per prime e & per ultima, così la e commerciale che produce non viene più guardata. Il percorso delle parole UTF-16 prende una strada diversa verso lo stesso risultato — una scansione singola da sinistra a destra a passi di due byte che riscrive ogni corrispondenza sul posto e la salta
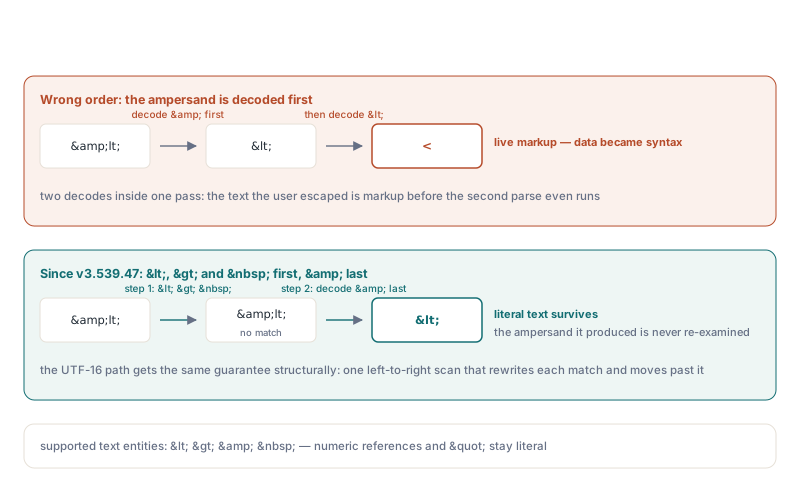
La fase di disegno non riceve alcuna tardiva sostituzione di . Una parola che raggiunge il line breaker è testo definitivo, e la decodifica vive nel parser e in nessun altro posto
La regola del confine porta il peso maggiore. Quando il renderer scrive l'HTML normalizzato, mette in escape &, < e > in ogni parola decodificata prima di accodarla, e la seconda analisi la decodifica negli stessi caratteri. Effetto netto sulle due passate: una decodifica. La stringa di continuazione che DrawHTMLTextBox restituisce segue la stessa regola. Le parole che non entravano vengono messe in escape prima di finire nel residuo, e il resto del residuo viene copiato dall'HTML normalizzato, che è già con escape. Una box che prende tutto restituisce una stringa vuota
Perché l'escape UTF-16BE non può usare una sostituzione a livello di byte?
L'escape UTF-16BE non può usare una sostituzione a livello di byte perché i due byte di una e commerciale possono cavalcare due caratteri tra loro estranei. L'intera code unit a 16 bit è l'unica unità di lavoro sicura
Il renderer tiene le parole Unicode come UTF-16 big-endian impacchettato in stringhe di byte, byte alto prima, così una e commerciale è 00 26. Prendete U+0100 (A maiuscola latina con macron, byte 01 00) seguita da U+2603 (il pupazzo di neve, byte 26 03). Il buffer si legge 01 00 26 03, e i byte due e tre fanno 00 26. Una ricerca per byte di #0'&' trova una e commerciale che nessun carattere contiene, innesta & in mezzo a due code point, e sposta di un byte ogni carattere successivo
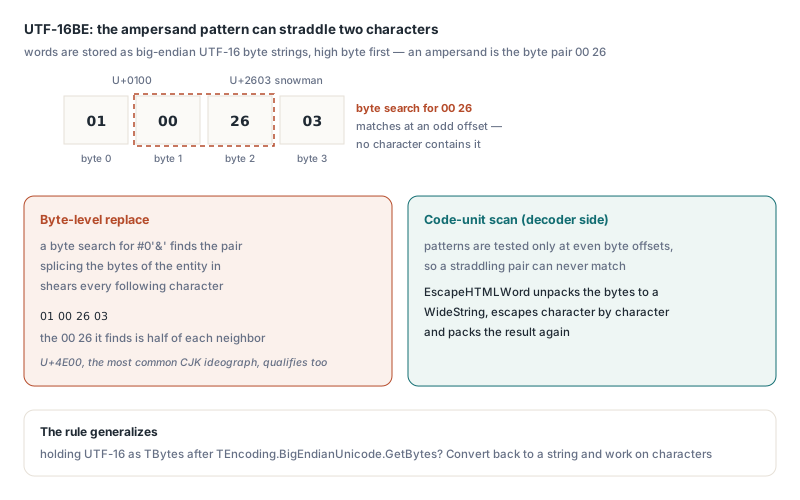
Non è un angolo esotico. Qualsiasi carattere il cui byte basso è zero può fornire la prima metà, e U+4E00, uno degli ideogrammi CJK più frequenti, è un carattere così. Le parentesi angolari sono esposte allo stesso modo: 00 3C e 00 3E compaiono ogni volta che un tale carattere è seguito da uno tra U+3C00 e U+3EFF in CJK Extension A. Quindi PDFlibPas mette in escape le parole Unicode spacchettandole in una WideString, facendo l'escape carattere per carattere e ri-impacchettando il risultato. Il decoder è sicuro per la ragione corrispondente: testa i pattern solo a offset pari
Il codice vostro può battere contro lo stesso muro. Una volta che testo UTF-16 vive in TBytes, per esempio dopo TEncoding.BigEndianUnicode.GetBytes, cercarvi pattern di byte è un difetto in attesa della coppia giusta di caratteri. Riconvertite in stringa e lavorate sui caratteri
Codice Markdown e celle di dataset: la e commerciale va per prima
Entrambi i produttori HTML dentro PDFlibPas, il convertitore Markdown e l'esportatore di dataset, mettono in escape la e commerciale prima delle parentesi angolari, così l'unica decodifica nel renderer ripristina il testo originale byte per byte
In MarkdownToHTML, i code span inline e i blocchi di codice recintati o indentati mappano & a &, < a < e > a >. Gli spazi diventano e una tab diventa quattro di questi, il che conserva l'indentazione. La prosa ordinaria mette in escape solo le parentesi angolari: HTML crudo digitato nella prosa non può iniettare tag, mentre un autore che scrive & di proposito ottiene comunque una e commerciale, come gli autori Markdown si aspettano. DrawMarkdownText e DrawMarkdownTextBox eseguono la stessa conversione, così un blocco di codice compare esattamente come digitato:
uses
System.SysUtils, PDFlibrary;
procedure RenderCodeSample;
var
Lib: TPDFlib;
Md, Html: WideString;
begin
Md := 'Comparison helper:' + sLineBreak + sLineBreak +
'```' + sLineBreak +
'if (A < B) and (Flags <> 0) then' + sLineBreak +
' WriteLn(''<tag> & R&D'');' + sLineBreak +
'```';
Lib := TPDFlib.Create;
try
// Ispeziona l'HTML: nel codice, '&' diventa '&' e '<' diventa '<'
Html := Lib.MarkdownToHTML(Md);
Lib.SetOrigin(1); // origine in alto a sinistra, Y cresce verso il basso
Lib.SetMeasurementUnits(0); // punti
// La pagina mostra il codice esattamente come digitato, grafie di entità incluse
Lib.DrawMarkdownText(50, 50, 495, Md);
Lib.SaveToFile('code-sample.pdf');
finally
Lib.Free;
end;
end;L'esportatore di dataset è dove siede la scorciatoia allettante. Se un renderer non decodificasse &, mettere in escape la e commerciale stamperebbe & in ogni cella che ne contiene una, quindi mettere in escape solo le parentesi angolari sembra la scelta più gentile. Crolla alla prima cella il cui valore per caso contiene <, che arriva poi alla pagina come <. Dato che il renderer decodifica &, l'esportatore dietro PDFlibExportDataSet mette in escape & per primo, e un valore come R&D < & atterra nel PDF alla lettera. Il resto di quell'esportatore è coperto in esportare un TDataSet in un report PDF in Delphi
Perché per prima, e non semplicemente da qualche parte nella catena? Mettete in escape < per primo e ottenete <. Mettete in escape & per secondo e quello diventa &lt;, che una decodifica singola corretta mostra come < anziché <. Una catena di sostituzioni sequenziali funziona solo quando il carattere di escape stesso viene gestito prima di qualsiasi passaggio che lo introduce
Come mettere in escape testo non fidato per DrawHTMLTextBox?
Per PDFlibPas mettete in escape il contenuto testuale non fidato sostituendo &, poi <, poi >, esattamente una volta, e tenete i dati non fidati del tutto fuori dai valori degli attributi. L'helper qui sotto è da aggiungere voi; è codice RTL puro:
uses
System.SysUtils, PDFlibrary;
// Helper vostro (non parte della libreria): mette in escape il testo non fidato
// per il contenuto testuale HTML di PDFlibPas. '&' va sostituito per primo,
// altrimenti la e commerciale dentro un '<' appena prodotto viene
// sottoposta a escape una seconda volta
function EscapeHTMLText(const S: string): string;
begin
Result := StringReplace(S, '&', '&', [rfReplaceAll]);
Result := StringReplace(Result, '<', '<', [rfReplaceAll]);
Result := StringReplace(Result, '>', '>', [rfReplaceAll]);
end;
procedure RenderTicket(const CustomerComment: string);
var
Lib: TPDFlib;
Html: WideString;
begin
Lib := TPDFlib.Create;
try
Lib.SetOrigin(1);
Lib.SetMeasurementUnits(0);
Html := '<p><b>Customer comment</b></p>' +
'<p>' + EscapeHTMLText(CustomerComment) + '</p>';
Lib.DrawHTMLText(50, 50, 495, Html);
Lib.SaveToFile('ticket.pdf');
finally
Lib.Free;
end;
end;Dategli in pasto il commento Try <a href="https://example.com">this</a> & <b> e la pagina mostra quei caratteri uno per uno. Con un renderer che decodifica due volte, lo stesso input con escape diventa una annotazione link viva. È il passo dal difetto cosmetico al problema di sicurezza: un commento di ticket non dovrebbe mai poter piantare un URL cliccabile in un PDF che va al vostro stesso staff
Notate ciò che l'helper lascia stare. Gli escaper di uso generale convertono anche " in " e ' in ', cosa giusta per un browser e sbagliata qui — la decodifica testuale di PDFlibPas conosce solo le quattro entità elencate prima, quindi quelle due si stamperebbero letteralmente come " e '. Non riusate un escaper da browser per questo. I virgoletti sono innocui nel contenuto testuale; contano solo dentro i valori degli attributi, e il renderer non decodifica affatto le entità negli attributi. Per gli attributi preferiamo una regola a un escaper più furbo, dato che lì comunque nessuno schema di escape viene verificato: tenete i valori utente fuori da href, src e style. Se un target di link deve davvero venire da input utente, validatelo voi contro una allow-list di schemi e caratteri e rifiutate tutto ciò che contiene virgolette o parentesi angolari
Due abitudini discendono direttamente dalla decodifica a passata unica:
- Mettete sempre in escape
&. Saltatelo, e testo utente contenente<si mostra come<— innocuo, ma non ciò che l'utente ha digitato - Fate l'escape in un punto solo. Il testo che passa attraverso due escaper renderizza
<come la grafia visibile<, quindi trovate l'unico posto in cui i vostri dati entrano nella stringa HTML e fate l'escape lì
Impaginare con LeftOverText senza rompere gli escape
DrawHTMLTextBox restituisce l'HTML che non è entrato, di solito chiamato LeftOverText, e quel residuo conserva le grafie di entità letterali e le parentesi angolari con escape quando finisce nella box successiva. Ripassatelo esattamente come lo avete ricevuto
const
  BoxLeft = 50;
  BoxTop = 50;
  BoxWidth = 495;    // dimensionato per una pagina A4 in punti
  BoxHeight = 740;
  MaxPages = 500;    // vostro tetto di sicurezza

procedure RenderLongHTML(Lib: TPDFlib; const Html: WideString);
var
  Rest: WideString;
  Pages: Integer;
begin
  Lib.SetOrigin(1);
  Lib.SetMeasurementUnits(0);
  Rest := Lib.DrawHTMLTextBox(BoxLeft, BoxTop, BoxWidth, BoxHeight, Html);
  Pages := 1;
  while (Rest <> '') and (Pages < MaxPages) do
  begin
    Lib.NewPage;
    Inc(Pages);
    // Il residuo è già HTML con escape: mai rifargli escape o decodificarlo
    Rest := Lib.DrawHTMLTextBox(BoxLeft, BoxTop, BoxWidth, BoxHeight, Rest);
  end;
  if Rest <> '' then
    raise Exception.CreateFmt('Content still left after %d pages', [MaxPages]);
end;
Trattate il residuo come opaco. È HTML normalizzato con gli stili già risolti su ogni tag, quindi farlo passare dal vostro escaper trasforma ogni < in &lt;, e decodificarlo consegna alla box successiva tag vivi. Innestarci dentro testo utente fresco ha le stesse due modalità di fallimento. Il tetto di pagine costa un confronto: se qualche elemento non può mai entrare nella box, un ciclo senza tetto non ha uscita naturale
Il Markdown ha la sua continuazione. DrawMarkdownTextBox restituisce un residuo che comincia con un commento marcatore, che dice ai punti d'ingresso Markdown di saltare la conversione alla chiamata successiva. Ripassatelo a DrawMarkdownTextBox o DrawMarkdownText, allo stesso modo in cui riconsegnereste LeftOverText a DrawHTMLTextBox. Un residuo Markdown appartiene ai punti d'ingresso Markdown, quindi tenetelo da quella parte e instradate attraverso le chiamate HTML solo i residui di DrawHTMLTextBox
La forma dietro tutto questo — analizza, riscrivi nella stessa sintassi, analizza di nuovo — si presenta anche nei motori di template, nei sanitizzatori HTML e nelle catene Markdown-to-HTML-to-PDF, e il fallimento arriva in due direzioni. Troppo poco ri-codifica trasforma dati in sintassi. Troppa codifica, o un decoder che gira due volte, mostra al lettore grafie di entità o se le mangia. Tappare una direzione sola tende a rompere l'altra, ecco perché il renderer PDFlibPas tratta la decodifica di &, il decodificarla per ultima, l'assenza di decodifiche tardive e il ri-escape a ogni confine come un pacchetto unico. La direzione di export segue la stessa regola in esportazione semantica PDF verso Markdown e DOCX da Delphi, dove ogni carattere letterale viene messo in escape per la sintassi bersaglio esattamente una volta
Disegno HTML e Markdown, l'esportatore di report da dataset e il resto del motore di layout arrivano come sorgente Pascal nativa in PDF Library for Delphi, sia per Delphi sia per Free Pascal. Edizioni, copertura di piattaforme e download di prova sono elencati nella pagina del prodotto PDF Library for Delphi