Mezzo punto decide tutto. In un report con testo corpo da 10 punti, un titolo di sezione composto in grassetto da 11 punti si converte in Markdown come paragrafo ordinario, mentre una didascalia da 12 punti in copertina, di peso regolare, torna come ### Quarterly figures. Sembra al contrario finché non vi ricordate cosa conserva davvero una pagina PDF: glifi a coordinate, un nome di font e una dimensione. Nulla sulla pagina dice "titolo". Ogni titolo che un convertitore emette è un'ipotesi costruita da quei tre fatti, e l'ipotesi ha soglie
Perché una pagina PDF non ha paragrafi da esportare
Una pagina PDF contiene operatori di mostrazione testo, non paragrafi. Ogni operatore colloca una sequenza di glifi a una posizione, nell'ordine in cui l'applicazione produttrice è capitata a emetterli, e ISO 32000-1 non mette alcun obbligo al producer di dire che due sequenze appartengono alla stessa frase, figurarsi allo stesso elemento di elenco o cella di tabella. Il formato descrive una pagina stampata esattamente, e ci arriva buttando via la struttura che ha prodotto la pagina
Così ogni convertitore ricostruisce ciò che il generatore ha scartato. Le righe vengono dalle baseline condivise e dalla spaziatura verticale. Le interruzioni di paragrafo vengono dai cambi di spaziatura e rientro. Un elenco è una sequenza di blocchi che cominciano con un carattere bullet o un pattern numerico. Una tabella è una griglia di blocchi di testo i cui bordi si allineano tra righe e colonne. Sui documenti che seguono abitudini tipografiche ordinarie questo funziona bene; su una brochure composta per effetto visivo ha ben poco a cui aggrapparsi
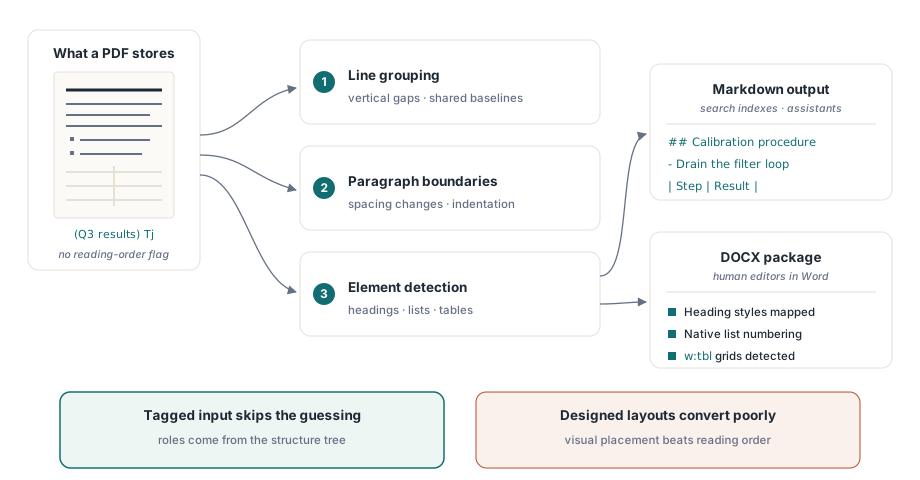
I PDF taggati sono la grande eccezione. Quando un documento porta un albero di struttura, i ruoli di paragrafo, titolo, elenco e tabella sono registrati dal producer invece di essere indovinati dopo, ed è per questo che il lavoro descritto in struttura di accessibilità dei PDF taggati ripaga anche in qualità di conversione. Se controllate il producer, taggare l'output è la cosa più economica che possiate fare per chi lo convertirà dopo
Da dove vengono i livelli dei titoli
PDF Library for Delphi decide i livelli dei titoli in due modi, a seconda dell'input. Su una pagina taggata, un blocco il cui ruolo di struttura va da H1 a H6 conserva quel livello, e H o Title diventa livello 1. Su una pagina non taggata l'export ripiega sulla dimensione del font relativa al testo corpo della pagina, e considera solo paragrafi a riga singola di 200 caratteri o meno
La regola della dimensione ha bisogno sia di un rapporto sia di un divario assoluto, misurati contro la dimensione dominante del corpo:
| Output Markdown | Testo più grande sulla riga | Con corpo da 10 pt |
|---|---|---|
# | almeno 1,6 volte la dimensione del corpo e almeno 4 pt in più | 16 pt e oltre |
## | almeno 1,35 volte e almeno 2,5 pt in più | 13,5 pt e oltre |
### | almeno 1,15 volte e almeno 1,25 pt in più | 11,5 pt e oltre |
Questo spiega l'esempio iniziale. Un titolo in grassetto da 11 punti sopra testo da 10 punti manca il terzo livello di mezzo punto, e il peso non gioca alcun ruolo nel livello. La didascalia di copertina a 12 punti lo supera. Il divario assoluto esiste per le dimensioni piccole del corpo: su testo da 6 punti, come note a piè di pagina, un rapporto da solo promuoverebbe una riga da 7 punti a titolo, e il requisito extra di 1,25 pt lo impedisce
Riteniamo sia il compromesso giusto. Il grassetto è troppo comune dentro il testo corpo (frasi di apertura, termini definiti, totali in una riga di riepilogo) per essere un segnale di titolo affidabile da solo, e un convertitore che promuove ogni riga in grassetto produce Markdown con decine di sezioni spurie. Perdere qualche titolo solo-grassetto costa meno. Se i vostri documenti contano su titoli in grassetto a dimensione corpo, la correzione affidabile è a monte: taggateli, o alzate la dimensione del titolo di un punto e mezzo
Grassetto e corsivo nell'output vengono letti dal nome del font. Una sequenza il cui nome font contiene Bold, Black o Demi diventa **bold**; Italic o Oblique diventa *italic*. I producer che fanno subsetting dei font sotto nomi opachi come F3, o che fingono il grassetto tracciando i contorni dei glifi regolari, non danno all'export niente da leggere, e quel testo arriva senza stile
Export Markdown per le pipeline di retrieval
Il percorso Markdown è quello da afferrare quando la destinazione è una pipeline testuale: un sito di documentazione, un indice di ricerca, un corpus a chunk per un assistente. ExportPageMarkdown restituisce una pagina come WideString, ExportDocumentMarkdown restituisce un intervallo di pagine, e SaveMarkdownToFile e SaveMarkdownToStream scrivono lo stesso testo come UTF-8 senza byte-order mark. Il BOM mancante è deliberato; parecchi generatori di siti statici e strumenti di diff lo trattano come contenuto
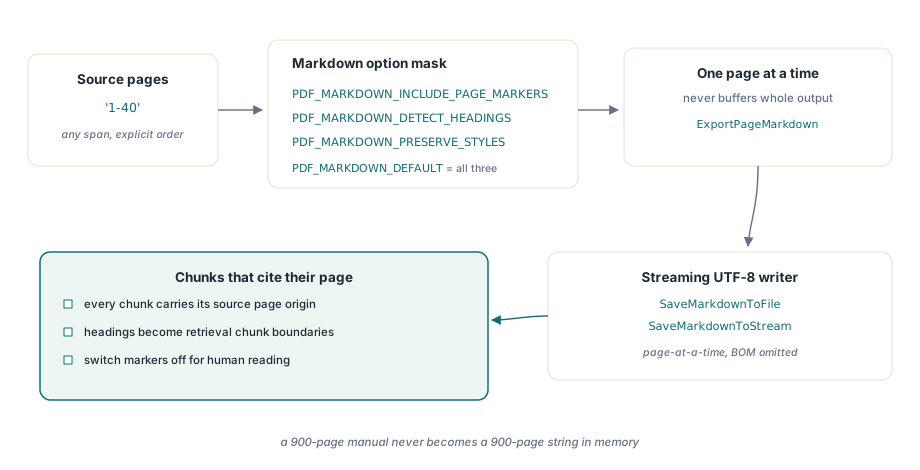
Le opzioni sono una maschera di bit: PDF_MARKDOWN_INCLUDE_PAGE_MARKERS (1), PDF_MARKDOWN_DETECT_HEADINGS (2) e PDF_MARKDOWN_PRESERVE_STYLES (4), con PDF_MARKDOWN_DEFAULT che combina tutte e tre. Un'impostazione seconda, a livello di documento, controlla l'analisi stessa: SetStructuredTextOptions prende i flag PDF_STRUCTURED_*, e il suo default rileva le colonne, rileva intestazioni e piè di pagina ricorrenti, e salda le tabelle che continuano attraverso un'interruzione di pagina
uses
  SysUtils, PDFlibrary;

var
  Pdf: TPDFlib;
  Exported: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    if Pdf.LoadFromFile('handbook.pdf', '') = 0 then
      raise Exception.Create('Cannot open handbook.pdf');

    // Il rilevamento di intestazioni e piè di pagina ricorrenti è attivo per default;
    // aggiungere EXCLUDE_FURNITURE li toglie anche dall'output
    Pdf.SetStructuredTextOptions(PDF_STRUCTURED_ADVANCED_DEFAULT or
      PDF_STRUCTURED_EXCLUDE_FURNITURE);

    // Marcatori di pagina e titoli, ma nessuna enfasi ** e *
    Exported := Pdf.SaveMarkdownToFile('1-40',
      PDF_MARKDOWN_INCLUDE_PAGE_MARKERS or PDF_MARKDOWN_DETECT_HEADINGS,
      'handbook.md');
    if Exported = 0 then
      raise Exception.CreateFmt('Markdown export failed, error %d',
        [Pdf.LastErrorCode]);

    // JSON con una voce per pagina: readingSource è tagged, mixed,
    // geometric o geometric-columns
    Writeln(Pdf.GetLastStructuredTextDiagnostics);
  finally
    Pdf.Free;
  end;
end;
Per un corpus di retrieval scartiamo PDF_MARKDOWN_PRESERVE_STYLES. L'enfasi è applicata sequenza per sequenza, così una frase in grassetto composta in diverse sequenze esce come **Net** **revenue**, che si legge bene sullo schermo e aggiunge rumore a ogni embedding. I marcatori di pagina sono il caso opposto: teneteli. Ogni marcatore è un commento HTML, <!-- page: 12 -->, invisibile quando il Markdown viene renderizzato e banale da parsare quando dividete i chunk, così un passaggio recuperato può citare la pagina da cui viene. Quando una tabella continua dalla pagina precedente, il marcatore della nuova pagina viene omesso così la tabella a pipe resta un pezzo solo
Due comportamenti beccano chi esporta pagina per pagina in un ciclo. Primo, le intestazioni ricorrenti vengono riconosciute per ripetizione: un paragrafo nel 12 percento superiore o inferiore della pagina conta come arredo quando testo corrispondente siede nella stessa banda su un'altra pagina della stessa esportazione, con le cifre normalizzate così "Pagina 3 di 40" coincide con "Pagina 4 di 40". Una chiamata a pagina singola non ha altre pagine con cui confrontarsi, quindi un'intestazione ricorrente non taggata resta nel testo. Secondo, le immagini in Markdown sono incorporate inline come URI data:, il che mantiene il file autosufficiente e significa che una pagina con una grande fotografia può aggiungere centinaia di kilobyte di base64 al file. Se il vostro chunker ha un limite di dimensione, togliete le righe che cominciano con 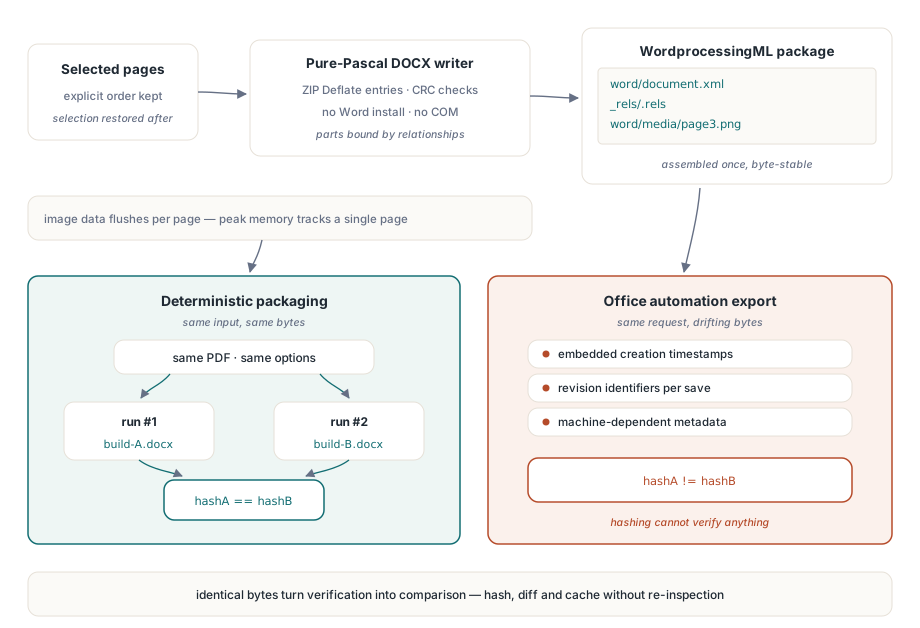
Due scelte fanno reggere questo. Ogni voce ZIP porta la stessa data DOS fissa, 1 gennaio 1980, invece del tempo dell'esecuzione, e la parte delle proprietà core non ha date di creazione o modifica. Ogni voce viene compressa con Deflate grezzo solo quando davvero lo rende più piccolo, così i media PNG, già compressi, vengono conservati così come sono. Potete confermare il primo punto con unzip -v handbook.docx: ogni riga mostra la stessa data
L'automazione di Office non può darvelo. Salvando attraverso Word l'ora corrente finisce stampata nei metadati del pacchetto e nelle intestazioni ZIP, così lo stesso documento convertito due volte differisce nei modi che sconfiggono un hash. Lo stesso ragionamento sta dietro agli identificatori di file stabili degli ID PDF deterministici per build riproducibili: una volta che l'output è riproducibile, la verifica diventa un confronto
Quali input si convertono bene, e quali mai
La qualità della conversione varia più con l'input che con il convertitore, e vale la pena dirlo ai vostri utenti subito. I PDF taggati e i documenti business generati puliti (fatture, report, contratti) si convertono bene: i titoli atterrano come titoli, le tabelle sopravvivono, gli elenchi si rinumerano in Word. Gli impaginati accademici a due colonne passano nel giusto ordine di lettura quando la geometria delle colonne è regolare, e la diagnostica riporterà geometric-columns per quelle pagine. Le tabelle che si spezzano tra pagine vengono risaldate per inferenza, quindi controllatele a campione. Il materiale marketing fortemente progettato, dove il testo è collocato per effetto anziché in ordine di lettura, dà a qualsiasi convertitore poco da recuperare; aspettatevi di ritoccare il risultato a mano
I documenti scansionati sono un caso a parte. Una pagina che è una grande immagine non contiene oggetti testo, quindi non c'è niente da esportare finché non esiste un livello testo, ed eseguire l'OCR è un prerequisito per entrambi i formati. Prima di impegnarvi su un grosso lotto, campionate una dozzina di file rappresentativi ed enumerate ciò che le loro pagine contengono, come descritto in ricerca testuale ed enumerazione degli elementi di pagina; una pagina con immagini e nessuna sequenza di testo vi dice di più in un secondo di quanto vi dirà leggere l'output convertito
Scegliete il formato per ciò che viene dopo. Il Markdown sta alle macchine e alle pipeline: i titoli diventano confini di chunk, le tabelle restano leggibili come tabelle a pipe, e i marcatori di pagina danno a ogni chunk una citazione. Il DOCX sta alle persone che devono cambiare il documento, perché ciò che vogliono indietro è un file modificabile in Word, con veri elenchi e vere tabelle, e il solo testo non glielo dà
PDF Library for Delphi viene distribuita per Delphi, C++Builder e Lazarus, con edizioni DLL e ActiveX che espongono le stesse chiamate di export Markdown e DOCX a host C#, C++ e di scripting. Il reference di ogni flag di opzione e un download di prova sono sulla pagina del prodotto PDF Library for Delphi