Un importatore di annotazioni FDF può restituire il numero di voci che ha parserizzato senza aggiungerne nessuna al documento: ogni voce contata, ogni voce buttata via. TPDFlib.ImportAnnotationsFromFDFString in losLab PDF Library legge le chiavi in qualsiasi ordine, parserizza /Rect correttamente e indipendentemente dalla locale, e restituisce il numero di annotazioni davvero aggiunte, mentre l'exporter corrispondente scrive il /Rect reale dell'annotazione, così un export, un import e un secondo export producono un FDF byte-identico. Il resto della nota spiega come un offset di partenza sbagliato produce un perfetto fallimento silenzioso, quali altre tre trappole si nascondono dietro di esso, e come controllare un import da voi invece di fidarvi di un valore di ritorno
Lo scenario è ordinario. Un revisore annota un contratto, i commenti viaggiano come file FDF (Acrobat lo chiama Export Comments), e il vostro servizio Delphi li fonde in una copia pulita con una chiamata di import FDF. La chiamata restituisce 7, il log dice "7 commenti importati", il job va verde, e il PDF di output non ha un commento. Niente sollevato, niente avvisato, e il numero sembrava plausibile perché era il conteggio vero delle voci nel file. È la forma peggiore che un bug può prendere: una funzione il cui unico segnale di successo è un contatore calcolato indipendentemente dal lavoro che dichiara di riportare
Perché un import FDF può riportare successo senza aggiungere niente?
Perché un lettore di nomi può partire nel posto sbagliato, e un contatore può vivere fuori dal codice che fa il lavoro. Un cercatore di chiavi che restituisce la posizione immediatamente dopo /Subtype atterra sul whitespace prima del valore. Un ReadName che parte da quello spazio e si ferma al primo carattere di whitespace si ferma prima di leggere niente, quindi ogni subtype torna vuoto. Un helper come AddAnnotationToPage che rifiuta di costruire un'annotazione senza subtype sta facendo la scelta difensiva corretta in isolamento, ma se è una procedure senza valore di ritorno e l'Inc(Result) del chiamante sta fuori da essa, le due guardie insieme convertono "non ha funzionato niente" in "ha funzionato tutto". Il lettore di nomi corretto salta il whitespace, richiede la / iniziale di un oggetto nome PDF, e si ferma a qualsiasi delimitatore, compresi [, ( e ), così /Subtype/Text e /Subtype /Text producono entrambi Text; è così che losLab PDF Library legge i nomi
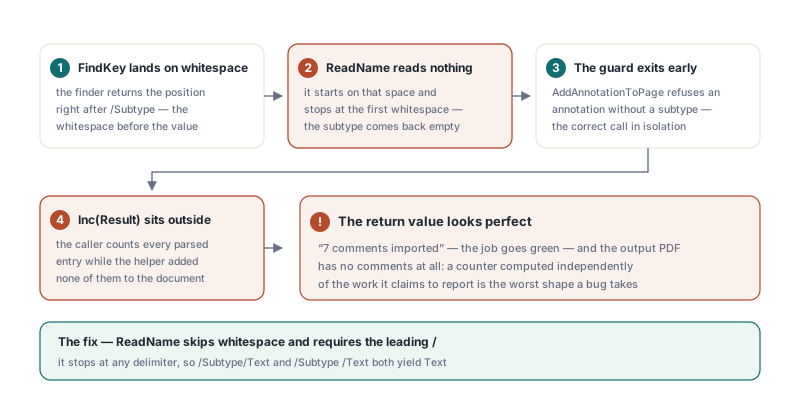
Anche il valore di ritorno merita cura al di là di questo. Un importatore che incrementa per ogni dizionario ben formato nell'array /Annots riporta comunque troppo quando una voce ha un /Page 0-based fuori intervallo o un /Subtype mancante, entrambe le cose vengono saltate. In losLab PDF Library, ImportAnnotationsFromFDFString e ImportAnnotationsFromFDF restituiscono il numero di annotazioni davvero aggiunte, come l'import XFDF: l'helper FDF AddAnnotationToPage restituisce un Boolean e il contatore si muove solo in caso di successo. Misurare il documento resta comunque il controllo più forte, perché vale a prescindere da quale codice ha prodotto il numero, quindi lo schema qui sotto confronta AnnotationCount su ogni pagina prima e dopo l'import
function TotalAnnotations(Lib: TPDFlib): Integer;
var
  Page, Saved: Integer;
begin
  Result := 0;
  Saved := Lib.SelectedPage;
  for Page := 1 to Lib.PageCount do
    if Lib.SelectPage(Page) = 1 then
      Inc(Result, Lib.AnnotationCount);   // per la pagina selezionata, widget compresi
  Lib.SelectPage(Saved);
end;

var
  Lib: TPDFlib;
  Before, Reported, Added: Integer;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('contract.pdf', '');
    Before := TotalAnnotations(Lib);
    Reported := Lib.ImportAnnotationsFromFDF('review-comments.fdf');
    Added := TotalAnnotations(Lib) - Before;
    if Added <> Reported then   // uguali quando ogni voce è atterrata su una pagina
      Writeln(Format('Importer reported %d, %d landed on a page', [Reported, Added]));
    Lib.SaveToFile('contract-reviewed.pdf');
  finally
    Lib.Free;
  end;
end;
Altre tre trappole dietro alla prima
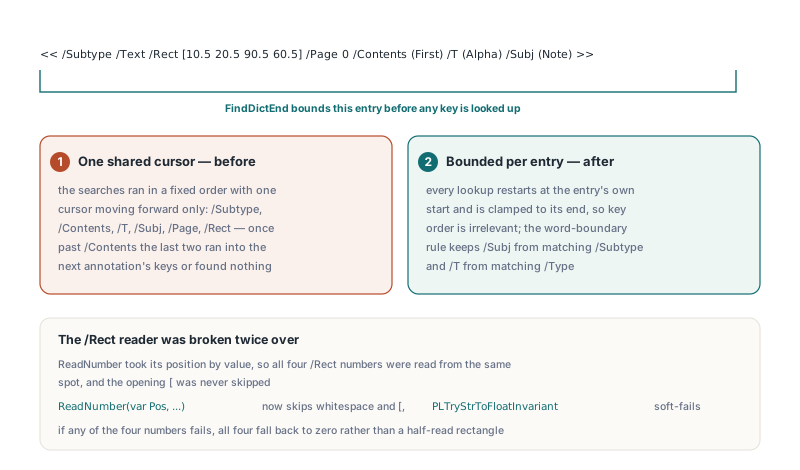
Sistemare il subtype da solo espone altre tre trappole nello stesso tipo di parser, ognuna invisibile finché nessuna annotazione raggiunge mai una pagina. Primo, un ReadNumber che prende la sua posizione come parametro per valore legge lo stesso punto quattro volte quando viene chiamato per i quattro numeri /Rect in sequenza, e se non salta la [ di apertura, in pratica non legge niente affatto. Secondo, un FindKey che condivide un cursore in avanti su tutte le ricerche dipende dall'ordine delle chiavi. Un exporter può scrivere /Subtype, /Rect, /Page, /Contents, /T, /Subj mentre l'importatore cerca nell'ordine /Subtype, /Contents, /T, /Subj, /Page, /Rect; una volta che il cursore ha passato /Contents, la ricerca di /Page e /Rect corre oltre la voce corrente e o non trova niente o combacia le chiavi dell'annotazione successiva, così l'importatore non riesce nemmeno a leggere l'output del suo stesso exporter. Terzo, i numeri parserizzati attraverso una routine che segue il separatore decimale di sistema, come PLStrToFloat, si rompono sulle macchine con locale a virgola. ISO 32000-1 §12.7.7 definisce l'FDF come sintassi di oggetti PDF, e le chiavi dei dizionari in PDF sono senza ordine (§7.3.7), quindi qualsiasi parser FDF che assume un ordine delle chiavi è sbagliato per costruzione, a prescindere da quale strumento ha prodotto il file
losLab PDF Library delimita prima ogni voce. FindDictEnd cammina dal << di apertura al suo >> corrispondente, tracciando i dizionari annidati e saltando i corpi delle stringhe letterali con i loro escape a backslash, così un >> dentro un commento come (see section >> 4) non può chiudere la voce in anticipo. Ogni ricerca di chiave parte quindi dall'inizio della voce ed è limitata alla sua fine, il che rende l'ordine delle chiavi irrilevante e impedisce a un'annotazione di prendere in prestito il /Page di un'altra. La corrispondenza delle chiavi accetta anche un delimitatore direttamente dopo il nome, perché /Contents(Hi) è tanto valido quanto /Contents (Hi), mentre la regola del confine di parola impedisce a /Subj di combaciare l'inizio di /Subtype e a /T di combaciare /Type. ReadNumber prende la sua posizione come parametro var, salta whitespace e [, e parserizza con PLTryStrToFloatInvariant, che fallisce in modo morbido su un token malformato invece di sollevare. Se uno dei quattro numeri del rettangolo fallisce, tutti e quattro ricadono su zero invece di produrre un rettangolo letto a metà
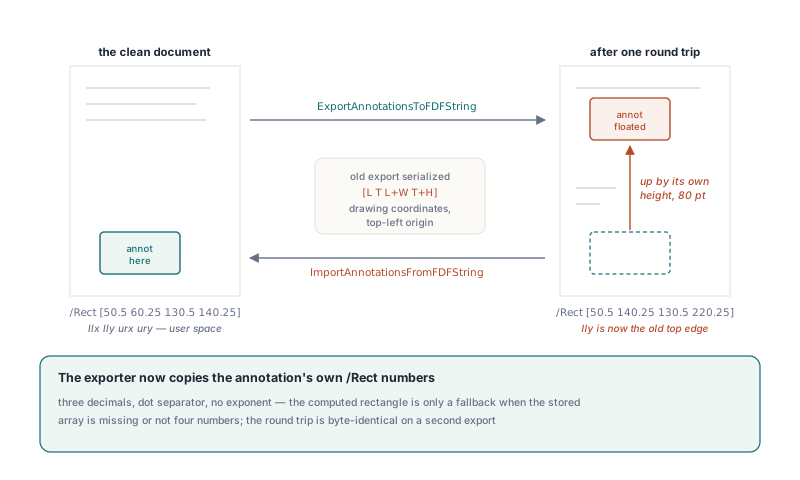
Perché i round trip FDF possono spostare ogni annotazione della propria altezza?
Perché è facile scrivere un rettangolo nel modello di coordinate sbagliato. Il /Rect di un'annotazione è [llx lly urx ury] in user space predefinito (ISO 32000-1 §12.5.2, con i rettangoli definiti in §7.9.5), e l'FDF porta lo stesso array. GetAnnotRectEx, però, riporta Left, Top, Width e Height nelle coordinate di disegno della libreria, lo spazio che SetOrigin controlla. Un exporter che serializza quelli come [L T L+W T+H] consegna all'importatore quattro valori che, riscritti alla lettera come rettangolo PDF, mettono il bordo superiore dove appartiene l'angolo inferiore sinistro, così ogni round trip sposta l'annotazione in alto della propria altezza. L'exporter di losLab PDF Library copia i numeri /Rect dell'annotazione stessa, tre decimali, separatore punto, niente esponente, e ricade sul rettangolo calcolato solo quando l'array memorizzato manca o non sono quattro numeri
Un test di round trip che vale la pena copiare asserisce sul documento e su un secondo export, non sul valore di ritorno dell'importatore. Notate il conteggio atteso di 2: AddNoteAnnotation crea un'annotazione Text più la sua Popup, e entrambe viaggiano. Il test esegue anche export e import sotto un separatore decimale a virgola, che è dove vive l'altra metà di questa storia
var
  Source, Target: TPDFlib;
  FDF: AnsiString;
  OldSep: Char;
begin
  Source := TPDFlib.Create;
  Target := TPDFlib.Create;
  try
    Source.NewPages(1);                     // ora due pagine
    Source.SelectPage(2);
    Source.AddNoteAnnotation(50.5, 60.25, 0, 80, 80, 120, 60,
      'Reviewer', 'Check this', 0.25, 0.5, 0.75, 0);
    Target.NewPages(1);

    OldSep := FormatSettings.DecimalSeparator;
    FormatSettings.DecimalSeparator := ',';   // simula un desktop tedesco o francese
    try
      FDF := Source.ExportAnnotationsToFDFString;   // scrive comunque /Rect [50.5 ...
      Target.ImportAnnotationsFromFDFString(FDF);
    finally
      FormatSettings.DecimalSeparator := OldSep;
    end;

    Target.SelectPage(2);
    Assert(Target.AnnotationCount = 2);           // la nota e il suo popup
    Assert(Target.GetAnnotType(1) = 'Text');
    Assert(Target.ExportAnnotationsToFDFString = Source.ExportAnnotationsToFDFString);
  finally
    Target.Free;
    Source.Free;
  end;
end;
Il percorso FDF è costruito attorno al dizionario principale dell'annotazione. L'importatore ricostruisce ogni voce con /Type, /Subtype, /Rect, /Contents, /T e /Subj, e l'exporter lascia le annotazioni Widget ai metodi dei dati di form, dove i campi form appartengono. Prima di contare sull'FDF per colore, flag, stile del bordo, collegamenti popup o appearance stream, controllate la mappa più ampia di quali dati viaggiano attraverso quale metodo nella panoramica di interscambio di dati form FDF, XFDF e XFA, e se dovete ispezionare cosa è davvero arrivato, i lettori per indice come GetAnnotType, GetAnnotTitle e GetAnnotContentsEx sono coperti in introspezione di outline, annotazioni e action
Come si leggono file FDF e XFDF con decimali a virgola?
Per l'FDF la risposta è inequivocabile: una virgola non è un delimitatore nella sintassi PDF, quindi un token numerico che contiene esattamente una virgola e nessun punto può essere solo un decimale scritto su una macchina con locale a virgola. File così esistono, per esempio /Rect [10,500 20,250 40,750 60,125] da un exporter che formattava i numeri con la locale di sistema, e ReadNumber trasforma quella singola virgola in un punto prima di parserizzare. Un token con due virgole, o con una virgola e un punto, viene rifiutato invece che indovinato. Il lettore non consuma nemmeno la notazione a esponente, il che corrisponde a ISO 32000-1 §7.3.3: i numeri PDF non la usano mai
L'XFDF è più difficile, perché negli attributi XML la virgola è il separatore. L'XFDF standard (ISO 19444-1) scrive rect="50.5,80.25,70.75,100.125" e dashes="4,2", mentre un writer dipendente dalla locale su un sistema con locale a virgola produce rect="50,500 80,250 70,750 100,125" e opacity="0,600". losLab PDF Library legge e scrive i numeri XFDF in modo invariante in entrambe le direzioni, e riconosce la forma legacy attraverso XFDFNormalizeLegacyDecimals solo quando l'attributo si divide sul whitespace nel numero esatto di token attesi (quattro per rect, uno per opacity e width) e ogni token ha la forma cifre-virgola-cifre. Un rect standard non combacia mai: è o un token con tre virgole o token che finiscono con una virgola. dashes è lasciato deliberatamente in pace, perché 4,2 potrebbe essere due lunghezze di dash o un legacy 4.2, e nessuna regola può distinguerli
const
  // Chiavi fuori dall'ordine dell'exporter, più decimali a virgola da un export con locale a virgola
  LegacyFDF: AnsiString = '%FDF-1.2'#10'1 0 obj'#10'<< /FDF << /Annots ['#10 +
    '<< /Rect [10,500 20,250 40,750 60,125] /Page 0 /Contents (First) ' +
    '/Subtype /Text /T (Alpha) /Type /Annot >>'#10 +
    '] >> >>'#10'endobj'#10'trailer'#10'<< /Root 1 0 R >>'#10'%%EOF'#10;
var
  Lib: TPDFlib;
begin
  Lib := TPDFlib.Create;               // un documento nuovo ha una pagina
  try
    Lib.ImportAnnotationsFromFDFString(LegacyFDF);
    Assert(Lib.AnnotationCount = 1);
    Assert(Lib.GetAnnotTitle(1) = 'Alpha');
    // Ri-esportato come XFDF con decimali a punto: rect="10.500 20.250 40.750 60.125"
    Writeln(Lib.ExportAnnotationsToXFDFString);
  finally
    Lib.Free;
  end;
end;
Che cosa deve davvero asserire un test di import delle annotazioni?
Un test di import utile asserisce sullo stato del documento di destinazione, mai solo su ciò che l'importatore dice di sé; nel fallimento a zero silenzioso, il valore di ritorno è l'unico numero che resta intatto. Tre asserzioni beccano ogni trappola descritta qui: il conteggio delle annotazioni sulla pagina attesa, un campo riletto attraverso GetAnnotType o GetAnnotContentsEx, e un secondo export confrontato byte per byte con il primo. La stessa disciplina vale per qualsiasi API che riscrive la struttura del documento in massa, compresa la consolidazione dei campi descritta in fusione di campi form duplicati: controllate l'albero risultante, non un totale restituito. I metodi delle annotazioni FDF e XFDF, con le loro varianti su file e su stringa, sono spediti nella losLab PDF Library per Delphi e C++Builder