CollateDocumentsEx nella libreria PDF Delphi PDF Library for Delphi unisce diversi documenti aperti in un unico documento interleaved. Aggiunge GroupSize pagine da ciascuna sorgente per ogni turno, accetta un elenco di intervalli di pagine per sorgente, e tratta un intervallo discendente come 3-1 come un'inversione di quella sorgente. Una sola chiamata trasforma uno stack di fronti e uno stack di retri invertiti in ordine di lettura
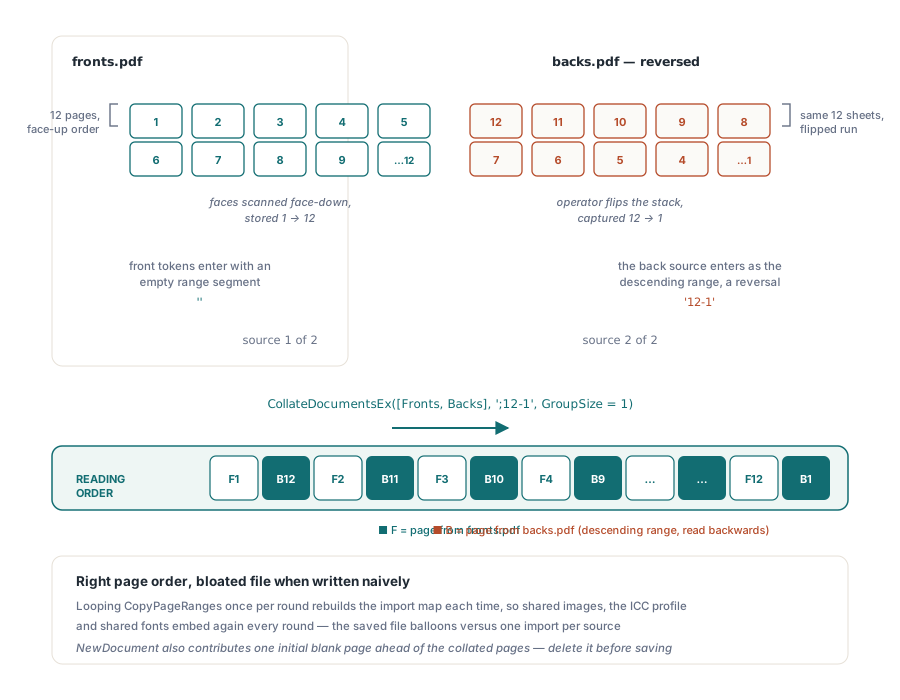
Lo scenario dietro questa API è banale e molto comune. Uno scanner alimentato a fogli con percorso single-sided elabora l'intera pila a faccia in giù, poi l'operatore ribalta la pila e la elabora di nuovo. Il risultato sono due PDF: i fronti in ordine, i retri in ordine inverso. Il file che l'utente vuole è uno solo, pagina 1 fronte, pagina 1 retro, pagina 2 fronte, e così via. Questo articolo tratta il problema dell'ordinamento e la trappola della duplicazione delle risorse che sta sotto di esso. Se il tuo interesse è invece il throughput della concatenazione grezza, vedi merge PDF veloce con shifting dei riferimenti a livello di byte; se gli input sono troppo grandi per stare interamente in memoria, vedi unire e dividere PDF di dimensioni gigabyte con accesso diretto
Lo scanner produce due pile, una delle quali al contrario
Fascicolare non è unire. Un merge concatena intervalli di pagine; una fascicolazione li interleaved, e il pattern di interleaving è una proprietà del dispositivo fisico che ha prodotto l'input. Sbagliare il pattern non rende il file leggermente sbagliato, lo rende illeggibile: ogni seconda pagina appartiene a un foglio diverso. Tre variabili descrivono quasi ogni caso reale: quante sorgenti sono nella rotazione, quante pagine arrivano da ciascuna sorgente per turno, e se una sorgente deve essere letta al contrario. CollateDocuments copre le prime due con un semplice array di handle di documento e un intero GroupSize. CollateDocumentsEx aggiunge la terza accettando un elenco di intervalli di pagine separati da punto e virgola, un segmento per sorgente, dove un segmento vuoto significa tutte le pagine di quella sorgente e un intervallo discendente la inverte. Entrambe le funzioni accodano alla fine del documento attualmente selezionato e restituiscono 1 in caso di successo, 0 per qualsiasi rifiuto
Perché la fascicolazione ingenua moltiplica la dimensione del file?
Perché la mappa di import che associa i numeri oggetto sorgente ai numeri oggetto target viene ricostruita a ogni chiamata di copia, e qualunque cosa sia raggiungibile da più di un blocco viene importata una volta per blocco. All'interno di PDF Library for Delphi, TPDFDocument.CopyPagesFromDoc resetta la sua NewIndObjList all'inizio di ogni invocazione. Quella lista è l'unica memoria che il copiatore ha di ciò che ha già trasferito. Chiamala una volta con un intervallo di dieci pagine e un font condiviso da tutte e dieci le pagine viene incorporato una sola volta. Chiamala dieci volte con una pagina ciascuna e lo stesso font viene incorporato dieci volte. Questo pesa molto di più sulle scansioni che sui documenti testuali, perché una pagina scansionata è un singolo grande image XObject e gli oggetti condivisi sono quelli con peso reale: un profilo ICC incorporato, una catena /DecodeParms condivisa, un timbro o filigrana come form XObject applicato a ogni foglio, il font del layer di testo OCR. Il modo ovvio di scrivere una fascicolazione round-robin è un ciclo sui turni, e quel ciclo è esattamente il caso patologico
// Non fare così. Ogni chiamata a CopyPageRanges ricostruisce la mappa di import,
// quindi tutto ciò che le due sorgenti condividono internamente viene importato una volta per
// turno invece che una volta per sorgente.
var
  RoundIndex: Integer;
begin
  for RoundIndex := 1 to 12 do
  begin
    PDF.CopyPageRanges(Fronts, IntToStr(RoundIndex));
    PDF.CopyPageRanges(Backs, IntToStr(13 - RoundIndex));
  end;
end;
Dodici round, due sorgenti, ventiquattro import map. Nulla ti avverte. L'ordine delle pagine è corretto, ogni pagina viene renderizzata, e l'unico sintomo è un file diverse volte più grande della somma dei suoi input. Su un job in batch da 300 pagine il moltiplicatore non è un errore di arrotondamento, è la differenza tra un archivio che rientra nel budget di conservazione e uno che non rientra
Importa una volta sola, poi riordina l'albero delle pagine
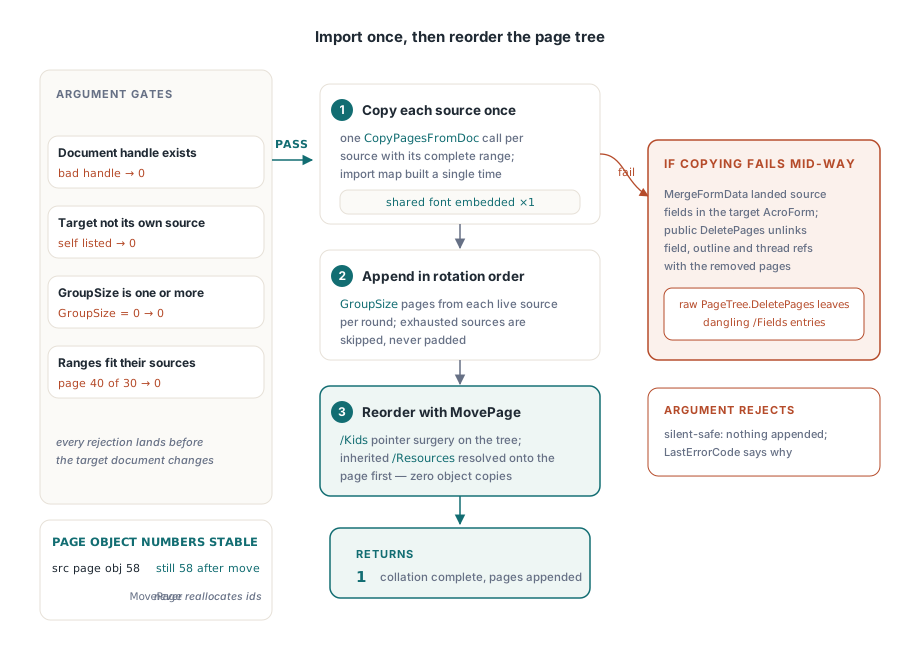
La soluzione è separare le due questioni che il ciclo ingenuo aveva fuso insieme. La copia decide quali oggetti esistono nel target; l'ordinamento decide dove si trovano le pagine nell'albero delle pagine. CollateDocumentsEx copia ogni sorgente esattamente una volta, in un'unica chiamata CopyPagesFromDoc con l'intervallo completo di quella sorgente, così ogni sorgente ottiene una sola mappa di import e le risorse condivise vengono scritte una sola volta. Solo dopo che ogni sorgente è arrivata avviene l'interleaving, e avviene interamente tramite TPDFPageTree.MovePage
Gli spostamenti di pagina sono gratuiti nel senso che conta qui. ISO 32000-1 §7.7.3 definisce l'albero delle pagine come una struttura bilanciata di dizionari di nodo i cui array /Kids contengono riferimenti indiretti, con /Count che porta il totale delle foglie a ogni nodo. Rilocare una pagina significa rimuovere un riferimento indiretto da un array /Kids, inserirlo in un altro, aggiustare entrambi i valori /Count, e ripuntare il /Parent della pagina. Nessuno stream di contenuto viene toccato, nessuna risorsa viene duplicata, nessun oggetto viene creato. L'oggetto pagina mantiene il suo numero oggetto, ed è anche per questo che i numeri oggetto rimangono stabili come avviene in sostituzione di pagine che preserva i numeri oggetto. C'è un ulteriore dettaglio che uno spostamento di pagina ingenuo sbaglia e MovePage no. ISO 32000-1 §7.7.3.4 permette a /Resources, /MediaBox, /CropBox e /Rotate di essere ereditati da un nodo antenato invece di essere dichiarati sulla pagina. Una pagina che eredita le sue risorse dal nodo A e viene poi spostata sotto il nodo B eredita silenziosamente qualcosa di diverso, o niente del tutto. MovePage quindi risolve il valore ereditato e lo scrive sul dizionario della pagina prima della rilocazione, così la pagina porta i propri attributi attraverso lo spostamento
Cosa fa realmente la passata di riordino?
Esegue un selection sort contro la semantica insert-at. L'ordine desiderato relativo al blocco viene calcolato prima: percorri le sorgenti in rotazione, prendi fino a GroupSize indici da ciascuna, salta una sorgente esaurita, ripeti finché ogni pagina è piazzata. Questo produce una permutazione sul blocco aggiunto. Applicarla è la parte scomoda, perché MovePage è un insert, non uno swap, quindi ogni spostamento fa scorrere di uno tutto ciò che sta tra la posizione vecchia e quella nuova
L'implementazione mantiene un array Current che modella dove si trova ora ogni pagina aggiunta, scandisce in avanti dalla posizione K alla ricerca della pagina che appartiene a K, emette lo spostamento, poi fa scorrere le voci dell'array per rispecchiare ciò che lo spostamento ha fatto all'albero. È O(n al quadrato) in operazioni su array e zero in copie di oggetti, che è il trade corretto per questo carico di lavoro: una fascicolazione da 500 pagine è un quarto di milione di rimescolamenti di interi e nemmeno un byte di dati immagine duplicati. Gli intervalli discendenti e le pagine ripetute non richiedono gestione speciale in questo passaggio perché PLParsePageRangeList viene chiamata con ordinamento disattivato e duplicati consentiti, quindi l'ordine richiesto sopravvive intatto al parsing
Intervalli invertiti e il merge duplex in una sola chiamata
Con l'inversione espressa come intervallo, il caso del doppio passaggio a plano collassa in una singola chiamata. I fronti vogliono il loro ordine naturale e i retri vogliono 12-1, e il primo segmento vuoto prima del punto e virgola indica che la prima sorgente contribuisce con tutte le sue pagine
var
  PDF: TPDFlib;
  Target, Fronts, Backs: Integer;
begin
  PDF := TPDFlib.Create;
  try
    Target := PDF.NewDocument;
    if PDF.LoadFromFile('fronts.pdf', '') <> 1 then
      Exit;
    Fronts := PDF.SelectedDocument;
    if PDF.LoadFromFile('backs.pdf', '') <> 1 then
      Exit;
    Backs := PDF.SelectedDocument;
    PDF.SelectDocument(Target);
    // fronti 1..12 in ordine, retri scansionati al contrario: F1 B12 F2 B11 ...
    if PDF.CollateDocumentsEx([Fronts, Backs], ';12-1', 1) = 1 then
      PDF.SaveToFile('duplex.pdf');
  finally
    PDF.Free;
  end;
end;
Due comportamenti in questo snippet vale la pena esplicitare. Le pagine fascicolate vengono accodate al documento selezionato, quindi un documento creato con NewDocument contribuisce con la sua pagina bianca iniziale prima di esse, e devi eliminarla se non la vuoi. E le sorgenti possono essere disomogenee: con GroupSize 2 su una sorgente da tre pagine e una da cinque pagine, i turni risultano A1 A2 B1 B2, poi A3 B3 B4 quando A è quasi esaurita, poi B5 da sola, perché una sorgente esaurita viene semplicemente saltata invece che riempita
Rollback, campi modulo, e cosa porta con sé la fascicolazione
Ogni argomento viene validato prima che il target venga toccato. Un handle di documento mancante, il documento selezionato elencato come propria sorgente, un GroupSize inferiore a uno, un numero di segmenti che non corrisponde al numero di sorgenti, un intervallo che nomina una pagina che la sorgente non ha: tutti questi casi restituiscono 0 con il target invariato. Il fallimento durante la copia è il caso più difficile, ed è gestito tramite il pubblico DeletePages piuttosto che il grezzo PageTree.DeletePages. Il motivo è specifico. La copia viene eseguita con MergeFormData abilitato, quindi i campi modulo della sorgente sono già stati accodati all'array /AcroForm /Fields del target nel momento in cui una sorgente successiva fallisce. Eliminare le pagine a livello di albero delle pagine spoglierebbe le pagine dei widget e lascerebbe quei riferimenti di campo penzolanti; il percorso pubblico scollega il campo, i riferimenti dell'outline e dei thread di articolo insieme alle pagine
if PDF.CollateDocumentsEx([Fronts, Backs], ';12-1', 1) = 0 then
  // Non è stato accodato nulla e il target è identico byte per byte a prima.
  // 412 è l'errore di copia; 0 significa che gli argomenti sono stati rifiutati
  // durante la validazione, prima che qualsiasi pagina venisse toccata.
  Log(Format('collate rejected, LastErrorCode=%d', [PDF.LastErrorCode]));
La fascicolazione porta le pagine, le loro annotazioni e i loro campi modulo, e unisce l'elenco campi AcroForm, l'array dell'ordine di calcolo e il dizionario delle risorse predefinite. Outline e destinazioni con nome che vivono nei cataloghi sorgente restano con le sorgenti. L'albero degli outline di una pila di fronti scansionata è quasi sempre vuoto, quindi nel caso duplex non si perde nulla; quando fascicoli due documenti redatti, pianifica di ricostruire la navigazione sul risultato
PDF Library for Delphi distribuisce le funzioni di fascicolazione insieme al resto della sua superficie di assemblaggio pagine, così il flusso di lavoro dello scanner, l'estrazione basata su intervalli e i percorsi per file di grandi dimensioni risiedono tutti dietro un unico componente in Delphi e C++Builder. Il riferimento completo dell'API e una build di prova sono disponibili sulla pagina prodotto losLab Delphi PDF library