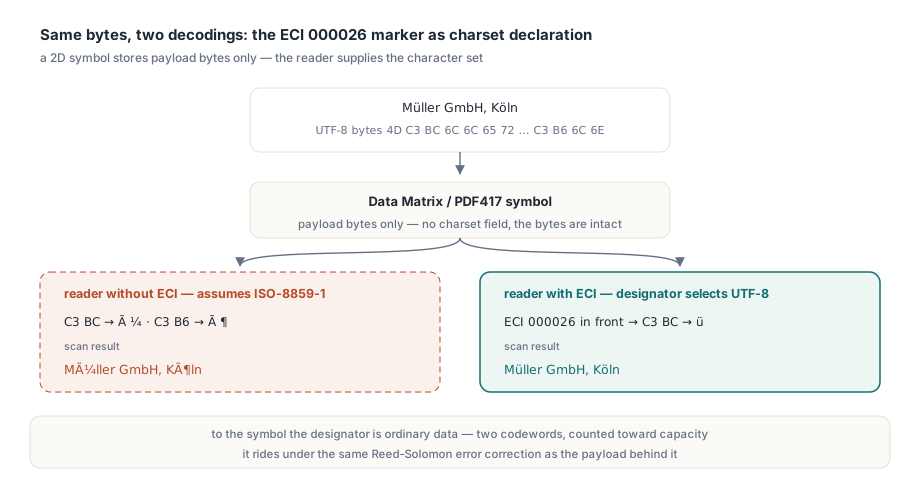
Un'etichetta di magazzino salva il destinatario Müller GmbH, Köln come UTF-8 in un simbolo Data Matrix, e ogni lettore palmare dello stabilimento la rilegge come Müller GmbH, Köln. Impostare la proprietà BarcodePayloadEncoding di PDFlibPas su bpeUTF8WithECI antepone un marcatore ECI 000026 ai dati, il che dice ai lettori Data Matrix e PDF417 di decodificare quei byte come UTF-8
Perché un payload UTF-8 si decodifica come Müller?
Il simbolo non contiene alcuna dichiarazione di charset, quindi il lettore ripiega sul set di caratteri a byte singolo predefinito della simbologia, che per Data Matrix è ISO-8859-1. Una ü UTF-8 sono i due byte C3 BC, che ISO-8859-1 mappa in à e ¼; ö diventa ö allo stesso modo. I byte in sé sono intatti. L'Extended Channel Interpretation è la dichiarazione di charset del mondo barcode. Il registro ECI dell'AIM assegna numeri ai set di caratteri, e lo 000026 è quello dell'UTF-8; un simbolo che si apre con un designatore ECI dice a un lettore conforme di decodificare tutto ciò che segue in quel set di caratteri. Per il simbolo il designatore è dati ordinari. Occupa due codeword in entrambe le simbologie discusse qui, conta ai fini della capacità, ed è protetto dalla stessa correzione errori Reed-Solomon per i barcode 2D che copre il payload che sta dietro
Posizioni dei codeword ECI in Data Matrix e PDF417
Ogni simbologia ha uno slot fisso per il marcatore. Mettetelo altrove e il simbolo o non si decodifica affatto o si decodifica con spazzatura in testa:
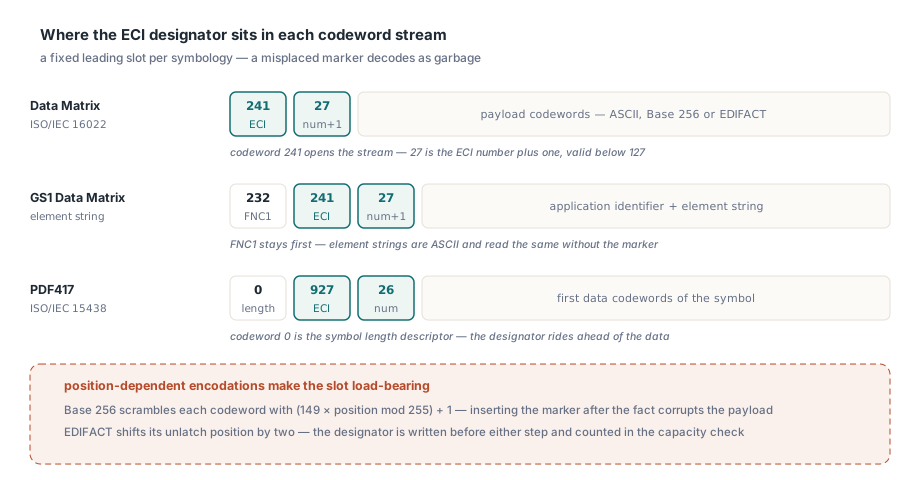
- Data Matrix (ISO/IEC 16022): codeword 241, poi il numero ECI più uno nella forma a codeword singolo usata per i valori sotto 127, quindi 27 per UTF-8. Apre lo stream di dati
- GS1 Data Matrix: l'FNC1 (codeword 232) deve restare in prima posizione, quindi PDFlibPas colloca il marcatore subito dopo, se lo richiedete; le element string GS1 però sono tratte da un sottoinsieme di ASCII, e senza marcatore si leggono allo stesso modo
- PDF417 (ISO/IEC 15438): il codeword 0 è il descrittore di lunghezza del simbolo, e il marcatore segue come codeword 927 e 26, davanti al primo codeword di dati
Base 256 è il caso insidioso. Quella codifica, la modalità Data Matrix compatta per byte arbitrari, rimescola ogni codeword con un valore pseudo-casuale derivato dalla sua posizione assoluta nel simbolo, (149 × position mod 255) + 1. Anteporre il marcatore dopo il rimescolamento fa sì che ogni byte dietro di lui sia stato rimescolato per una posizione due posti prima di quella che il lettore vede, così l'intero payload si derimescola in valori sbagliati. La codifica EDIFACT ha una versione più lieve della stessa dipendenza: la sua posizione di unlatch slitta di due quando il marcatore va davanti al payload. PDFlibPas scrive il marcatore nello stream di codeword prima che entrambi i passi girino, e il controllo di capacità che sceglie la dimensione del simbolo lo include già. Il codice dell'etichetta per entrambe le simbologie:
uses
  SysUtils, PDFlibrary;

procedure PrintConsigneeLabel(const FileName: string);
var
  Pdf: TPDFlib;
begin
  Pdf := TPDFlib.Create;
  try
    Pdf.NewDocument;                                // crea e seleziona la pagina 1
    Pdf.SetPageSize('A4');
    Pdf.SetMeasurementUnits(1);                     // millimetri
    Pdf.SetOrigin(1);                               // Top si misura dal bordo superiore

    Pdf.BarcodePayloadEncoding := bpeUTF8WithECI;   // byte UTF-8 + ECI 000026
    if Pdf.DrawDataMatrixSymbol(20, 20, 0.5, 'Müller GmbH, Köln',
      1,      // Encoding: 1 = codifica ASCII
      0,      // SymbolSize: 0 = la prima dimensione della tabella che basta
      100) <> 1 then                                // orientamento normale, quiet zone predefinita di 1 modulo
      raise Exception.CreateFmt('Data Matrix failed (%d)', [Pdf.LastErrorCode]);

    if Pdf.DrawPDF417SymbolEx(20, 50, 'Zustellung: Müller GmbH, Köln',
      0, 0, 0,  // orientamento, colonne, righe: automatici
      -1,       // livello di correzione errori automatico
      0.3, 3.0) <> 1 then
      raise Exception.Create('PDF417 failed');

    // Uno scanner che capisce ECI dovrebbe restituire il testo tedesco per entrambi i simboli
    Pdf.BarcodePayloadEncoding := bpeSystemANSI;    // si torna al predefinito
    Pdf.SaveToFile(FileName);
  finally
    Pdf.Free;
  end;
end;
NewDocument crea già la pagina 1 e la seleziona, quindi i simboli finiscono sulla prima pagina senza chiamare NewPage. SetOrigin(1) sposta l'origine nell'angolo in alto a sinistra, il che rende Top la distanza del bordo superiore del simbolo dalla sommità della pagina. Con l'origine predefinita in basso a sinistra, un Top di 10 mm colloca quel bordo 10 mm sopra il fondo del foglio, e un simbolo di 11 mm ne sborda. DrawDataMatrixSymbol ritorna 1 in caso di successo. Per dati che non sa codificare — un payload che supera il simbolo più grande una volta contato il marcatore, o la dimensione fissa che avete chiesto — ritorna 0, imposta LastErrorCode a 302 e non disegna nulla, così l'esempio tratta qualunque valore diverso da 1 come un errore
Ogni etichetta deve portare il marcatore ECI?
No, e il predefinito lo riflette. BarcodePayloadEncoding accetta tre valori, ognuno pensato per una popolazione di lettori diversa:
bpeSystemANSI(il predefinito) converte il testo attraverso la code page ANSI di sistema e non scrive alcun marcatore, che è ciò che si aspettano i layout di etichette costruiti con le funzioni QR, PDF417 e Data Matrix di PDFlibPasbpeUTF8scrive byte UTF-8 senza marcatore, per sistemi chiusi in cui è il vostro software a leggere il barcode e a presumere già UTF-8bpeUTF8WithECIscrive byte UTF-8 e li etichetta con ECI 000026
Il prezzo di etichettare tutto è il supporto da parte dei lettori. L'elaborazione ECI è un'opzione di configurazione su molti scanner, e a seconda di quell'impostazione un dispositivo può rifiutare il simbolo o passare il designatore all'host come testo: la convenzione AIM è una backslash e sei cifre, quindi l'applicazione riceve \000026Müller GmbH, Köln. Attivate il marcatore simbolo per simbolo, per i payload che contengono testo non ASCII, e distribuitelo insieme alla modifica del profilo scanner. Un payload a byte singolo resta una scelta sensata quando ogni nome ci sta nella code page che i vostri lettori presumono. ü è il byte FC sia in Windows-1252 sia in ISO-8859-1, quindi un indirizzo tedesco scritto con bpeSystemANSI su un sistema Windows dell'Europa occidentale si decodifica correttamente su un lettore Data Matrix che di ECI non ha mai sentito parlare. Il testo giapponese non ha un ripiego del genere
Dimensione del simbolo: selezione automatica, template fissi e rettangoli
I due codeword del marcatore raramente fanno da soli. In codifica ASCII la riga del destinatario con bpeSystemANSI tiene ü e ö come byte singoli sopra 127, due codeword ciascuno, e l'intera riga costa 19 codeword, che stanno in un simbolo 20×20 con i suoi 22 codeword di dati. Come UTF-8 le due lettere diventano quattro byte alti e la riga costa 23. Il marcatore porta il totale a 25. Serve il 22×22, e il salto viene dai soli byte UTF-8, dato che 23 oltrepassa già il 20×20. Un template che blocca SymbolSize a 9 (20×20) prende 0 ed errore 302 da DrawDataMatrixSymbol appena la codifica cambia, e nello slot del barcode non viene disegnato nulla
Il dimensionamento automatico può cambiare la forma. Con SymbolSize a 0, PDFlibPas percorre in ordine la lista delle dimensioni di ISO/IEC 16022 e prende la prima voce la cui capacità di dati contiene lo stream. Le sei dimensioni rettangolari stanno in quella lista in mezzo ai quadrati. Un payload che riempiva un simbolo 26×26 (44 codeword di dati) ne vuole 46 con il marcatore, e la voce seguente che ne contiene 46 è 16×48 con 49, prima di 32×32 con 62. A 0,5 mm per modulo un quadrato di 13 mm diventa una striscia di 8 × 24 mm. Un 22×22 pieno fa lo stesso: 30 codeword più due stanno in 16×36. I payload piccoli restano quadrati — tre codeword che riempivano un 10×10 diventano cinque e stanno in 12×12, che precede l'8×18 nella lista. Se l'etichetta riserva uno slot quadrato, bloccate SymbolSize sul quadrato che potete permettervi (16 per 32×32) e lasciate che sia l'errore 302 a dirvi quando un nome è troppo lungo per quello slot; il dimensionamento automatico va bene per layout che accettano entrambe le forme
PDF417 cresce con una regola diversa. Con ErrorLevel a -1, l'encoder pianifica la correzione errori sui livelli minimi raccomandati di ISO/IEC 15438, che salgono a 41, 161 e 321 codeword, descrittore di lunghezza incluso. Uno stream di 39 codeword diventa 41 con il marcatore, il livello minimo passa da 2 a 3, e il blocco di correzione errori che pianifica cresce da 8 a 16 codeword. Sono dieci codeword in più. Con colonne e righe automatiche, l'encoder dispone il rettangolo partendo da quel totale maggiore, così un payload seduto appena sotto una soglia guadagna più area di quanto suggeriscano i suoi due codeword di marcatore
Quale codifica tiene piccolo un Data Matrix UTF-8?
Confrontate direttamente i due costi. La codifica ASCII comprime una coppia di cifre in un codeword e l'ASCII semplice a un codeword per carattere, ma ogni byte sopra 127 ne costa due: uno Upper Shift (235) e il byte meno 127. Base 256 paga un latch e un campo di lunghezza una volta sola — un codeword di lunghezza fino a 249 byte, due oltre — e poi un codeword per byte, senza compressione delle cifre. Per testo senza sequenze di cifre, Base 256 vince appena un payload contiene tre byte alti. La riga di Müller lo fa già, con 21 codeword contro 23. Le sequenze numeriche lunghe spingono il bilancio di nuovo verso ASCII, perché lì ogni coppia di cifre risparmia un codeword. L'helper qui sotto conta entrambi i costi e disegna con la modalità più economica; l'ASCII puro non prende affatto il marcatore, visto che si legge identico sotto ogni set di caratteri:
// Disegna un Data Matrix per testo Unicode con la codifica più economica
function DrawUnicodeDataMatrix(Pdf: TPDFlib; Left, Top, ModuleSize: Double;
  const Text: WideString): Integer;
var
  Bytes: UTF8String;
  I, HighBytes, AsciiCost, Base256Cost, Mode: Integer;
  Saved: TPDFlibBarcodePayloadEncoding;
begin
  Bytes := UTF8Encode(Text);
  HighBytes := 0;
  AsciiCost := 0;
  I := 1;
  while I <= Length(Bytes) do
  begin
    if (I < Length(Bytes)) and (Bytes[I] >= '0') and (Bytes[I] <= '9') and
       (Bytes[I + 1] >= '0') and (Bytes[I + 1] <= '9') then
    begin
      Inc(AsciiCost);                    // coppia di cifre: un codeword
      Inc(I, 2);
      Continue;
    end;
    if Ord(Bytes[I]) > 127 then
    begin
      Inc(HighBytes);
      Inc(AsciiCost, 2);                 // Upper Shift + (byte - 127)
    end
    else
      Inc(AsciiCost);
    Inc(I);
  end;
  if Length(Bytes) <= 249 then
    Base256Cost := Length(Bytes) + 2     // latch + un codeword di lunghezza
  else
    Base256Cost := Length(Bytes) + 3;    // latch + due codeword di lunghezza

  Saved := Pdf.BarcodePayloadEncoding;
  try
    if HighBytes = 0 then
    begin
      Pdf.BarcodePayloadEncoding := bpeSystemANSI;  // ASCII puro: nessun marcatore
      Mode := 1;
    end
    else
    begin
      Pdf.BarcodePayloadEncoding := bpeUTF8WithECI;
      if Base256Cost < AsciiCost then
        Mode := 3                        // Base 256
      else
        Mode := 1;                       // ASCII
    end;
    Result := Pdf.DrawDataMatrixSymbol(Left, Top, ModuleSize, Text, Mode, 0, 100);
  finally
    Pdf.BarcodePayloadEncoding := Saved;
  end;
end;
Per 東京都千代田区 la forma UTF-8 è di 21 byte, tutti sopra 127. Con il marcatore, Base 256 vuole 25 codeword di dati e la codifica ASCII 44, che secondo la tabella delle capacità è un simbolo 22×22 contro uno 26×26 alla stessa dimensione di modulo. Quel 26×26 è pieno. Un codeword in più e salta a 16×48. I payload GS1 (modalità 7) restano fuori dall'helper perché le loro element string sono ASCII. I codici QR passano la loro data mode tramite l'argomento EncodeOptions di DrawQRCode, e i simboli Aztec disegnati da PDFlibPas portano un flag ECI 26 automaticamente ogni volta che i byte del payload sono UTF-8 valido con almeno un carattere non ASCII
Per la riga di Müller il marcatore costa due codeword, mentre il passaggio da 20×20 a 22×22 — da 10 a 11 mm con moduli da 0,5 mm — lo causano i byte UTF-8. Se lo slot della vostra etichetta ha quel millimetro in più, impostate BarcodePayloadEncoding a bpeUTF8WithECI sull'istanza TPDFlib della PDFlibPas Delphi PDF Library subito prima che il simbolo del destinatario venga disegnato, e riportatelo a bpeSystemANSI per i simboli legacy sulla stessa pagina