Un encoder Reed-Solomon che memorizza il termine costante del polinomio generatore per primo e poi divide partendo dal termine di grado massimo non sta calcolando affatto la correzione degli errori. HotPDF aveva esattamente questo in quattro encoder di barcode 2D, QR, Data Matrix, PDF417 e Aztec, e ogni simbolo prodotto portava un blocco di controllo che nessuno scanner conforme poteva usare
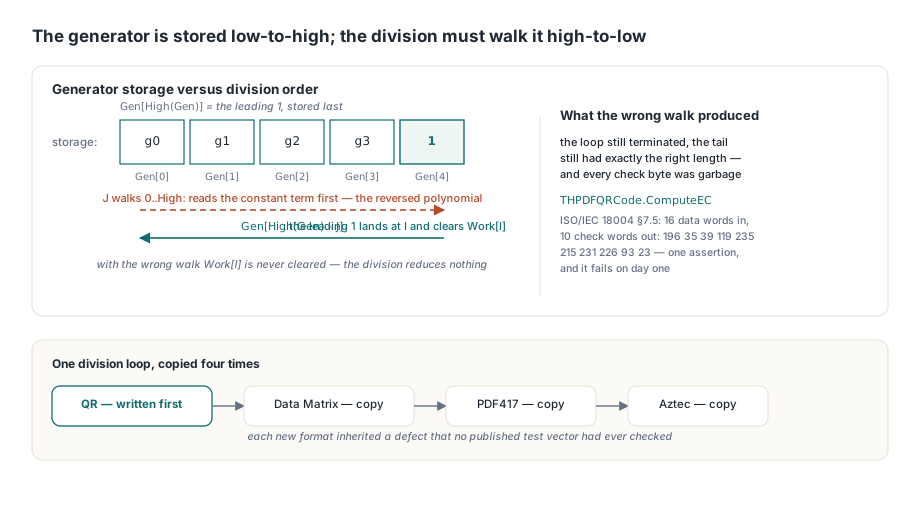
La parte interessante non è lo sbaglio aritmetico. È la propagazione. Un encoder è stato scritto per primo, il suo loop di divisione è stato copiato negli altri tre, e ogni nuovo formato ha ereditato un difetto che non era mai stato validato contro un singolo test vector pubblicato. I simboli venivano comunque renderizzati, i finder pattern stavano al posto giusto, le dimensioni erano corrette. Solo i byte che permettono a un barcode 2D di sopravvivere a una macchia erano spazzatura
Un polinomio invertito, copiato in quattro encoder
La causa principale è un disallineamento nell'ordine di memorizzazione dentro il loop di divisione sintetica. Tutti e quattro gli encoder di HotPDF costruiscono il polinomio generatore con i coefficienti dal basso verso l'alto, quindi Gen[0] contiene il termine costante e Gen[High(Gen)] il coefficiente direttivo monico. Il loop di divisione indicizzava Gen[J] in avanti mentre percorreva il messaggio, il che è aritmeticamente identico a dividere per il polinomio invertito. C'era una seconda conseguenza che nascondeva la prima: poiché il coefficiente direttivo non arrivava mai alla posizione I, Work[I] non veniva mai azzerato, quindi la divisione non riduceva mai davvero nulla. Il loop terminava comunque e riempiva comunque la coda con un array della lunghezza esatta
// THPDFQRCode.ComputeEC nell'unità HPDFQRCode.pas
Gen := GeneratorPoly(ECCount);            // Gen[0] è il termine costante
SetLength(Work, Length(Data) + ECCount);
for I := 0 to High(Data) do
  Work[I] := Data[I];
for I := Length(Data) to High(Work) do
  Work[I] := 0;
for I := 0 to High(Data) do
begin
  Factor := Work[I];
  if Factor = 0 then
    Continue;
  // Gen[High(Gen)] è l'1 direttivo che azzera Work[I]; percorrere Gen
  // in avanti divide invece per il polinomio invertito
  for J := 0 to High(Gen) do
    Work[I + J] := Work[I + J] xor GFMul(Gen[High(Gen) - J], Factor);
end;
Il fix è la singola espressione di indice Gen[High(Gen) - J]. Dopo di essa, THPDFQRCode.ComputeEC riproduce l'esempio svolto di ISO/IEC 18004 §7.5: il blocco in modalità byte versione 1-M 32 91 11 120 209 114 220 77 67 64 236 17 236 17 236 17 produce le dieci check word 196 35 39 119 235 215 231 226 93 23. È una sola asserzione, e sarebbe fallita al primo giorno
Perché anche il simbolo Aztec perdeva il suo payload?
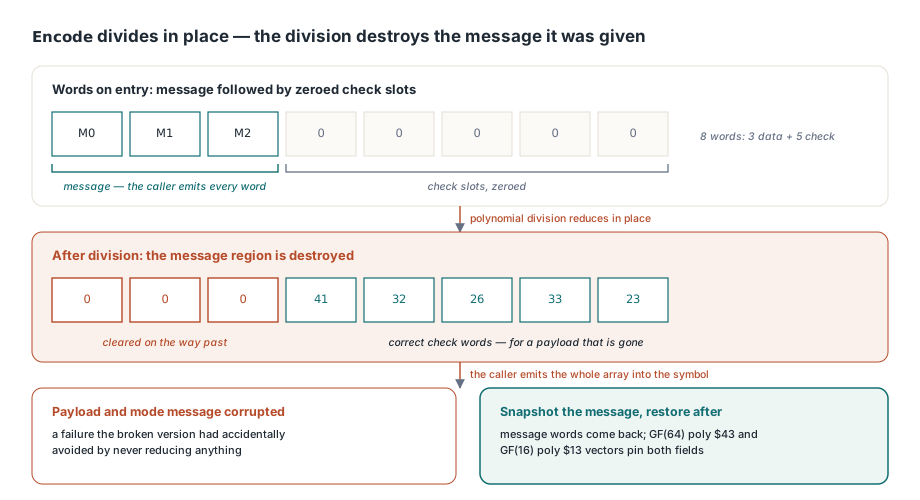
Aztec portava una versione più pesante dello stesso bug perché TAztecGF.Encode divide in place. La routine riceve Words che contiene il messaggio seguito dagli slot delle check word azzerati, e il chiamante emette l'intero array nel simbolo. La divisione polinomiale distrugge il dividendo mentre lo riduce, quindi una volta corretto il loop perché riducesse davvero, le parole del messaggio venivano sovrascritte lungo il percorso. Payload e mode message uscivano entrambi corrotti, un fallimento che la versione rotta aveva evitato per caso non riducendo mai nulla
// TAztecGF.Encode nell'unità HPDFAztec.pas
SetLength(Message, DataCount);
for I := 0 to DataCount - 1 do
  Message[I] := Words[I];
for I := 0 to DataCount - 1 do
begin
  Factor := Words[I];
  if Factor = 0 then
    Continue;
  for J := 0 to ECCount do
    Words[I + J] := Words[I + J] xor Multiply(Gen[ECCount - J], Factor);
end;
// La divisione azzera la regione del messaggio, ma il chiamante emette
// l'intero array nel simbolo, quindi le parole di dati devono tornare
for I := 0 to DataCount - 1 do
  Words[I] := Message[I];
Aztec usa due campi diversi, e la fixture di regressione li esercita entrambi. In GF(64), il campo di un simbolo a sei bit costruito dal polinomio primitivo $43, le parole 12 45 3 con cinque check word producono 41 32 26 33 23 mentre le prime tre restano intatte. In GF(16), il campo della mode message con polinomio primitivo $13, le parole 5 9 producono 11 15 6 8. Entrambi passano per l'hook HPDFAztecTestEncode contro ISO/IEC 24778
Perché Data Matrix ha bisogno di due fix invece di uno?
THPDFDataMatrix.ComputeEC impilava un secondo errore, indipendente, sopra quello condiviso: costruiva il polinomio generatore con radici che partono da α^0, mentre l'Allegato E di ISO/IEC 16022 specifica radici da α^1. Correggere solo l'indice di divisione dà le check word 146 107 90 179 128 per l'esempio standard, che sembrano plausibili esattamente come quelle corrette e restano comunque illeggibili. Entrambi i difetti dovevano sparire prima che i numeri combaciassero
// THPDFDataMatrix.ComputeEC nell'unità HPDFDataMatrix.pas
Gen[0] := 1;
for I := 0 to ECCount - 1 do
begin
  // DMExp[I + 1]: le radici vanno da alpha^1 a alpha^ECCount, non da alpha^0
  for J := ECCount downto 1 do
    Gen[J] := GFMul(Gen[J], DMExp[I + 1]) xor Gen[J - 1];
  Gen[0] := GFMul(Gen[0], DMExp[I + 1]);
end;
Il punto di riferimento è abbastanza piccolo da stare in un commento. La stringa '123456' si codifica nelle code word ASCII 142 164 186, un simbolo 10x10 porta cinque check word, e il blocco corretto è 114 25 5 88 102. HPDFDataMatrixTestComputeEC espone la class function dietro la guardia {$IFDEF HPDF_TESTING}, quindi la fixture asserisce quei cinque valori senza istanziare un encoder né renderizzare una pagina. Il campo di Galois stesso, costruito da InitDMTables sul polinomio primitivo $12D nelle tabelle DMExp e DMLog, era corretto da sempre, ed è esattamente per questo che il bug si è nascosto così bene
PDF417 divide su un campo primo, dove i segni contano
PDF417 richiedeva quattro modifiche invece di una, perché GF(929) è un campo primo e non un campo di estensione binaria: l'addizione non è xor, la sottrazione non è addizione, e il segno di ogni fattore del generatore è aritmetica reale, non notazione. Ogni fattore deve essere (x - 3^i), che in codice significa moltiplicare per 929 - GF929Pow(3, I); il passo di riduzione deve sottrarre; le radici partono da 3^1 secondo la sezione 5.5 di ISO/IEC 15438; e Factor va memorizzato in una locale prima che il loop interno giri, perché il passaggio a J = 0 scrive Work[I] e altrimenti cambierebbe il moltiplicatore sotto i suoi piedi. HPDFPDF417TestComputeEC fissa il risultato corretto: le code word 5 453 178 121 239 con quattro parole di correzione danno 452 327 657 619
// THPDFPDF417.ComputeEC nell'unità HPDFPDF417.pas
for I := 1 to ECCount do
begin
  Root := (929 - GF929Pow(3, I)) mod 929;   // il fattore è (x - 3^i)
  for J := ECCount downto 1 do
    Gen[J] := (GF929Mul(Gen[J], Root) + Gen[J - 1]) mod 929;
  Gen[0] := GF929Mul(Gen[0], Root);
end;
// ...
Factor := Work[I];                          // latch: J = 0 riscrive Work[I]
if Factor = 0 then
  Continue;
for J := 0 to ECCount do
  Work[I + J] := (Work[I + J] + 929 - GF929Mul(Gen[ECCount - J], Factor)) mod 929;
Il finder di Data Matrix era stato installato alla rovescia
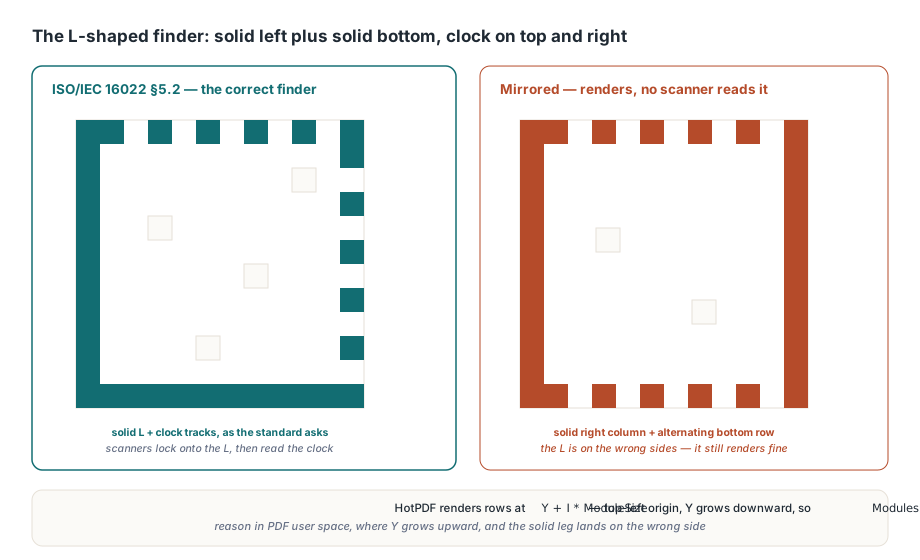
Le check word corrette non salvano un simbolo il cui finder pattern è specchiato, e la stessa release ha dovuto correggere anche quello. Il codice di posizionamento disegnava una colonna sinistra piena, una colonna destra piena e moduli alternati lungo le righe superiore e inferiore, mentre la sezione 5.2 di ISO/IEC 16022 chiede una colonna sinistra piena più una riga inferiore piena, il finder a L, con la clock track alternata lungo la riga superiore e la colonna destra. Quello che rende facile sbagliarla in direzione opposta è la convenzione sulle coordinate: HotPDF renderizza le righe di moduli a Y + I * ModuleSize, che è la semantica con origine in alto a sinistra, quindi Modules[Size - 1, *] è la riga inferiore del simbolo stampato. Chiunque ragioni nello user space di PDF, dove Y cresce verso l'alto, mette il lato pieno dalla parte sbagliata e non vede nulla di sospetto sullo schermo
Perché quattro encoder rotti hanno superato i test per anni?
Perché i test asserivano la struttura e i difetti erano nell'aritmetica. I casi QR, Data Matrix e Aztec esistenti controllavano i moduli del finder, i timing pattern e le dimensioni del simbolo, tutte cose genuinamente corrette; nessun test aveva mai confrontato una check word con un vector pubblicato. La seconda ragione si generalizza ancora di più. HotPDF include un decoder QR integrato, e usarlo per validare l'encoder sembra un round trip ovvio, tranne che questo decoder legge le code word di dati e non esegue alcuna correzione Reed-Solomon, quindi rileggeva esattamente ciò che l'encoder aveva scritto e riportava successo. Quando un encoder e un decoder condividono un'assunzione, un test di round trip dimostra che concordano, non che uno dei due abbia ragione. Un codice di correzione degli errori va validato contro i vector stampati nello standard, mai contro il tuo stesso decoder. La fixture THPDFBarcodeECCTests ora contiene un test per formato, ognuno nominato per ciò che fissa, e ognuno arriva all'aritmetica attraverso un hook compilato solo sotto {$IFDEF HPDF_TESTING}:
QRCheckWordsMatchISO18004Exampleasserisce le dieci check word dell'esempio in modalità byte versione 1-MDataMatrixCheckWordsMatchISO16022Exampleasserisce 114 25 5 88 102 per le code word 142 164 186PDF417CheckWordsMatchGF929Referenceasserisce 452 327 657 619 su GF(929) con radici da 3^1 a 3^4AztecCheckWordsKeepMessageAndMatchReferenceasserisce le check word e che le parole del messaggio sopravvivano alla divisione in place
Quattro domande intercettano la maggior parte di questa famiglia in qualsiasi encoder tu mantenga. Il tuo ordine di memorizzazione del generatore corrisponde all'ordine di indicizzazione della divisione, e riesci a indicare la riga che lo dimostra? Le radici partono dove dice lo standard, α^1 per Data Matrix e 3^1 per PDF417? Una divisione in place ripristina la regione del messaggio dopo? Almeno un test confronta le check word, invece del conteggio dei moduli, con un numero stampato in una specifica? Anche il raggio d'azione conta quando decidi cosa fare degli artefatti esistenti. I simboli generati prima della v2.748.0 vengono renderizzati e spesso scansionano in condizioni ideali, perché un'immagine pulita non ha bisogno di correzione per essere letta; ciò che hanno perso è la tolleranza ai danni che è l'intera ragione per scegliere questi formati. Etichette long-lived e documenti archiviati con simboli interessati meritano di essere rigenerati invece di essere controllati al volo con la fotocamera del telefono. Gli encoder vivono nel supporto dei barcode in HotPDF, accanto al percorso di decodifica QR con la sua gestione delle orientazioni e al layer di output dei report che posiziona i simboli sulla pagina; il riferimento completo dell'API barcode arriva con la HotPDF Delphi Component per Delphi e C++Builder