A HotXLS Delphi Component v2.384.67 óta úgy hasonlít össze két szöveges értéket, ahogy az Excel 16: kis- és nagybetű nélkül, a Windows user locale „word sort" sorrendjében, amit a CompareStringW ad vissza NORM_IGNORECASE flaggel. A kötőjel és az aposztráf első körben kimarad, és csak a döntetlent bontja, így a ="a-b">"ab" TRUE, a többi írásjel viszont a számok és betűk elé sorol, így a ="a~b"<"ab" is TRUE. Ugyanez a sorrend vezérli mostantól az összehasonlító operátorokat, a > / < feltételeket, a tartományrendezést és a VLOOKUP-ot
Senki nem „collation eltérés" címmel jelenti a hibát. A jelentések azt írják, hogy a COUNTIF(A:A,">M") a szerveren két sorral többet számol, mint Excelben, hogy az riport szolgáltatás által rendezett árlista az X-100-ot oda teszi, ahová az Excel nem, vagy hogy a VLOOKUP("ABC",...) #N/A-t ad, pedig az oszlop nyilvánvalóan tartalmaz abc-t. Mindhárom ugyanabból a kérdésből jön: ha mindkét operandus szöveg, melyik a kisebb? Az Excelnek pontos válasza van, ez nem az, amit a legtöbb Delphi kód ad, és v2.384.67 előtt a HotXLS három különböző választ adott aszerint, melyik kódút kérdezett
Milyen szabállyal hasonlít össze az Excel két szöveget?
Az Excel a user locale word sortjával hasonlít, kis- és nagybetűt ignorálva. A word sort a Windows NLS összehasonlító függvényeinek alapértelmezett collationje: a betűk nyelvi sorrendjük szerint hasonlítanak, nem kódpontjuk szerint, az ékezetes betűk az alapbetűjük mellett ülnek, és két karakter kap külön bánásmódot. A kötőjel, a -, és az aposztráf, a ', első körben ignorálva van, így a co-op és a coop egymás mellé kerül, és csak akkor dönt a jelenlétük, ha a stringek többi része döntetlen. Minden más írásjel számít, és a számok elé sorol, a számok pedig a betűk elé
A táblázat megmutatja, mindez mit jelent a gyakorlatban, mellette a két összehasonlítással, amihez egy Delphi fejlesztő leginkább nyúlna. Az Excel oszlop azokat az ítéleteket tartja, amiket az Excel 16 adott az IF(A<B,...)-ra, amiket a HotXLS v2.384.67 óta reprodukál
| A vs B | Excel 16 / HotXLS | CompareStr (ordinális) | CompareText |
|---|---|---|---|
"a-b" vs "ab" | nagyobb | kisebb | kisebb |
"a'b" vs "ab" | nagyobb | kisebb | kisebb |
"a~b" vs "ab" | kisebb | nagyobb | nagyobb |
"a_b" vs "ab" | kisebb | kisebb | nagyobb |
"ab" vs "AB" | egyenlő | nagyobb | egyenlő |
"é" vs "f" | kisebb | nagyobb | nagyobb |
"Z" vs "f" | nagyobb | kisebb | nagyobb |
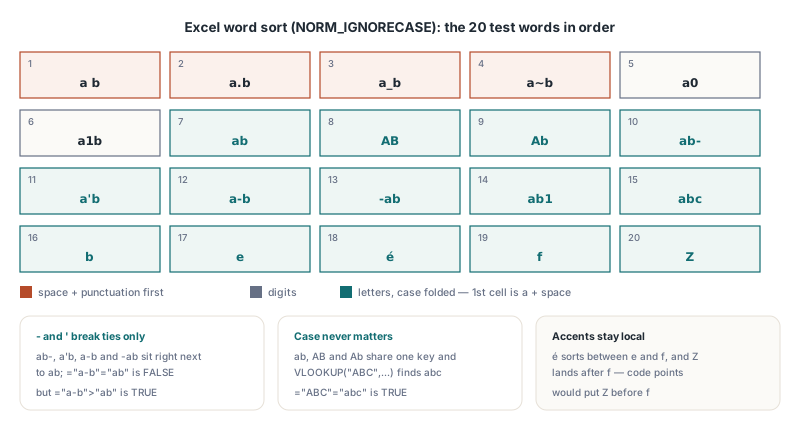
Két következmény könnyen elkerüli a figyelmet. Először a kötőjel döntetlenbontó szerepe miatt a ="a-b"="ab" FALSE: a stringek közel szomszédok a rendezésben, mégsem egyenlők. Másodszor az egyenlőség a kis- és nagybetűt teljesen ignorálja, így az ab, AB és Ab ugyanaz a kulcs, ameddig bármely összehasonlítás illet. Húsz tesztszó rendezése az Excel Range.Sort-jával ezt adja: a b, a.b, a_b, a~b, a0, a1b, ab / AB / Ab, ab-, a'b, a-b, -ab, ab1, abc, b, e, é, f, Z; az ab csoporton belül az ignorált karakter helyzete dönt
Hogyan szúrták le az Excel szövegsorrendjét?
Az Excel szövegsorrendjét mérésből azonosították, nem dokumentációból, mert az Excel dokumentációja nem nevezi meg a collationt. A teszt 4000 véletlen stringpárt generált ASCII írásjelekből, számokból, mindkét betűfajtából, szóközökből, é-ből, ß-ből, ä-ből, kínai karakterekből, full-width formákból és nem törhető szóközből, 0-tól 4-ig terjedő hosszokkal, a párok felét egymás near-missjeként megépítve. Az Excel 16 minden párra kiértékelte az IF(A<B,-1,IF(A=B,0,1))-t, és az ítéleteket különböző flagkészletekkel vetették össze a Windows összehasonlító API-jával
- Csak
NORM_IGNORECASE(alapértelmezett word sort, user locale): nincs valódi eltérés. Az egyetlen 7 eltérés olyan cellák voltak, amiknek az egész tartalma'volt, amit az Excel szövegprefix karakterként elfogyaszt, így mintavételi artefaktok voltak, nem collation eltérések NORM_IGNORECASESORT_STRINGSORT-tal: 41 eltérés. A string sort a kötőjelet és az aposztráfot rendes szimbólumként kezeli, ami pontosan az a viselkedés, ami az Excelnek nincs megNORM_IGNOREWIDTHhozzáadásával: másképp rossz, mert ugyanannak a betűnek a full-width és half-width formáját egyenlővé teszi, az Excel pedig elkülöníti őket
Egy második, kézzel válogatott ellenőrzés mind a 190 párt összevetette, amik 20 csavaros szóból kihúzhatók, meg az Excel Range.Sort-jának eredményét ugyanazon az oszlopon. Mindkettő egyetértett a sima NORM_IGNORECASE word sorttal, és azok a 190 ítélet meg a rendezett sorrend mostantól a HotXLS regressziós suitejának része, futtatva mind a klasszikus TXLSWorkbook enginen, mind a XLSX natív TXLSXWorkbook enginen
Miért kapja el a CompareText és az ordinális összehasonlítás a rossz sorrendet?
A CompareText és az ordinális összehasonlítás azért kapja el rosszul az Excel sorrendjét, mert UTF-16 kódegységeket hasonlít, és a kódpontsorrend az írásjeleket a betűkhöz képest tetszőleges helyekre teszi. A kötőjel U+002D, az aposztráf U+0027, mindkettő minden betű alatt, így egy ordinális összehasonlítás az "a-b"-t kisebbnek mondja az "ab"-nál, ahelyett hogy a kötőjelet döntetlenbontónak tekintné. A hullámjel U+007E minden betű fölött ül, így a "a~b" nagyobbnak jön ki, az Excel ellenkezőjéhez képest. A Delphi RTL CompareText-je csak az a..z-t hajtja nagybetűre, aztán kódegységeket hasonlít, ami második torzítást ad: az aláhúzás U+005F a nagybetűs és kisbetűs betűk között fekszik, így a nagybetűsítés az "a_b"-t az "ab" alól fölé viszi. Egyik függvény sem tudja, hogy az é az e és az f közé tartozik
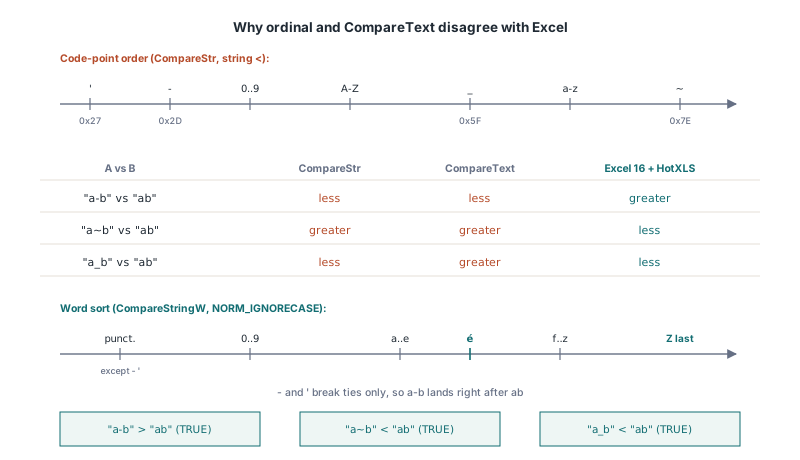
A szokásos Delphi eszközök a vonal mindkét oldalára esnek:
- A
CompareStr, a string<operátor és aTComparer<string>.Default(amiCompareStr-t hív) ordinális és kis- és nagybetű-érzékeny, így aTArray.Sort<string>comparer nélkül aZ-t teszi azfelé - A
CompareTextés aSameTextordinálisak csak-ASCII kis- és nagybetűhajtogatás után - A Delphi RTL
AnsiCompareText-je ésWideCompareText-je WindowsonCompareString(LOCALE_USER_DEFAULT, NORM_IGNORECASE, ...)-ot hív, ugyanazt a hívást, ami egyezik az Excelel. Egy rendezettTStringListaz alapbeállításaival (UseLocaleTrue,CaseSensitiveFalse)AnsiCompareText-en át megy, és ezért vele is egyetért az Excellel - POSIX célokon a Delphi RTL az
AnsiCompareText-et ICU collationre irányítja, ami más algoritmus más írásjelszabályokkal, a Free PascalAnsiCompareText-je WindowsonCompareStringA-t hív az ANSI kódlapra váltás után, ami elveszíti minden karaktert, amit az a kódlap nem tud reprezentálni
A locale-érzékeny RTL függvények Windowson tehát implementáció szerint jók, nem szerződés szerint, és az Excel sorrendjét igénylő kódnak jobban jár, ha explicitté teszi az API hívást. A HotXLS-nek belül ugyanez a keveréke volt. Az összehasonlító operátorok mindkét stringet nagybetűsítették és kódpontokat hasonlítottak, a feltételfüggvények > / < ágai a Delphi kis- és nagybetű-érzékeny Variant összehasonlítását használták, a VLOOKUP / HLOOKUP pedig ugyancsak azt a kis- és nagybetű-érzékeny Variant összehasonlítást, ezért a VLOOKUP("ABC",A1:A20,1,FALSE) nem találhatta meg az abc-t. A tartományrendezés már WideCompareText-et használt. Három út, három sorrend
Mi változott a HotXLS v2.384.67-ben?
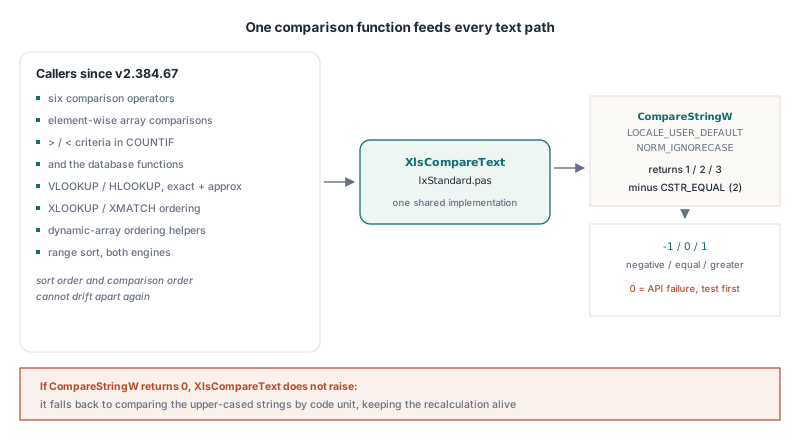
v2.384.67 óta a HotXLS számító és rendező útjainak szöveg-szöveg összehasonlításai egyetlen függvényen mennek át, a lxStandard.pas-beli XlsCompareText-en, ami CompareStringW(LOCALE_USER_DEFAULT, NORM_IGNORECASE, ...)-ot hív, és levonja a CSTR_EQUAL-t. A hívók a hat összehasonlító operátor, az elemenkénti összehasonlítások a tömbképletekben, a COUNTIF-szerű feltételek >, <, >= és <= ágai meg az adatbázisfüggvények, a VLOOKUP és HLOOKUP (pontos és közelítő), a dinamikus tömb függvények mögötti rendező helperek meg az XLOOKUP / XMATCH, és mindkét engine tartományrendezése. A tartományrendezés ugyanarra a függvényre irányítása garantálja, hogy a rendezési sorrend és az összehasonlítási sorrend többé nem tud szétesni, ami azért fontos, mert a szövegre futtatott közelítő VLOOKUP csak akkor értelmes, ha az oszlop abban a sorrendben volt rendezve, amiben a keresés hasonlít
uses
  System.Variants, lxHandleX;

var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Sheets.Add('Data');  // A Calculate az aktív sheetre értékel
    Writeln(VarToStr(Book.Calculate('="a-b">"ab"')));   // True: a kötőjel csak döntetlent bont
    Writeln(VarToStr(Book.Calculate('="a-b"="ab"')));   // False: döntetlen eldöntve, nem egyenlő
    Writeln(VarToStr(Book.Calculate('="a~b"<"ab"')));   // True: az írásjel előbb jön
    Writeln(VarToStr(Book.Calculate('="ABC"="abc"')));  // True: a kis- és nagybetű nem számít
  finally
    Book.Free;
  end;
end;
A kereszttípusos összehasonlítások külön szabály, és nem változtak: minden szám minden szöveges érték alatt van, minden szöveges érték minden boolean alatt, ahogy a cikk az összehasonlítási láncokról, üres operandusokról és SUMIF-ről írja. A word sort csak akkor él, ha mindkét operandus szöveg. A wildcard illesztés is külön: egy "a*" vagy "=ab" szerű feltétel minta vagy egyenlőségteszt, amit a útmutató az Excel wildcardokhoz COUNTIF-ben, MATCH-ben és DSUM-ban fed le, és az itt tárgyalt collation csak a rendezési operátorokat dönti el
A következő példa a 20 tesztszót betölti egy oszlopba, TXLSXWorksheet.SortRange-szel rendezi, és megnéz egy feltételszámlálást és egy keresést. A számlálások azok, amiket az Excel 16 adott ugyanarra az oszlopra
const
  Words: array [0..19] of string = ('ab', 'a-b', 'a~b', 'a_b', 'AB', 'a b',
    'ab1', 'ab-', '-ab', 'abc', 'a''b', 'Ab', 'b', 'a.b', 'a1b', 'a0',
    #$00E9, 'e', 'f', 'Z');
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  i: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Words');
    for i := 0 to High(Words) do
      Sheet.Cells[i + 1, 1].Value := WideString(Words[i]);

    // Excel 16 ugyanazon az oszlopon: 11, 11, 14
    Writeln(VarToStr(Book.Calculate('=COUNTIF(A1:A20,">ab")')));
    Writeln(VarToStr(Book.Calculate('=COUNTIF(A1:A20,"<a-b")')));
    Writeln(VarToStr(Book.Calculate('=COUNTIF(A1:A20,">=AB")')));

    // #N/A volt v2.384.67 előtt: a keresés kis- és nagybetű-érzékenyen hasonlított
    Sheet.Cells[1, 3].Formula := '=VLOOKUP("ABC",A1:A20,1,FALSE)';
    Book.Recalculate;
    Writeln(VarToStr(Sheet.Cells[1, 3].Value));                // abc

    // Egy kulcsoszlop, növekvő: a b, a.b, a_b, a~b, a0, a1b, ab, AB, Ab, ...
    Sheet.SortRange(1, 1, 20, 1, [1], [False]);
    for i := 1 to 20 do
      Writeln(VarToStr(Sheet.Cells[i, 1].Value));
  finally
    Book.Free;
  end;
end;
A TXLSXWorksheet.SortRange stabil merge sortot használ, így azok az ab, AB és Ab, amik egyenlőként hasonlítanak, megtartják a rendezés előtti relatív sorrendjüket. Az üres cellák mindkét irányban a végére mennek, akárcsak Excelben
Hogyan adja vissza a saját Delphi kódodban az Excel sorrendjét?
Hogy a saját Delphi kódodban megadd az Excel szövegsorrendjét, hívd a CompareStringW-t LOCALE_USER_DEFAULT-tal és NORM_IGNORECASE-szel, és ne adj hozzá SORT_STRINGSORT-ot vagy NORM_IGNOREWIDTH-ot. A visszatérési érték nem előjeles összehasonlítási eredmény: az API CSTR_LESS_THAN-t (1), CSTR_EQUAL-t (2) vagy CSTR_GREATER_THAN-t (3) ad, és 0-t, ha a hívás elbukik. Vonj ki 2-t, hogy megkapd a szokásos negatív / nulla / pozitív konvenciót, és előbb tesztelj 0-ra, mert egy eredménynek nézett hiba -2 lesz, csendes „kisebb"
uses
  Winapi.Windows, System.SysUtils, System.Generics.Defaults,
  System.Generics.Collections;

// Az Excel szövegsorrendje: user locale word sort, kis- és nagybetű nélkül
function ExcelCompareText(const A, B: string): Integer;
var
  R: Integer;
begin
  R := CompareStringW(LOCALE_USER_DEFAULT, NORM_IGNORECASE,
    PWideChar(A), Length(A), PWideChar(B), Length(B));
  if R = 0 then
    RaiseLastOSError;          // a 0 hiba, nem összehasonlítási eredmény
  Result := R - CSTR_EQUAL;    // az 1/2/3 -1/0/1 lesz
end;

var
  Keys: TArray<string>;
begin
  Keys := ['abc', 'a-b', 'AB', 'a~b', '-ab', 'ab'];
  TArray.Sort<string>(Keys, TComparer<string>.Construct(
    function(const L, R: string): Integer
    begin
      Result := ExcelCompareText(L, R);
    end));
  // a~b, ab / AB (egyenlő, bármely sorrend), a-b, -ab, abc
end;
A TArray.Sort nem stabil, így azok a kulcsok, amik egyenlőként hasonlítanak, mint az ab és AB, bármely sorrendben jöhetnek ki; ha az egyenlő kulcsok eredeti sorrendje számít, rendezz egy index tömböt az eredeti pozícióval másodlagos kulcsként. Az ellenkező eset is előfordul: néha egy oszlop nem követheti az Excel sorrendjét, például cikkszámoknál, ahol az X-100 és az X100 különböző kódok, és kódpont szerint kellene sorolniuk. A TXLSXWorksheet.SortRange-nek van olyan overloadja, ami TXLSSortCompareEvent-et vesz át, egy function(const Left, Right: Variant): Integer of object szignatúrájú metódust, és azt használja a beépített összehasonlítás helyett
uses
  System.SysUtils, System.Variants, lxStandard, lxHandleX;

type
  TPartNumberOrder = class
    function Compare(const Left, Right: Variant): Integer;
  end;

function TPartNumberOrder.Compare(const Left, Right: Variant): Integer;
begin
  // Egy egyéni comparer üres cellákat is kap (Nullként): te helyezd el őket
  if VarIsNull(Left) or VarIsNull(Right) then
    Exit(Ord(VarIsNull(Left)) - Ord(VarIsNull(Right)));
  Result := CompareStr(VarToStr(Left), VarToStr(Right));   // ordinális, kis- és nagybetű-érzékeny
end;

var
  Sheet: TXLSXWorksheet;   // egy kitöltött sheet, 2..501 sor, A..D oszlopok
  Order: TPartNumberOrder;
begin
  // ...
  Order := TPartNumberOrder.Create;
  try
    // A oszlopra kulcsolva, növekvő
    Sheet.SortRange(2, 1, 501, 4, [1], [False], xlsSortByRows,
      xlsSortExcelLike, Order.Compare);
  finally
    Order.Free;
  end;
end;
Ha egyéni comparer van megadva, a HotXLS kihagyja a saját üreskezelését, és nyers kulcsértékeket ad át, így a comparernek Null-lal kell bajlódnia. Csökkenő kulcsnál a HotXLS negálja, amit a comparer ad vissza, ami az üreseket is a tetőre viszi, hacsak a comparer nem számol velük. Tartsd észben, hogy az így rendezett oszlop már nem abban a sorrendben van, amit az Excel közelítő VLOOKUP-ja vagy egy bináris kereséses XLOOKUP vár; azoknak a módoknak a csapdáit eltérően rendezett adaton a útmutató az XLOOKUP és XMATCH bináris kereséses módokhoz fedi le
Miért rendezhet ugyanaz a munkafüzet másképp egy másik gépen?
Ugyanaz a munkafüzet azért rendezhet másképp egy másik gépen, mert az Excel szövegsorrendje a Windows user locale-jétől függ, és a HotXLS szándékosan követi azt a függőséget. A word sort nyelvfüggő: a svéd collation például az ä-t az z után teszi, ahol az angol és a német az a mellett tartja. Az Excel örökli azt a locale-től, ami alatt fut, így egy stockholmi kolléga által újraszámolt munkafüzet más COUNTIF(...,">y")-t adhat vissza, mint ugyanaz a fájl egy chicagói asztalon. A HotXLS LOCALE_USER_DEFAULT-ot ad át, hogy az eredményei ugyanazon a gépen egyezzenek az Excelel; bármely rögzített locale azt tenné, hogy a HotXLS minden, eltérő beállítású gépen szembefordulna az Excelel
Három gyakorlati következménye van a szerveroldali generálásnak:
- A számító locale azé a fióké, aminek a folyamata alatt fut. Egy Windows szolgáltatás vagy IIS application pool más regionális formátumot használhat, mint a fejlesztő asztala, így az IDE-ben látott eredmények nem automatikusan azok, amiket a production számol
- A fájlba írt cache-elt képleteredmények a generáló gép locale-jét tükrözik. Az Excel a saját locale-jével számol újra, így egy érték megváltozhat, amikor a fájlt máshol nyitják meg és újraszámolják; az az Excel viselkedése, nem HotXLS artefakt
- A locale-ek főleg az ékezetes betűkben, azokban a betűkapcsolatokban térnek el, amiket egyes nyelvek egyetlen betűként kezelnek, meg a nem latin írásrendszerekben, így az egyszerű angol szavakra korlátozott tesztadat nem leplezi le a problémát
A platformhatár egyszerű. A HotXLS Windows library, Win32-re és Win64-re építve Delphivel és C++Builderrel, meg win32 / win64 célokra Lazarusszal és Free Pascallel, és mindezek a buildek ugyanazt a CompareStringW-t hívják. Nincs külön nem-Windows collation út. Az egyetlen fallback egy elbukott API hívásra szól: ha a CompareStringW 0-t ad, az XlsCompareText a nagybetűsített stringeket hasonlítja kódegységenként ahelyett, hogy kivételt dobna egy újraszámolás közepén, ami tartja a számolást, de többé nem garantálja az Excel sorrendjét
Gyorsreferencia: Excel szövegösszehasonlítás a HotXLS-ben
- Szabály: user locale word sort
NORM_IGNORECASE-szel,SORT_STRINGSORTnélkül,NORM_IGNOREWIDTHnélkül, a HotXLS-ben v2.384.67 óta - A
-és'csak döntetlent bont: a="a-b">"ab"TRUE és a="a-b"="ab"FALSE - A többi írásjel a számok elé, a számok a betűk elé sorol: a
="a~b"<"ab"és a="a0"<"ab"TRUE - A kis- és nagybetű soha nem számít: a
="ABC"="abc"TRUE és aVLOOKUP("ABC",...)megtalálja azabc-t - Lefedett utak: összehasonlító operátorok, tömbösszehasonlítások,
>/<feltételek,VLOOKUP/HLOOKUP, dinamikus tömb rendezés,SortRangemindkét engineben - Nem fedi le ez a szabály: vegyes típusok (szám < szöveg < boolean) és wildcard feltételek, amiknek megvannak a maguk szabályaik
- Delphi kódban:
CompareStringW(LOCALE_USER_DEFAULT, NORM_IGNORECASE, ...), tesztelj 0-ra, vonj kiCSTR_EQUAL-t; kerüld aCompareText-et,CompareStr-t és aTComparer<string>.Default-ot, amikor az eredménynek egyeznie kell az Excelel - Az eredmények attól a locale-től függenek, aminek a fiókja alatt a kód fut, Excelben és HotXLS-ben egyaránt
A hétköznapi szavak minden szabály alatt ugyanúgy sorolnak, így csak a kötőjeles kódok, írásjelek és ékezetes nevek fedik le a rossz collationt. A HotXLS mostantól mindannyiuknál az Excel válaszát adja mind az XLS, mind az XLSX engineben. Licencelési részletek, támogatott Delphi és C++Builder verziók és a próbaverzió letöltése a HotXLS Delphi Excel component oldalon található