A HotXLS Delphi Component a =1<2<3-ot FALSE-ként értékeli, ugyanazt a választ adva, mint az Excel 16, mert a v2.384.3 óta a képletelemző balról jobbra hajtja össze az összehasonlító operátorokat: a 1<2 TRUE-vá áll össze, a TRUE<3 pedig FALSE, mert egy logikai érték minden szám felett rangsorol. Ugyanez a kiadás az üres operandust egyszerre teszi egyenlővé a 0-val és a ""-dal, és megengedi a SUMIF-nek, hogy az egycellás összegtartományt a feltételtartomány alakjára nyújtsa. Mindegyik triviálisnak tűnik, amíg a Delphiben számolt munkafüzet el nem tér attól a munkafüzettől, amelyet Excelben nyitottak meg
Az eltérés jellemzően olyan képlettel kezdődik, amelyet valaki intuícióból írt. Valaki beírja a =0<B2<100-at, hogy ellenőrizze, a mennyiség a tartományban van-e, az Excel csendben FALSE-t válaszol minden sorra, és a munkalap beégetett hibával szállul ki. Egy számítómotor nem javíthatgathatja a felhasználó szándékát; a dolga az az érték előállítása, amelyet az Excel adna, hogy a HotXLS által a fájlba írt gyorsítótárazott eredmény egyezzen azzal, amit az Excel újraszámolás után mutat. A v2.384.3 előtt a HotXLS TRUE-t válaszolt erre a tartományellenőrzésre minden sorban, az ellenkező irányba tévedve, és egy szerveren generált riport ellentmondott ugyanannak a riportnak asztali gépen megnyitva
Miért ad FALSE-t az =1<2<3 az Excelben?
Az Excel azért ad FALSE-t, mert az összehasonlítások láncát (1<2)<3-ként olvassa, és a belső TRUE aztán elbukik a 3-as szám elleni típusrangsorolásban. A régi HotXLS parser ugyanazt a szöveget 1<(2<3)-ként olvasta: a lxFormula.pas-ban élő TXLSSyntax.Parse_expr egy operandust elemzett, meglátott egy összehasonlító tokent, és rekurzióba ment a Parse_expr-be a jobb oldalért, ami az operátort jobbra asszociatívvá teszi. Ez 1<TRUE-t ad, a szám pedig egy logikai érték alatt van, így az eredmény TRUE volt. A hiba szimmetrikus: a =3>2>1 TRUE az Excelben és FALSE volt a HotXLS-ben, az =1=1=TRUE pedig TRUE az Excelben és FALSE volt a javítás előtt. A CalculateFormula_ComparisonChainsFoldLeftToRight regresszió hét ilyen képletet szögez le az Excel 16 által adott értékekre, és mindegyiket mindkét motorarchitektúrán futtatja, a klasszikus TXLSWorkbook-on és az XLSX-natív TXLSXWorkbook-on, az a HotXLS képletmotor áttekintésében ismertetett Calculate metódust használva
const
  Formulas: array [0..6] of string = ('=1<2<3', '=3>2>1', '=(1<2)<3',
    '=1<(2<3)', '=1=1=TRUE', '=3>2>1=TRUE', '=1<2<3=FALSE');
  // Amit az Excel 16 ad vissza: FALSE, TRUE, FALSE, TRUE, TRUE, TRUE, TRUE
var
  Classic: IXLSWorkbook;
  Xlsx: TXLSXWorkbook;
  i: Integer;
begin
  Classic := TXLSWorkbook.Create;
  Xlsx := TXLSXWorkbook.Create;
  try
    // A TXLSXWorkbook.Calculate az aktív munkalapra értékel, és
    // Null-t ad vissza, ha a munkafüzetnek egyáltalán nincs munkalapja
    Xlsx.Sheets.Add('Data');
    for i := 0 to High(Formulas) do
      Writeln(Formulas[i], '  classic=', VarToStr(Classic.Calculate(Formulas[i])),
        '  xlsx=', VarToStr(Xlsx.Calculate(Formulas[i])));
  finally
    Xlsx.Free;
  end;
end;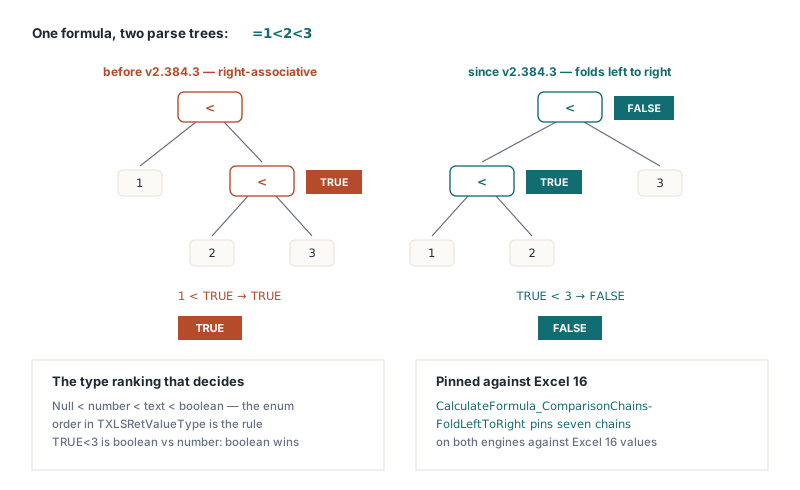
A javítás a Parse_expr-et ugyanolyan alakú hurokká alakítja, amilyet a Parse_expr1 már használ a +, a - és a & esetén. Az első operandust Parse_expr1-fel elemzi, és míg a következő token az =, a <>, a <, a >, a <= vagy a >= közül való, összehasonlító csomópontot hoz létre, a felgyűlt bal eredményt első gyerekként fűzi hozzá, a következő operandust Parse_expr helyett Parse_expr1-fel elemzi, az új csomópontot pedig a következő kör bal eredményévé teszi. Két részlet volt könnyen elrontható a rekurzió iterációvá alakításánál, és mindkettő ott lapul a karbantartói jegyzetekben: a felgyűlt csomópontot (lChild := Item; Item := nil) sorrendben kell átadni, a hibaág pedig a félig felépített csomópont felszabadítása után Exit-tel lépjen ki, ne pedig kihulljon a hurokból, és lógó fát adjon vissza
Hogyan rangsorolja a HotXLS a számokat, a szöveget és a logikai értékeket egy összehasonlításban?
A HotXLS úgy rangsorolja a vegyes típusokat, ahogy az Excel: minden szám kisebb minden szöveges értéknél, minden szöveges érték kisebb minden logikai értéknél. A lxCalc.pas-ban élő TXLSCalculator.CompareVariants a GetRetValueType-tal mindkét operandust a TXLSRetValueType = (xlVariantValue, xlNumberValue, xlStringValue, xlBooleanValue) enumerációba sorolja, és ha a két osztály eltér, egyszerűen összehasonlítja az ordinálisaikat, így az enum deklarációs sorrendje a típusok közti szabály. Egy osztályon belül az összehasonlítás a természetes, egy Excel-specifikus csavarral a szövegnél: mindkét karakterlánc átmegy az lxUpperCase-en, így a ="abc"="ABC" TRUE. Ez a rangsor az ok, amiért a lánc eredménye nélküle nem gondolkodható végig. A TRUE<3 nem a TRUE 1-re kényszerítése, hanem logikai érték összevetése számmal, és a logikai érték nyer. A dátumok a motor számára sorozatszámok (a varDate xlNumberValue-ként osztályozódik), tehát egy dátum mindig bármely szöveg alatt van, beleértve a véletlenül dátumnak tűnő szöveget is
Minek egyezik meg egy üres cella egy összehasonlításban?
Egy összehasonlító operandusként használt üres cella akkor egyenlő 0-val, ha a másik oldal szám, akkor ""-dal, ha a másik oldal szöveg, a v2.384.53 óta pedig FALSE-szal, ha a másik oldal logikai érték, tehát üres A1 mellett a =A1=0, a =A1="" és a =A1=FALSE egyaránt TRUE. A mind a hat összehasonlító operátort kiszolgáló TXLSCalculator.CompareVarValues a CompareVariants hívása előtt helyettesíti az üreset: ha pontosan az egyik operandus Null, WideString('')- lesz, ha a partnere karakterlánc, False, ha a partnere logikai érték, egyébként 0. Két üres továbbra is egymással egyezik meg helyettesítés nélkül. A számtani út mindig is 0-vá tette az üreset, ezért adott a =A1+1 eredménye 1-et, a CompareVariants viszont a Null-t saját legalsó ranggal tartotta, minden szám alatt, és az összehasonlító operátorok ezt a rangot használták közvetlenül
var
  Wb: IXLSWorkbook;
  Sh: TXLSWorksheet;
begin
  Wb := TXLSWorkbook.Create;
  Sh := Wb.Sheets.Add;
  Sh.Range['B1', 'B1'].Value := 5;      // az A1-et szándékosan hagyjuk üresen

  Writeln(VarToStr(Wb.Calculate('=A1=0')));    // True
  Writeln(VarToStr(Wb.Calculate('=A1=""')));   // True
  Writeln(VarToStr(Wb.Calculate('=A1<B1')));   // True: az üres 0-ként hasonlít
  Writeln(VarToStr(Wb.Calculate('=A1<0')));    // False; v2.384.3 előtt True volt
end;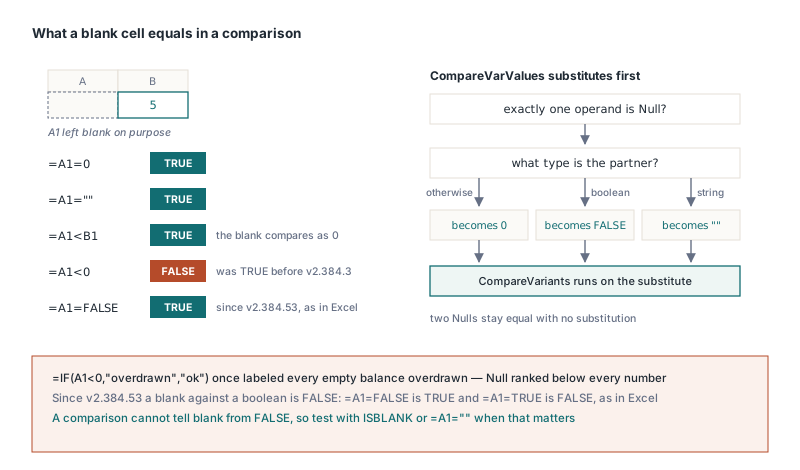
Az utolsó sor az, amelyik a gyakorlatban fájt. A régi rang alatt az üres minden számnál kisebb volt, a negatívokat is beleértve, így a =IF(A1<0,"overdrawn","ok") minden üres egyenlegcellát túllépésként címkézett, a =A1=0 pedig FALSE volt egy olyan cellára, amelyet minden felhasználó nullának mondana. A v2.384.3 után is maradt egy határ: a helyettesítés csak 0 és az üres karakterlánc közt választott, így egy logikai értékkel összehasonlított üres 0-vá vált, amely a TRUE alatt is és a FALSE alatt is rangsorol, és az üres A1-en a =A1=FALSE FALSE-t adott. A HotXLS 2.384.53 óta a logikai értékkel összehasonlított üres FALSE-ként kezelődik mind az XLS, mind az XLSX motorban, ahogy az Excel teszi: üres A1 mellett a =A1=FALSE és a =A1<TRUE TRUE-t ad, a =A1=TRUE pedig FALSE-t. Ez azt is jelenti, hogy az összehasonlítás nem tudja megkülönböztetni az üreset a FALSE-tól, sem az Excelben, sem a HotXLS-ben; ha egy munkalapnak kell ez a megkülönböztetés, ISBLANK-kal vagy =A1=""-gal teszteljen
Miért adott 0-t az egycellás összegtartományú SUMIF?
A SUMIF azért adott 0-t, mert a HotXLS az iterációt a két tartomány kisebbjére szorította, miközben az Excel a feltételtartomány alakját tartja meg, és csak a bal felső cellájáért használja az összegtartományt. A =SUMIF(A1:A10,">5",B1) az Excelben tehát B1:B10-et jelent, egy kényelem, amelyre sok kézzel rakott sablon támaszkodik. A közös munkás, a TXLSCalculator.GetValueItemRange2 korábban a sor- és oszlopszámait az értéktartományéra szűkítette, ami a példát egyetlen A1-B1 összevetésre redukálta. A v2.384.3 eltávolítja a szorítást: a hurok ma már a feltételtartományon végigsétál, és az összegtartomány bal felső sarkától azonos eltolással olvassa az egyes értékeket. Mivel a CalcSumIF és a CalcAverageIF is ugyanezt a munkást hívja, az AVERAGEIF ugyanazt az átméretezést kapja, és a feltételtartománynál nagyobb összegtartomány ugyanabból az okból a feltétel alakjára vágódik vissza. A középen álló feltételargumentum érték-osztályú, a két szélső hivatkozás-osztályú — a különbséget az implicit metszésről és argumentumosztályokról szóló cikk tárgyalja
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  Row: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Sales');
    for Row := 1 to 10 do
    begin
      Sheet.Cells[Row, 1].Value := Row;          // feltételoszlop: 1..10
      Sheet.Cells[Row, 2].Value := Row * 100;    // összegek: 100..1000
    end;
    Sheet.Cells[1, 4].Formula := '=SUMIF(A1:A10,">5",B1)';     // egycellás összegtartomány
    Sheet.Cells[2, 4].Formula := '=SUMIF(A1:A10,">5",B1:B10)'; // explicit összegtartomány
    if Book.Recalculate = lxOk then
      // Mind a D1, mind a D2 4000 (600+700+800+900+1000); a D1 v2.384.3 előtt 0 volt
      Writeln(VarToStr(Sheet.Cells[1, 4].Value), ' ', VarToStr(Sheet.Cells[2, 4].Value));
  finally
    Book.Free;
  end;
end;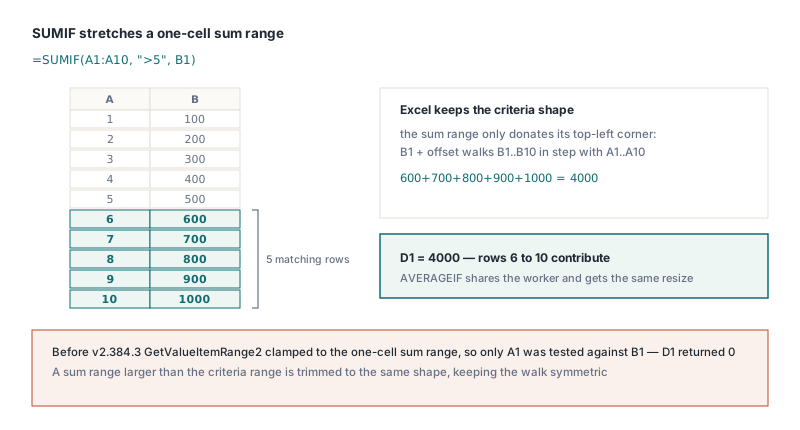
INDIRECT és YEARFRAC: két halkabb javítás
Az INDIRECT ma már tiszteli a második argumentumát, és egy érvényes hivatkozás utáni szöveg hiba a figyelmen kívül hagyás helyett. a1 FALSE esetén a szöveg abszolút R1C1-ként elemződik, így a =INDIRECT("R2C3",FALSE) a C2-t olvassa; a régi kód figyelmen kívül hagyta a jelzőt, az „R2”-t R oszlopként, 2. sorként olvasta, és csendben rossz cellát adott vissza. A jelző a változó típusa szerint diszpécselődik (logikai, szám vagy szöveg), mert egy karakterlánc-változó közvetlen Double-re konvertálása kivételt dob. A R[1]C[1] jellegű relatív R1C1 szöveg #REF!-et ad, mivel az INDIRECT-nek nincs képletcella-kiindulása, amelyre feloldhatná, az egyéb karakterekkel záruló A1 szöveg, a "B2 junk", szintén #REF!-et ad. A YEARFRAC 0 alap mellett ma már alkalmazza a NASD februárvégi szabályait, amelyeket a DAYS360 már implementált: ha mindkét dátum február utolsó napja, a zárónap 30 lesz, majd az február utolsó napjára eső kezdőnap is 30 lesz. 2024-02-29-től 2025-02-28-ig a szám ma már 360 nap, pontosan 1 tört, ahol a korábbi Days360US 359-et számolt
Mit garantálnak ezek a javítások, és mi volt a tanulság?
Az összehasonlítás-lánc viselkedését egy teszt garantálja, amely mindkét motort az Excel 16-ban mért értékekkel veti össze, és azért létezik ez a teszt, mert a javítás első leírása téves volt. A v2.384.3-as kiadási jegyzet eredetileg azt írta, hogy a balról jobbra hajtás miatt a =1<2<3 TRUE, ami pontosan az, amit a régi jobbra asszociatív parser gyártott, és pont az ellenkezője annak, amit mind az Excel, mind az új kód ad. Senki nem értékelte ki a példát; intuícióból íródott, hogy „1 kisebb, mint 2, ami kisebb, mint 3”. A jegyzetet kijavították, a hét képletes tesztet egy követő commitban hozzáadták, és az ebből kinőtt szabály mindenkire érvényes, aki táblázat-szemantikát dokumentál: futtassa le a példát Excelben, mielőtt leírja a várt értéket. Az üres operandus helyettesítése és a SUMIF átméretezés ugyanazt az Excel-viselkedést követi, a v2.384.53 óta az üres-logikai esetet is beleértve, és azok a feltételes aggregátumok, amelyeknek a szűrt vagy rejtett sorokat is ki kell hagyniuk, a SUBTOTAL és AGGREGATE rejtett sorokról szóló cikkében levő külön szabályokat követik
A HotXLS natív Delphi és C++Builder táblázatkezelő komponens, amely XLS-t, XLSX-et, ODS-t és CSV-t olvas, újraszámol és ír Excel telepítése nélkül, és az itt ismertetett összehasonlítási, üres- és SUMIF-szabályok abban a számítómotorban élnek, amelyet mindkét munkafüzet-architektúra közösen használ. A teljes függvénylista és a licencelési lehetőségek a HotXLS Delphi táblázatkezelő komponens termékoldalán