Une recherche de « two-x » dans un PDF fraîchement généré peut revenir sans aucun résultat alors que la page montre clairement ces cinq caractères. Déchargez la chaîne extraite en points de code et la raison est là : le tiret est revenu en U+00AD SOFT HYPHEN, et l'espace qui le suit en U+00A0 NO-BREAK SPACE. Les deux se regardent identiquement à l'écran. La différence vit dans la CMap ToUnicode, la table qu'un lecteur consulte pour ramener les codes de caractères vers l'Unicode, et elle vient d'un glyphe de police partagé par deux points de code
Les outils à chaînes ordinaires aggravent l'écart. Un export CSV découpe la ligne autrement, un outil de diff signale deux lignes qui se lisent pareil dans tous les visionneurs, et un correcteur orthographique prend « two-x » avec trait souple pour un mot inconnu. La normalisation Unicode ne vous sauve qu'à moitié : NFKC rabat U+00A0 sur une espace ordinaire car NBSP porte une décomposition de compatibilité, mais U+00AD n'a aucune décomposition, donc le trait souple survit à toutes les formes de normalisation
Pourquoi les espaces extraites reviennent en U+00A0 ?
Les espaces extraites deviennent U+00A0 quand la CMap ToUnicode est indexée par glyphe et qu'un glyphe est accessible depuis deux points de code. Dans Arial, le glyphe 3 sert à la fois U+0020 et U+00A0, et le glyphe du tiret sert à la fois U+002D et U+00AD. Une CMap construite du côté des glyphes doit dire quelque chose du CID 0003, et le générateur de PDFium dans FPDFText_LoadFont finit par dire deux choses : une entrée bfchar qui le mappe vers U+0020, et un bfrange sous forme de tableau qui mappe le même CID vers U+00A0
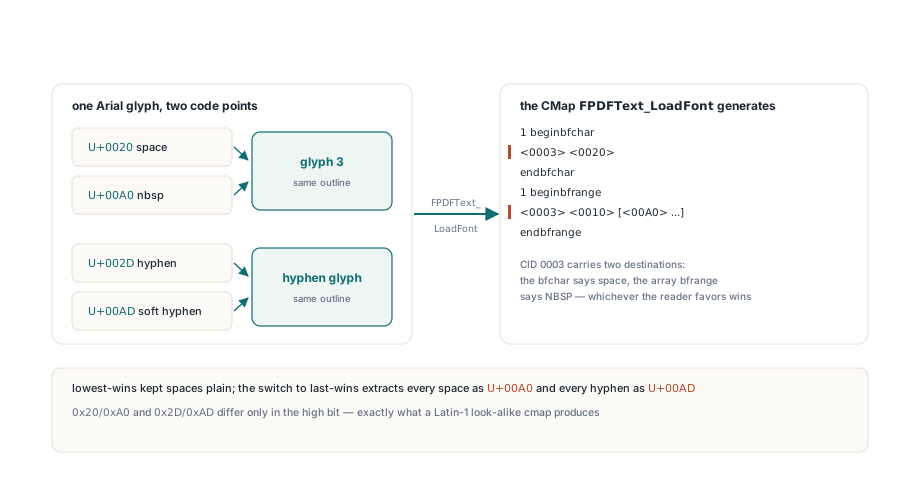
1 beginbfchar
<0003> <0020>
endbfchar
1 beginbfrange
<0003> <0010> [<00A0> ...]
endbfrange
L'ISO 32000-1 §9.10.3 décrit comment bfchar et bfrange mappent les codes vers l'Unicode, mais elle ne dit pas quelle entrée gagne quand deux d'entre elles revendiquent le même CID. Les lecteurs choisissent chacun leur règle de priorité. Un lecteur qui garde le mapping le plus bas ou le premier extrait une espace ordinaire ; le lecteur de PDFium garde le dernier, et comme la plage tableau suit le bloc bfchar, chaque espace écrite via une CMap indexée par glyphe s'extrait en NBSP et chaque tiret en trait souple. Le même texte peut donc s'extraire différemment dans deux visionneurs du même fichier
Les paires suivent un motif. 0x20/0xA0 et 0x2D/0xAD ne diffèrent que par le bit de poids fort, ce qu'une police produit quand sa cmap envoie les sosies Latin-1 vers le contour déjà utilisé pour le caractère ASCII. Le Omega majuscule grec (U+03A9) et le signe Ohm (U+2126) partagent un glyphe dans Arial aussi. Si un code d'extraction qui passait échoue maintenant sur des caractères invisibles, imprimez les points de code au lieu de faire confiance à la vue chaîne du débogueur ; les bases de la lecture de texte d'une page sont dans l'extraction de texte de documents PDF avec PDFium en Delphi
Comment PDFium Component indexe les polices système par point de code
PDFium Component ne demande jamais au moteur de générer cette CMap pour les polices système qui portent une cmap Unicode. Quand TPdf.AddText a besoin d'une police, le composant lit la table sfnt cmap de la police elle-même, en préférant une sous-table de format 12 et en retombant sur le format 4. Les points de code reviennent triés et dédupliqués, et le CID k+1 est attribué au k-ième point de code, le CID 0 restant .notdef. Une CIDToGIDMap explicite envoie chaque CID vers son glyphe. U+0020 et U+00A0 reçoivent donc deux CID différents qui dessinent le même contour, et la CMap ToUnicode que le composant écrit mappe chaque CID vers exactement un point de code
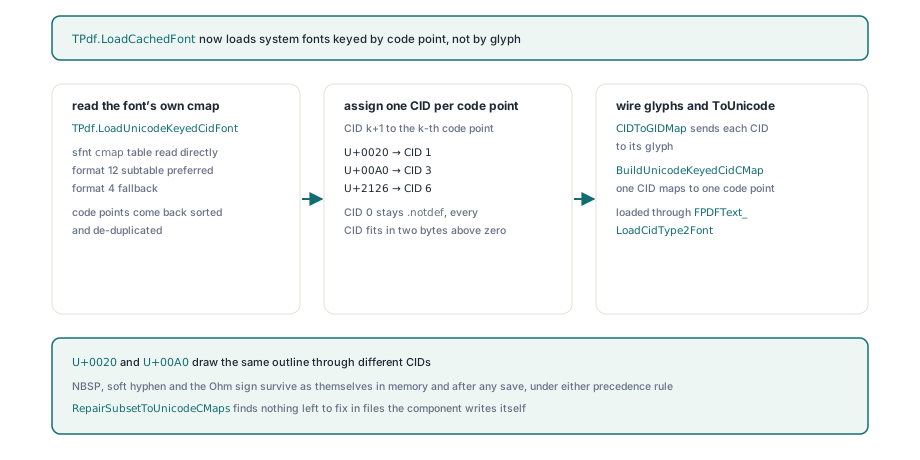
La police est chargée via FPDFText_LoadCidType2Font, le même point d'entrée qui soutient l'écriture au niveau glyphe de l'intégration de polices CID Type 2 avec des cartes CID-vers-GID explicites. Quand FPDFText_SetText écrit ensuite une chaîne, la recherche inverse tombe sur un seul CID par caractère. Rien là-dedans ne dépend de la règle de priorité du lecteur, car il n'existe pas de second mapping entre lesquels la règle choisirait. Le fichier sauvegardé transporte aussi le flux ToUnicode du composant lui-même, si bien que l'extraction après rechargement voit la même table un-à-un que le document vivant
Le coût est une CIDToGIDMap plus grosse : deux octets par point de code couvert par la police. Supposons une police qui mappe environ 3 000 points de code. La carte atteint alors à peu près 6 Ko, remise au moteur avec chaque police. L'échange vaut la peine à chaque fois. Quelques kilooctets achètent une extraction qui se lit pareil dans PDFium, dans les visionneurs qui gardent le premier mapping, et dans n'importe quel indexeur que votre client lancera l'an prochain
L'aller-retour ci-dessous écrit une chaîne qui contient chaque paire à problème, l'extrait du document non sauvegardé, sauvegarde, recharge et extrait de nouveau. Les deux chaînes doivent égaler l'entrée exactement ; l'assistant CodePoints n'est là que pour rendre une discordance lisible :
uses
  SysUtils, PDFium;

const
  // Espace/U+00A0 et tiret/U+00AD partagent un glyphe Arial, comme
  // Omega grec (U+03A9) et le signe Ohm (U+2126)
  Sample: WString = 'two-x'#$00A0'y'#$00AD'z '#$03A9#$2126;

function CodePoints(const S: WString): string;
var
  I: Integer;
begin
  Result := '';
  for I := 1 to Length(S) do
    Result := Result + 'U+' + IntToHex(Ord(S[I]), 4) + ' ';
end;

var
  Pdf: TPdf;
  Live, Reloaded: WString;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.CreateDocument;
    Pdf.AddPage(1, 595, 842);
    Pdf.AddText(Sample, 'Arial', 12, 72, 770);
    Live := Pdf.Text;                  // document vivant, non sauvegardé
    Pdf.SaveAs('codepoints.pdf');
  finally
    Pdf.Free;
  end;

  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'codepoints.pdf';
    Pdf.Active := True;
    Pdf.PageNumber := 1;
    Reloaded := Pdf.Text;              // après une sauvegarde complète et un rechargement
  finally
    Pdf.Free;
  end;

  if (Live <> Sample) or (Reloaded <> Sample) then
    Writeln('Mismatch: ', CodePoints(Live), '/ ', CodePoints(Reloaded));
end.
Gardez le NBSP et le trait souple dans la chaîne d'échantillon même si vos documents en contiennent rarement. Un test qui n'écrit que de l'ASCII passe aussi contre une CMap indexée par glyphe, car rien en lui ne demande jamais au lecteur de choisir entre deux mappings
Pourquoi une seule entrée bfrange peut anéantir un bloc entier ?
Un bfrange isolé dont la suite de CIDs traverse une frontière xxFF fait jeter à PDFium le bloc entier où il se trouve. L'ISO 32000-1 §9.10.3 ne laisse varier que le dernier octet de la destination dans une plage, et le côté CID recèle un piège jumeau dans le parseur de PDFium : il déduit le CID haut comme (low and $FFFFFF00) or (high and $FF). Une suite du CID 00FE à 0101 se lit 00FE à 0001, bas supérieur au haut, et le bloc entier est marqué invalide. SetText réussit, la page se rend correctement, et l'extraction renvoie U+0000 pour chaque caractère du bloc
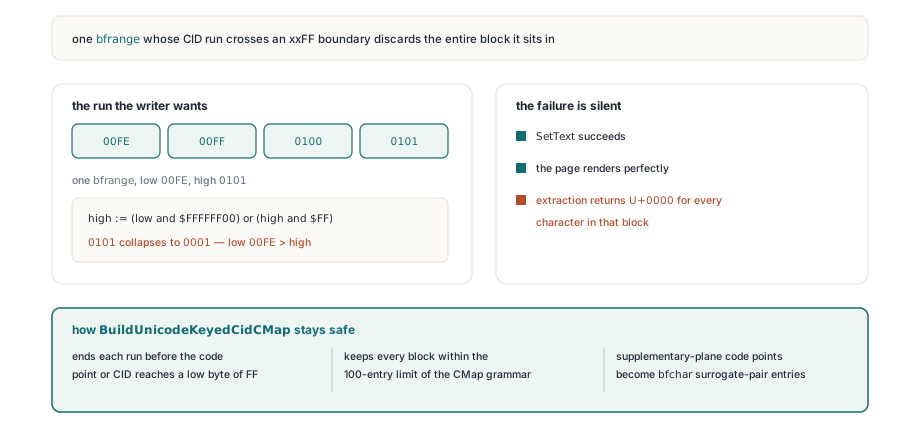
Une police indexée par point de code est exactement là où ça mord. Les CIDs sont denses et séquentiels, donc toute police de plus de 255 points de code produit des suites de CIDs qui traverseraient 00FF, 01FF et ainsi de suite si le rédacteur fusionnait bêtement les entrées consécutives. La CMap que PDFium Component écrit termine une suite avant que le point de code ou le CID n'atteigne un octet bas de FF, et elle découpe les entrées en blocs d'au plus 100, la limite que la grammaire CMap impose à chaque section beginbfrange et beginbfchar
Les points de code au-dessus de U+FFFF reçoivent des entrées bfchar individuelles dont les destinations sont des paires de substitution UTF-16, car incrémenter une paire de substitution dans une plage n'a aucun sens défini. Le versant substitution de l'histoire est dans la gestion des emoji, du CJK et des paires de substitution en Delphi. Une CMap en bfchar seuls esquiverait entièrement le problème de frontière, à plusieurs fois la taille, voilà pourquoi les plages restent la forme principale et que les règles de découpage portent la charge
Réparer les conflits ToUnicode dans des fichiers d'autres outils
RepairSubsetToUnicodeCMaps dans l'unité FPdfCompress corrige le conflit indexé par glyphe dans des fichiers que le composant n'a pas écrits. TPdf.SaveAs l'exécute à chaque sauvegarde complète non incrémentale, et vous pouvez l'appeler directement sur n'importe quel flux. Pour chaque CID qui porte deux destinations, l'entrée bfchar gagne. Sans bfchar pour le CID, une paire qui ne diffère que par le bit de poids fort se résout vers le plus petit point de code base-Latin. Tout autre conflit garde son premier mapping
La réparation édite les valeurs hexadécimales en conflit sur place, avec des remplacements de même longueur. La disposition des blocs, la couverture de CIDs et chaque autre octet du flux restent tels quels, donc la CMap garde la forme que le lecteur de PDFium acceptait déjà. Une CMap reconstruite proprement serait plus jolie dans un dump hexadécimal. Elle changerait aussi la structure d'un flux qu'un lecteur strict acceptait déjà, et c'est un pari sans avantage quand seule une poignée de valeurs de destination est fausse
uses
  Classes, FPdfCompress;

var
  Source, Dest: TFileStream;
begin
  Source := TFileStream.Create('from-other-tool.pdf',
    fmOpenRead or fmShareDenyWrite);
  try
    Dest := TFileStream.Create('repaired.pdf', fmCreate);
    try
      // Éditions de même longueur seulement ; les fichiers sans conflit
      // réparable, et ceux à flux de références croisées ou d'objets, sont copiés tels quels
      RepairSubsetToUnicodeCMaps(Source, Dest);
    finally
      Dest.Free;
    end;
  finally
    Source.Free;
  end;
end.
La routine reconstruit une table de références croisées classique, donc les documents qui utilisent des flux de références croisées, des références hybrides ou des flux d'objets passent octet par octet. Les sauvegardes incrémentales (saIncremental) sautent la réparation par conception, car une révision incrémentale doit rester en appendice seul. Pour le texte que le composant écrit lui-même, ni l'un ni l'autre cas n'importe : ses polices indexées par point de code ne produisent jamais de conflit à réparer
Où s'applique la voie indexée par point de code
La voie indexée par point de code couvre toute police qui expose une sous-table cmap Unicode, et le chargement indexé par glyphe de PDFium s'occupe du reste. Détails à connaître avant de vous y fier :
- Les polices Symbol qui ne portent qu'une cmap (3,0), et toute police que la voie CID ne peut charger, passent par
FPDFText_LoadFont, où un glyphe partagé par deux points de code subit la règle de priorité du lecteur - Avec seulement une sous-table de format 4, la carte couvre le plan multilingue de base ; une sous-table de format 12 sur la plateforme (3,10) ou la plateforme Unicode ajoute les points de code hors du plan de base
- Le glyphe 0 et les points de code de substitution sont laissés de côté, et le compte d'entrées est plafonné à 65535 pour que chaque CID tienne dans deux octets au-dessus de zéro
- Les TrueType Collections demandent un soin particulier :
GetFontDatade GDI renvoie tout le .ttc, etFPDFText_LoadCidType2Fontn'a pas de paramètre d'index de face, donc passer la collection telle quelle incorporerait la face 0, SimSun, quand vous demandiez NSimSun depuis simsun.ttc. Le composant rapproche le nom de famille de la table de noms de la police (nameID 1 et 16) et remet la face demandée comme sfnt autonome ; une collection qu'il ne peut pas parser passe entière et utilise la face 0 - Si aucune police système du nom demandé n'est lisible,
AddTextremet le nom de police àFPDFPageObj_NewTextObj, qui le cherche parmi les polices standard de PDFium
Replier les caractères invisibles à l'index, les garder dans le texte
Une fois que l'extraction renvoie les vrais points de code, une autre question se pose : que doit faire un index de recherche avec un vrai NBSP ou trait souple que l'auteur a tapé exprès ? Repliez-les dans la couche d'indexation et laissez TPdf.Text tranquille. La chaîne extraite est le registre de ce que le document dit ; un index est une vue avec perte construite pour l'appariement, et les règles de repli lui appartiennent
L'assistant ci-dessous est une fonction à ajouter à votre propre code. Il mappe le NBSP vers une espace et jette le trait souple, qui selon le standard Unicode ne marque qu'une place où une ligne peut se couper. Il laisse délibérément U+2126 intact. La normalisation NFC transformerait le signe Ohm en Omega, car U+2126 a une décomposition canonique singleton vers U+03A9, et savoir si une recherche de fiche technique doit apparier ces deux-là est une décision produit plutôt qu'une décision d'extraction :
uses
  SysUtils, Classes, PDFium;

// Votre propre assistant pour un index de recherche ; hors de PDFium Component
function FoldForIndex(const S: string): string;
begin
  Result := StringReplace(S, #$00A0, ' ', [rfReplaceAll]);
  Result := StringReplace(Result, #$00AD, '', [rfReplaceAll]);
end;

procedure IndexDocument(const FileName: string; Lines: TStrings);
var
  Pdf: TPdf;
  P: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    for P := 1 to Pdf.PageCount do
    begin
      Pdf.PageNumber := P;
      Lines.Add(FoldForIndex(Pdf.Text));   // le texte exact reste dans Pdf.Text
    end;
  finally
    Pdf.Free;
  end;
end;
Lancez IndexDocument sur le fichier codepoints.pdf du premier exemple et la ligne indexée doit lire « two-x yz ΩΩ », onze caractères avec un signe Ohm en dernier, tandis que Pdf.Text renvoie toujours les douze caractères d'origine, NBSP et trait souple compris
Les polices indexées par point de code, la réparation de CMap et l'extraction de texte reposent toutes sur le même modèle de page en Delphi, C++Builder et Lazarus ; l'API des polices et du texte est couverte en entier sur la page produit de PDFium Component pour Delphi