PDFium Component écrit du texte dans une page PDF au niveau du glyphe avec AddCidType2Text, en intégrant des données TrueType que vous fournissez sous forme de police CID Type 2. Il attribue à chaque instance de glyphe un CID séquentiel, génère la correspondance CID-vers-GID explicite et la CMap ToUnicode, et fusionne les glyphes sur une même ligne de base en un seul objet texte natif. Le sous-ensemblage optionnel garde le fichier léger, avec une politique explicite pour ce qui se passe quand le sous-ensemblage échoue
L'écriture au niveau du glyphe est ce dont vous avez besoin quand le texte a déjà été façonné. L'arabe, le devanagari et tout script à formes contextuelles produisent une séquence d'identifiants de glyphe qui ne se mappe plus un pour un sur des caractères, si bien qu'une API prenant une chaîne et un nom de police ne peut pas exprimer le résultat. Remettre directement les glyphes et les positions est le seul moyen de placer du texte de script complexe correctement façonné dans un PDF
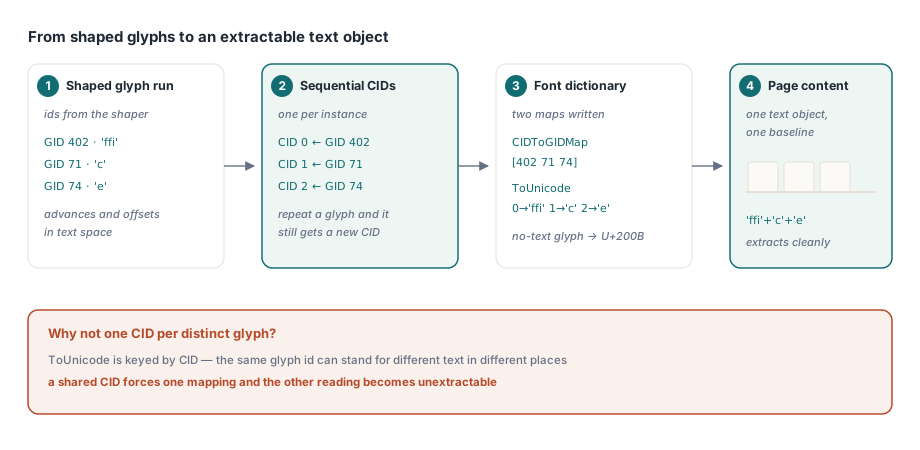
Pourquoi chaque instance de glyphe reçoit son propre CID
L'optimisation tentante consiste à dédupliquer : un CID par identifiant de glyphe distinct, réutilisé partout où ce glyphe apparaît. Cela produit une police plus petite et cela casse l'extraction de texte, car le même glyphe peut légitimement correspondre à un contenu Unicode différent selon les endroits
Un glyphe de ligature est le cas évident. Le même glyphe « ffi » peut représenter les trois caractères dans un mot et, après une décision de façonnage différente, quelque chose d'autre ailleurs. La correspondance ToUnicode est indexée par CID, si bien qu'un CID partagé ne peut porter qu'une seule correspondance, et quel que soit le texte qui perd cette compétition, il devient inextractible
Chaque instance de glyphe prend donc son propre CID, et chaque correspondance est libre de représenter plusieurs unités de code UTF-16. Un glyphe sans texte significatif — un élément décoratif, un glyphe de positionnement pur — se mappe explicitement vers U+200B, une espace de largeur nulle, si bien que chaque CID possède un résultat d'extraction observable plutôt qu'un vide
uses
  PDFium;

var
  Pdf: TPdf;
  Glyphs: TPdfCidGlyphs;
  Options: TPdfCidFontOptions;
  Report: TPdfCidFontReport;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'label.pdf';
    Pdf.LoadDocument;
    Pdf.PageNumber := 1;

    // Une entrée par glyphe façonné : l'id de glyphe, le texte qu'il représente,
    // et son avance et ses décalages dans l'espace texte
    SetLength(Glyphs, 3);
    Glyphs[0].GlyphID := 402;  Glyphs[0].UnicodeText := 'ffi';
    Glyphs[0].Advance := 18.4;
    Glyphs[1].GlyphID := 71;  Glyphs[1].UnicodeText := 'c';
    Glyphs[1].Advance := 9.8;
    Glyphs[2].GlyphID := 74;   Glyphs[2].UnicodeText := 'e';
    Glyphs[2].Advance := 9.2;

    Options := TPdfCidFontOptions.Default;   // sous-ensemble préféré
    Options.VerifyExtraction := True;

    if Pdf.AddCidType2Text(LoadFileBytes('NotoSans.ttf'), Glyphs,
         11, 72, 700, Options, Report) then
      Writeln(Format('%d glyphs, %d unique, font %d -> %d bytes, match=%s',
        [Report.GlyphCount, Report.UniqueGlyphCount,
         Report.OriginalFontBytes, Report.EmbeddedFontBytes,
         BoolToStr(Report.ExtractionMatches, True)]));
  finally
    Pdf.Free;
  end;
end;
Le sous-ensemblage, et les vérifications qu'un code de retour ne vous donne pas
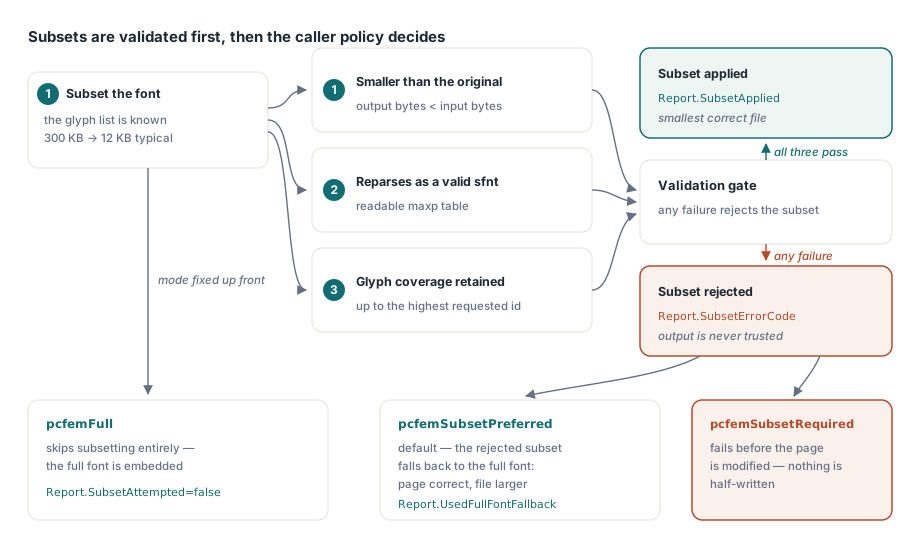
Réduire une police en sous-ensemble aux glyphes réellement utilisés fait la différence entre intégrer 300 Ko et intégrer 12 Ko, et sur un document comportant plusieurs polices, cela décide si le fichier est envoyable par e-mail. La voie de sous-ensemblage de la plateforme accepte directement une liste de glyphes, ce qui convient parfaitement à cette API puisque l'appelant connaît déjà chaque identifiant de glyphe utilisé
Ce que cela ne vous donne pas, c'est la confiance. Un appel de sous-ensemblage peut rapporter un succès et retourner une sortie inutilisable, si bien que le composant valide trois propriétés avant d'accepter le résultat : la sortie doit être plus petite que l'originale, elle doit se réanalyser comme un sfnt valide avec une table maxp lisible, et elle doit conserver les glyphes jusqu'à l'identifiant original le plus élevé demandé. Tout échec signifie que le sous-ensemble est rejeté
Ce qui se passe ensuite relève de la politique de l'appelant. Sous pcfemSubsetPreferred, le réglage par défaut, un sous-ensemble rejeté revient à intégrer la police complète, si bien que la page est correcte et simplement plus volumineuse. Sous pcfemSubsetRequired, l'opération échoue avant que la page ne soit modifiée, ce que veut un pipeline contraint en taille. pcfemFull saute entièrement le sous-ensemblage. Le rapport indique quelle voie a été prise via SubsetAttempted, SubsetApplied, UsedFullFontFallback et SubsetErrorCode
Une vérification qui ne peut pas produire de faux positif
Avec VerifyExtraction activé, le composant confirme que ce qu'il a écrit peut être relu. La façon naïve de le faire est d'extraire toute la page et de chercher la chaîne attendue, et c'est erroné : une page qui contenait déjà ce texte réussit le test même quand le nouveau texte a été écrit incorrectement
Au lieu de cela, la page de texte est reconstruite et les handles d'objet insérés par cet appel sont lus individuellement, dans l'ordre d'insertion, puis concaténés. Le résultat est comparé au texte attendu, et le rapport expose les deux chaînes aux côtés du booléen, si bien qu'une divergence peut être diagnostiquée plutôt que simplement détectée
Activez-le pendant le développement et dans tout pipeline où l'extractibilité est une exigence — archives consultables, conformité d'accessibilité, exploration de texte en aval. Le coût est une reconstruction de page de texte par appel, ce qui explique qu'il ne soit pas activé par défaut dans les boucles serrées
Budgets et échec atomique
Octets de police, instances de glyphes et unités de code Unicode sont chacun plafonnés avant l'allocation, et le format de police, l'index TTC, la plage d'identifiants de glyphe et les valeurs de géométrie sont validés avant toute écriture. La géométrie doit être finie, ce qui semble évident jusqu'à ce qu'un moteur de façonnage vous remette une avance NaN issue d'une police malformée
L'échec est atomique au niveau de la page. Si le chargement de police, l'écriture d'objets, la génération de contenu ou la vérification d'extraction échoue, chaque objet inséré par cet appel est retiré dans l'ordre inverse et le contenu de la page est régénéré. Un appel échoué laisse la page telle qu'elle était, pas avec un demi-fragment de texte dessus
Où cela s'inscrit dans un pipeline de texte
La répartition du travail mérite d'être énoncée clairement. Le façonnage — transformer des caractères en glyphes positionnés — n'est pas le travail de cette API ; il revient à un moteur de façonnage, et la propre prise en charge bidirectionnelle et des scripts complexes du composant est traitée dans la gestion des emoji, du CJK et des paires suppléantes. Cette API est ce que vous appelez ensuite, avec la série de glyphes que le moteur de façonnage a produite
Pour du texte latin ordinaire sans façonnage contextuel, les API texte basées sur des chaînes plus simples sont le bon outil et produisent un code plus compact. Recourez à l'écriture CID Type 2 quand vous disposez d'une sortie façonnée, quand vous avez besoin d'un contrôle exact des identifiants de glyphe, ou quand la police doit être intégrée à partir d'octets que vous détenez plutôt que résolue par nom — l'alternative de résolution de police étant le mécanisme fournisseur décrit dans contrôler la substitution de police PDF
Une remarque de déploiement : intégrer une police est autant une question de licence qu'une question technique. Les polices varient selon que l'intégration est autorisée du tout, autorisée pour l'affichage seulement, ou autorisée pour l'édition. La bibliothèque intégrera n'importe quels octets que vous lui donnez, et vérifier la licence relève de votre responsabilité, pas de celle du format de fichier
L'écriture de texte au niveau du glyphe, la fourniture de polices et l'extraction de texte partagent le même modèle de page en Delphi, C++Builder et Lazarus ; l'API complète est décrite sur la page du composant PDFium pour Delphi