Un article de conférence à deux colonnes trié par position verticale revient avec une première ligne comme Abstract We measure the 2 Related work Earlier studies : les premiers mots de la colonne de gauche et les premiers mots de la colonne de droite, collés ensemble parce que les deux tiennent sur la même ligne de base. Rien n'a mal tourné dans le parseur. Une page PDF offre deux ordres défendables pour son texte, la séquence dans laquelle le flux de contenu le peint et la position de chaque glyphe sur la page, et pour beaucoup de mises en page ces deux ordres se contredisent. Un extracteur qui renvoie des blocs positionnés au lieu d'une seule chaîne vous laisse voir quel ordre vous avez obtenu et basculer quand c'est le mauvais pour la page devant vous
Ce que renvoie GetStructuredText
TPdf.GetStructuredText du PDFium Component renvoie une TPdfStructuredTextPage pour la page courante : un tableau de blocs, chaque bloc un tableau de lignes, chaque ligne un tableau de segments stylés. Chaque niveau porte son propre Text et un rectangle Bounds en espace page en points PDF, donc un titre, une seule ligne ou une phrase en gras peuvent être localisés sur la page sans seconde recherche. L'enregistrement de page ajoute Width, Height, CharacterCount et deux compteurs de qualité décrits plus bas
Le Page.Text aplati est construit à partir des blocs plutôt qu'à partir du flux brut de caractères. Les lignes d'un bloc sont jointes par un CRLF unique et les blocs sont séparés par une ligne vide, ce qui veut dire qu'une sortie en texte brut de Page.Text montre déjà où l'extracteur a tracé ses frontières de blocs. C'est la chose la plus rapide à imprimer quand une page se lit bizarrement
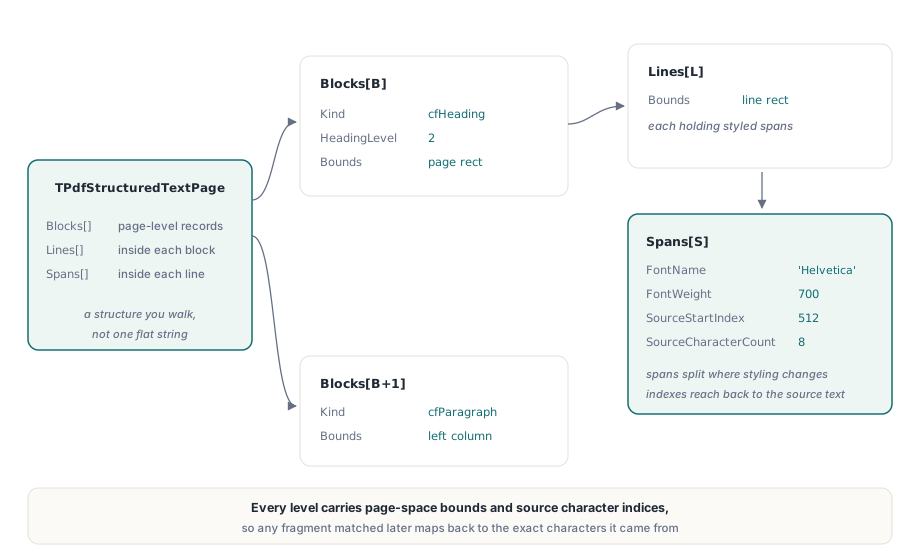
Tout cela est piloté par un petit enregistrement d'options. TPdfStructuredTextOptions.Default règle ReadingOrder à roPhysicalLayout, active IncludeFontInfo et IncludeSemantics, et fixe MaxCharacters à 1 000 000. Le champ d'ordre de lecture est celui qui change le plus la forme de la sortie
Comment les deux ordres de lecture construisent lignes et blocs
roContentOrder garde la séquence de dessin du producteur, tandis que roPhysicalLayout reconstruit l'ordre depuis les positions des glyphes, et la différence se montre d'abord dans la façon dont les lignes se forment. En ordre de contenu, les caractères sont pris dans l'ordre où la page les dessine. Une nouvelle ligne démarre à une rupture de ligne explicite ou quand le caractère suivant ne chevauche plus la ligne courante verticalement. Une ligne rejoint alors le bloc directement devant elle seulement si les deux se chevauchent horizontalement d'au moins un cinquième de la largeur la plus étroite et si l'écart vertical ne dépasse pas environ deux hauteurs de ligne et quart ; sinon elle ouvre un nouveau bloc. Les blocs restent dans l'ordre de dessin
La mise en page physique jette la séquence de dessin. Chaque caractère avec une boîte connue est trié par le centre vertical de cette boîte, haut de la page d'abord, puis par son bord gauche. Les caractères dont les étendues verticales se chevauchent assez partagent une ligne, et ce test ne regarde que la hauteur. La distance horizontale n'y joue aucun rôle. Chaque ligne rejoint ensuite le bloc existant, n'importe où sur la page, qui lui convient le mieux selon la même règle de chevauchement-et-écart, et les blocs finis sont triés par leur bord supérieur, le bord gauche départageant les égalités à un demi-point près
Cette seconde règle est la source de l'exemple d'ouverture. Quand les deux colonnes d'un article partagent une grille de lignes de base, la première ligne de la colonne de gauche et la première ligne de la colonne de droite se chevauchent verticalement, donc la mise en page physique les met sur une ligne. L'écart à la gouttière est plus large qu'un quart de la taille de police, donc l'extracteur insère une espace et continue. Chaque ligne du corps fait de même, les lignes fusionnées se chevauchent toutes horizontalement, et tout le corps à deux colonnes devient un seul bloc large qui se lit droit à travers la gouttière
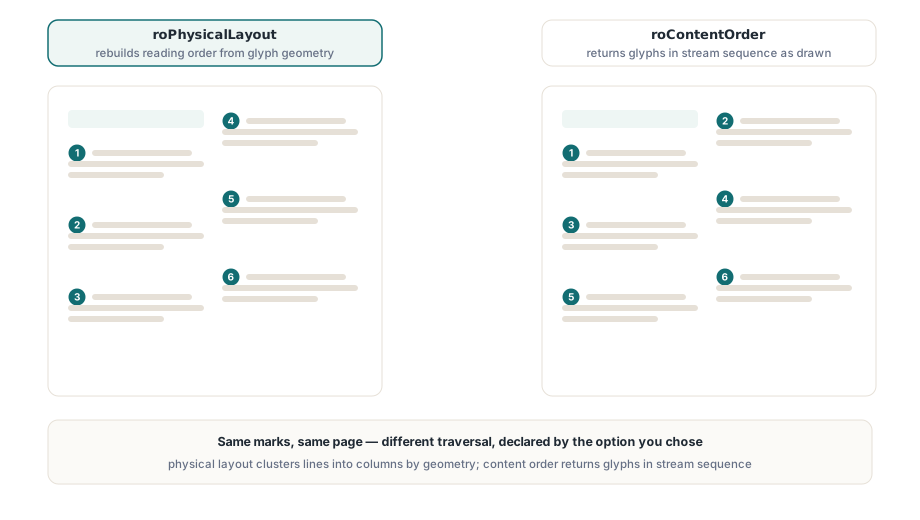
L'ordre de contenu traite bien cette page chaque fois que le producteur a écrit la colonne un avant la colonne deux, ce que font normalement les traitements de texte et les systèmes de composition. Les lignes de la colonne de gauche s'empilent en blocs, la première ligne de la colonne de droite n'a aucun chevauchement horizontal avec eux et ouvre un bloc neuf, et les blocs sortent dans l'ordre où l'auteur les a écrits. La mise en page physique gagne sa place sur un autre genre de page : factures, relevés, formulaires et diapositives, où une étiquette et sa valeur tiennent sur la même ligne de base et lire la rangée de gauche à droite est exactement ce qu'on veut. C'est aussi le mode à employer quand la séquence de dessin n'a pas de sens, par exemple du texte peint police par police ou une page assemblée de nombreuses petites surcouches
Pour une collection mixte, partagez le choix par type de document. Articles, rapports et manuels sortis d'un outil de composition connu passent par roContentOrder ; formulaires et documents transactionnels restent sur le défaut roPhysicalLayout. La routine suivante imprime les blocs d'une page en ordre de contenu, avec les titres marqués quand le fichier est étiqueté
uses
  SysUtils, PDFium;

procedure DumpBlocks(Pdf: TPdf; PageNumber: Integer);
var
  Options: TPdfStructuredTextOptions;
  Page: TPdfStructuredTextPage;
  B, L: Integer;
begin
  Pdf.PageNumber := PageNumber;                 // base 1
  Options := TPdfStructuredTextOptions.Default;
  Options.ReadingOrder := roContentOrder;      // producteurs colonne par colonne

  Page := Pdf.GetStructuredText(Options);
  if Page.Source = rosStructure then
    Writeln('block kinds come from the structure tree')
  else
    Writeln('block kinds are inferred from layout');

  for B := 0 to High(Page.Blocks) do
  begin
    if Page.Blocks[B].Kind = cfHeading then
      Writeln(Format('[%d] H%d  %s',
        [B, Page.Blocks[B].HeadingLevel, Page.Blocks[B].Text]))
    else
    begin
      Writeln(Format('[%d] x=%.0f..%.0f, %d line(s)',
        [B, Page.Blocks[B].Bounds.Left, Page.Blocks[B].Bounds.Right,
         Length(Page.Blocks[B].Lines)]));
      for L := 0 to High(Page.Blocks[B].Lines) do
        Writeln('      ', Page.Blocks[B].Lines[L].Text);
    end;
  end;
end;
Comment détecter une ligne qui court à travers la gouttière ?
Une ligne fusionnée se trahit par ses segments. GetStructuredText démarre un nouveau segment chaque fois que le caractère suivant n'est pas le successeur direct du précédent dans la séquence de caractères d'origine de la page, en plus des changements de style couverts plus bas. Dans une colonne, les mots consécutifs sont en général consécutifs dans la source. À la gouttière d'une ligne fusionnée, l'index de source saute de centaines de caractères, et l'écart horizontal entre les deux segments est bien plus large que n'importe quelle espace de mot
Ces deux signaux ensemble font un test fiable, et vous pouvez le faire tourner sur la sortie par défaut avant de décider si une page réclame l'ordre de contenu à la place. L'instantané de données de caractères que GetStructuredText lit est mis en cache par page, huit pages par défaut, donc redemander la même page une seconde fois avec un autre ReadingOrder regroupe des données déjà en mémoire au lieu d'extraire la page encore une fois
// LineCrossesGutter est une aide que vous ajoutez vous-même : elle signale une ligne portant deux
// segments voisins très éloignés sur la page et non adjacents dans la
// séquence de caractères source
function LineCrossesGutter(const Line: TPdfStructuredTextLine;
  MinGap: Double): Boolean;
var
  S: Integer;
  Prev, Cur: TPdfStructuredTextSpan;
begin
  Result := False;
  for S := 1 to High(Line.Spans) do
  begin
    Prev := Line.Spans[S - 1];
    Cur := Line.Spans[S];
    if (Prev.SourceStartIndex < 0) or (Cur.SourceStartIndex < 0) then
      Continue;                                 // blocs de texte alternatif
    if (Cur.Bounds.Left - Prev.Bounds.Right > MinGap) and
       (Cur.SourceStartIndex <>
        Prev.SourceStartIndex + Prev.SourceCharacterCount) then
      Exit(True);
  end;
end;

function ExtractWithFallback(Pdf: TPdf): TPdfStructuredTextPage;
var
  Options: TPdfStructuredTextOptions;
  B, L, Lines, Crossing: Integer;
begin
  Options := TPdfStructuredTextOptions.Default;   // roPhysicalLayout
  Result := Pdf.GetStructuredText(Options);

  Lines := 0;
  Crossing := 0;
  for B := 0 to High(Result.Blocks) do
    for L := 0 to High(Result.Blocks[B].Lines) do
    begin
      Inc(Lines);
      if LineCrossesGutter(Result.Blocks[B].Lines[L], 18) then
        Inc(Crossing);
    end;

  // un quart des lignes traversant un écart ressemble à des colonnes, pas à une rangée de formulaire
  if (Lines > 0) and (Crossing * 4 >= Lines) then
  begin
    Options.ReadingOrder := roContentOrder;
    Result := Pdf.GetStructuredText(Options);
  end;
end;
Dix-huit points font un quart de pouce, confortablement plus large qu'une espace de mot dans du corps de texte et plus étroit que la plupart des gouttières. Le seuil d'une ligne sur quatre garde une facture avec quelques rangées étiquette-et-montant sur la mise en page physique tandis qu'un vrai corps à deux colonnes, où presque chaque ligne traverse, bascule. Si le producteur a écrit la page rangée par rangée à travers les deux colonnes, les index de source restent contigus, le test ne se déclenche jamais, et aucun des deux ordres ne séparera les colonnes pour vous ; cette page réclame le mode colonne de l'API de contenu lisible, décrit dans la lecture de deux colonnes avec un titre à cheval
Que change IncludeSemantics, et que laisse-t-il intact ?
IncludeSemantics étiquette les blocs ; il ne les réordonne pas. Avec l'option activée, GetStructuredText lit le contenu lisible de la page et donne à chaque bloc le type du fragment qu'il chevauche avec la plus grande aire. Les types disponibles sont cfParagraph, cfHeading avec un HeadingLevel, cfListItem, cfTableCell, cfCaption, cfFigure, cfLink, cfOther pour tout autre tag, et cfPlain quand rien ne correspond. Chaque bloc récupère aussi une Language et un StructElementIndex qui le relie à un élément de l'arbre de structure
Le champ Source dit d'où vient l'étiquette : rosStructure quand la page a un arbre de structure utilisable au sens de l'ISO 32000-1 §14.7, rosHeuristic quand les types ont été déduits. Page.Source donne la même réponse pour la page entière. Un titre rapporté avec rosStructure est un titre parce que l'auteur l'a étiqueté ; un titre rapporté avec rosHeuristic est une conjecture instruite, et un pipeline d'indexation qui pondère les titres devrait traiter les deux différemment. L'ordre des blocs, dans les deux cas, vient toujours de ReadingOrder. La passe sémantique utilise les défauts du contenu lisible, donc un réglage de colonnes appliqué via ReadableContentOptions n'atteint pas GetStructuredText
Les figures ont une règle de plus. Sur une page étiquetée, un élément Figure ou un texte alternatif qui n'a été rattaché à aucun bloc de texte est ajouté comme bloc à part, portant la description alternative comme texte. Un tel bloc a une seule ligne et un seul segment avec SourceStartIndex à -1, car aucun glyphe de la page ne l'a produit. Le code qui remappe les segments vers les caractères doit sauter cette valeur, voilà pourquoi le test de gouttière ci-dessus la vérifie. Les contrôles d'arbre de structure eux-mêmes sont traités dans la validation de l'arbre de structure PDF/UA
Segments, bornes et le chemin de retour vers les caractères
Chaque TPdfStructuredTextSpan porte son texte, ses bornes, FontName, FontSize, FontWeight et Angle, plus SourceStartIndex et SourceCharacterCount. Avec IncludeFontInfo actif, un segment s'arrête où n'importe laquelle des quatre valeurs de style change, donc une phrase avec trois mots en gras au milieu arrive en trois segments et l'emphase peut être reconstruite depuis FontWeight au lieu d'être devinée des noms de polices. Avec IncludeFontInfo inactif, les champs de style restent vides et les segments ne se coupent que là où la séquence de source est interrompue
L'angle compte sur les pages avec tampons. Un filigrane diagonal DRAFT vit dans le même espace de coordonnées que le texte du corps, et en mise en page physique ses lettres peuvent atterrir sur des lignes du corps qu'elles croisent verticalement. Les segments avec un Angle non nul se laissent facilement écarter avant de joindre le texte pour l'indexation
Les deux champs de source sont ce qui transforme un résultat de recherche en quelque chose de dessinable. Ils indexent la séquence de caractères de la page, donc une phrase trouvée dans un bloc se convertit directement en boîtes de caractères pour un surlignage, selon l'approche de la sélection visuelle de lignes de texte avec boîtes de caractères. Quand la forme refluée ou HTML de la page est le but, les mêmes blocs alimentent le modèle de reflow et son export HTML
Un budget de caractères et deux compteurs de qualité
MaxCharacters rejette une page carrément quand elle porte plus de caractères qu'autorisé. GetStructuredText vérifie le compte avant d'allouer le moindre tableau de travail, et une page surdimensionnée lève EPdfError avec le message Structured text character budget exceeded ; une page partielle n'est jamais renvoyée. La valeur doit être positive. L'instantané de caractères par page que lit la méthode a son propre plafond par défaut de 1 000 000 caractères et 100 000 objets de texte, signalé comme Text snapshot budget exceeded, donc régler MaxCharacters au-dessus du million ne laisse passer aucune page plus grande
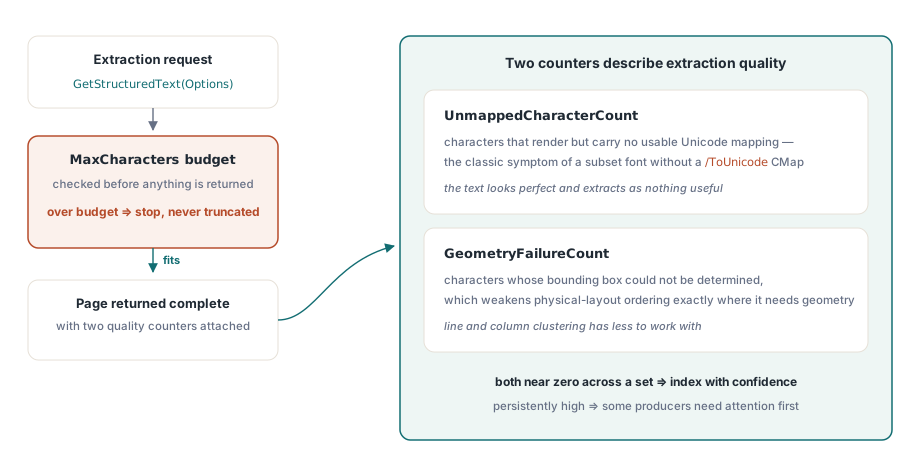
UnmappedCharacterCount compte les caractères pour lesquels PDFium n'a pu produire aucune valeur Unicode du tout. Ces caractères apparaissent en U+FFFD dans chaque champ Text. La cause habituelle est une police de sous-ensemble avec un encodage personnalisé et sans CMap /ToUnicode, le cas que décrit l'ISO 32000-1 §9.10.2, où le texte se rend correctement et ne peut pas être extrait de façon fiable. Le compteur mesure les correspondances manquantes seulement : un glyphe dont l'entrée /ToUnicode nomme le mauvais point de code compte comme mappé, donc une page de charabia plausible peut encore rapporter zéro
GeometryFailureCount compte les caractères sans boîte utilisable, sauts de ligne exclus. En ordre de contenu, ces caractères suivent simplement leurs voisins. En mise en page physique ils n'ont pas de position où se trier, donc ils sont placés après chaque caractère positionné et finissent rattachés à la dernière ligne de la page. Une page avec un compte de géométrie non nul et des fragments étranges sur sa dernière ligne montre exactement cela
// LogRejected et LogQuality sont vos propres routines de journalisation
function ExtractForIndex(Pdf: TPdf; PageNumber: Integer;
  out Page: TPdfStructuredTextPage): Boolean;
var
  Options: TPdfStructuredTextOptions;
begin
  Result := False;
  Pdf.PageNumber := PageNumber;
  Options := TPdfStructuredTextOptions.Default;
  Options.MaxCharacters := 200000;              // limite d'entrée pour ce pipeline
  try
    Page := Pdf.GetStructuredText(Options);
  except
    on E: EPdfError do
    begin
      LogRejected(PageNumber, E.Message);       // budget de caractères ou d'instantané
      Exit;
    end;
  end;

  if Page.UnmappedCharacterCount * 20 > Page.CharacterCount then
    LogQuality(PageNumber, Format('%d of %d characters have no Unicode value',
      [Page.UnmappedCharacterCount, Page.CharacterCount]));
  if (Options.ReadingOrder = roPhysicalLayout) and
     (Page.GeometryFailureCount > 0) then
    LogQuality(PageNumber, Format('%d characters without a box; check the last line',
      [Page.GeometryFailureCount]));
  Result := True;
end;
Pour une page dont vous n'avez besoin que comme chaîne, l'extraction de texte de documents PDF couvre les appels plus simples, et la lecture et l'écriture du contenu marqué BDC et MCID va une couche sous l'arbre de structure. Le modèle de page structurée, le lecteur de contenu lisible et l'export de reflow voyagent tous dans le composant Delphi et Lazarus décrit sur la page produit PDFium Component