Un contrat exporté depuis un traitement de texte avec la case « PDF balisé » laissée décochée a toujours l'air structuré à l'écran : un titre gras de 24 points, des clauses numérotées, un barème d'honoraires encadré. Convertissez-le en HTML recomposable et le barème revient en vraie <table>, tandis que le titre est un <p> exactement au même niveau qu'une note de bas de page. Cette sortie est correcte. ISO 32000-1 §14.8 donne à un PDF exactement un endroit pour dire « cette suite de texte est un titre », l'arbre de structure, et un fichier non balisé n'en a pas. La taille et la graisse sont des choix de composition, et un convertisseur qui transforme chaque grande ligne grasse en <h1> promeuvera aussi les citations détachées, les totaux de tableaux et le nom de la société dans l'en-tête de lettre
La question qui vaut la peine d'être posée à n'importe quel pipeline PDF-vers-HTML, c'est donc d'où vient chaque titre, chaque élément de liste et chaque tableau de sa sortie, et jusqu'à quel point chacun peut être cru par une mise en page de téléphone, un lecteur d'écran ou un indexeur de recherche. Titres et tableaux donnent des réponses différentes. L'étape d'export ajoute ses propres choix sur les sauts de ligne, l'encodage des caractères et la mémoire
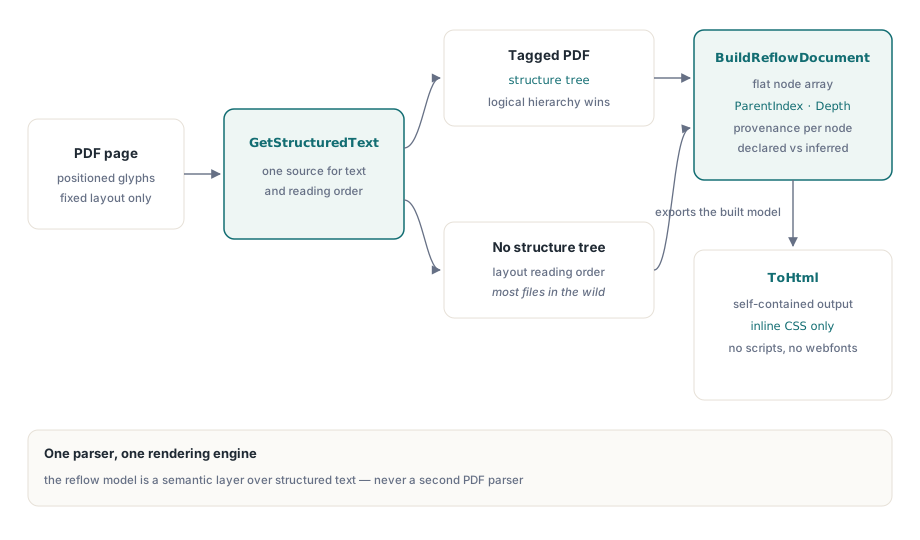
D'où viennent les titres et les listes
PDFium Component construit le modèle de recomposition avec TPdf.BuildReflowDocument, et cette méthode prend chaque mot, bloc et indice sémantique de GetStructuredText, la même couche de texte structuré décrite dans les blocs de texte structuré et l'ordre de lecture. Il n'y a ni second analyseur ni second extracteur de texte derrière. Pour chaque page de la plage demandée, elle collecte les blocs dans l'ordre physique de mise en page. GetStructuredText a déjà apparié chaque bloc au contenu balisé de la page par aire de recouvrement, et BuildReflowDocument copie sur le bloc le rôle qu'elle a trouvé : H à H6 deviennent des titres avec leur niveau, LI, Lbl et LBody deviennent des éléments de liste, Figure devient une figure dont le texte est la description alternative, et Caption devient une légende
Deux conséquences s'ensuivent, toutes deux faciles à observer. L'ordre des blocs suit toujours la mise en page de la page, même dans un fichier balisé, donc les balises décident de ce qu'est un bloc et la géométrie décide de où il va. Et sur une page sans balises, chaque bloc est un paragraphe. Les titres et les listes ne sont jamais devinés d'après la taille de police
Chaque nœud porte un champ Source de type TPdfReadingOrderSource : rosStructure quand le rôle vient de l'arbre de structure, rosHeuristic quand il vient de la seule mise en page. Le HTML exporté le répète en data-source="structure" ou data-source="inferred" sur chaque élément, et le TPdfReflowDocument.Source au niveau du document ne vaut rosStructure que si chaque page de la plage était balisée. Les tableaux sont toujours en rosHeuristic, car ils viennent de la détection géométrique et non de balises Table. Si une étape aval traite les titres comme points de repère de navigation, vérifiez ce champ d'abord ; un document balisé vous donne les points de repère choisis par l'auteur
Un tableau de nœuds plat au lieu d'un arbre d'objets
TPdfReflowDocument.Nodes est un arbre aplati en préordre : un seul tableau dynamique d'enregistrements TPdfReflowNode, chacun portant un ParentIndex et un Depth. Les nœuds de page se tiennent à la profondeur 0 avec un index de parent à -1. Paragraphes, titres, figures, légendes, listes et tableaux pendent à la page à la profondeur 1, les éléments de liste se tiennent à la profondeur 2 sous leur liste, et les cellules de tableau atteignent la profondeur 3 sous une ligne. Les éléments de liste consécutifs partagent un seul nœud de liste ; tout autre bloc ou un tableau entre eux démarre une nouvelle liste
La disposition plate est une décision de portabilité. Un enregistrement récursif contenant un tableau dynamique de lui-même compile sous Delphi, C++Builder et Free Pascal, mais les trois gèrent les types managés récursifs différemment à travers une frontière de package ou de DLL. Un tableau plat d'enregistrements simples se comporte pareil dans les trois, et il peut être diffusé avec une seule boucle for et sans récursion
uses
  SysUtils, PDFium;

var
  Pdf: TPdf;
  Options: TPdfReflowOptions;
  Doc: TPdfReflowDocument;
  Node: TPdfReflowNode;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'contract.pdf';
    Pdf.LoadDocument;

    Options := TPdfReflowOptions.Default;   // toutes les pages, tableaux allumés, CSS allumée
    Doc := Pdf.BuildReflowDocument(Options);

    for I := 0 to High(Doc.Nodes) do
    begin
      Node := Doc.Nodes[I];
      case Node.Kind of
        prnkHeading:
          Writeln(Format('%sH%d [%s] %s', [StringOfChar(' ', Node.Depth * 2),
            Node.HeadingLevel,
            BoolToStr(Node.Source = rosStructure, True), Node.Text]));
        prnkTable:
          // sur un nœud de tableau, RowSpan/ColumnSpan portent les comptes de lignes et de colonnes du tableau
          Writeln(Format('%stable %dx%d, page %d, confidence %.2f',
            [StringOfChar(' ', Node.Depth * 2), Node.RowSpan, Node.ColumnSpan,
             Node.PageNumber, Node.Confidence]));
      end;
    end;

    Writeln(Format('%d node(s), %d table(s), %d character(s), pages %d-%d',
      [Length(Doc.Nodes), Doc.TableCount, Doc.CharacterCount,
       Doc.FirstPage, Doc.LastPage]));
  finally
    Pdf.Free;
  end;
end;
Sur le contrat non balisé de l'ouverture, cette boucle n'imprime aucune ligne H du tout et une ligne de tableau par barème détecté. Faites-la tourner sur une copie balisée du même document et les titres apparaissent avec True à côté. FirstPage et LastPage des options valent 0 par défaut, ce qui signifie première et dernière page du document ; une plage hors du compte de pages lève EPdfError avant que la moindre page ne soit lue
Pourquoi le texte des tableaux n'apparaît-il pas deux fois ?
La détection de tableaux tourne sur chaque page après la collecte du texte structuré, ce qui veut dire que les mots à l'intérieur d'un tableau existent deux fois : une fois comme blocs de texte, une fois comme cellules. Émettez les deux et chaque tableau du HTML est suivi de son propre contenu encore une fois en paragraphes détachés, exactement ce que produit une fusion naïve du genre « ajouter les tableaux au texte »
Le modèle le résout géométriquement. Un bloc de texte dont la boîte englobante se trouve au moins à moitié à l'intérieur des bornes d'un tableau détecté est jeté, et le nœud de tableau prend sa place. Les tableaux sont ensuite entrelacés avec les blocs restants par position verticale (le plus haut sur la page d'abord, la gauche vers la droite servant de départage quand les bords supérieurs sont à moins d'un demi-point), donc un tableau atterrit entre le paragraphe au-dessus et le paragraphe en dessous au lieu d'être accolé à la fin de la page
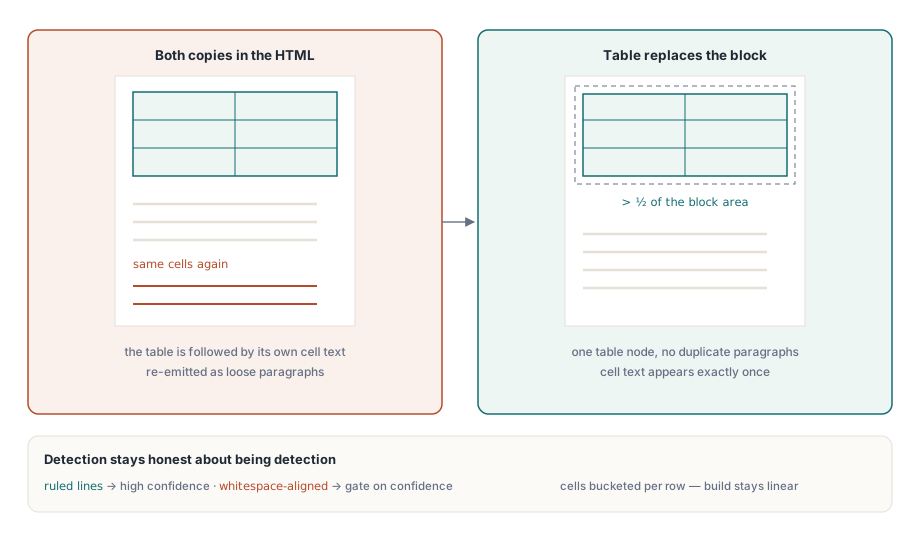
Le seuil de demi-aire a un bord visible. Un bloc qui enfourche la bordure du tableau et se tient surtout en dehors survit intact, donc une ligne de texte peut de temps en temps apparaître à la fois dans la dernière ligne et dans le paragraphe qui suit. C'est le bon côté de l'erreur. Un seuil assez bas pour retirer chaque bloc chevauchant supprimerait aussi du texte de corps qui ne fait qu'effleurer la boîte englobante d'un tableau, et une ligne dupliquée est bien plus facile à remarquer et à pardonner qu'une phrase manquante
Les tableaux détectés portent aussi une confiance, et les deux stratégies de détection atterrissent dans des bandes différentes. Un tableau trouvé à partir de filets traces se situe entre 0,88 et 1,0, selon combien de ses cellules contiennent du texte. Un tableau déduit purement de l'alignement des blancs se situe entre 0,58 et 0,88. Le Confidence du nœud de tableau porte ce score, chaque nœud de cellule le répète, et le HTML l'écrit en data-confidence sur l'élément <table>. Les tableaux sous TableOptions.MinConfidence (0,5 par défaut) ne sont jamais créés, et quand un tableau est rejeté ses mots restent simplement dans le modèle en paragraphes ordinaires
Pour un index de recherche ou une vue de lecture mobile, un tableau faux coûte peu et un tableau correctement détecté est une grosse amélioration, donc laissez les valeurs par défaut. Pour une conversion d'archivage, où une grille inventée autour d'un bloc d'adresse à deux colonnes est pire que pas de grille, restreignez la détection aux tableaux à filets :
Options := TPdfReflowOptions.Default;
Options.DetectTables := True;
Options.TableOptions.DetectWhitespaceTables := False; // tableaux à filets seulement
Options.TableOptions.MinConfidence := 0.9;            // jette aussi les grilles à filets clairsemées
Options.TableOptions.MaxTables := 200;                // plafond sur tout le document
Options.TableOptions.MaxCells := 50000;               // plafond sur tout le document

Doc := Pdf.BuildReflowDocument(Options);
if Doc.TableCount = 0 then
  Writeln('No ruled tables; all page text is emitted as paragraphs');
Dans une construction de recomposition, MaxTables et MaxCells se comptent sur toute la plage de pages, pas par page, donc un relevé de 300 pages avec un tableau à filets sur chaque page exige un MaxTables d'au moins 300, sinon la construction s'arrête avec EPdfError au premier tableau au-delà de la limite. Les valeurs par défaut sont 1000 tableaux et 100000 cellules
Pour le côté détection lui-même, y compris les rectangles fins remplis dessinés comme bordures et la continuation à travers les pages, voir la détection et l'extraction de tableaux
Exporter un HTML qui n'a besoin de rien d'autre
TPdfReflowDocument.ToHtml parcourt le modèle déjà construit et ne touche plus jamais à PDFium, donc exporter deux fois le même modèle donne la même chaîne. Avec FullDocument posé (la valeur par défaut), le résultat est une page complète : doctype, <meta charset="utf-8">, une balise meta viewport, un <title> tiré de l'entrée Title du document (ou « PDF document » quand elle est vide), et un attribut lang pris de la langue du document. Avec FullDocument ôté, vous obtenez un seul fragment <div class="pdf-reflow"> à glisser dans votre propre gabarit
La feuille de style optionnelle de IncludeCss est un seul bloc <style> inline : une colonne de lecture de 72 rem, chaque page PDF en carte blanche quand IncludePageSections est allumé, des bordures de tableaux resserrées, et une media query sous 40 rem qui retire le rembourrage des cartes et réduit le texte des tableaux. Pas de script, pas de web font, pas d'URL externe, c'est ce qui laisse le fichier se loger dans un courriel, un viewer d'aide façon CHM ou un contrôle de navigateur bac à sable. Les niveaux de titres hors 1 à 6 sont écrits en h2, les cellules d'en-tête deviennent th, et les cellules avec un RowSpan ou un ColumnSpan au-dessus de 1 reçoivent rowspan et colspan. Allumer IncludeGeometry ajoute data-left, data-top, data-right et data-bottom en points PDF, pratique pour surligner un résultat de recherche en retour sur la page rendue
PreserveLineBreaks mérite un choix délibéré. Un saut de ligne à l'intérieur d'un paragraphe PDF a été fait pour une largeur de colonne fixe ; gardez-le sur un écran de 360 pixels et chaque ligne se replie deux fois, le motif déchiqueté que la recomposition existe pour faire disparaître. Laissez-le ôté (la valeur par défaut) pour de la prose. Allumez-le pour les documents où le saut porte du sens, comme les adresses, les vers ou les listings de code, et il écrit <br> au lieu d'une espace
Pour un long document, construire toute la page comme une seule WString puis l'encoder double le pic mémoire. WriteHtml diffuse le même balisage dans un TPdfReportWriter à la place, en écrivant de l'ASCII avec chaque caractère non ASCII en référence de caractère numérique, donc les octets sont valides quelle que soit la façon dont le côté receveur devine l'encodage :
uses
  Classes, SysUtils, PDFium, FPdfAsync, FPdfReport;

procedure ExportReflowHtml(Pdf: TPdf; const FileName: string;
  const Token: IPdfCancellationToken);
var
  Options: TPdfReflowOptions;
  Doc: TPdfReflowDocument;
  Limits: TPdfReportLimits;
  Stream: TFileStream;
  Writer: TPdfReportWriter;
begin
  Options := TPdfReflowOptions.Default;
  Options.MaxNodes := 500000;
  Options.MaxCharacters := 20000000;
  Doc := Pdf.BuildReflowDocument(Options, Token);   // l'état de page est restauré ensuite

  Limits := TPdfReportLimits.Default;
  Limits.MaxCharacters := 64 * 1024 * 1024;  // plafond d'octets de sortie, 64 Mio maximum
  Limits.MaxItems := Options.MaxNodes;       // un item par nœud, 1048576 maximum

  Stream := TFileStream.Create(FileName, fmCreate);
  try
    Writer := TPdfReportWriter.Create(Limits, Stream);  // le flux reste possédé par l'appelant
    try
      Doc.WriteHtml(Writer);
    finally
      Writer.Free;
    end;
  finally
    Stream.Free;
  end;
end;
WriteHtml vérifie plus que ToHtml. Il refuse un modèle avec plus de nœuds que Options.MaxNodes, applique Options.MaxCharacters au texte qu'il écrit, limite l'imbrication à l'argument MaxDepth (64 par défaut), et vérifie que chaque ParentIndex pointe vers un nœud antérieur. Ce dernier contrôle compte si votre code filtre ou réécrit Nodes avant l'export : un tableau édité avec un index de parent vers l'avant lève EPdfReportLimit au lieu de produire du balisage aux tags désappariés
Budgets, annulation et page courante
Un PDF est une entrée non fiable, et un fichier malformé ou hostile peut déclarer des milliers de pages de texte minuscule. BuildReflowDocument vérifie les budgets de caractères, de nœuds, de tableaux et de cellules avant chaque ajout de nœud, donc un fichier qui les dépasse s'arrête avec EPdfError et un message nommant le budget (« Reflow node budget exceeded », par exemple) pendant que l'usage mémoire reste borné. MaxCharacters et MaxNodes doivent tous deux être positifs ; les valeurs par défaut sont 10 000 000 de caractères et 1 000 000 de nœuds
Le IPdfCancellationToken optionnel est consulté avant chaque page, entre les blocs, avant chaque tableau et avant chaque ligne de tableau. Passez le Token d'un TPdfCancellationTokenSource possédé par votre fiche, appelez Cancel depuis le handler du bouton, et la construction lève EPdfOperationCancelled au prochain de ces points de contrôle. Attrapez-le séparément de EPdfError pour que l'annulation d'un utilisateur ne soit pas journalisée comme fichier cassé. Quelle que soit l'exception avec laquelle la construction se termine, rien de partiel n'est renvoyé ; si l'échec survient plus loin dans WriteHtml, le fichier de destination détient une page tronquée, donc supprimez-le dans votre propre handler d'exception
L'état de page est le détail dont dépend le code GUI. La construction visite chaque page de la plage en déplaçant PageNumber, et un try/finally remet la page de l'appelant en place sur un succès, sur un échec de budget et sur une annulation pareillement. Un viewer qui lance un export pendant que l'utilisateur lit la page 340 est toujours sur la page 340 quand l'export revient
Là où la recomposition a sa place
La sortie de recomposition marche bien comme entrée pour l'indexation de recherche, les vues de lecture accessibles, l'affichage sur téléphone et la migration de contenu vers un CMS. Elle abandonne délibérément le positionnement absolu, les polices exactes, le travail vectoriel et la géométrie de page, hormis les coordonnées optionnelles data-*. Quand un travail exige que la page soit identique, rendez-la ; quand il exige que les mots soient lisibles ailleurs, recomposez-la
Comme les titres et les listes ne viennent que des balises, la qualité du HTML suit la qualité du balisage en amont. Les documents qui passent les contrôles de la validation de l'arbre de structure PDF/UA produisent des modèles avec une vraie hiérarchie de titres, et le même contenu balisé pilote les fonctions de lecture de la construction d'un lecteur accessible
Recomposition, texte structuré, extraction de tableaux et rendu tournent tous contre le même objet TPdf en Delphi, C++Builder et Lazarus ; enregistrements d'options, exceptions et écrivain de rapport sont documentés sur la page produit de PDFium Component pour Delphi