L'objet numéro 1 n'est pas la page 1. Ce seul fait fait trébucher plus de code de traitement PDF que n'importe quelle autre partie du format, et la raison n'apparaît que quand vous cessez de regarder ce qu'un visionneur affiche pour regarder le graphe d'objets que le visionneur lit réellement
Un fichier PDF est une collection d'objets indirects numérotés. Chacun porte un numéro d'objet et un numéro de génération, et les autres objets y pointent avec une référence écrite N G R — 3 0 R désigne la version courante de l'objet 3. Les pages sont des objets comme les autres, mais leur position dans le fichier et leurs numéros ne disent rien de l'ordre d'affichage. L'ordre vient de l'arbre /Pages. Parcourez les objets dans l'ordre numérique et vous assemblerez les pages dans le mauvais ordre pour une part non négligeable des fichiers réels
L'arbre est aussi le refuge de beaucoup de comportements moins évidents. Sa forme décide de la rapidité avec laquelle un visionneur peut sauter à la page 8 214, ses nœuds intérieurs transmettent discrètement taille de page et polices aux feuilles en dessous, et les totaux /Count qui rendent toute la structure rapide ne sont imposés par rien du tout. Nous passerons les trois en revue, en commençant par l'ordre lui-même
L'arbre de pages décide de l'ordre
Tout PDF a un catalogue de document (ISO 32000-2 §7.7.2), et l'entrée /Pages du catalogue pointe vers le nœud racine de l'arbre de pages. Cette racine est un dictionnaire avec /Type /Pages, un tableau /Kids de références indirectes, et un /Count donnant le nombre de pages feuilles en dessous. L'ordre d'affichage est une marche en profondeur, de gauche à droite, de cet arbre. C'est toute la règle
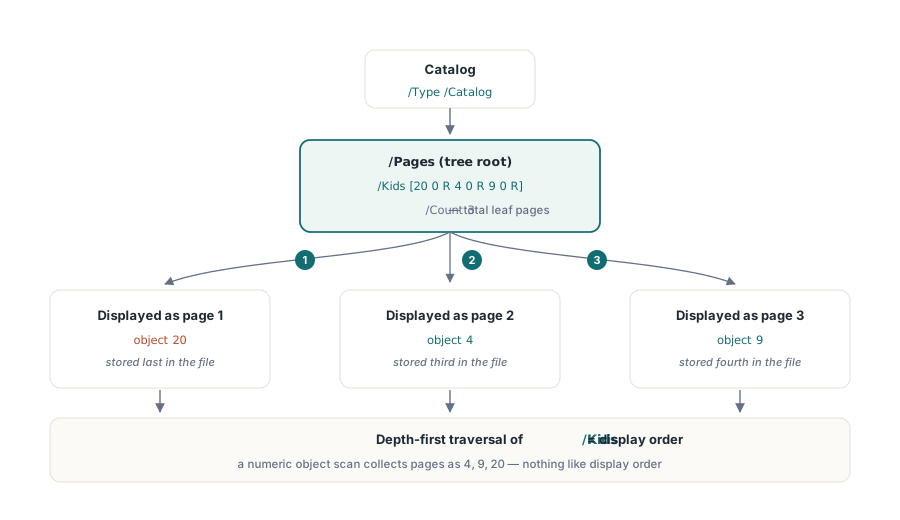
Un fichier minimal de trois pages rend cela concret :
%PDF-1.7

1 0 obj
<< /Type /Catalog /Pages 2 0 R >>
endobj

2 0 obj
<< /Type /Pages /Kids [20 0 R  4 0 R  9 0 R] /Count 3 >>
endobj

% Objet 4 : stocké en troisième position dans le fichier, mais page 2 à la lecture
4 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 5 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% Objet 9 : stocké en quatrième position mais page 3
9 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 10 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% Objet 20 : stocké en dernier mais page 1 ; Kids[0] décide, pas la numérotation
20 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 21 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj
Le tableau /Kids se lit [20 0 R 4 0 R 9 0 R], donc l'objet 20 est la page 1, l'objet 4 la page 2 et l'objet 9 la page 3. Un code qui itère les objets dans l'ordre numérique et ramasse tout ce qui porte /Type /Page se trompe sur ce fichier. Pire, la sortie a encore l'air plausible : bon nombre de pages, contenu reconnaissable sur chaque page, mauvaise séquence
Les générateurs produisent des dispositions comme celle-ci pour des raisons ordinaires. Une bibliothèque qui réserve les numéros d'objet de toutes les pages à l'avance les numérote dans l'ordre de création, puis écrit les octets dans l'ordre qui arrange son sérialiseur. Un outil de fusion renumérote les objets de chaque document source pour éviter les collisions, si bien que les objets de pages finissent dispersés dans la table d'objets combinée tandis que le nouveau tableau /Kids racine porte la séquence correcte. Et les mises à jour incrémentales ajoutent les nouveaux objets en fin de fichier avec des numéros neufs, donc une page ajoutée dans une révision vit près de la fin du flux d'octets même quand elle appartient en position 1
Ce dernier cas est celui qui mord. Un corpus de tests produit par un seul outil peut passer complètement, puis des fichiers venus d'un flux de fusion, ou des documents passés par quelques révisions, sortent mélangés. Les correctifs heuristiques ne tiennent pas, parce que l'échec dépend du générateur et de l'historique d'édition du fichier. Le vrai correctif est court : partir du catalogue, résoudre /Pages, parcourir /Kids récursivement et émettre les feuilles dans l'ordre où vous les rencontrez. Notre étude de cas de débogage d'ordre des pages suit exactement ce symptôme d'un mauvais diagnostic jusqu'à sa cause racine, avec le code de traversée récursive et les étapes qpdf pour vérifier le résultat
Le fan-out est une décision de performance
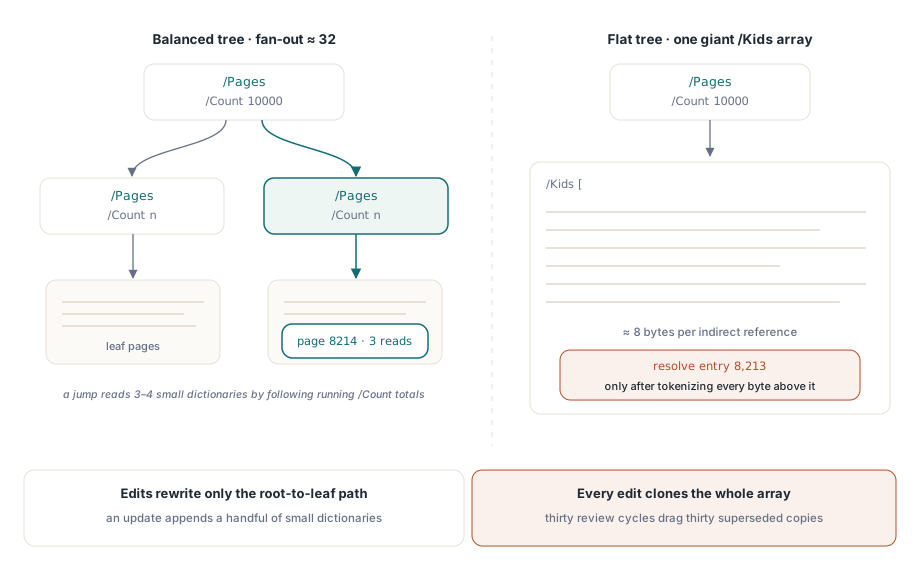
La spécification permet deux formes. Les générateurs simples émettent un arbre plat, un nœud racine /Pages dont le /Kids ne contient que des feuilles /Page. Rien n'oblige un writer à imbriquer, et un document de 10 000 pages avec 10 000 références de feuilles dans un seul tableau est conforme. La référence PDF recommande néanmoins un arbre équilibré pour les grands documents, et les générateurs grand public suivent ce conseil avec un fan-out modeste — typiquement quelques dizaines d'enfants par nœud intermédiaire, chaque nœud intermédiaire ayant son propre /Kids et son propre /Count
La raison est ce qu'un visionneur doit lire avant de pouvoir montrer quoi que ce soit. Prenez un saut direct à la page 8 214 de ce fichier de 10 000 pages. Avec un arbre plat, le visionneur doit d'abord analyser la racine, et la racine est un tableau énorme : à environ huit octets par référence indirecte, un objet de 80 Ko qui doit être tokenisé de bout en bout avant que l'entrée 8 213 ne se résolve. Avec un arbre équilibré de fan-out 32, le même saut lit la racine, compare les totaux /Count cumulés pour choisir le bon enfant, et descend. Trois ou quatre petits dictionnaires, quelques centaines d'octets chacun. Cet accès aléatoire O(log n) est ce pour quoi l'arbre a été conçu, et c'est toute la raison d'être de /Count sur les nœuds intermédiaires — un lecteur peut sauter un sous-arbre entier sans ouvrir un seul objet à l'intérieur
La forme de l'arbre fixe aussi le coût d'édition. Une mise à jour incrémentale qui insère une page doit réécrire chaque nœud dont /Kids ou /Count a changé, c'est-à-dire le chemin du parent de la nouvelle feuille jusqu'à la racine. Dans un arbre équilibré, ce chemin est une poignée de petits dictionnaires ajoutés au fichier. Dans un arbre plat, le « chemin » est le tableau racine géant, dupliqué en entier à chaque révision. Un contrat qui passe par trente cycles de révision et d'annotation peut finir par transporter trente copies remplacées du même tableau de 80 Ko dans son flux d'octets
Pour le code de traitement, l'imbrication a une conséquence plus brutale. Vous ne pouvez pas supposer que le premier niveau de /Kids contient des pages, donc chaque enfant doit être vérifié : /Type /Pages signifie récursion, /Type /Page signifie feuille. Un code qui s'arrête au premier niveau marche sur tous les fichiers plats qu'il rencontre, puis abandonne silencieusement des sous-arbres entiers la première fois qu'un générateur décide d'imbriquer
Les nœuds intérieurs portent des attributs hérités
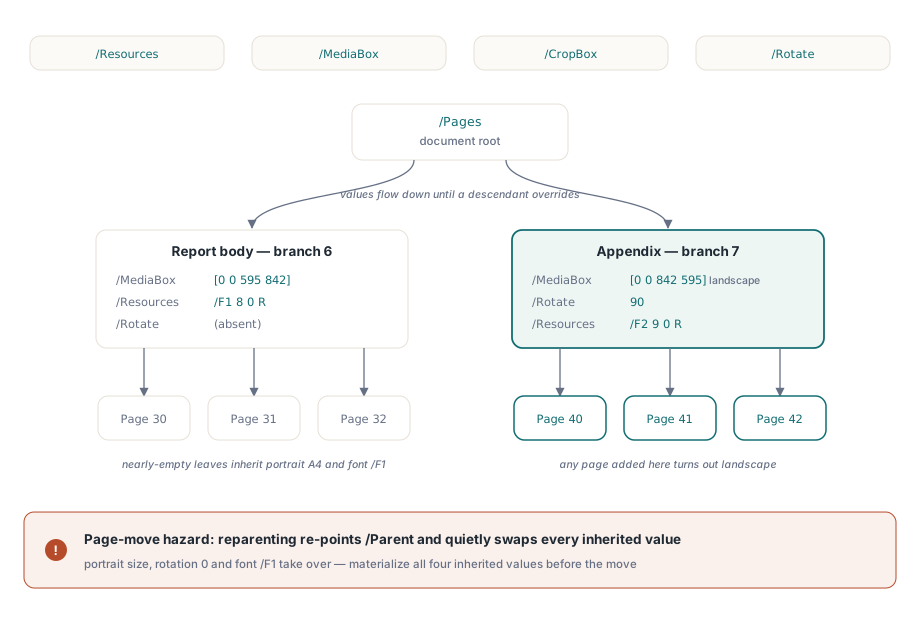
Les nœuds intermédiaires font plus que router les recherches. Quatre attributs de page sont héritables (ISO 32000-2 §7.7.3.4) : /Resources, /MediaBox, /CropBox et /Rotate. N'importe lequel peut se poser sur un nœud /Pages, où il s'applique à chaque feuille en dessous sauf si un descendant le remplace. Un writer produisant un rapport avec une annexe au format paysage peut exprimer cette disposition dans l'arbre lui-même :
5 0 obj   % racine du document
<< /Type /Pages /Count 6 /Kids [6 0 R  7 0 R] >>
endobj

6 0 obj   % corps du rapport : A4 portrait, police du corps
<< /Type /Pages /Parent 5 0 R /Count 3
   /Kids [30 0 R  31 0 R  32 0 R]
   /MediaBox [0 0 595 842]
   /Resources << /Font << /F1 8 0 R >> >> >>
endobj

7 0 obj   % annexe : A4 paysage, pivoté, sa propre police
<< /Type /Pages /Parent 5 0 R /Count 3
   /Kids [40 0 R  41 0 R  42 0 R]
   /MediaBox [0 0 842 595] /Rotate 90
   /Resources << /Font << /F2 9 0 R >> >> >>
endobj

40 0 obj  % page annexe : hérite de la taille, de la rotation, des polices
<< /Type /Page /Parent 7 0 R /Contents 43 0 R >>
endobj
Les objets 40 à 42 sont presque vides. La taille de page, la rotation et les ressources de police arrivent toutes du nœud 7, ce qui garde le fichier compact et auto-entretenu : ajoutez une quatrième page sous le nœud d'annexe et elle sort en paysage sans que personne n'y touche
Cela signifie aussi que les propriétés d'une page ne sont pas toutes sur la page. L'objet 40 n'a pas de clé /MediaBox, et c'est parfaitement légal — un lecteur qui traite la clé manquante comme une entrée malformée rejettera des fichiers valides. La recherche doit remonter la chaîne /Parent jusqu'à trouver l'entrée ou atteindre la racine. Cette marche a besoin d'un garde anti-cycle. Un fichier corrompu peut porter une référence /Parent qui pointe en arrière vers un nœud déjà visité, et sans un ensemble d'objets visités la recherche tourne en boucle pour toujours
Le même mécanisme crée le risque classique de déplacement de page. Supposez qu'un outil déplace l'objet 40 dans le corps du rapport en éditant les deux tableaux /Kids et en repointant /Parent vers le nœud 6. Le déplacement est structurellement valide, mais l'objet 40 hérite désormais de la /MediaBox portrait, d'aucune rotation et de la police /F1 — tandis que son flux de contenu sélectionne toujours /F2, qui ne se résout plus. La page rétrécit, se dé-pivote et perd son texte en une seule modification. Un code de réorganisation qui tient debout écrit les valeurs résolues des quatre attributs héritables sur le dictionnaire de page avant de le re-parenter. Si vous avez déjà fait glisser une page dans un éditeur et regardé comment elle change de taille ou d'orientation, c'est le mécanisme que vous avez vu
Aplatissement : légal, courant, parfois coûteux
Beaucoup d'outils font l'inverse. Les writers minimaux émettent un arbre à un seul niveau parce que c'est simple, et de nombreux utilitaires de fusion et de fractionnement reconstruisent n'importe quel arbre lu en un seul tableau /Kids plat, car la sortie équilibrée est du travail en plus et la sortie plate est toujours conforme. Une reconstruction correcte doit résoudre l'héritage en même temps. Chaque attribut dont héritait une feuille doit être copié sur la feuille, ou hissé vers la nouvelle racine s'il est uniforme dans tout le document ; sautez cette étape et la sortie change de géométrie exactement comme dans le cas du déplacement de page
Pour les documents typiques, l'aplatissement est inoffensif. Il fait mal à l'échelle, des deux manières déjà décrites : le tableau racine devient un grand objet que chaque ouverture et chaque saut de page analysent en entier, et chaque édition structurelle le réécrit en entier. Ce que l'aplatissement ne détruit pas, c'est le partage par références indirectes. Un arbre plat où les 10 000 pages pointent vers le même objet dictionnaire /Resources reste dédupliqué — la seule chose perdue est l'option de laisser l'entrée hors de la page et de laisser un ancêtre la fournir
Quand /Count ment
/Count est de la pure comptabilité. Il doit égaler le nombre de pages feuilles dans le sous-arbre du nœud, et rien dans le format de fichier ne l'impose. Deux schémas de corruption expliquent la plupart des comptes mensongers vus dans la nature
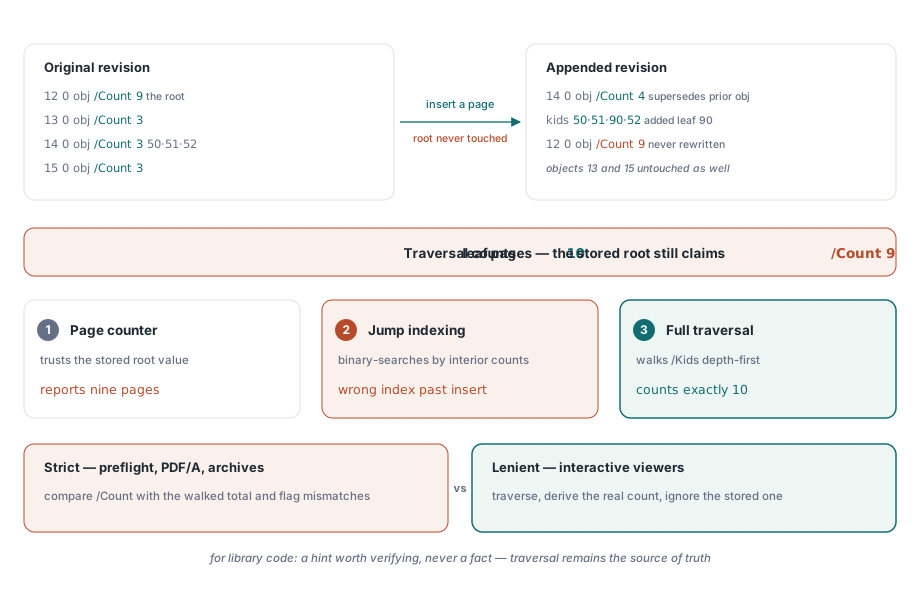
Le premier est le compte périmé laissé par une mise à jour incrémentale. Un éditeur insère une page, réécrit le parent immédiat avec un nouveau /Kids et un /Count mis à jour, ajoute les deux au fichier — et ne touche jamais aux ancêtres :
% Révision originale
12 0 obj
<< /Type /Pages /Count 9 /Kids [13 0 R  14 0 R  15 0 R] >>
endobj

14 0 obj
<< /Type /Pages /Parent 12 0 R /Count 3
   /Kids [50 0 R  51 0 R  52 0 R] >>
endobj

% Révision ajoutée : une page insérée dans la branche du milieu.
% Objet 14 remplacé ; objet 12 jamais réécrit
14 0 obj
<< /Type /Pages /Parent 12 0 R /Count 4
   /Kids [50 0 R  51 0 R  90 0 R  52 0 R] >>
endobj
L'arbre contient maintenant dix feuilles, mais la racine indique toujours neuf. Un visionneur qui fait confiance à la racine affiche neuf dans son compteur de pages. Celui qui utilise les comptes intérieurs pour rechercher par bissection un saut de page calcule un index erroné pour chaque page après le point d'insertion. Une traversée complète en trouve dix. Trois réponses différentes, un seul fichier
Il y a une manière plus silencieuse de se faire mordre par le même fichier. Un code qui lit le compte racine, commence à parcourir l'arbre, et s'arrête une fois qu'il a collecté ce nombre de pages ne verra jamais la page dix. Aucune exception, aucun avertissement, juste un document écourté d'une page. Utiliser /Count comme borne de boucle ou garde de bornes est l'erreur ; la marche doit courir jusqu'à épuisement de l'arbre, quoi qu'en dise le nombre stocké
Le second schéma est le compte qui n'aurait jamais pu être juste : négatif, zéro sur un nœud peuplé, ou absurdément énorme. Ceux-ci viennent du fuzzing, de dommages de transmission, et parfois de bugs arithmétiques dans des éditeurs. Ils sont dangereux précisément pour le code qui fait confiance à /Count pour l'allocation. Dimensionner un tableau depuis un /Count de -3 déclenche au mieux une erreur de plage, et le faire depuis un /Count de deux milliards est une allocation de déni de service. Traitez la valeur comme une entrée non fiable, comme tous les autres nombres du fichier
Les analyseurs se divisent en deux camps là-dessus. Les consommateurs stricts — outils de preflight, validateurs PDF/A, pipelines d'archivage — comparent /Count au résultat de la traversée et rejettent ou signalent le fichier. Les visionneurs interactifs sont presque universellement tolérants : ils traversent, dérivent le compte réel et ignorent silencieusement celui stocké, ce qui explique exactement pourquoi un fichier à compte périmé peut circuler des années sans plainte jusqu'à ce qu'il rencontre un analyseur plus strict dans un flux automatisé. Pour du code de bibliothèque, nous pensons que le juste milieu est le bon défaut. Utilisez /Count comme indication pour la préallocation, et pour sauter des sous-arbres une fois vérifié, et laissez la traversée rester la source de vérité
En production, ces échecs s'annoncent rarement comme des problèmes d'arbre. Ils se manifestent en pages mélangées, une page manquante à la fin d'une fusion, ou une page qui change de taille ou d'orientation après une réorganisation. L'étude de cas de débogage remonte un tel signalement à travers l'arbre. Pour l'anatomie du fichier autour (objets, données de références croisées, trailers), la vue d'ensemble de la structure d'un fichier PDF est le point de départ
Le Composant HotPDF gère tout cela en interne : il traverse des arbres imbriqués de n'importe quelle profondeur, résout les attributs hérités quand des pages sont copiées ou déplacées, et vérifie /Count contre le nombre réel de feuilles au lieu de s'y fier, si bien que les indices de page dans son API désignent toujours des pages logiques