Le symptôme classique ressemble à un off-by-one : une routine de copie de pages demande la page 1 d'un document de trois pages et obtient systématiquement la page 2. La logique d'indexation semble correcte. L'appel utilise un index logique basé sur 0, l'arithmétique est correcte, les conditions aux limites (boundary conditions) sont bonnes. Pourtant, la mauvaise page sort à chaque fois
La cause n'est pas du tout dans le code de copie. Elle se trouve dans la façon dont le loader construit son tableau de pages, et c'est l'un des pièges les plus faciles à attraper dans l'analyse PDF
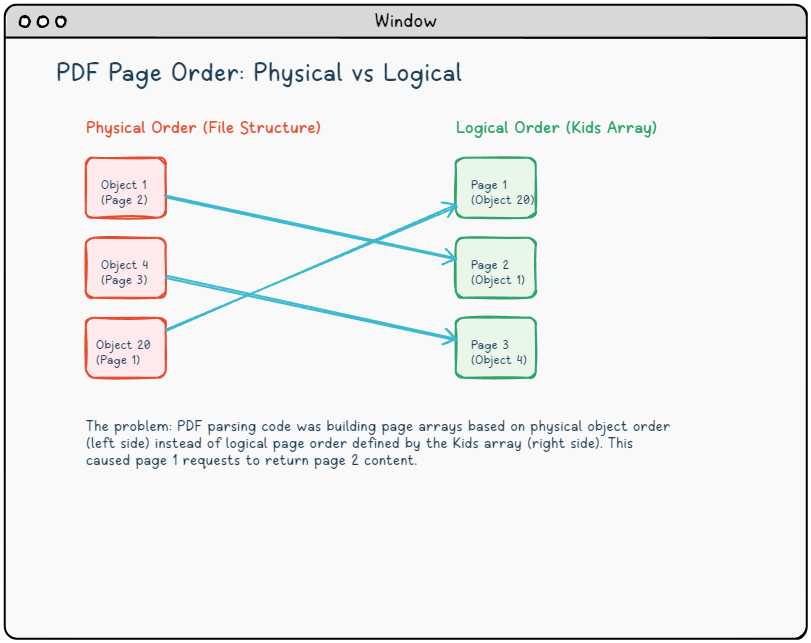
Deux classements (orderings), une source de confusion
Un fichier PDF est une collection d'objets indirects, chacun identifié par un numéro d'objet. La structure du fichier n'impose aucune obligation à ces numéros de refléter l'ordre de lecture. L'objet 1 peut contenir la page 2 ; l'objet 20 peut contenir la page 1. Ce qui définit réellement l'ordre de lecture est l'arborescence des pages (page tree) : une hiérarchie de dictionnaires /Pages dont les tableaux /Kids répertorient les références de page dans la séquence qu'une visionneuse doit afficher (ISO 32000-1 §7.7.3)
Voici une arborescence de pages qui expose le piège :
{ Racine de l'arbre Pages, objet 16 }
16 0 obj
<<
  /Type /Pages
  /Count 3
  /Kids [20 0 R   { logical page 1 }
         1 0 R    { logical page 2 }
         4 0 R]   { logical page 3 }
>>
endobj
Le fichier s'est avéré répertorier l'objet 1 et l'objet 4 avant l'objet 20 dans le flux d'octets. Tout analyseur (parser) qui itérait à travers des objets indirects dans l'ordre du fichier et les estampillait (stamped them) dans un PageArr au fur et à mesure qu'il trouvait des dictionnaires de type page finirait avec l'objet 1 à l'index 0, l'objet 4 à l'index 1, et l'objet 20 à l'index 2. La page logique 1 se trouve à PageArr[2]. Demander l'index de page 0 récupère la page logique 2 à la place
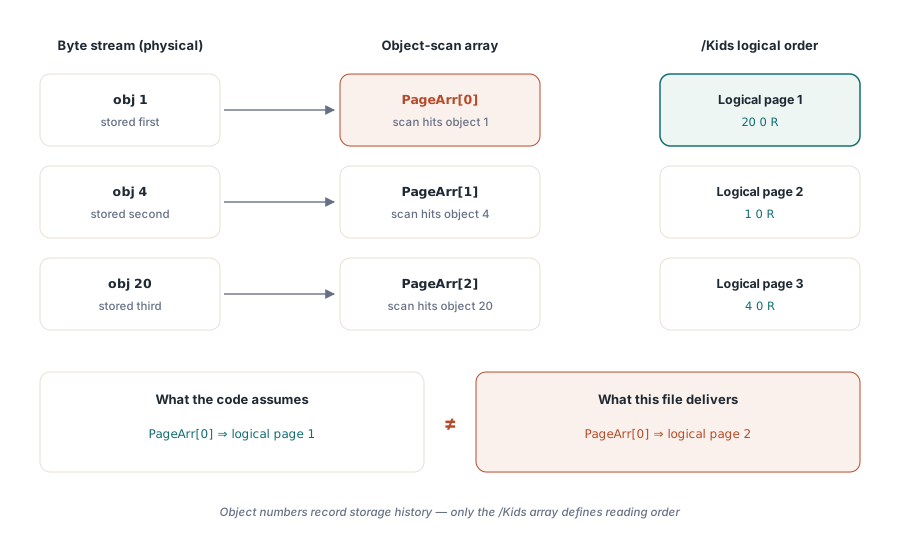
Confirmation de l'hypothèse
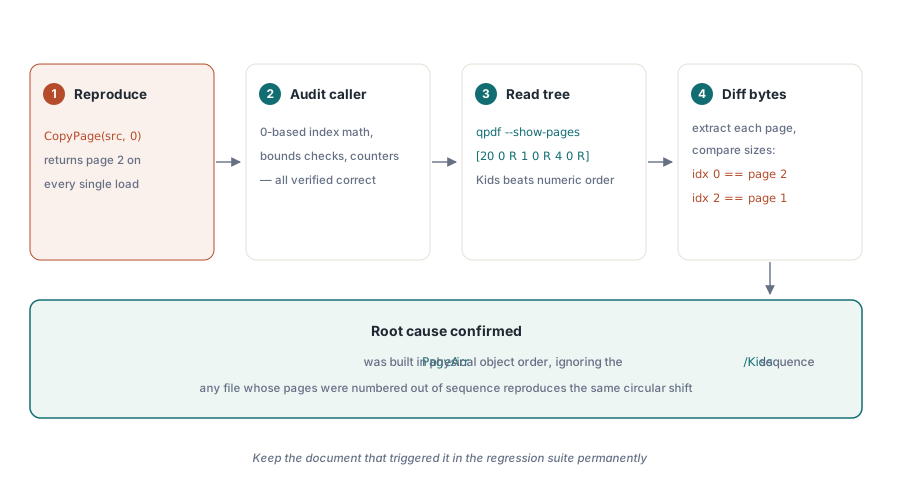
Avant de changer le moindre code, prouvez l'inadéquation (mismatch) plutôt que de la supposer. L'outil en ligne de commande qpdf rend cela simple :
{ shell }
qpdf --show-pages input.pdf
{ La sortie révèle l'ordre des Kids : 20 0 R, puis 1 0 R, puis 4 0 R }

qpdf --show-object="16 0 R" input.pdf
{ Affiche le dictionnaire Pages avec /Kids dans l'ordre de lecture }
L'extraction individuelle de chaque page et la comparaison des tailles de fichiers confirment le mappage : ce que le PageArr[0] d'un balayage d'objets produit est le contenu appartenant à la page logique 2, et PageArr[2] contient la page logique 1. Le décalage circulaire (circular shift) est la preuve irréfutable (smoking gun). Cela explique aussi pourquoi le symptôme apparaît sur de nombreux documents sources différents : tout PDF où les objets de page se trouvent avoir des numéros d'objet inférieurs à une page logique antérieure le déclenche
Il y a une raison simple pour laquelle les PDF finissent dans cet état. Une mise à jour incrémentielle conserve les numéros d'objet des objets qu'elle modifie, mais tout ce qu'elle ajoute, une page de couverture (cover page) insérée au début par exemple, reçoit un nouveau numéro supérieur à tout ce qui est déjà dans le fichier, tandis que sa référence va au début du tableau Kids. Les outils qui fusionnent ou réorganisent des documents renumérotent les objets dans l'ordre qui leur convient. Certains générateurs écrivent simplement des pages dans un ordre pratique pour le streaming de contenu plutôt que pour la séquence de pages logique. Le format PDF ne leur demande pas de faire autrement
La bonne approche : suivre le tableau Kids
Construisez la liste des pages en parcourant la chaîne /Kids à partir de la racine du catalogue, et non en balayant les objets indirects. Le parcours doit être récursif, car un document volumineux répartit généralement ses pages entre des nœuds /Pages intermédiaires, et il doit se prémunir contre un arbre malformé qui pointerait vers l'un de ses propres ancêtres. Dans le croquis ci-dessous, TPdfDict et TPdfArray représentent les types dictionnaire et tableau utilisés par votre analyseur :
type
  TPageList = array of TPdfDict;

procedure CollectPages(Node: TPdfDict; var Pages: TPageList;
  Depth: Integer = 0);
var
  Kids: TPdfArray;
  Child: TPdfDict;
  I: Integer;
begin
  if Depth > 64 then  // un cycle ou un arbre pathologiquement profond
    raise EPdfError.Create('Page tree too deep or cyclic');
  Kids := Node.GetArray('Kids');
  if Kids = nil then
    Exit;
  for I := 0 to Kids.Count - 1 do
  begin
    Child := Kids.ResolveDict(I);  // suit la référence indirecte
    if Child = nil then
      Continue;
    if Child.GetName('Type') = 'Pages' then
      CollectPages(Child, Pages, Depth + 1)  // nœud intermédiaire
    else
    begin
      SetLength(Pages, Length(Pages) + 1);   // feuille : page suivante dans l'ordre d'affichage
      Pages[High(Pages)] := Child;
    end;
  end;
end;

// Utilisation : partir de l'entrée /Pages du catalogue
SetLength(Pages, 0);
CollectPages(Catalog.ResolveDict('Pages'), Pages);
if Length(Pages) <> Catalog.ResolveDict('Pages').GetInteger('Count') then
  LogWarning('Page tree /Count disagrees with the pages actually found');
Deux détails sont délibérés. Une feuille sans entrée /Type est quand même traitée comme une page, car certains rédacteurs l'omettent et les visionneuses ouvrent ces fichiers malgré tout. Et la comparaison finale du /Count ne coûte rien mais attrape les arbres tronqués ou édités à la main avant qu'un appelant n'y indexe
Si vous chargez des documents avec HotPDF, cet ordre est déjà résolu au chargement du document : les indices de pages suivent l'ordre d'affichage de l'arborescence des pages, nœuds /Pages imbriqués inclus, si bien que l'indice 0 est toujours la première page qu'une visionneuse affiche. Le parcours ci-dessus importe lorsque votre propre code analyse directement la structure PDF
Copier par index logique avec CopyPageFromDocument
Comme HotPDF résout l'ordre des pages au chargement, les indices de pages logiques signifient ce que les appelants attendent. Le CopyPageFromDocument de haut niveau prend un index logique basé sur 0 et copie la bonne page dans le document de destination :
var
  Source, Dest: THotPDF;
begin
  Source := THotPDF.Create(nil);
  Dest   := THotPDF.Create(nil);
  try
    Source.LoadFromFile('source.pdf');

    Dest.FileName := 'extracted.pdf';
    Dest.BeginDoc;

    { Copie la page logique 0 (la première page que voit l'utilisateur) }
    Dest.CopyPageFromDocument(Source, 0, 0);

    Dest.EndDoc;
  finally
    Source.Free;
    Dest.Free;
  end;
end;
Parce que l'indice est un indice d'ordre d'affichage, CopyPageFromDocument se comporte correctement même avec les documents où l'ordre physique et logique divergent. Pour les opérations par lots (batch operations), InsertPagesFromDocument accepte un tableau d'indices logiques et les copie en un seul passage
Ce que cela révèle sur l'analyse (parsing) PDF
La spécification PDF est explicite : l'ordre des pages logiques est défini par le tableau /Kids de l'arborescence des pages, et non par des numéros d'objet ou des décalages d'octets (ISO 32000-1 §7.7.3.2). Tout analyseur (parser) qui utilise un classement (ordering) différent comme raccourci produira des résultats corrects sur la majorité des documents qu'il voit, car la plupart des générateurs écrivent des pages dans l'ordre naturel et attribuent des numéros d'objet séquentiels. L'erreur se cache jusqu'à ce que quelqu'un charge un PDF qui a été édité de manière incrémentielle, réorganisé par un autre outil ou généré par un logiciel qui a choisi une disposition (layout) différente
Les tests effectués uniquement sur des PDF auto-générés ne permettent pas de détecter cette classe de problèmes. La gestion de l'ordre des pages a besoin d'un corpus de documents provenant de sources variées : sauvegardes incrémentielles, documents numérisés avec pages de couverture (cover pages) insérées, PDF produits par des outils qui linéarisent ou optimisent différemment le graphe d'objets. Tout document dont l'ordre physique et logique diverge mérite une place permanente dans ce corpus
La page du Composant HotPDF couvre l'API complète pour les opérations de page, y compris CopyPageFromDocument, InsertPagesFromDocument et MovePage