Un PDF qui semble parfait sur votre machine mais s'affiche sous forme de carrés vides sur la machine de quelqu'un d'autre est le défaut de police le plus courant dans les logiciels de documents, et cela ne signifie presque jamais une erreur de texte. Les caractères sont intacts et le codage est correct, seuls les glyphes (glyphs) sont absents. La différence entre les deux machines réside dans les polices installées sur le système d'exploitation, et l'écart entre un document portable et un document fragile réside dans une décision prise lors de la création de la page : la police voyage-t-elle avec le PDF, ou suppose-t-on sa présence sur le terminal cible
Pour comprendre pourquoi cela se produit, et pourquoi une autre défaillance génère un texte qui semble consultable mais se révèle être du charabia à la copie, il faut examiner la façon dont le PDF store le texte. Il ne stocke pas de phrases. Il stocke des codes de glyphes ainsi qu'un programme de police et les tables qui les associent, et chaque erreur de rendu ou d'extraction réside dans les vides entre ces trois éléments. Voici un tour d'horizon de ce mécanisme basé sur l'ISO 32000, accompagné au besoin des appels Delphi pour le contrôler
Caractère, code et glyphe sont trois choses différentes
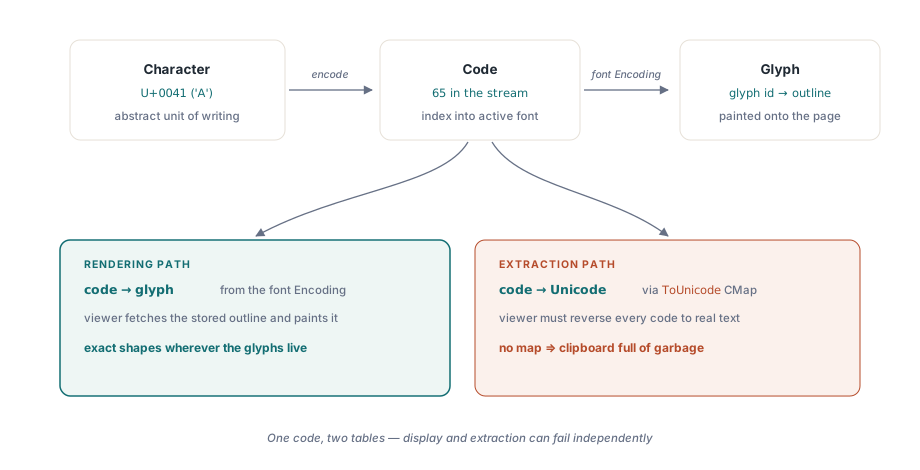
Le vocabulaire prête souvent à confusion car le langage courant regroupe trois concepts distincts sous le mot "lettre". Un caractère (character) est l'unité abstraite d'écriture, le concept de la lettre majuscule A, identifié en Unicode par U+0041. Un glyphe (glyph) est la forme dessinée, les courbes et contours d'épaisseur utilisés par une police spécifique pour représenter ce caractère. Entre les deux se trouve le code (code) : les octets dans le flux de contenu indiquant au visualiseur quel glyphe dessiner pour la police actuelle
Le PDF fonctionne au niveau du code. Lorsqu'un flux de contenu affiche une chaîne de caractères, ces octets sont des index dans la police actuellement active, et non de l'Unicode. L'encodage de la police détermine que le code 65 signifie "dessiner le glyphe archivé sous le numéro 65", un processus qui ne contient aucune information indiquant que ce résultat ressemble à un A pour un être humain. C'est précisément pour cela que le PDF peut s'afficher de manière parfaitement cohérente n'importe où tant qu'il trouve les glyphes, et c'est aussi pourquoi l'extraction est un problème différent de l'affichage : le dessin nécessite uniquement une correspondance code-vers-glyphe (code-to-glyph), tandis que la lecture nécessite une correspondance code-vers-Unicode (code-to-Unicode), et ce sont deux tables distinctes qui peuvent être incohérentes ou manquantes de manière indépendante
Les types de polices que vous rencontrerez réellement
La norme ISO 32000 définit plusieurs types de dictionnaires de polices, dont trois sont utilisés en pratique dans les documents que vous recevez ou générez. Savoir lequel vous examinez explique la grande majorité des problèmes potentiels
Le type 1 est le format de contour PostScript d'origine d'Adobe, construit à partir de courbes de Bézier cubiques. Les quatorze polices standard que tout lecteur conforme doit fournir — les familles Helvetica, Times, Courier, Symbol et ZapfDingbats — sont de type 1, et un dictionnaire de police qui en désigne une peut légitimement omettre le programme de police. C'est le seul cas où ne pas incorporer une police est sûr par spécification et non par chance. Pour toute autre police de type 1, le programme doit être incorporé, sinon le visualiseur fait une substitution, généralement par une police métriquement similaire mais visuellement différente
TrueType utilise des courbes quadratiques et vient du monde Apple et Microsoft. C'est ce que sont la plupart des polices système, et ce que vous incorporerez le plus souvent. Une police TrueType simple en PDF se limite à des codes sur un octet, donc une telle police adresse au plus 256 glyphes à la fois. Ce plafond est la raison structurelle pour laquelle le CJK et les autres grands systèmes d'écriture ne peuvent pas voyager sur une police simple
Le type 0, police composite ou indexée CID (CID-keyed), est la réponse à cette limitation. Elle utilise des codes multi-octets et une CMap pour les acheminer via des CIDFonts descendantes, dont les contours sont soit TrueType, soit CFF/Type 1. C'est le seul type de police capable de transporter des milliers de glyphes, de sorte que tout PDF contenant du chinois, du japonais, du coréen ou un mélange multilingue étendu utilise le type 0, que l'auteur y ait pensé ou non. Le prix à payer est la complexité : il y a plus de pièces mobiles, et une plus grande partie d'entre elles doit être correcte à la fois pour le rendu et pour l'extraction
Un détail derrière cette illustration détermine la taille du fichier. Les polices étant des bibliothèques de contours et non des bitmaps de taille fixe, le même programme incorporé dessert toutes les tailles de points (point size) de la page. La mise à l'échelle est une transformation appliquée lors du dessin, ce qui explique pourquoi un titre et son corps de texte peuvent partager la même police incorporée, et pourquoi le coût de l'incorporation est calculé par police et non par taille
L'incorporation détermine si le fichier est portable ou fragile
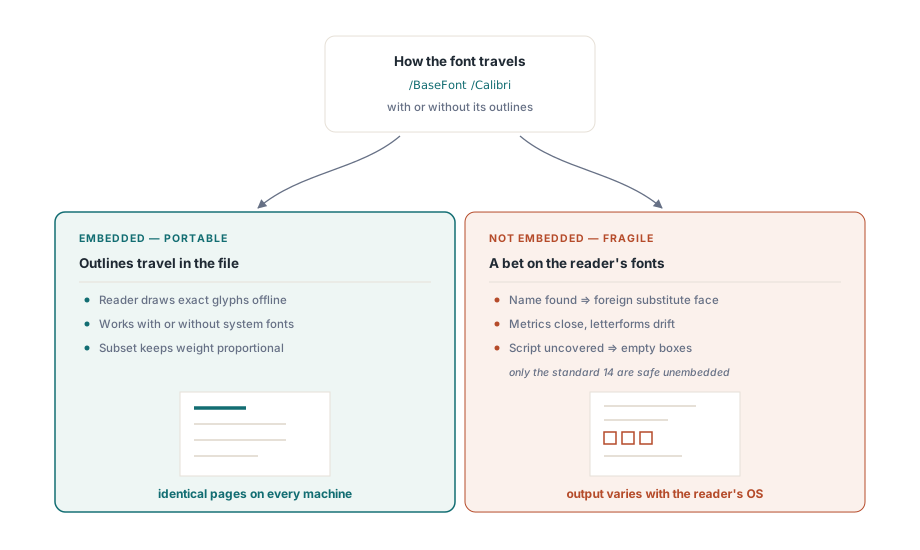
L'incorporation (Embedding) signifie que le programme de police — les données réelles de contour — est écrit sous forme de flux dans le fichier PDF. Le lecteur d'une machine qui n'a jamais entendu parler de votre police pourra ainsi lire ces contours directement depuis le fichier et dessiner les glyphes exacts. Si vous omettez l'incorporation, vous pariez sur la présence d'une police du même nom sur le système de destination ; si ce système ne l'a pas, le visualiseur se repliera sur une police de substitution. Pour les quatorze polices standard, cette substitution est prédéfinie et inoffensive. Pour toutes les autres polices, les résultats sont imprévisibles, allant d'un espacement légèrement décalé à des rectangles vides en l'absence de police alternative couvrant ce système d'écriture
Dans HotPDF, le contrôle nécessite simplement de configurer une propriété avant l'ouverture du document. FontEmbedding indique à la bibliothèque d'intégrer les polices utilisées pour le dessin dans le fichier :
var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.FileName := 'report.pdf';
    Pdf.Compression := cmFlateDecode;
    Pdf.FontEmbedding := True;          // les contours voyagent à l'intérieur du fichier
    Pdf.BeginDoc;
    Pdf.CurrentPage.SetFont('Calibri', [], 11);
    Pdf.CurrentPage.TextOut(72, 760, 0, 'This renders the same on a machine without Calibri.');
    Pdf.EndDoc;
  finally
    Pdf.Free;
  end;
end;
Cet ordre n'est pas décoratif. BeginDoc est le moment où HotPDF valide la structure du document, de sorte que FontEmbedding doit être défini sur true avant cet appel. S'il est affecté après, aucune erreur ni avertissement ne sera émis, mais le fichier sera généré silencieusement sans inclure les polices. C'est le pire type de bogue : il réussit tous les tests sur votre machine de développement où la police est installée, et ne se révèle que sur la machine du client où elle fait défaut
L'incorporation est également le point de rencontre entre licences et ingénierie. Les programmes de polices comportent des indicateurs décrivant s'ils peuvent être librement incorporés, uniquement prévisualisés ou totalement interdits d'incorporation. Respecter ces indicateurs relève de votre responsabilité, pas de celle du moteur de rendu, et le fait que "cela fonctionne" n'est pas équivalent à "être autorisé à le faire"
Sous-définition : n'incorporer que les glyphes que vous utilisez
Une incorporation complète écrit l'intégralité du programme de police dans le fichier. Une grande police CJK TrueType peut peser plusieurs mégaoctets, et l'incorporer entièrement pour afficher seulement une douzaine de caractères est un gaspillage qui s'accumule de manière exponentielle dans les documents multipages. La sous-définition (Subsetting) résout ce problème en n'écrivant que les glyphes référencés dans le document, puis en renommant la police avec un préfixe de six lettres suivi d'un signe plus (comme ABCDEF+Calibri, visible dans la liste des polices de tout PDF sous-défini) afin que le lecteur ne confonde pas ce sous-ensemble avec la police système complète du même nom
Pour la plupart des documents générés, la sous-définition est l'option par défaut appropriée. Elle maintient la taille du fichier proportionnelle au contenu plutôt qu'à la police source, ce qui est crucial pour les grandes polices multilingues qui autrement domineraient le fichier. La seule mise en garde est que le sous-ensemble ne contient que le contenu utilisé au moment de la création. Si un processus en aval tente d'ajouter du texte ultérieurement à un document contenant des polices sous-définies, les glyphes requis peuvent ne pas exister dans le fichier, ce qui constitue une contrainte réelle lors de l'édition incrémentielle de PDF tiers
Polices Unicode et problème des carrés CJK
Lorsque le texte n'appartient pas à l'alphabet latin pur, le chemin des polices simples (simple-font) s'arrête. La solution consiste à enregistrer explicitement une police prenant en charge Unicode, permettant à HotPDF de construire une police Type 0 basée sur celle-ci. RegisterUnicodeTTF charge un fichier TrueType via son chemin ; après cela, ce nom enregistré peut être utilisé comme n'importe quel autre nom dans SetFont :
Pdf.FontEmbedding := True;
Pdf.RegisterUnicodeTTF('C:\Fonts\NotoSansCJKsc-Regular.ttf');
Pdf.BeginDoc;
Pdf.CurrentPage.SetFont('NotoSansCJKsc-Regular', [], 14);
Pdf.CurrentPage.TextOut(72, 720, 0, '你好,世界 こんにちは 안녕하세요');
Pdf.EndDoc;
Deux choses font la réussite ou l'échec ici. La police doit couvrir les systèmes d'écriture de la chaîne : une TrueType réservée au latin ne produira pas des glyphes chinois parce que vous le lui demandez, et le résultat est à nouveau des carrés vides, cette fois parce que le glyphe n'existe réellement pas dans cette police. Et l'incorporation doit rester active, car une police Type 0 assemblée depuis une TTF enregistrée ne signifie rien pour un lecteur qui ne trouve pas les contours. Pour le contenu mixte, le choix durable est une police à large couverture — les familles Noto et Arial Unicode MS étant les réponses habituelles — incorporée et sous-définie
Les scripts de droite à gauche et complexes ajoutent une couche de mise en forme par-dessus la couverture. HotPDF expose RtLTextOut pour l'arabe et l'hébreu, qui gère le réordonnancement directionnel : vous passez l'ordre logique et laissez la bibliothèque faire la mise en page. Avoir un arabe correct, c'est couverture plus mise en forme plus direction, trois choses distinctes, et un carré à cet endroit peut signifier l'échec de n'importe laquelle
La table ToUnicode : là où vit le copier-coller
Tout ce qui précède concerne le dessin. L'extraction est l'image miroir et échoue pour ses propres raisons. Un visualiseur rend une page en utilisant la correspondance code-vers-glyphe de la police, mais quand un utilisateur sélectionne du texte et le copie, le visualiseur doit reconvertir ces mêmes codes en Unicode. Cette correspondance inverse est la CMap ToUnicode, un flux optionnel rattaché à la police
Lorsqu'elle est présente et correcte, le texte copié s'exporte sous forme de caractères corrects. Lorsqu'elle est manquante ou erronée, ou si la police est sous-définie avec des codes de glyphes personnalisés sans écriture de ToUnicode, la page s'affiche parfaitement mais le presse-papiers se remplit de charabia : les codes de glyphes sont lus comme de l'Unicode alors qu'ils ne le sont pas pour un sous-ensemble d'encodage personnalisé. C'est pourquoi les documents numérisés avec une couche de texte OCR peuvent être consultables, tandis que les PDF numériques natifs issus de générateurs négligents ne le sont pas. Le rendu et l'extraction utilisant des tables différentes, il est possible qu'un fichier satisfasse l'un tout en brisant l'autre. Si la fonction d'extraction est importante pour vos sorties, considérez un mappage ToUnicode correct comme indispensable, et vérifiez-le personnellement en copiant du texte à partir d'exemples plutôt que de croire aveuglément qu'il est présent
Comment diagnostiquer rapidement les défauts de police
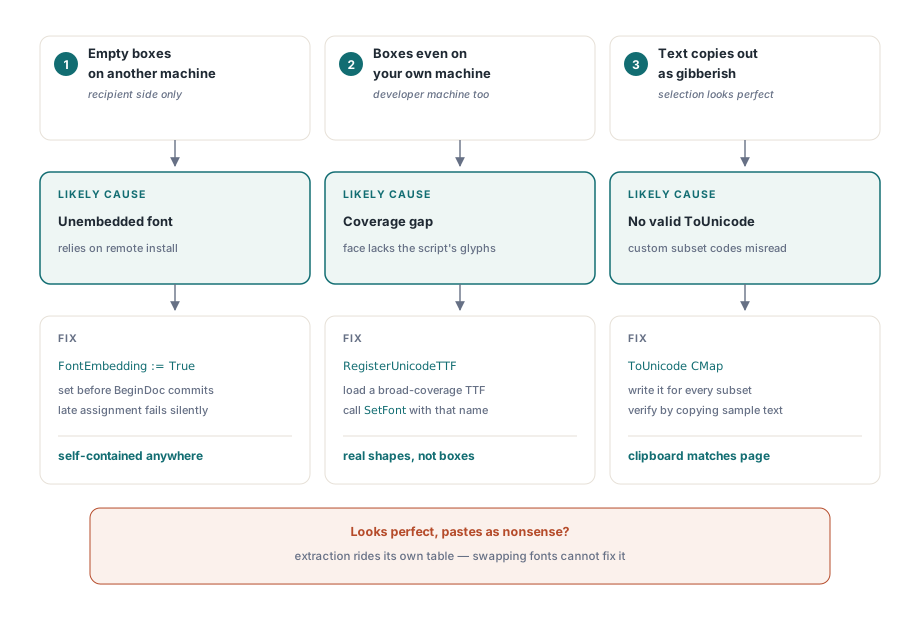
Le mode d'échec vous indique où chercher la cause. Les rectangles vides apparaissant sur la machine de quelqu'un d'autre signifient presque toujours que la police n'a pas été incorporée. La première vérification porte donc sur l'incorporation, et la seconde sur la couverture des glyphes. Des rectangles apparaissant même sur votre propre machine pointent directement vers un problème de couverture de caractères : la police ne contient tout simplement pas ce système d'écriture, qu'elle soit incorporée ou non. Si le texte s'affiche correctement mais se transforme en charabia lors de la copie, il s'agit d'un problème ToUnicode et non d'un problème de rendu. Manipuler les polices ou l'incorporation n'y changera rien, car la fonction de dessin n'a jamais échoué. Pour lire un fichier généré, vous pouvez l'ouvrir dans Acrobat et consulter l'onglet Polices des propriétés du document : une entrée saine affichera son type, indiquera "Incorporée (Embedded)" ou "Sous-ensemble incorporé (Embedded Subset)", et spécifiera l'encodage. Une police qui aurait dû être incorporée mais ne l'a pas été se révélera d'elle-même ici avant même que le client ne s'en aperçoive
Rien de tout cela n'est exotique une fois la distinction entre caractère, code et glyphe claire. Incorporez les polices avec lesquelles vous dessinez, sous-définissez les grosses, passez à une police Unicode et à RegisterUnicodeTTF dès que le texte quitte le latin, et gardez une carte ToUnicode correcte si quelqu'un doit extraire le texte. Avec cela en ordre, les carrés cessent d'apparaître. Pour la mécanique autour, l'anatomie d'un PDF minimal montre où le dictionnaire de police se situe dans l'arbre d'objets, et la visite de la structure de document couvre le partage des ressources entre pages
Les appels de SetFont, FontEmbedding et RegisterUnicodeTTF présentés ici font partie du HotPDF Delphi Component pour Delphi et C++Builder