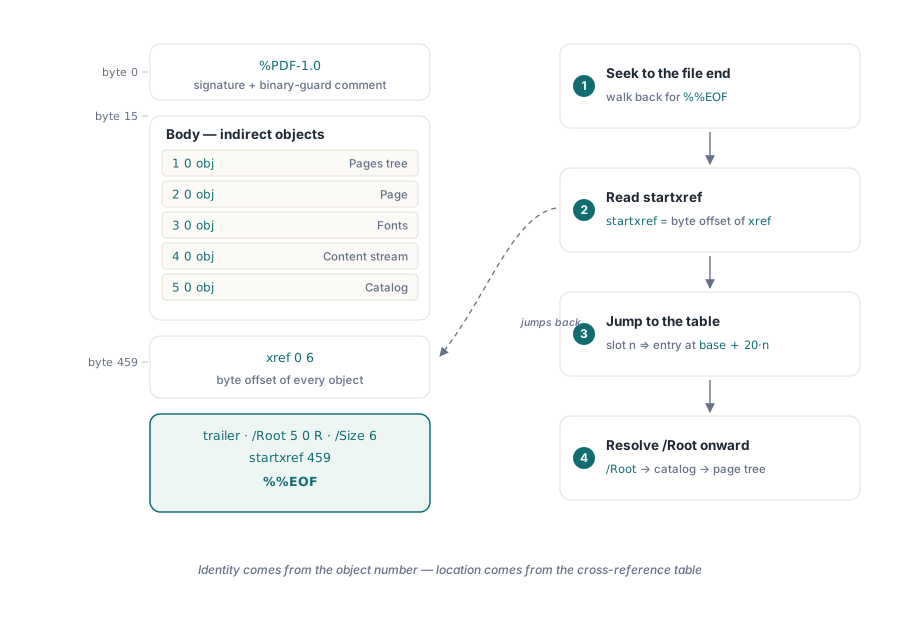
Les lecteurs PDF ne commencent pas à lire le fichier depuis le début, mais depuis la fin. Les derniers octets contiennent les adresses de tout le reste, et si l'analyseur ne comprend pas cet ordre, analyser à partir de la première ligne entraînera une mauvaise interprétation de l'ensemble du format. Par conséquent, la méthode la plus efficace pour étudier un PDF sur le disque est de suivre le chemin du lecteur : commencer par la fin, puis sauter en arrière vers la table de correspondance (map), et enfin analyser les objets pointés par cette table
Lorsque rien n'est compressé, ces octets sont très clairs et peuvent être lus directement dans un éditeur de texte. Un document minimal d'une page affichant "Hello, World!" pèse moins de 500 octets, et chaque élément structurel du format y est clairement visible. Voici le fichier complet, avec ses quatre parties repérées :
%PDF-1.0                          % Header
%âãÏÓ

1 0 obj                           % Body : la séquence d'objets
<<
/Kids [2 0 R]
/Count 1
/Type /Pages
>>
endobj

2 0 obj
<<
/Rotate 0
/Parent 1 0 R
/Resources 3 0 R
/MediaBox [0 0 612 792]
/Contents [4 0 R]
/Type /Page
>>
endobj

3 0 obj
<< /Font << /F0 << /BaseFont /Times-Italic /Subtype /Type1 /Type /Font >> >> >>
endobj

4 0 obj
<< /Length 65 >>
stream
1. 0. 0. 1. 50. 700. cm BT
  /F0 36. Tf
  (Hello, World!) Tj
ET
endstream
endobj

5 0 obj
<< /Pages 1 0 R /Type /Catalog >>
endobj

xref                              % Cross-reference table
0 6
0000000000 65535 f
0000000015 00000 n
0000000074 00000 n
0000000192 00000 n
0000000291 00000 n
0000000409 00000 n

trailer                           % Trailer
<<
/Root 5 0 R
/Size 6
>>
startxref
459
%%EOF
Ces quatre parties sont toujours agencées de haut en bas dans l'ordre suivant : l'en-tête (header), le corps des objets (body), la table des références croisées (cross-reference table) et le trailer. Notez que vous les lisez presque dans l'ordre inverse. La norme ISO 32000-2 §7.5.1 prescrit également cette structure en quatre parties, et le choix d'un accès de la fin vers le début s'explique uniquement par des raisons d'efficacité : un lecteur sautant directement à l'objet requis est bien plus rapide qu'un lecteur scannant chaque octet depuis le début, le trailer et la table des références croisées étant précisément là pour offrir cet accès aléatoire
L'en-tête (Header) contient deux lignes, dont la seconde est essentielle
La première ligne est %PDF-1.0. Du point de vue de la syntaxe, le symbole de pourcentage en fait un commentaire, mais le lecteur le traite comme une signature de fichier et en extrait le numéro de version. En pratique, la gestion des versions est assez souple. Un lecteur conçu spécifiquement pour le PDF 2.0 ouvrira volontiers un fichier déclaré comme 1.0, et la plupart des lecteurs tenteront également d'ouvrir des fichiers avec un numéro de version erroné ou dont la ligne de version est enfouie profondément dans le fichier (plutôt qu'à l'octet 0). Ce nombre n'est qu'une indication des fonctionnalités attendues, pas une restriction
La deuxième ligne est celle que l'on peut facilement supprimer par accident pour passer ensuite tout un après-midi à déboguer. C'est également un commentaire, mais sa charge utile se compose de quatre octets supérieurs à l'ASCII 127. Ils sont là pour que tout outil transférant des fichiers en "mode texte" les reconnaisse comme binaires et cesse de réécrire les fins de lignes. Le PDF contient des flux compressés et ces octets peuvent coïncider avec des retours chariot ou des sauts de ligne ; si l'outil de transfert les réécrit, la longueur de flux enregistrée dans le dictionnaire ne correspondra plus aux octets sur le disque, corrompant le fichier. Ce commentaire à octets élevés est un mécanisme de défense vieux de quarante ans contre le FTP en mode ASCII, toujours présent dans les fichiers écrits par tous les outils sérieux en raison de la nature silencieuse et fatale des pannes qu'il prévient
Le corps (Body) stocke les objets, chacun ayant son propre numéro
Tout ce qui constitue le document existe sous forme de séquence plate d'objets indirects dans le corps. Chaque objet commence par deux entiers et le mot-clé obj, contient son contenu et se termine par endobj. Dans l'exemple ci-dessus, l'objet 1 est un nœud d'arbre de pages : 1 0 obj, suivi d'un dictionnaire, puis de endobj. Le premier entier est le numéro d'objet, le second est le numéro de génération. Dans un fichier nouvellement écrit, le numéro de génération est presque toujours égal à zéro ; il n'augmente que si le numéro d'objet est réutilisé lors d'une édition, ce qui est extrêmement rare, de sorte que vous pouvez considérer un numéro de génération non nul comme le signe que le fichier a subi une mise à jour incrémentielle. Le contenu entre ces mots-clés est un dictionnaire écrit entre << et >>, mais il peut tout aussi bien s'agir d'un nombre, d'une chaîne de caractères, d'un tableau ou d'un flux
Ce qui en fait un graphe et non une liste est la marque de référence 2 0 R. Elle signifie "objet 2, génération 0, peu importe son emplacement dans le fichier". Le nœud de l'arbre des pages ci-dessus ne contient pas ses pages ; il pointe vers l'objet 2, qui à son tour pointe vers ses ressources et flux de contenu par le même mécanisme. Le contenu du corps est disposé dans l'ordre jugé pratique par le rédacteur, ces références le cousant ensemble dans un arbre enraciné au niveau du catalogue (catalog). La position dans le fichier n'a aucune importance. L'identité provient du numéro d'objet, et l'emplacement de la table des références croisées
La table de références croisées est un index de décalages d'octets
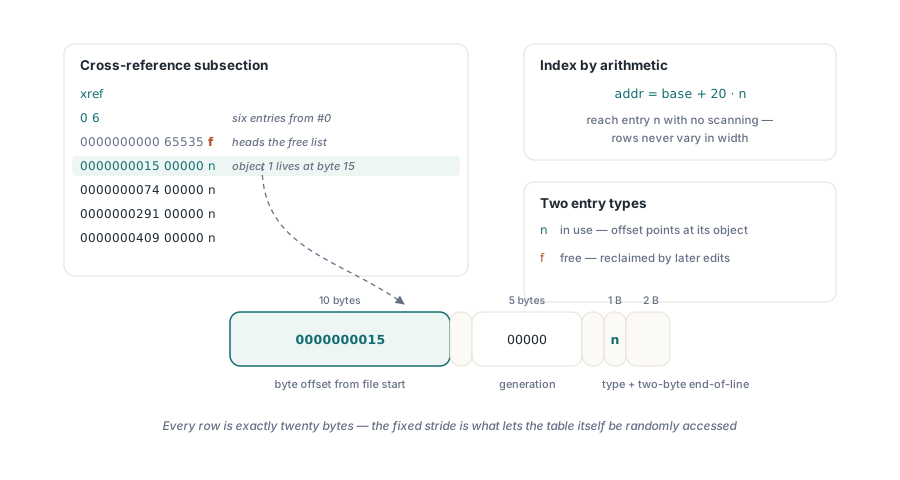
La table xref est ce qui transforme les numéros d'objets en positions dans le fichier. C'est la raison pour laquelle un lecteur peut ouvrir un document de mille pages et rendre la page 850 sans analyser les 849 pages qui la précèdent. Chaque entrée enregistre exactement où commence son objet, compté en octets depuis le début du fichier :
xref
0 6                  % 6 entrées, à partir de l'objet 0
0000000000 65535 f   % entrée 0 : tête de la liste libre
0000000015 00000 n   % l'objet 1 commence à l'octet 15
0000000074 00000 n   % l'objet 2 commence à l'octet 74
0000000192 00000 n   % l'objet 3 commence à l'octet 192
0000000291 00000 n   % l'objet 4 commence à l'octet 291
0000000409 00000 n   % l'objet 5 commence à l'octet 409
La largeur fixe est conçue à dessein. Chaque entrée fait exactement 20 octets : un décalage de 10 chiffres, un espace, un numéro de génération de 5 chiffres, un espace, un type de caractère, et deux octets de fin de ligne. Les lignes étant uniformes, le lecteur peut indexer directement l'entrée de l'objet n par calcul, sans avoir à analyser ; le tableau fournissant un accès aléatoire au corps est donc lui-même accessible de manière aléatoire. La ligne 0 6 est l'en-tête d'une sous-section : elle indique que les entrées suivantes décrivent six objets commençant au numéro 0
L'objet 0 est spécial et toujours présent. Son type f représente libre (free), son numéro de génération est 65535, et il se trouve en tête de la liste chaînée des numéros d'objets libres. Dans un fichier qui n'a jamais été modifié, la liste des objets libres ne contient que cette unique entrée, ce qui est une simple formalité. Elle joue son rôle lors des mises à jour incrémentielles, lorsqu'une suppression d'objet ajoute son numéro à cette liste pour que les éditions ultérieures puissent le recycler. Les autres entrées ont le type n pour indiquer qu'elles sont utilisées, et leurs 10 chiffres représentent le décalage (offset) vers lequel vous devez sauter pour lire la définition de cet objet
Le trailer est le point d'entrée, et il se trouve à la fin
Le trailer est la première chose que le lecteur consomme réellement, bien qu'il soit écrit en dernier. Un analyseur ouvre le fichier, se place à la fin et remonte en arrière à la recherche de %%EOF. Juste au-dessus se trouvent startxref suivi d'un seul nombre, et ce nombre est le décalage en octets du mot-clé xref. Grâce à lui, le lecteur saute directement à la table des références croisées sans avoir analysé le moindre objet :
trailer
<<
/Root 5 0 R          % le catalogue du document
/Size 6              % un de plus que le numéro d'objet le plus élevé
>>
startxref
459                  % décalage en octets de la table xref
%%EOF
Le dictionnaire trailer porte les deux valeurs dont le lecteur a besoin avant de pouvoir faire quoi que ce soit. /Root pointe vers le catalogue du document — l'objet 5 ici — qui est le sommet du graphe d'objets et la route vers l'arbre des pages. /Size est le nombre d'entrées que la table des références croisées doit contenir, soit un de plus que le numéro d'objet le plus élevé à cause de l'entrée libre à l'emplacement zéro. À partir de %%EOF, toute la séquence de lecture se déduit : trouver le marqueur, lire startxref pour localiser la table, charger la table pour savoir où vit chaque objet, lire /Root pour trouver le catalogue, puis résoudre les objets à la demande à partir de là. L'en-tête, situé en haut, n'est guère consulté que tard. C'est la carte du bas dont le lecteur a besoin en premier
Les mises à jour incrémentielles ajoutent une seconde table de correspondance au lieu de réécrire
Lorsque le fichier est modifié, cette conception orientée vers la fin s'avère payante. L'édition d'un PDF ne nécessite la réécriture d'aucun des octets déjà présents sur le disque. Les objets nouveaux et modifiés sont ajoutés à la fin, suivis d'une toute nouvelle section de références croisées et d'un tout nouveau trailer, tandis que le fichier d'origine sous-jacent reste inchangé. La seule nouvelle entrée enregistrée est l'entrée /Prev dans le nouveau trailer, qui conserve le décalage en octets de la table des références croisées précédente :
% ... fichier d'origine, inchangé, se termine ici ...

6 0 obj                          % un objet ajouté par cette édition
<< /Type /Annot /Subtype /Text /Rect [100 700 120 720] >>
endobj

xref                             % une seconde section xref, pour le nouvel objet uniquement
6 1
0000000612 00000 n

trailer
<<
/Root 5 0 R
/Size 7
/Prev 459                        % décalage en octets de la table xref précédente
>>
startxref
680                              % décalage de cette nouvelle section xref
%%EOF
Le lecteur commence toujours par le %%EOF final, suit le startxref jusqu'à la table la plus récente, mais remonte ensuite la chaîne /Prev vers les tables plus anciennes pour les fusionner, garantissant que chaque numéro d'objet utilise toujours l'entrée la plus à jour. Les sections de référence croisée forment une liste liée descendante dans le fichier, chaque section remplaçant les objets concernés dans la section précédente. L'objet remplacé par l'édition reste physiquement présent à son ancien décalage ; il n'est simplement plus accessible car l'entrée xref ultérieure pointe vers un emplacement plus récent
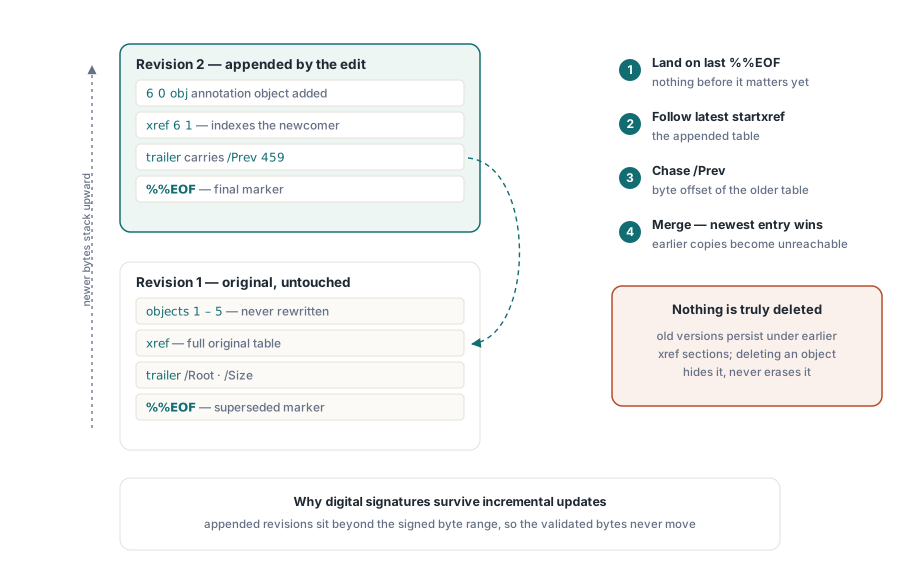
C'est ce mécanisme qui rend les PDF signés vérifiables. La signature numérique couvre une certaine plage d'octets du fichier. Les mises à jour incrémentielles effectuant uniquement des ajouts, les octets signés ne sont jamais déplacés. La signature reste vérifiable par rapport à la plage d'origine, tandis que les révisions ultérieures se situent à sa suite, chacune avec sa table xref et son trailer. C'est également ainsi que le PDF peut conserver un historique récupérable : chaque objet remplacé existe toujours sur le disque sous la section de référence croisée précédente, ce qui est une fonctionnalité pour le suivi des versions, mais un danger potentiel pour ceux qui pensent que "supprimer" signifie la disparition des octets
Le coût, c'est la croissance. Chaque édition ajoute ; rien n'est récupéré sur place, si bien qu'un fichier révisé de nombreuses fois accumule des objets morts et une longue chaîne de sections xref. Le remède est une réécriture complète : charger le document et l'enregistrer à neuf, ce qui renumérote les objets survivants, abandonne les inatteignables et émet une unique table de références croisées propre. Les deux stratégies se négocient directement l'une contre l'autre. L'ajout est rapide et préserve signatures et historique ; la réécriture est plus lente et sacrifie les deux, en échange d'un fichier compact
Lire ces quatre sections en pratique
Connaître la disposition suffit pour déboguer à la main la plupart des problèmes de type « ce fichier ne s'ouvre pas ». Si un lecteur rejette un PDF, les coupables habituels sont aux deux extrémités, pas au milieu. Un téléchargement tronqué perd le trailer : startxref ou %%EOF manque et le lecteur n'a pas de point d'entrée ; les lecteurs tolérants retombent alors sur un balayage complet du fichier pour reconstruire le xref — exactement le chemin lent que la table devait éviter. Un transfert en mode texte raté corrompt les octets de flux ou les décalages cessent de correspondre à la réalité, et les objets se chargent depuis la mauvaise position. Quand les décalages de la table ne pointent plus vers de vrais mots-clés obj, le fichier est structurellement cassé même si chaque objet est individuellement correct
Pour le nouveau code, la leçon à tirer de la mise en page est de laisser la bibliothèque gérant l'enregistrement des octets. Les décalages dans la table des références croisées doivent être précis au niveau de l'octet, alignés avec l'emplacement réel de chaque objet, le trailer doit pointer vers la bonne table et les mises à jour incrémentielles doivent être correctement liées via /Prev. Des composants natifs comme le HotPDF Delphi Component pour Delphi et C++Builder gèrent tous ces aspects lors de l'écriture du fichier, y compris le choix entre l'ajout de révisions incrémentielles et la réécriture dans une version compacte. Si vous souhaitez comprendre comment construire la même structure à partir de zéro plutôt que de l'analyser, l'article complémentaire sur la construction d'un document PDF à partir de zéro détaille le processus d'écriture séquentielle de l'en-tête, des objets, de la table xref et du trailer