Ouvrez un PDF de 200 pages depuis un lien et le navigateur reste souvent blanc tant que la plus grande partie du fichier n'est pas arrivée. Fast Web View est le nom qu'Adobe Acrobat donne à un PDF linéarisé (annexe F de l'ISO 32000-1) : la page une et un petit index sont placés au début, si bien qu'un visionneur peint la page une tôt et récupère les pages suivantes par requête HTTP Range. HotPDF et PDFium Component savent tous deux écrire des fichiers linéarisés depuis Delphi
Rien de tout cela n'est un format de fichier distinct. Un PDF linéarisé est un PDF ordinaire que n'importe quel lecteur conforme ouvre sans traitement particulier ; la différence tient à l'ordre de ses octets et à deux structures supplémentaires, le dictionnaire de paramètres de linéarisation et le flux de hints. Deux conditions décident si un lecteur ressent un jour le bénéfice. Il faut que le fichier soit linéarisé et le reste — ce qu'une modification ajoutée défait discrètement — et que le serveur web réponde aux requêtes de plages d'octets avec 206 Partial Content. Sur un disque local, où atteindre la fin d'un fichier ne coûte rien, un PDF linéarisé se comporte exactement comme n'importe quel autre, si bien que Fast Web View est purement une optimisation réseau qui paie pour les grands documents ouverts directement depuis une URL
Que réorganise un PDF linéarisé ?
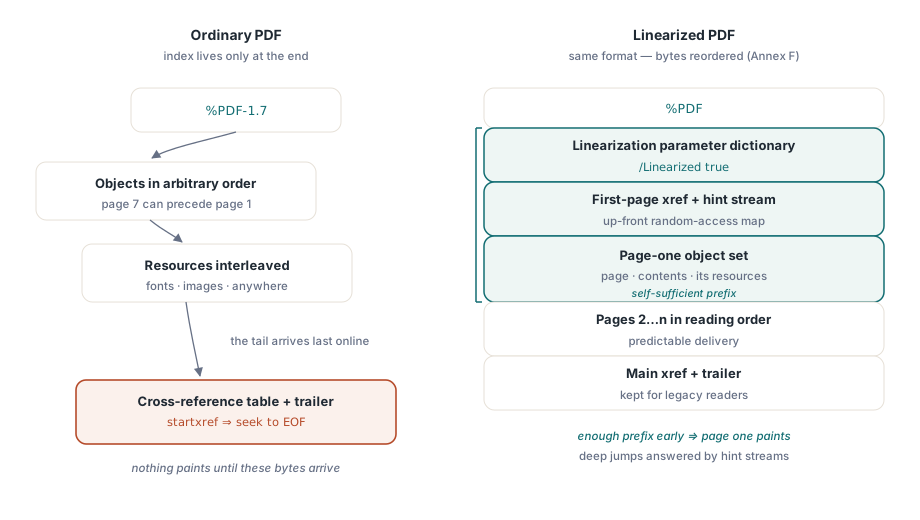
Un PDF linéarisé rassemble tout ce dont la page une a besoin dans un bloc contigu près du début du fichier, devant toutes les autres pages. Dans un PDF ordinaire, les objets peuvent se trouver dans n'importe quel ordre, car la table de références croisées à la fin mappe chaque numéro d'objet à son décalage en octets : un lecteur se place à la queue, lit le pointeur startxref, charge la table et peut ensuite tout trouver (la présentation de la structure d'un fichier PDF détaille cet agencement en-tête, corps, xref et trailer). La conception est excellente sur disque et mauvaise sur un réseau, où la queue est précisément la partie qui arrive en dernier. Pour dessiner la page une, un lecteur conventionnel a besoin de l'objet page, de son flux de contenu et des polices et images qu'elle utilise, et dans un fichier en désordre n'importe lequel de ces éléments peut se trouver dans le dernier mégaoctet
La linéarisation impose l'ordre. Après l'en-tête viennent le dictionnaire de linéarisation et une petite section de références croisées de première page, puis les objets au niveau du document tels que le catalog, le flux de hints primaire, et la première page avec toutes ses ressources. Les pages restantes suivent une à une, puis les objets partagés entre les pages suivantes, et enfin la table de références croisées principale. Un lecteur qui ignore l'optimisation démarre toujours par la fin et trouve chaque objet via la table principale, c'est pourquoi un fichier linéarisé reste pleinement compatible avec les logiciels plus anciens. La numérotation des objets paraît donc à l'envers dans un éditeur hexadécimal : le bloc de tête porte les numéros les plus élevés, tandis que tout ce qui le suit est numéroté à partir de 1
Le dictionnaire de linéarisation et les tables de hints
Le premier objet après l'en-tête %PDF est le dictionnaire de paramètres de linéarisation, et l'annexe F exige qu'il tienne dans les 1 024 premiers octets pour qu'un lecteur en flux le trouve dans le paquet d'ouverture. La table F.1 liste ses entrées : /L est la longueur du fichier entier en octets, /H le décalage et la longueur du flux de hints primaire, /O le numéro d'objet de la première page, /E le décalage où la première page se termine, /N le nombre de pages, et /T le décalage de la première entrée de la table de références croisées principale. L'entrée /L pèse plus qu'elle n'y paraît. Quand elle contredit la taille réelle du fichier, la table F.1 dit au lecteur de traiter le document comme un PDF ordinaire et d'ignorer tous les hints qu'il contient
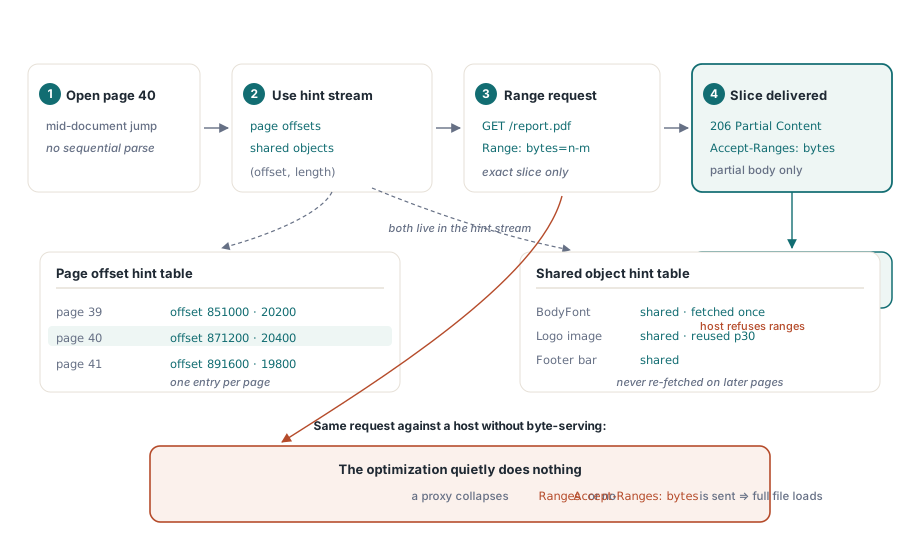
Le flux de hints est ce qui rend bon marché un saut à la page 40. Il contient une table de hints de décalages de pages, qui enregistre pour chaque page où ses objets commencent et combien d'octets ils couvrent, et une table de hints d'objets partagés qui fait la même chose pour les polices, logos et autres ressources utilisées sur plusieurs pages. Un lecteur qui veut la page 40 consulte sa plage d'octets, demande exactement cette tranche et rend dès qu'elle arrive, en récupérant de la même façon tout objet partagé qu'il ne détient pas déjà. Deux détails font trébucher les linéariseurs maison. Les décalages de hints sont logiques, calculés comme si le flux de hints lui-même était absent, si bien qu'un écrivain qui stocke des décalages physiques décale de la taille de l'objet de hints chaque requête de plage ultérieure. Et un écrivain qui suit le lien /Parent d'une page tout en collectant ses ressources redescend à travers l'arbre des pages et entraîne tout le document dans la section de première page. Les deux fichiers se prétendent toujours linéarisés. Aucun ne charge plus vite
Pourquoi le Fast Web View a-t-il besoin de la coopération du serveur ?
Le Fast Web View ne fonctionne que si le serveur délivre des tranches arbitraires du fichier à la demande. Le lecteur envoie des requêtes HTTP avec un en-tête Range et attend 206 Partial Content en retour ; si le serveur n'annonce jamais Accept-Ranges: bytes, ou si un proxy ou un CDN devant lui fusionne les requêtes de plage en transferts complets, le lecteur ne peut pas récupérer la page 40 tout seul et télécharge le fichier entier à la place. La structure à l'intérieur du PDF est alors correcte et entièrement gaspillée, et c'est la défaillance la plus souvent diagnostiquée à tort comme une linéarisation cassée. Avant de reconstruire un document, demandez le premier kilooctet de l'URL exacte qu'ouvre le visionneur, par exemple avec curl -r 0-1023, et confirmez que le statut est 206. Les hébergeurs de fichiers statiques s'en sortent d'ordinaire par défaut, tandis que les points de terminaison d'application qui diffusent des PDF via leur propre gestionnaire s'en sortent souvent mal
Comment vérifier qu'un PDF possède le Fast Web View ?
Vérifiez les octets plutôt que de faire confiance à l'outil qui a produit le fichier, et vérifiez les deux moitiés de la condition : le fichier se déclare linéarisé, et cette déclaration correspond toujours au fichier sur disque. Trois vérifications couvrent presque tous les cas, du coup d'œil sur un poste de travail au verrou automatisé dans un pipeline de publication :
- Adobe Acrobat ou Reader : ouvrez File > Properties ; l'onglet Description affiche
Fast Web View: YesouNodans son coin inférieur droit. Acrobat n'annonce Yes que si la structure est présente et à jour, si bien qu'un fichier modifié après linéarisation affiche No - qpdf en ligne de commande :
qpdf --check-linearizationvalide les tables de hints contre les positions réelles des objets, etqpdf --show-linearizationdécharge le dictionnaire et chaque entrée des tables de hints - Le premier kilooctet du fichier : ouvrez-le dans un éditeur de texte ou hexadécimal et cherchez un objet contenant
/Linearized 1dans les 1 024 premiers octets ; quand il y est, comparez sa valeur/Là la taille de fichier rapportée par le système d'exploitation
# Valide le dictionnaire de linéarisation et les tables de hints contre l'agencement réel
qpdf --check-linearization report-web.pdf

# Décharge /L, /H, /O, /E, /N, /T et chaque entrée des tables de hints
qpdf --show-linearization report-web.pdf
La vérification qpdf est celle qui vaut d'être câblée dans un pipeline, car elle réconcilie les tables de hints avec les positions réelles des objets ; une vérification qui se contente de confirmer l'existence du dictionnaire bénira un fichier dont les décalages pointent vers les mauvais octets. Depuis Delphi, THotPDF.IsLoadedLinearized dans HotPDF rapporte si un document chargé se déclare linéarisé, en scannant les 1 024 premiers octets à la recherche de /Linearized avant toute analyse. PDFium Component répond à la même question via la fonction de classe TPdf.InspectAvailability, dont le champ Linearization renvoie plnLinearized, plnNotLinearized ou plnUnknown sans même charger le document. Les deux drapeaux rapportent ce que le fichier déclare ; la comparaison /L vous dit si cette déclaration correspond toujours aux octets sur disque :
uses
  System.SysUtils, System.Classes, System.Math, System.StrUtils, PDFium;

type
  TFastWebView = (fwvNo, fwvStale, fwvYes);

// Votre propre utilitaire : PDFium décide si le fichier est linéarisé,
// et la comparaison /L attrape les modifications ajoutées ensuite
function FastWebViewState(const FileName: string): TFastWebView;
var
  Stream: TFileStream;
  Head: AnsiString;
  Text: string;
  P, Q: Integer;
begin
  Result := fwvNo;
  Stream := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    if TPdf.InspectAvailability(Stream).Linearization <> plnLinearized then
      Exit;
    SetLength(Head, Min(Stream.Size, 1024));   // annexe F : 1 024 premiers octets
    Stream.Position := 0;
    if Length(Head) > 0 then
      Stream.ReadBuffer(Head[1], Length(Head));
    Text := string(Head);
    P := Pos('/Linearized', Text);
    if P = 0 then
      Exit;
    P := PosEx('/L ', Text, P + Length('/Linearized'));
    if P = 0 then
      Exit;
    Inc(P, 3);
    Q := P;
    while (Q <= Length(Text)) and CharInSet(Text[Q], ['0'..'9']) do
      Inc(Q);
    if StrToInt64Def(Copy(Text, P, Q - P), -1) = Stream.Size then
      Result := fwvYes
    else
      Result := fwvStale;   // linéarisé une fois, puis modifié
  finally
    Stream.Free;
  end;
end;
Activer le Fast Web View dans Acrobat, qpdf et Delphi
N'importe quel outil qui réécrit le fichier entier dans l'ordre de l'annexe F peut activer le Fast Web View, et l'essentiel est qu'il s'exécute en dernier. Dans Acrobat, activez Save As optimizes for Fast Web View sous Preferences > Documents puis utilisez File > Save As plutôt que Save, car un simple Save peut ajouter une mise à jour incrémentale. Sur un serveur ou dans un script de build, qpdf --linearize in.pdf out.pdf réécrit n'importe quel PDF sous forme linéarisée et laisse le fichier d'entrée intact. Le code Delphi a deux routes, selon que vous générez le document ou le recevez. HotPDF écrit une sortie linéarisée directement quand THotPDF.LinearizeOutput est à True ; posez-le avec les autres options de sortie avant BeginDoc, et l'agencement de l'annexe F est calculé et écrit à l'intérieur de EndDoc :
qpdf --linearize report-final.pdf report-web.pdfvar
PDF: THotPDF;
begin
PDF := THotPDF.Create(nil);
try
PDF.AutoLaunch := False; // n'ouvre pas un visionneur après EndDoc
PDF.FileName := 'catalog-web.pdf';
PDF.LinearizeOutput := True; // à poser avant BeginDoc
PDF.BeginDoc; // la page 1 existe après BeginDoc
PDF.CurrentPage.TextOut(72, 72, 0, 'Spring catalog');
PDF.AddPage;
PDF.CurrentPage.TextOut(72, 72, 0, 'Price list');
PDF.EndDoc; // l'agencement linéarisé est écrit ici
finally
PDF.Free;
end;
end;Pour les fichiers qui existent déjà, PDFium Component fournit TPdf.SaveAsLinearized. La méthode exécute la sauvegarde PDFium ordinaire vers un magasin intermédiaire, si bien que les modifications de pages et les valeurs de formulaires passent par le même chemin que toute autre sauvegarde, puis restructure cette sortie selon l'annexe F avant d'écrire votre cible. La méthode prend les mêmes paramètres TSaveOption et TPdfVersion que SaveAs, refuse saIncremental et toute version antérieure à PDF 1.2, et sa surcharge par nom de fichier écrit vers un fichier temporaire qui ne remplace la cible qu'après le succès de la sauvegarde. Comme l'écrivain reconstruit le fichier depuis la révision courante, c'est aussi la façon de rendre le Fast Web View à un fichier qui a accumulé des modifications ajoutées. Une entrée chiffrée exige saRemoveSecurity : la renumérotation des objets invalide les clés par objet du gestionnaire de sécurité standard (ISO 32000-1 §7.6.2), si bien que la copie web est écrite sans chiffrement
var
  Pdf: TPdf;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'manual-rev3.pdf';   // porte des modifications ajoutées
    Pdf.Active := True;
    if not Pdf.SaveAsLinearized('manual-web.pdf', saNoIncremental) then
      raise Exception.Create('Linearized save failed');
  finally
    Pdf.Free;
  end;
end;
Les mises à jour incrémentales désactivent discrètement le Fast Web View
Une mise à jour incrémentale est la raison la plus courante pour laquelle un fichier correctement linéarisé perd son Fast Web View plus tard. Quand un outil ajoute une signature, remplit un champ de formulaire ou attache une note par une sauvegarde incrémentale, il laisse les octets d'origine intacts et ajoute à la fin les objets modifiés, une nouvelle section de références croisées et un nouveau trailer. Le dictionnaire de linéarisation au début décrit toujours l'ancien agencement, son /L ne correspond plus à la taille du fichier, et un lecteur conforme en revient à traiter le document comme un PDF ordinaire, même si la structure linéarisée reste intacte dans la première partie du fichier. HotPDF ajoute exactement ce genre de révision via BeginIncrementalUpdate et SaveIncrementalUpdate, ce qui est le bon outil tant que le document change encore et la mauvaise dernière étape pour un fichier destiné à un serveur web :
// Ajoute une révision : rapide, garde les octets antérieurs intacts,
// et laisse le résultat sans Fast Web View
PDF.BeginIncrementalUpdate('report.pdf');
PDF.AddPage;
PDF.CurrentPage.TextOut(72, 760, 0, 'Addendum');
PDF.SaveIncrementalUpdate('report-rev2.pdf');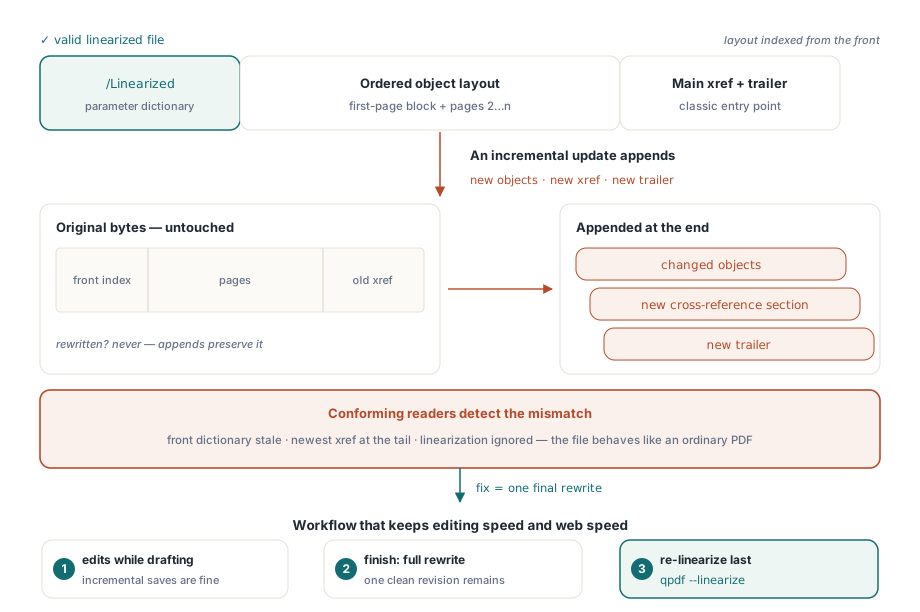
La règle qui fonctionne est de modifier par mise à jour incrémentale tant que le document est en mouvement, de linéariser une seule fois en toute dernière étape, et de laisser le Fast Web View de côté pour les fichiers envoyés par courriel ou téléchargés avant que quiconque ne les ouvre, puisqu'ils ne tirent rien de l'index plus grand chargé en tête. Les documents signés imposent un vrai choix : une réécriture complète change les octets que le /ByteRange de chaque signature couvre, et signer ensuite ajoute une mise à jour qui ramène aussitôt la divergence de /L, donc pour les contrats gardez la signature et acceptez les téléchargements complets. Le côté écriture de l'annexe F, y compris la façon dont les décalages convergent avant l'écriture du premier octet et pourquoi la sortie linéarisée renonce aux object streams, est couvert dans l'écriture de PDF linéarisés avec les tables de hints de HotPDF et la linéarisation Fast Web View avec PDFium Component en Delphi. LinearizeOutput et IsLoadedLinearized sont livrés avec le HotPDF Delphi Component, tandis que SaveAsLinearized et InspectAvailability font partie de PDFium Component pour Delphi, C++Builder et Lazarus