Un classeur ODS avec un tableau croisé passe dans une bibliothèque, une seule cellule source est modifiée, et le fichier sauvegardé s’ouvre avec toutes les valeurs de cellules intactes et le pivot disparu : content.xml contenait un <table:data-pilot-table> à l’entrée et en contient zéro à la sortie. La réparation évidente est de copier le XML du pivot sous forme de chaîne. Cela restaure le compte d’éléments, et ensuite un analyseur sensible aux espaces de noms refuse la partie sauvegardée avec une erreur de préfixe non lié. Les deux échecs ont une seule racine. Un morceau de XML ne voyage en sécurité que si les déclarations d’espaces de noms dont il dépend voyagent avec lui
Où vit une définition de pivot ODS dans content.xml
Un tableau croisé OpenDocument, que le format appelle un data pilot, est une définition stockée après les feuilles dans content.xml, et un écrivain qui reconstruit cette partie depuis son propre modèle d’objets ne la conserve que si le modèle a un endroit où la mettre. ODF 1.3 Partie 3 §9.6 décrit le conteneur : <table:data-pilot-tables> contient un <table:data-pilot-table> par pivot, chacun avec son table:source-cell-range, un ensemble d’enfants table:data-pilot-field, un table:target-range-address et une liste table:buttons. Les cellules de résultat que le pivot affiche siègent dans la feuille comme des cellules ordinaires. Un écrivain qui ne régénère que les cellules, les styles, les validations, les noms définis et les plages de base de données produit donc une feuille parfaitement valide avec les mêmes chiffres à l’écran et aucun pivot derrière
Le HotXLS Delphi Excel Component lit tout le sous-arbre <table:data-pilot-tables> de content.xml pendant OpenODS, avant d’analyser la moindre cellule, puis tente de traduire la collection vers son modèle de pivot. Une définition dans la forme simple que le modèle représente — plage source locale, champ de ligne, mesures d’agrégation et résultats stockés cohérents avec les données source — devient un TXLSPivotTable dans la liste PivotTables de la feuille, le même objet que pour un pivot XLSX et que vous pouvez étendre avec des champs calculés et rafraîchir depuis Delphi. Tout ce qui sort de cette forme conserve la collection comme XML capturé, et SaveAsODS la réécrit. Un attribut dans un espace de noms que le traducteur ne connaît suffit : des pivots sauvegardés par LibreOffice peuvent porter des attributs loext: et calcext:, et un attribut loext: envoie la définition sur le chemin capturé
Le repli est tout ou rien par classeur. Si un pivot sur trois d’une collection sort de la forme traduisible, les trois restent en XML capturé. Les séparer laisserait content.xml avec deux sources de vérité pour un même conteneur, une moitié reconstruite depuis des objets et l’autre rejouée depuis du texte, et tout désaccord entre les deux moitiés atterrirait dans le fichier de l’utilisateur. Garder la collection entière est le défaut le plus sûr, et c’est la même politique que HotXLS applique aux blocs extLst inconnus des XLSX : ce que le modèle ne peut pas porter est conservé tel qu’écrit
Pourquoi une définition de pivot découpée casse-t-elle le fichier sauvegardé ?
Une définition de pivot découpée dans content.xml par une recherche de chaîne perd les déclarations d’espaces de noms qui donnent un sens à ses préfixes, et Namespaces in XML traite un préfixe sans déclaration comme une erreur de bonne formation. L’approche par chaîne est courte : décoder la partie en WideString, trouver <table:data-pilot-tables avec Pos, trouver la balise fermante correspondante après, et copier tout l’intervalle. Le texte qui en sort a l’air complet. Il contient loext:ignore-selected-page="true" sur un champ de page et calcext:repeat-item-labels="false" sur chaque niveau, mais les déclarations xmlns:loext et xmlns:calcext qui lient ces préfixes siègent sur la racine du document, <office:document-content>, des milliers de caractères plus tôt
Namespaces in XML 1.0 §6.1 maintient une déclaration en portée de la balise ouvrante qui la porte jusqu’à la balise fermante correspondante, et tout nom préfixé à l’intérieur s’y résout. Découpez un sous-arbre du document et vous le découpez de cette portée. Quand le fragment est collé dans un nouveau document, chaque préfixe ne se résout que si la nouvelle racine le déclare par hasard. HotXLS écrit son propre <office:document-content> avec les espaces de noms que son écrivain utilise, dont office, table, text, style, fo, draw, calcext, tableooo et of. Dans la copie découpée, table: se résout, calcext: se résout, et loext: non. Un seul préfixe non lié suffit pour qu’un analyseur sensible aux espaces de noms rejette toute la partie, donc le pivot ne se dégrade pas avec grâce ; les données de feuille autour deviennent illisibles aussi
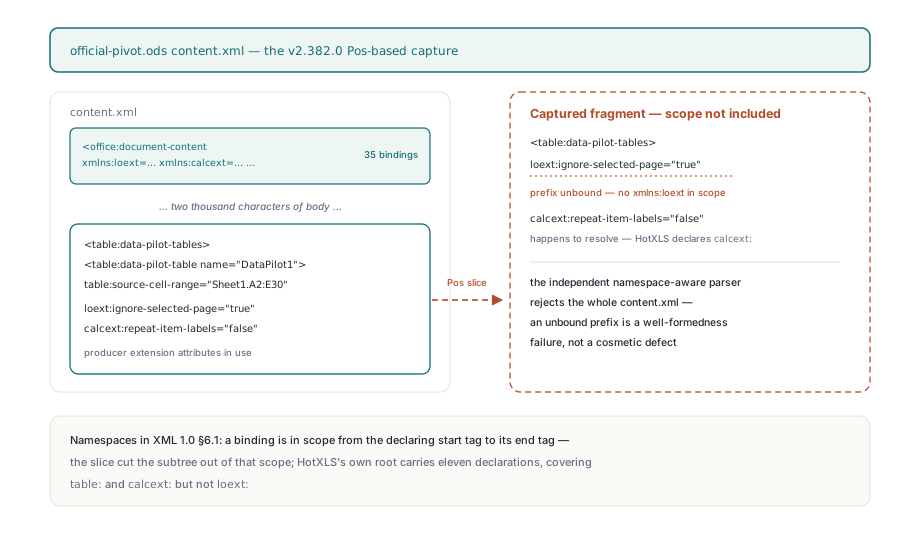
La recherche de chaîne a d’autres angles morts qu’une capture par lecteur ne rencontre jamais. Pos trouve le texte de la balise dans un commentaire, dans une section CDATA, ou dans une valeur d’attribut qui la cite. Il ne sait pas distinguer des éléments imbriqués de même nom. Et il cherche le préfixe littéral table:, alors qu’ODF autorise un producteur à lier l’espace de noms table au préfixe de son choix
Comment HotXLS reporte la portée des espaces de noms sur le fragment
HotXLS capture le sous-arbre du pivot avec un lecteur XML en flux qui suit chaque déclaration d’espace de noms avec la profondeur où elle est apparue, et recopie les déclarations encore en vigueur sur la balise ouvrante du fragment au moment où l’élément cible arrive. La pile grossit à chaque balise ouvrante qui déclare xmlns ou xmlns:prefix et rétrécit quand l’élément qui déclarait une liaison se referme. Les éléments vides demandent le même traitement : <x xmlns:p="..."/> ne produit jamais d’événement de balise fermante séparé, donc le dépilage doit se déclencher sur la balise ouvrante vide aussi, sinon une liaison fuit vers ses voisins
À la cible, la capture parcourt la pile de la liaison la plus interne vers l’extérieur et écrit chaque préfixe une fois. Parcourir de l’intérieur vers l’extérieur, c’est ce qui implémente le masquage. Si <office:spreadsheet> relie à nouveau un préfixe déjà déclaré par la racine, la valeur la plus proche est celle en vigueur au pivot, exactement comme l’exige le §6.1, et un ensemble de préfixes déjà écrits empêche la valeur externe de suivre. Un préfixe que l’élément pivot déclare lui-même est sauté, car écrire xmlns:table deux fois sur une même balise est une autre erreur de bonne formation
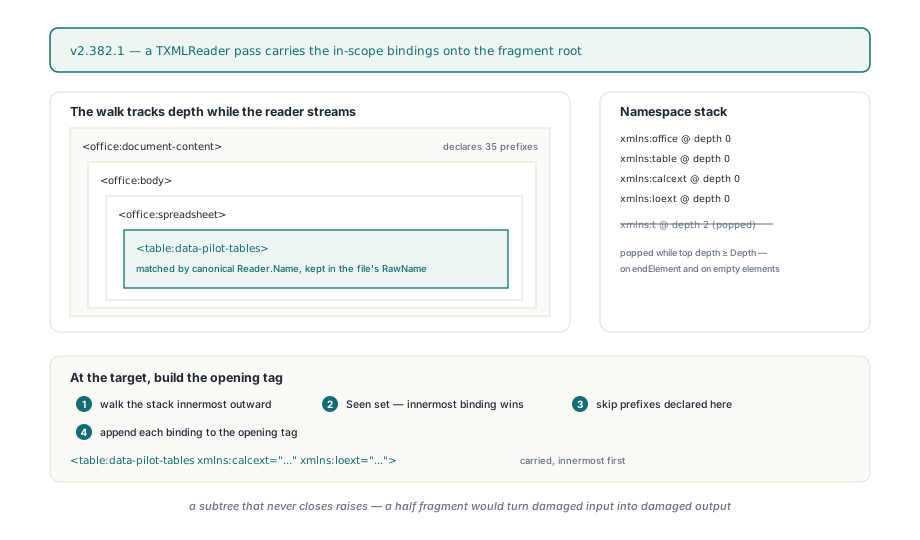
La cible est repérée par espace de noms, donc un producteur qui écrit <t:data-pilot-tables> avec t lié à l’URI de table ODF est quand même reconnu, tandis que les balises capturées gardent l’orthographe du fichier. Les nœuds texte d’espacement reviennent exactement tels qu’écrits. Le guillemetage des attributs et le choix entre <x/> et <x></x> sont normalisés, puisque le fragment est resérialisé depuis les événements du lecteur au lieu d’être copié octet pour octet. Si content.xml se termine alors que le sous-arbre du pivot est encore ouvert, comme dans un fichier tronqué, l’ouverture échoue avec une exception au lieu de garder une moitié de définition qui serait réécrite à la sauvegarde suivante
L’ensemble reporté est délibérément généreux. La capture copie chaque liaison en portée, utilisée ou non par le sous-arbre, donc la racine du fragment répète xmlns:table et xmlns:calcext même si la racine du document sauvegardé les déclare aussi. Redéclarer un préfixe dans une portée imbriquée est légal sous Namespaces in XML, et un fichier d’un producteur qui déclare des dizaines d’espaces de noms sur sa racine gagne quelques kilo-octets. Élaguer la liste voudrait dire balayer le sous-arbre à la recherche de chaque préfixe dans les noms d’éléments, les noms d’attributs et les valeurs d’attributs qui portent des QName, et un seul raté ramène immédiatement l’échec de préfixe non lié. Quelques déclarations redondantes coûtent bien moins que ce risque
Ouvrir, modifier et sauvegarder un classeur qui porte un pivot
Du côté appelant, il n’y a rien à activer : la définition de pivot voyage avec un OpenODS et un SaveAsODS ordinaires. Les feuilles sont numérotées à partir de 1, et les deux méthodes renvoient 1 en cas de succès :
uses
  System.SysUtils, lxHandleX;

procedure EditPivotSource(const InFile, OutFile: string);
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    if Book.OpenODS(InFile) <> 1 then
      raise Exception.CreateFmt('Cannot open %s', [InFile]);
    // E2 se trouve dans une plage source de pivot de Sheet1.A2:E30
    Book.Sheets[1].Cells[2, 5].Value := 1250.0;
    if Book.SaveAsODS(OutFile) <> 1 then
      raise Exception.CreateFmt('Cannot save %s', [OutFile]);
  finally
    Book.Free;
  end;
end;
Dans le content.xml sauvegardé, la collection de pivots siège dans <office:spreadsheet> juste après le <table:named-expressions> que l’écrivain génère et avant <table:database-ranges>. Un classeur qui porte à la fois un AutoFilter, que HotXLS écrit comme une plage de base de données, et un pivot place les deux éléments côte à côte, et si votre chaîne fait tourner un validateur de schéma ODF strict, cette paire est le premier endroit où regarder
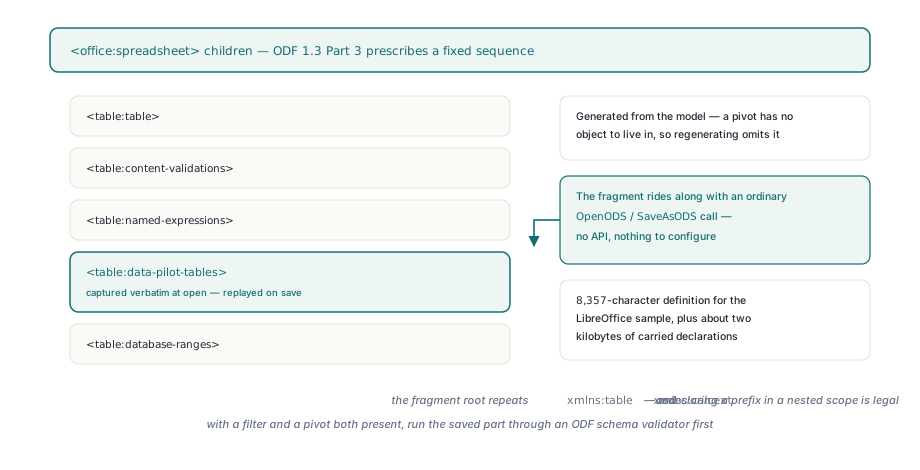
La modification de l’exemple change une valeur source et laisse les cellules de résultat du pivot telles quelles. Une définition capturée est rejouée telle qu’écrite : HotXLS ne la recalcule pas, et l’application tableur qui ouvre le fichier recalcule le pivot à son prochain rafraîchissement. Il en va de même pour ses adresses. Renommez Sheet1 ou déplacez le bloc source, et la définition sauvegardée pointe toujours vers Sheet1.A2:E30, ce que l’application consommatrice signale comme une plage cassée au rafraîchissement. Gardez les noms de feuilles et le bloc source stables dans tout classeur dont les pivots voyagent ainsi
Quel chemin un pivot donné a-t-il suivi ?
La vérification la plus rapide est la liste PivotTables de la feuille : une définition traduite y apparaît comme un TXLSPivotTable, et une capturée non. Le rapport de conversion répond à la seconde moitié de la question, ce qui adviendrait du pivot dans un autre format de sortie. GetConversionReport inspecte le classeur sans le sauvegarder ni le recalculer, et l’appelant est propriétaire du rapport renvoyé :
uses
  System.SysUtils, lxHandleX, lxDiagnostics;

function DescribeOdsPivots(Book: TXLSXWorkbook): string;
var
  I, Modeled: Integer;
  Report: TXLSConversionReport;
begin
  Modeled := 0;
  for I := 1 to Book.Sheets.Count do          // Sheets est en base 1
    Inc(Modeled, Book.Sheets[I].PivotTables.Count);

  Report := Book.GetConversionReport(xlsConversionOpenXmlWorkbook);
  try
    for I := 0 to Report.Count - 1 do
      if (Report[I].Feature = 'OpenDocumentPivotTables') and
         (Report[I].Fidelity = xlsConversionDropped) then
        Exit('Captured ODF pivot XML: keep this workbook on .ods');
  finally
    Report.Free;
  end;

  if Modeled > 0 then
    Result := Format('%d pivot table(s) in the pivot model', [Modeled])
  else
    Result := 'No pivot definitions';
end;
Le chemin de sortie compte parce que le XML capturé est du vocabulaire ODF et que seul l’écrivain ODS l’émet. Sauvegardé en .xlsx, la collection capturée n’a pas d’équivalent SpreadsheetML, et le rapport la liste sous OpenDocumentPivotTables avec xlsConversionDropped. L’écrivain binaire .xlsb refuse un classeur qui la porte encore. Un pivot traduit est un objet modèle ordinaire et suit les règles du format cible à la place. Les différences entre les chemins d’import et d’export ODS s’appliquent ici comme partout, et pour les fichiers à pivots la route sûre est .ods à l’entrée, .ods à la sortie
Une règle de plus découle du repli tout ou rien. Un classeur rejoue une collection capturée ou écrit ses pivots depuis le modèle ; il ne mélange jamais les deux dans un même content.xml. Ajouter un pivot avec AddPivotTable à un classeur qui porte déjà du XML de pivot capturé fait échouer la sauvegarde ODS avec une erreur au lieu d’accoler du XML généré au XML rejoué
Vérifier la partie sauvegardée avec un second analyseur
Un compte d’éléments ne prouve rien sur les espaces de noms. Une expression régulière qui cherche des balises ouvrantes data-pilot-table dans le content.xml sauvegardé voit du texte, et la copie découpée de la seconde section passe ce test. Un analyseur sensible aux espaces de noms qui n’a rien à voir avec la bibliothèque qui a écrit le fichier est un juge bien plus strict, et Delphi en embarque déjà un. La fonction ci-dessous est une vérification à ajouter à votre propre suite de tests ; TZipFile et TXMLDocument viennent de la RTL Delphi, pas de HotXLS :
uses
  System.SysUtils, System.Classes, System.Zip,
  Xml.xmldom, Xml.XMLIntf, Xml.XMLDoc;

// Votre propre aide de test : True quand le content.xml d’un paquet .ods
// se charge dans un analyseur DOM sensible aux espaces de noms
function OdsContentParses(const OdsFile: string; out Error: string): Boolean;
var
  Zip: TZipFile;
  Bytes: TBytes;
  Stream: TBytesStream;
  Doc: IXMLDocument;
begin
  Error := '';
  Zip := TZipFile.Create;
  try
    Zip.Open(OdsFile, zmRead);
    Zip.Read('content.xml', Bytes);
  finally
    Zip.Free;
  end;
  Stream := TBytesStream.Create(Bytes);
  try
    Doc := TXMLDocument.Create(nil);
    try
      Doc.LoadFromStream(Stream);     // un préfixe non lié échoue ici
      Result := True;
    except
      on E: EDOMParseError do
      begin
        Error := E.Message;
        Result := False;
      end;
    end;
  finally
    Stream.Free;
  end;
end;
Exécutez-la sur chaque .ods que votre code sauvegarde, puis allez un pas plus loin pour les fichiers à pivots et comparez le sous-arbre du pivot de l’entrée et de la sortie après analyse : balise, attributs triés, texte et enfants, récursivement, avec les noms étendus en URI d’espace de noms plus nom local. Cette comparaison laisse passer un préfixe réécrit et attrape un préfixe non lié, ce qui est exactement la frontière entre inoffensif et cassé. Nourrissez-la avec des fichiers de chaque producteur que vos utilisateurs font réellement tourner. Un document qui lie l’espace de noms table à un préfixe différent, qui déclare un préfixe sur l’élément pivot lui-même, ou qui en relie un autre dans <office:spreadsheet> exerce les règles de saut et de masquage d’une façon qu’un seul fichier LibreOffice n’exerce pas
Le lecteur et l’écrivain ODS, le modèle de pivot pour XLSX comme pour ODS, et le rapport de conversion utilisé plus haut font tous partie du HotXLS Delphi Excel Component ; sa page produit couvre la prise en charge complète de lecture-écriture XLSX, XLS et ODS pour Delphi et C++Builder