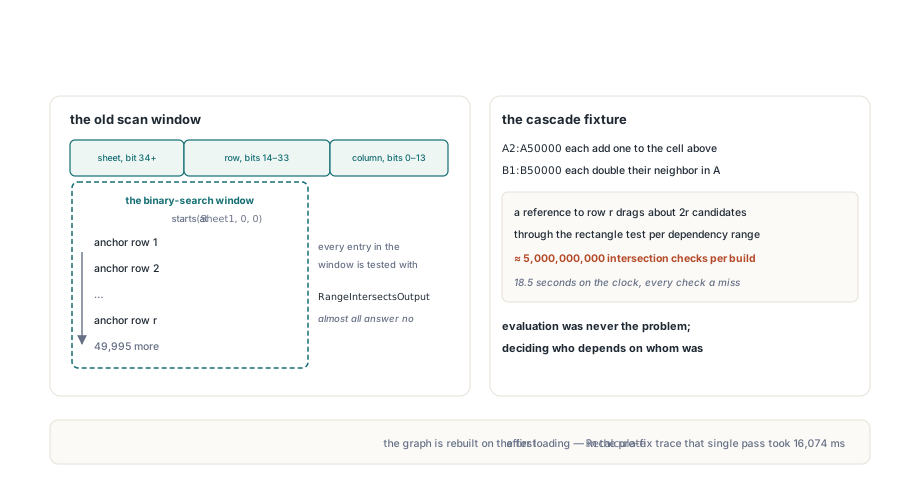
Une feuille avec 50 000 formules en colonne A, chacune ajoutant un à la cellule du dessus, et 50 000 autres en colonne B doublant leur voisine, c'est à peu près le modèle de tableur le plus simple qui soit. L'évaluer coûte 100 000 additions et multiplications. Déterminer l'ordre d'évaluation coûte bien plus si le constructeur d'arêtes est écrit de la façon évidente : chercher chaque formule depuis le haut de la feuille référencée jusqu'à la rangée référencée, tester chacune pour un chevauchement, et garder les touches. Pour cette seule feuille, cela fait à peu près cinq milliards de tests de rectangles, et presque tous répondent non
Les cinq milliards sont de l'arithmétique, pas une lecture de chronomètre. Une référence à la rangée r traîne environ 2r candidats dans la fenêtre de recherche, un par colonne pour chaque rangée au-dessus, et sommer cela sur 100 000 références atterrit dans les milliards. La partie intéressante, c'est que la fenêtre doit vraiment commencer en haut de la feuille, pour une raison qui n'a rien à voir avec de la paresse
Où une reconstruction de dépendances passe son temps
Le moteur de recalcul de HotXLS reconstruit son graphe de dépendances de formules chaque fois que la topologie des formules change : le premier Recalculate après le chargement ou la génération d'un classeur, et le premier après que des formules sont réécrites, des feuilles ajoutées ou retirées, ou un bloc de cellules cloné. Les deux classes de classeur, TXLSWorkbook et TXLSXWorkbook, construisent pour cela un TXLSDepGraph de l'unité lxDepGraph. Chaque cellule de formule devient un nœud avec une ancre (Row, Col) et un rectangle de sortie qui s'étend jusqu'à (OutRow2, OutCol2). Pour une formule ordinaire, le rectangle est la cellule d'ancrage elle-même
Les nœuds sont ordonnés par une clé 64 bits compactée issue de XLSDepMakeKey : la colonne occupe les bits 0–13, la rangée les bits 14–33, et l'index de feuille à partir du bit 34. Trier par cette clé donne un ordre feuille-majeur, rangée-majeur, donc trouver la dernière formule qui pourrait compter pour une référence est une seule recherche dichotomique sur (Sheet2, Row2, 16383). La première est le problème. La borne inférieure doit être (Sheet1, 0, 0), tout en haut de la feuille référencée, et tout ce qui se trouve entre les deux bornes devient candidat
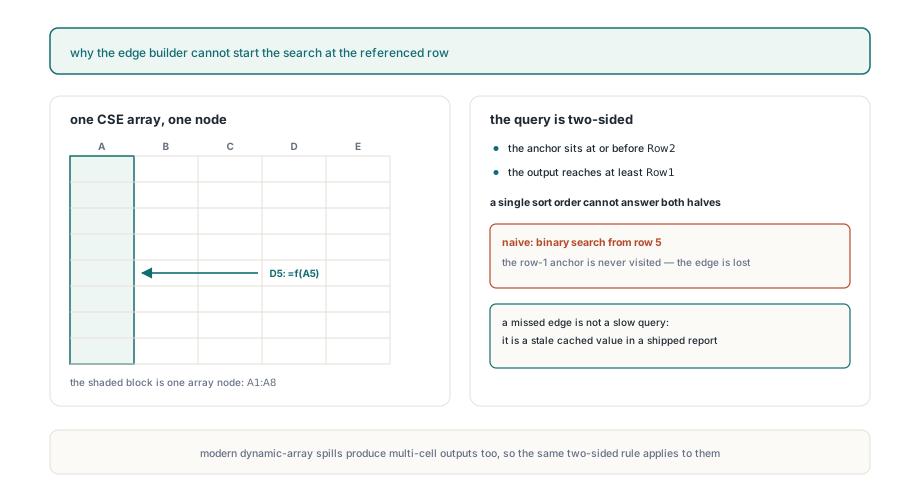
Pourquoi la recherche ne peut-elle pas partir de la rangée référencée ?
Une formule matricielle ancrée au-dessus d'une plage peut posséder des cellules à l'intérieur. Dans un TXLSXWorkbook, une matricielle CSE saisie en A1:A8 est un seul nœud dont l'ancre est A1 et dont la sortie descend jusqu'à la rangée 8, comme le décrit l'article sur le recalcul incrémental et le graphe de dépendances. Une formule en D5 qui ne lit que A5 a quand même besoin d'une arête depuis ce nœud. Démarrez la recherche dichotomique à la rangée 5 et l'ancre en rangée 1 n'est jamais visitée, l'arête n'est jamais enregistrée, et D5 peut être évaluée avant la matrice dont elle dépend. Le symptôme est une valeur en cache périmée dans le classeur sauvegardé, bien plus difficile à remarquer qu'un recalcul lent
La vraie requête a donc deux faces. Un nœud est candidat quand son ancre est au plus à Row2 et que sa sortie atteint au moins Row1, sur une feuille comprise dans la référence et avec des colonnes qui se chevauchent. Un tri par ancre répond à la première moitié. Rien dans l'ordre des ancres ne dit quoi que ce soit sur la seconde moitié, parce qu'une formule en rangée 3 peut produire une cellule ou mille rangées. Les tables de données d'analyse de scénarios ont la même forme : TXLSXWorkbook enregistre chaque table de données comme un nœud couvrant toute sa zone de résultat. Les formules à tableau dynamique prennent une autre route et sont marquées volatiles, donc recalculées à chaque passe ; l'article sur les formules à débordement de tableau dynamique couvre le comportement des plages débordées
TXLSDepGraph est une classe publique, donc le cas se reproduit facilement sans classeur. Les index de feuilles sont en base 1 et les rangées et colonnes en base 0, comme les coordonnées du calculateur. La sonde ci-dessous enregistre la racine matricielle et le lecteur, construit les arêtes, et fait aussi passer une chaîne inversée de références ponctuelles dans le même type de graphe pour montrer le compteur sur lequel s'appuient les sections suivantes
uses
  System.SysUtils, lxDepGraph;

function PointRef(ASheet, ARow, ACol: Integer): TXLSDepRange;
begin
  Result.Sheet1 := ASheet;
  Result.Sheet2 := ASheet;
  Result.Row1 := ARow;
  Result.Row2 := ARow;
  Result.Col1 := ACol;
  Result.Col2 := ACol;
  Result.LookupScan := False;
end;

procedure ProbeOutputIndex;
const
  N = 100000;
var
  G: TXLSDepGraph;
  Deps: TXLSDepRangeList;
  Reader, Row: Integer;
begin
  Deps := TXLSDepRangeList.Create;
  G := TXLSDepGraph.Create;
  try
    // Matricielle CSE : ancre A1 (rangée 0, col 0), sortie jusqu'à A8 (rangée 7)
    G.AddNode(1, 0, 0, 7, 0, False, nil);
    // D5 (rangée 4, col 3) ne lit que A5
    Deps.Add(PointRef(1, 4, 0));
    Reader := G.AddNode(1, 4, 3, 4, 3, False, Deps);
    G.BuildEdges;
    Writeln('D5 precedents: ', G.Nodes[Reader].PrecedentCount);  // 1, la racine A1
    Writeln('rectangles tested: ', G.EdgeCandidateChecks);       // 2 : la racine A1 et D5 elle-même
  finally
    G.Free;
  end;

  // Chaîne A1..A100000, chaque cellule lisant celle du dessus, ajoutée de bas en haut
  G := TXLSDepGraph.Create;
  try
    for Row := N - 1 downto 0 do
    begin
      Deps.Clear;
      if Row > 0 then
        Deps.Add(PointRef(1, Row - 1, 0));
      G.AddNode(1, Row, 0, Row, 0, False, Deps);
    end;
    G.BuildEdges;
    Writeln('chain checks: ', G.EdgeCandidateChecks);  // N - 1 = 99999
  finally
    G.Free;
    Deps.Free;
  end;
end;
Élaguer les sous-arbres par leur plus grande rangée de sortie
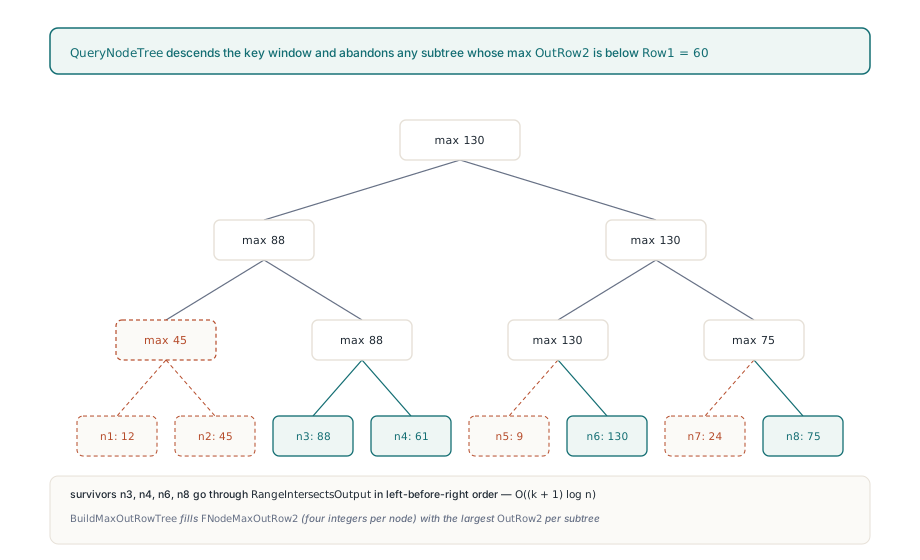
TXLSDepGraph.BuildEdges garde le tri par ancre pour la borne supérieure et répond à la borne inférieure avec un segment tree augmenté du max posé sur l'ordre trié. Chaque entrée de l'arbre stocke le plus grand OutRow2 de tous les nœuds en dessous d'elle. La requête ne descend qu'à l'intérieur de la fenêtre de clés et abandonne tout sous-arbre dont le maximum stocké n'atteint pas Row1, parce qu'aucune formule de ce sous-arbre ne peut atteindre les rangées référencées. Les nœuds qui survivent subissent toujours le test de rectangle complet, donc l'étendue de feuilles et les colonnes sont vérifiées exactement comme avant
La technique est assez petite pour être montrée en entier. L'esquisse ci-dessous est une version minimale écrite pour cet article, avec ses propres noms ; aucun n'est une API HotXLS, et les tableaux sont à remplir par le lecteur à partir d'une liste de rangées de sortie déjà triée par clé d'ancre
uses
  System.Math, System.Generics.Collections;

// Esquisse seulement : un segment tree augmenté du max sur les nœuds triés par clé d'ancre.
// OutRow2[i] est la dernière rangée de sortie du i-ème nœud dans l'ordre trié.
type
  TOutputIndex = record
    OutRow2: TArray<Integer>;
    MaxRow: TArray<Integer>;   // SetLength(MaxRow, 4 * Length(OutRow2))
  end;

procedure BuildMax(var Ix: TOutputIndex; Node, L, R: Integer);
var
  M: Integer;
begin
  if L = R then
  begin
    Ix.MaxRow[Node] := Ix.OutRow2[L];
    Exit;
  end;
  M := (L + R) shr 1;
  BuildMax(Ix, Node * 2, L, M);
  BuildMax(Ix, Node * 2 + 1, M + 1, R);
  Ix.MaxRow[Node] := Max(Ix.MaxRow[Node * 2], Ix.MaxRow[Node * 2 + 1]);
end;

// Collecte, de gauche à droite, chaque nœud de [Lo, Hi) dont la sortie atteint Row1
procedure Query(const Ix: TOutputIndex; Node, L, R, Lo, Hi, Row1: Integer;
  Hits: TList<Integer>);
var
  M: Integer;
begin
  if (R < Lo) or (L >= Hi) or (Ix.MaxRow[Node] < Row1) then
    Exit;                        // hors de la fenêtre, ou rien n'atteint Row1
  if L = R then
  begin
    Hits.Add(L);                 // l'appelant lance toujours le test de rectangle complet
    Exit;
  end;
  M := (L + R) shr 1;
  Query(Ix, Node * 2, L, M, Lo, Hi, Row1, Hits);           // gauche d'abord
  Query(Ix, Node * 2 + 1, M + 1, R, Lo, Hi, Row1, Hits);   // garde l'ordre de balayage
end;

// Construire une fois avec BuildMax(Ix, 1, 0, Count - 1),
// puis par référence appeler Query(Ix, 1, 0, Count - 1, Lo, Hi, Row1, Hits)
Par référence, le travail tombe de la taille de la fenêtre à O((k + 1) log n), où k est le nombre de nœuds dont la sortie atteint réellement les rangées référencées. De retour sur le modèle d'ouverture, une référence de Br vers Ar teste maintenant deux rectangles, Ar et Br elle-même, et une référence de Ar vers la cellule du dessus teste les deux nœuds de cette rangée. À la main, cela fait environ 200 000 tests pour la construction complète au lieu de cinq milliards
Les mêmes arêtes, dans le même ordre
La récursion gauche-avant-droite compte plus qu'il n'y paraît. Les nœuds survivants sont visités exactement dans l'ordre où une simple boucle sur la fenêtre les visiterait, donc les tableaux Dependents et Precedents de chaque nœud se remplissent dans la même séquence, et l'ordre topologique construit à partir d'eux sort identique à chaque exécution. Cet ordre n'est pas qu'une comptabilité interne : quand le graphe est à jour, l'écrivain XLSX émet xl/calcChain.xml dans l'ordre que renvoie FullTopoOrder, donc un ordre de visite non déterministe se traduirait par des diffs bruyants entre deux sauvegardes d'un classeur inchangé
Les sortes d'arêtes gardent aussi leurs règles. Les références situées dans l'argument tableau de recherche de VLOOKUP, MATCH, XLOOKUP et fonctions similaires produisent des arêtes de balayage de recherche, qui propagent l'état sale mais restent hors de la détection de cycles. Quand un nœud a à la fois une référence dure et une référence de recherche vers le même précédent, une arête dure enregistrée en premier supprime l'arête de balayage ultérieure, et une arête de balayage enregistrée en premier garde sa place tandis que l'arête dure est quand même ajoutée. C'est cet ordre qui empêche les plages de recherche de produire de fausses références circulaires, et il ne tient que si le parcours élagué visite les candidats dans l'ordre de balayage
La propriété EdgeCandidateChecks rend l'élagage observable. Elle compte les rectangles de sortie que le dernier appel à BuildEdges a réellement testés et se remet à zéro au début de chaque construction. Dans la sonde ci-dessus, la chaîne inversée rapporte 99 999, un test par référence, alors même que les nœuds ont été ajoutés de bas en haut et que le tri a dû tous les réordonner. AddNode marque le tri et les arêtes comme périmés, donc le prochain BuildEdges ou NodeIndexOf reconstruit l'index plutôt que de le rafistoler
Où se trouve le coût restant
L'arbre n'élague que sur les rangées, et ce choix façonne ce qu'un grand modèle paie encore
- Les ratés de colonnes se paient aux feuilles : les 2 626 formules remplissant
A100:Z200atteignent toutes la rangée 100, donc une référence àAA100:AA200teste chacune d'elles avant de la rejeter sur les colonnes - Les références à colonne entière et autres références larges ont réellement beaucoup de précédents ; l'index supprime les tests inutiles, et la construction des vraies arêtes reste proportionnelle à leur nombre
- Une référence qui couvre plusieurs feuilles ouvre une fenêtre couvrant toute la première feuille, donc les formules qui s'y trouvent avec des sorties profondes atteignent le test des feuilles ; les arêtes sortent identiques et seul l'élagage est plus faible
- L'arbre prend quatre entiers par nœud, environ 1,6 Mo pour 100 000 formules, et tout changement de topologie paie un re-tri complet en O(n log n) plus une construction d'arbre en O(n) à la construction d'arêtes suivante
Les rangées sont la bonne dimension unique à indexer. Les rapports générés, les grands livres et les modèles financiers grandissent vers le bas, donc la distance en rangées est l'origine de presque tous les candidats gaspillés, tandis qu'un raté de colonne est rejeté par le test de rectangle en une poignée de comparaisons d'entiers. Une seconde dimension dans l'arbre compliquerait chaque requête pour économiser des tests déjà bon marché
Côté appelant, l'étape coûteuse est la reconstruction, et les modifications de valeurs ne la déclenchent pas. Recalculate construit le graphe à son premier appel ; les appels suivants ne réévaluent que les formules en aval des valeurs modifiées, plus les volatiles. Écrire toutes les formules d'abord et recalculer une fois est le motif à viser. Le harnais ci-dessous chronomètre les deux sortes de passe sur le moteur classique, où Recalculate renvoie le nombre de cellules de formule qu'il n'a pas pu évaluer ; lancez-le sur le matériel qui hébergera le job par lots, parce que les temps absolus dépendent fortement de la machine
uses
  System.SysUtils, System.Diagnostics, lxHandle;

procedure TimeCascadeRecalc;
var
  Wb: TXLSWorkbook;
  Sh: TXLSWorksheet;
  I, Failed: Integer;
  Watch: TStopwatch;
begin
  Wb := TXLSWorkbook.Create;
  try
    Sh := Wb.Sheets.Add;
    Sh.Cells[1, 1].Value := 1;
    for I := 2 to 50000 do                     // chaîne de 49 999 maillons en colonne A
      Sh.Cells[I, 1].Formula := '=A' + IntToStr(I - 1) + '+1';
    for I := 1 to 50000 do                     // 50 000 dépendants en colonne B
      Sh.Cells[I, 2].Formula := '=A' + IntToStr(I) + '*2';

    Watch := TStopwatch.StartNew;
    Failed := Wb.Recalculate;                  // construit le graphe, évalue tout
    Writeln(Format('first pass: %d not evaluated, %.1f ms',
      [Failed, Watch.Elapsed.TotalMilliseconds]));

    Sh.Cells[1, 1].Value := 10;                // modification de valeur : le graphe est réutilisé
    Watch := TStopwatch.StartNew;
    Failed := Wb.Recalculate;                  // sous-graphe sale seulement
    Writeln(Format('value pass: %d not evaluated, %.1f ms',
      [Failed, Watch.Elapsed.TotalMilliseconds]));
  finally
    Wb.Free;
  end;
end;
Dans ce modèle, la passe de valeur réévalue toujours les 99 999 formules, puisque toute la colonne A pend à A1 ; ce qu'elle saute, c'est la construction du graphe. Écraser une cellule de formule par une valeur simple est une autre affaire, parce que cela change la topologie et que le Recalculate suivant reconstruit le graphe de zéro
La même forme quadratique dans les noms définis clonés
Les bandes de rapport cachent le même motif à un autre endroit. TXLSXWorksheet.CloneRangeTo copie les noms définis qui pointent directement vers une plage à l'intérieur du bloc cloné, et chaque copie a besoin d'un nom unique dans sa portée : Total_2, Total_3, et ainsi de suite. Une recherche qui repart de _2 pour chaque copie sonde un candidat de plus à chaque fois, donc une feuille construite à partir de centaines de bandes clonées dépense un nombre quadratique de recherches de noms rien que pour le nommage
TXLSXDefinedNames évite cela avec un indice de suffixe gardé dans son index de noms, un par nom de base et portée. La recherche suivante repart du suffixe renvoyé la dernière fois et le revérifie d'abord, parce que l'appelant est libre de ne pas ajouter ce nom. Supprimer un nom, le renommer via Name, le déplacer avec SheetIndex ou vider la collection jette l'index avec tous ses indices, donc le clone suivant revient au premier suffixe libre et comble tout trou que le changement a ouvert
Pour les applications Delphi et C++Builder qui génèrent ou recalculent de grandes feuilles de calcul, le composant Excel HotXLS pour Delphi et C++Builder utilise ce graphe de dépendances indexé dans le moteur de recalcul de ses deux classes de classeur, classique et XLSX