La boîte de recherche d'une visionneuse surligne « Acme Corp » en page 2 d'une facture, et pourtant une recherche d'octets dans le flux de page décompressé pour ces neuf mêmes caractères revient vide. Pour le premier mot seul, le flux peut contenir quelque chose comme <0024004600500048> Tj : des codes de glyphes sur deux octets dans une police sous-ensemble embarquée, avec l'écart entre les deux mots produit par un décalage de positionnement plutôt que par un caractère espace. Remplacer ce nom signifie décoder ces codes vers Unicode, faire la correspondance là, revenir aux octets exacts qui ont produit la touche, et écrire de nouveaux codes que la même police comprend. Quand le sous-ensemble n'a jamais contenu un glyphe dont le nouveau texte a besoin, il n'y a aucun code à écrire
Les demandes derrière cela relèvent de la maintenance documentaire ordinaire. Une entreprise se renomme et trois mille factures archivées portent encore l'ancien nom. Un modèle de contrat est parti avec la date d'expiration de l'an dernier. Un numéro de pièce retiré doit devenir son successeur dans chaque fiche technique. Dans un traitement de texte, chacune de ces tâches prend trente secondes ; dans un PDF, chacune se heurte à la façon dont les pages sont réellement stockées
Ce qu'une page PDF stocke à la place du texte
Une page PDF contient des glyphes positionnés, pas du texte éditable. Selon ISO 32000-1 §9.4, le flux de contenu pilote des opérateurs d'affichage de texte comme Tj et TJ, qui peignent des séquences de codes de caractères à des positions fixées par la matrice de texte. Ces codes sont des index dans l'encodage que déclare la police courante. Le chemin de retour vers des caractères lisibles peut passer par une CMap /ToUnicode (§9.10.3), un /Encoding avec un tableau /Differences, ou une chaîne de correspondance CID pour les polices Type0. Il n'y a pas d'objet paragraphe ni de flux de texte, et rien n'oblige un producteur à stocker un mot visible comme une seule chaîne : [(Ac) -12 (me)] TJ est une façon parfaitement ordinaire de créner un mot
Le remplacement ajoute une seconde exigence par-dessus le décodage. Un extracteur de texte peut jeter les positions d'octets une fois l'Unicode sorti. Un remplaceur en a besoin, parce qu'il doit savoir quels octets de quel opérande chaîne ont produit chaque glyphe, pour réécrire exactement cette plage et laisser tout le reste tranquille. C'est pourquoi un simple StringReplace sur les octets du flux est le mauvais outil même sur des fichiers qui se trouvent utiliser l'encodage WinAnsi. Il n'a aucune idée de quelle ( appartient à une chaîne et de quel Tf sélectionne la police qui donne leur sens à ces octets
Chercher dans la séquence de glyphes décodée
Le HotPDF Delphi Component cherche dans un document chargé avec SearchLoadedPageText et SearchLoadedDocumentText, qui comparent l'aiguille à la séquence de glyphes Unicode décodée de chaque page, jamais aux octets bruts du flux. Une touche est donc une touche quelle que soit la façon dont la police l'a encodée. Pendant le décodage, chaque glyphe garde trace de l'opérande chaîne, de l'élément du tableau TJ et de l'offset d'octet dont il vient, ce sur quoi l'étape de remplacement s'appuie plus tard. Le même interpréteur de glyphes pilote l'API couverte dans l'extraction de texte depuis un PDF chargé en Delphi ; la recherche garde simplement les positions source que l'extraction jette
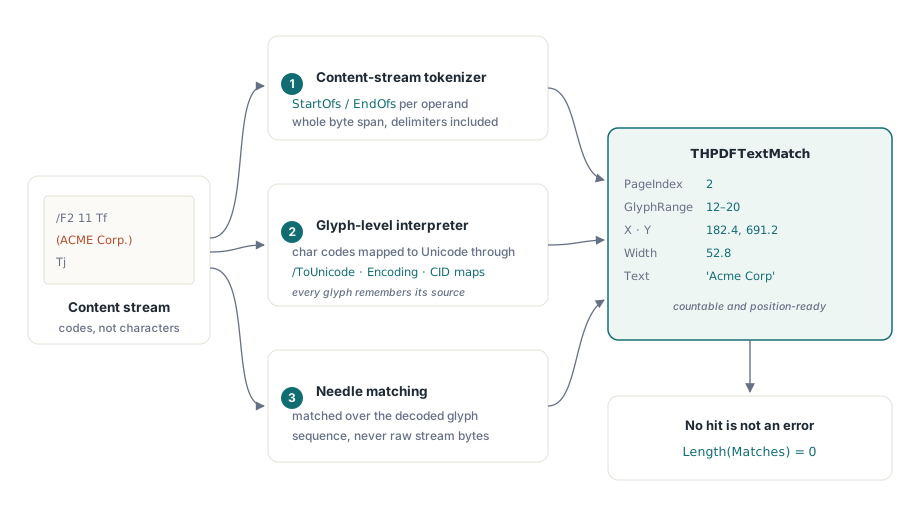
Chaque touche revient sous forme d'un enregistrement THPDFTextMatch : PageIndex, la plage de glyphes inclusive dans GlyphStart et GlyphEnd, l'origine en espace utilisateur dans X et Y, la Width de la touche, le TokenIndex et l'ItemIndex source, et le Text correspondant. PageIndex est en base zéro. Une aiguille qui n'apparaît pas donne un tableau vide et un résultat True, donc le code appelant n'a besoin d'aucun cas particulier pour « rien trouvé »
var
  Pdf: THotPDF;
  Matches: THPDFTextMatchArray;
  I: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoices-2025.pdf') > 0 then
      if Pdf.SearchLoadedDocumentText('Acme Corp', False, Matches) then
        for I := 0 to High(Matches) do
          WriteLn(Format('page %d at (%.1f, %.1f), width %.1f: "%s"',
            [Matches[I].PageIndex + 1, Matches[I].X, Matches[I].Y,
             Matches[I].Width, Matches[I].Text]));
  finally
    Pdf.Free;
  end;
end;
Que cette boucle imprime quelque chose dépend, avant tout le reste, des espaces. Le texte de recherche est construit à partir des glyphes que la page peint réellement, un caractère par glyphe, et un décalage TJ qui sépare visuellement deux mots est un nombre dans un tableau plutôt qu'un glyphe. Un producteur qui règle les espaces entre mots par des décalages plutôt que par un caractère espace donne « AcmeCorp » dans la séquence de glyphes, et l'aiguille « Acme Corp » ne la trouvera pas. Quand une phrase visible refuse de correspondre, cherchez d'abord son mot unique le plus long et regardez le Text de ce qui revient
La casse est l'autre chose à vérifier. Avec CaseSensitive à False, les builds depuis Delphi XE2 comparent les caractères via la correspondance minuscule simple d'Unicode, indépendante de la locale, donc É correspond à é et les capitales grecques ou cyrilliques correspondent à leurs minuscules. Les builds sur des compilateurs plus anciens ne replient que A–Z. La correspondance est un caractère vers un caractère, ce qui garde chaque position de l'aiguille alignée sur exactement un glyphe ; la conséquence est que ß ne correspond pas à SS. Pour les flux d'interface en mot entier, SearchLoadedPageTextWholeWord écarte les touches situées à l'intérieur d'un mot plus long, et GetLoadedSearchHitRect transforme une touche en un seul rectangle pour dessiner un surlignage
Recherche et remplacement travaillent tous deux sur les propres flux /Contents de la page. Le texte peint dans un Form XObject, là où beaucoup d'outils mettent les en-têtes et pieds de page tamponnés, vit dans un flux séparé que la page invoque avec Do, et il est hors de portée des deux opérations
Réécrire les octets correspondants avec ReplaceLoadedDocumentText
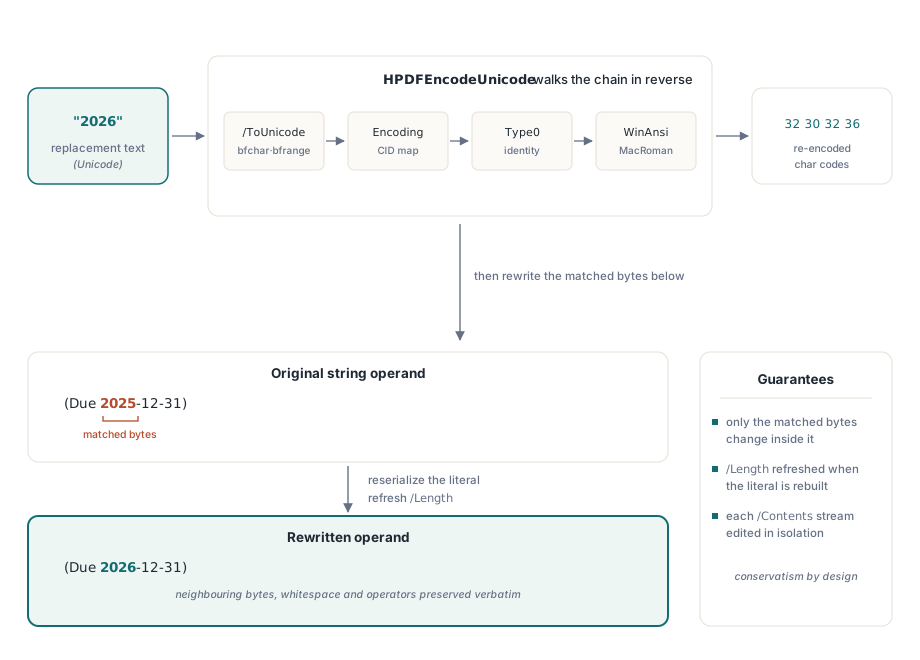
ReplaceLoadedPageText et ReplaceLoadedDocumentText réécrivent chaque occurrence d'une aiguille en faisant tourner le décodage de police à l'envers. Chaque caractère de remplacement est cherché dans la même chaîne que celle du décodeur, en sens inverse : les entrées bfchar et bfrange de /ToUnicode, les correspondances CID pour les polices Type0, les correspondances identité, et les tables prédéfinies WinAnsi et MacRoman. Les codes de caractères obtenus sont réécrits comme chaîne littérale, ou comme chaîne hexadécimale quand un octet tombe hors de l'ASCII imprimable, en suivant les mêmes règles d'échappement que lit le parseur de flux de contenu
Seuls les octets couverts par la correspondance changent. Les octets non correspondants du même opérande, les blancs entre les tokens, les commentaires et chaque opérateur environnant passent intacts. Remplacer bca dans abcabc donne a + remplacement + bc. Le remplacement peut être plus court ou plus long que l'aiguille, et chaque flux du tableau /Contents d'une page est traité séparément pour que la page reste bien formée. Quand une correspondance chevauche plusieurs opérandes chaîne, comme Hello stocké en [(He) -20 (llo)] TJ, le remplacement est écrit dans l'opérande où la correspondance commence et les octets correspondants sont retirés des opérandes suivants
var
  Pdf: THotPDF;
  Rewrites: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('contract-draft.pdf') > 0 then
    begin
      if Pdf.ReplaceLoadedDocumentText('2025-12-31', '2026-12-31',
        True, Rewrites) then
        WriteLn(Format('%d operand rewrites', [Rewrites]));
      Pdf.SaveLoadedDocument('contract-final.pdf');
    end;
  finally
    Pdf.Free;
  end;
end;
La page n'est pas recomposée. Le PDF n'a pas de reflow, donc un remplacement plus large que l'original prend simplement plus de place horizontale et peut empiéter sur ce qui était peint à sa droite ; la position du glyphe suivant a été fixée par le producteur et ne bouge pas. Dates, chaînes de version, numéros de pièces et corrections orthographiques de longueur similaire sont le travail pour lequel cette méthode est faite. Reformuler un paragraphe demanderait de recomposer tout ce qui suit, donc ce changement appartient au document source
Pourquoi un sous-ensemble de police ne peut-il pas accueillir des caractères qu'il n'a jamais contenus ?
Un caractère de remplacement que le sous-ensemble embarqué n'a jamais inclus n'a aucun code de caractère vers lequel revenir. Quand un producteur sous-ensemble une police, sa CMap /ToUnicode et son encodage ne couvrent que les glyphes que le document d'origine utilisait, et les contours de glyphes de tout le reste ne sont simplement pas dans le fichier. Si le document n'a jamais imprimé un E majuscule dans cette police, aucune séquence d'octets n'en sélectionne un. Cette limite se trouve dans le fichier, pas dans l'outil qui fait le remplacement
ReplaceLoadedDocumentText traite un remplacement non encodable de façon conservatrice : si un seul caractère ne peut pas être ré-encodé, cette occurrence est sautée en entier. Pas d'exception ni de chaîne à moitié remplacée, et le texte d'origine reste lisible. Dans l'exemple de date ci-dessus, le chiffre 6 doit exister quelque part dans cette même police pour que la réécriture réussisse. Supposons que la police n'ait jamais imprimé que « 2025 » et quelques totaux de commande sans 6 dedans : les dates restent telles quelles
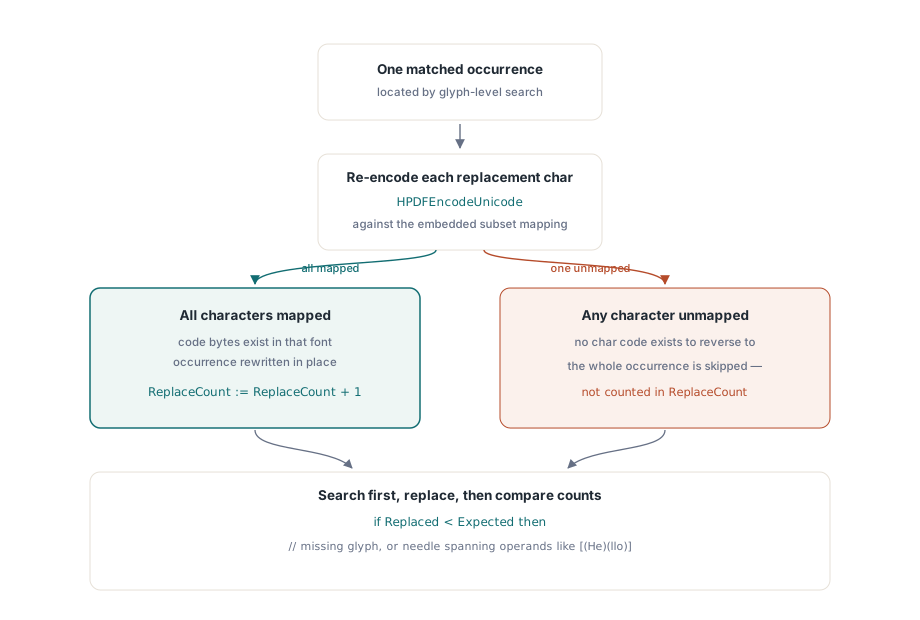
ReplaceCount rapporte des réécritures d'opérandes, et une correspondance répartie sur plusieurs opérandes peut compter pour plus d'une réécriture. Un compte inférieur au nombre de touches signifie quand même que quelque chose a été sauté, mais la réponse exacte vient d'une nouvelle recherche après le remplacement. Ce que la seconde recherche trouve est ce qui est resté, avec page et position attachées
procedure ReplaceAndAudit(Pdf: THotPDF; const OldText, NewText: UnicodeString);
var
  Before, After: THPDFTextMatchArray;
  Rewrites, I: Integer;
begin
  // Rechercher à nouveau ne marche que si NewText ne contient pas lui-même OldText
  Pdf.SearchLoadedDocumentText(OldText, True, Before);
  Pdf.ReplaceLoadedDocumentText(OldText, NewText, True, Rewrites);
  Pdf.SearchLoadedDocumentText(OldText, True, After);
  WriteLn(Format('%d found, %d operand rewrites, %d left',
    [Length(Before), Rewrites, Length(After)]));
  for I := 0 to High(After) do
    WriteLn(Format('  left on page %d at (%.1f, %.1f)',
      [After[I].PageIndex + 1, After[I].X, After[I].Y]));
end;
Quand le sous-ensemble ne suffit pas : prévisualiser et appliquer avec une nouvelle police
Pour les occurrences que la méthode au niveau des octets ne peut pas encoder, PreviewLoadedPageTextReplacement et ApplyLoadedPageTextReplacement prennent une autre route : ils retirent les glyphes correspondants et dessinent le remplacement sur place avec une police de votre choix, à la taille d'origine et sur la ligne de base d'origine. Le THPDFLoadedTextReplacementOptions par défaut utilise Arial à la taille de police du texte correspondant, dimensionne la boîte à la largeur du texte correspondant et garde Atomic activé. Une seule correspondance rejetée sur la page annule alors les autres. La prévisualisation renvoie un plan avec un résultat par correspondance, chacun portant un Status et, en cas de rejet, une Reason
var
  Opts: THPDFLoadedTextReplacementOptions;
  Plan, Applied: THPDFLoadedTextReplacementPlan;
  I: Integer;
begin
  // Pdf est un THotPDF chargé ; PageIndex est une page en base zéro signalée par l'audit
  Opts := THPDFLoadedTextReplacementOptions.Default;
  Opts.Appearance.FontName := 'Arial';
  Opts.Appearance.OverflowPolicy := ltopShrinkToFit;
  Opts.Appearance.MinFontSize := 6;
  if not Pdf.PreviewLoadedPageTextReplacement(PageIndex, 'Acme Corp',
    'Apex Corporation', True, Opts, Plan) then
    for I := 0 to High(Plan.Results) do
      if Plan.Results[I].Status = ltrsRejected then
        WriteLn(Format('match %d at (%.1f, %.1f): %s',
          [I, Plan.Results[I].X, Plan.Results[I].Y, Plan.Results[I].Reason]));
  if (Plan.RejectedCount = 0) and (Plan.ReadyCount > 0) then
  begin
    Pdf.ApplyLoadedPageTextReplacement(Plan, Applied);
    WriteLn(Format('%d of %d matches applied',
      [Applied.AppliedCount, Applied.MatchedCount]));
  end;
end;
Les raisons de rejet valent la peine d'être imprimées parce qu'elles renvoient directement à la géométrie de la page. Une correspondance qui passe d'une ligne de texte à la suivante est rejetée, et le texte vertical aussi. Avec la politique de débordement ltopReject par défaut, un remplacement qui ne tient pas dans la largeur correspondante est rejeté également. ltopShrinkToFit réduit plutôt la taille par paliers vers MinFontSize, et c'est pourquoi l'exemple la pose pour un remplacement de cinq caractères plus long que l'aiguille. Un remplacement contenant des caractères que la police choisie ne peut pas afficher est rejeté aussi
Le plan porte une empreinte du contenu et des polices de la page. Si quoi que ce soit change la page entre la prévisualisation et l'application, ApplyLoadedPageTextReplacement lève EInvalidOpException au lieu d'écrire sur une page que la prévisualisation n'a jamais vue. Les pages aux paires q/Q ou BT/ET déséquilibrées, et les documents contenant des champs de signature, lèvent EArgumentException ; les documents signés appellent des mises à jour incrémentales pour que la révision signée reste intacte
Le remplacement au niveau des octets vient en premier, et le chemin de changement de police ne tourne que sur les pages où l'audit trouve encore l'ancien texte. La réécriture au niveau des octets garde la police d'origine, ses métriques et son crénage, donc le texte édité s'accorde avec ses voisins sur la ligne. Le chemin de prévisualisation dessine dans une autre typographie, et sur une ligne composée en police condensée ou à empattements, un lecteur attentif verra le changement. Quand le but est de faire disparaître du texte plutôt que de le reformuler, la vraie suppression de contenu est le meilleur outil ; le caviardage et la restructuration de PDF chargés en Delphi couvre ce chemin
Ce qui change dans le fichier sauvegardé
Un flux de contenu édité par ReplaceLoadedPageText est sauvegardé non compressé. Le flux est décodé pour l'édition, et quand les octets reconstruits sont réécrits, ses entrées /Filter et /DecodeParms sont retirées et /Length est rafraîchi. Le PDF est valide et se rend normalement ; le coût est un fichier plus gros pour chaque flux édité. Un job par lots sur des milliers de factures devrait budgéter cette croissance ou lancer une passe de compression ensuite
Le chemin prévisualiser-appliquer change un peu plus. Une page appliquée reçoit un seul nouveau flux de contenu non compressé à la place de son /Contents d'origine, plus sa propre copie du dictionnaire de ressources avec la police de remplacement ajoutée. Tout le reste du document est laissé tranquille : les flux intacts gardent leur compression, les polices et images existantes ne sont pas réécrites, et les pages sans touche ne sont jamais ouvertes en écriture. La façon dont les objets réécrits atterrissent dans la structure de références croisées à la sauvegarde est couverte dans les flux d'objets et mises à jour incrémentales dans HotPDF
Recherche, remplacement au niveau des octets, remplacement par prévisualisation-application, extraction et caviardage tournent tous sur le même interpréteur de flux de contenu, de Delphi 5 jusqu'au RAD Studio actuel, sans dépendance externe. Les références des méthodes, les options de remplacement et une version d'essai sont sur la page produit du HotPDF Delphi Component