Le fragment de flux de contenu [(Reference)-333(Manual)] TJ peint deux mots avec un écart net entre eux, pourtant il ne contient aucun caractère espace du tout. L’écart est un mouvement du style : ISO 32000-1 §9.4.3 dit au lecteur de décaler le glyphe suivant de 333 millièmes de la taille de police vers la droite avant de dessiner Manual. Un extracteur qui copie des caractères et ignore la géométrie renvoie ReferenceManual, et un index de recherche nourri de sa sortie ne matchera jamais l'expression “Reference Manual”. La sortie TeX, beaucoup de fichiers Distiller et la plupart des mises en page justifiées séparent les mots ainsi
Les sauts de ligne se gâtent par l'autre côté. Un exposant surélevé coupe sa ligne en deux, un filigrane diagonal DRAFT arrive un caractère par ligne, et une épreuve rognée commence par la slug line d'imprimeur qu'aucune visionneuse n'affiche. Aucun de ces fichiers n'est cassé. Chacun emploie une façon légale de placer du texte qu’un extracteur copieur de caractères lit de travers
Des espaces de mots reconstruits depuis la géométrie des glyphes
THotPDF.ExtractLoadedPageText du HotPDF Delphi Component décide des coupures de mots d'après les positions des glyphes, et un caractère espace dans le flux n'est que l'un des signaux lus. Le long de la direction d'écriture du glyphe précédent, il mesure la distance de la fin de la largeur propre de ce glyphe à l'origine du glyphe courant, et insère une espace quand la distance dépasse 0.15 de la hauteur de boîte du glyphe courant, mesurée de l'ascendante à la descendante en espace utilisateur. Pour le fragment TJ ci-dessus, un tiers d’em passe largement cette ligne pour n'importe quelle fonte de texte ordinaire, donc le texte de page lit Reference Manual
Deux conditions retiennent l'espace. Rien n'est ajouté quand le texte déjà écrit finit par un blanc ou que le glyphe suivant en est un (espace, tabulation, espace insécable, espace idéographique), donc les producteurs qui montrent des espaces n'obtiennent jamais de doubles. Rien n'est ajouté non plus entre deux caractères CJK. Idéogrammes, kana, hangul et formes pleine largeur comptent tous, car la justification écarte une ligne chinoise ou japonaise sans que cet écart signifie une frontière de mot. Indépendamment des deux, une boîte de glyphe de hauteur nulle retombe sur la taille Tf comme hauteur. Chaque nombre que la règle utilise est stocké sur les enregistrements de glyphes, donc un fichier dont l'espacement paraît faux peut être rejoué glyphe par glyphe
uses
  SysUtils, HPDFDoc, HPDFContentStream;

// Affiche les écarts qu'ExtractLoadedPageText transformerait en espaces.
// Texte horizontal seulement ; ExtractLoadedPageGlyphs renvoie le flux
// de contenu de la page sans le texte des Form XObjects ni le filtre de coupe
procedure DumpWordGaps(Pdf: THotPDF; PageIndex: Integer);
var
  Glyphs: THPDFGlyphArray;
  I: Integer;
  Height, Gap: Double;
begin
  if not Pdf.ExtractLoadedPageGlyphs(PageIndex, Glyphs) then
    Exit;
  for I := 1 to High(Glyphs) do
  begin
    if Glyphs[I].Vertical or Glyphs[I - 1].Vertical then
      Continue;
    // hauteur ascendante-descendante de la boîte du glyphe, en espace utilisateur
    Height := Sqrt(Sqr(Glyphs[I].QuadX[3] - Glyphs[I].QuadX[0]) +
      Sqr(Glyphs[I].QuadY[3] - Glyphs[I].QuadY[0]));
    if Height <= 0 then
      Height := Abs(Glyphs[I].FontSize);
    // écart depuis la fin de la largeur propre du glyphe précédent
    Gap := Glyphs[I].BaselineStartX - Glyphs[I - 1].GlyphEndX;
    if (Height > 0) and (Gap > 0.15 * Height) then
      Writeln(Format('U+%.4x gap %.2f height %.2f: space',
        [Glyphs[I].Unicode, Gap, Height]));
  end;
end;
Pourquoi mesurer depuis la largeur propre du glyphe plutôt que depuis la position du style ?
Parce que la position du style après un glyphe contient déjà de l’espacement qui n'a rien à voir avec les coupures de mots. L'ISO 32000-1 §9.4.4 définit le déplacement horizontal comme la largeur du glyphe fois la taille de police, plus l'espacement de caractères Tc, plus l'espacement de mots Tw, le tout mis à l'échelle par l'échelle horizontale Tz. Chaque enregistrement de glyphe porte les deux bouts : BaselineEndX / BaselineEndY portent ce déplacement complet, tandis que GlyphEndX / GlyphEndY ne portent que l’avance de la fonte à la taille courante et Tz. Les deux divergent sur les fichiers qui resserrent l'interlettrage avec un Tc négatif et rendent l'espace par un ajustement TJ après chaque glyphe. Mesuré depuis le style, chaque rendu ressemble à un écart, et un terme chinois comme “95后” sort en “9 5 后”. Mesuré depuis la largeur propre du glyphe, l'ajustement ne rend que ce que Tc avait pris, et le terme reste intact
Le seuil est lié à la hauteur de boîte du glyphe plutôt qu'à la taille Tf pour une raison apparentée. Les exports Word écrivent souvent 1 Tf et portent la vraie taille dans un Tm mis à l'échelle, donc l'opérande de taille de police lit 1 alors que le texte fait 10 points de haut. Une règle calée sur cet opérande placerait le seuil à 0.15 point sur une telle page, et des paires de crénage ordinaires se mettraient à ressembler à des coupures de mots. La hauteur de boîte est mesurée après application de chaque matrice, donc 1 Tf avec une matrice mise à l’échelle et un 10 Tf ordinaire produisent le même texte
Deux cas limites suivent droit de la géométrie. Un titre composé avec un interlettrage très lâche, où Tc seul ouvre plus de 0.15 de la hauteur du texte entre les lettres, s'extrait en S P A C E D. C'est ce que la page montre, et nous préférons le renvoyer plutôt que d’ajouter une heuristique qui devine quels larges écarts sont de l'interlettrage et lesquels sont des mots ; une devinette de ce genre se met à avaler de vraies coupures de mots dans des colonnes étroitement justifiées, ce qui est un échec pire pour la recherche. Des morceaux dessinés hors ordre sur une même ligne de base produisent un écart négatif et se collent sans espace. Dans du texte courant, ce cas est rare
Quand une nouvelle ligne démarre-t-elle dans le texte extrait ?
ExtractLoadedPageText démarre une nouvelle ligne quand le mouvement de l'origine du glyphe précédent à celle du glyphe courant, projeté sur la normale de la direction d'écriture précédente, dépasse la moitié de la plus grande hauteur de boîte des deux glyphes. Le mouvement le long de la ligne de base ne compte jamais pour un saut de ligne, si loin que saute le style
Une règle qui compare le mouvement Y brut à la moitié de la taille Tf échoue dans deux directions. Avec 1 Tf et un Tm mis à l'échelle, le seuil rétrécit à une demi-unité, donc un exposant surélevé d'une élévation de texte de 0.4 coupe la ligne. Il en va de même du léger frémissement de ligne de base que certains moteurs de mise en page laissent entre des suites. La même règle ignore X entièrement. Du texte sous un Tm tourné, comme ce filigrane diagonal, descend la page à chaque glyphe et sort un caractère par ligne, tandis que la projection traite une suite à 45 degrés exactement comme une horizontale
Prendre la plus grande des deux hauteurs compte quand les tailles se mélangent sur une ligne. Un mot d'affichage de 36 points suivi d'une légende de 8 points quelques points plus bas est jugé contre la moitié de la hauteur du grand glyphe, donc la paire reste ensemble ; jugée contre le petit glyphe seul, la légende atterrirait sur une ligne à part. L’élévation de texte fait partie de l'origine du glyphe, voilà pourquoi la ligne de base surélevée d'un exposant est jugée contre cette même demi-hauteur
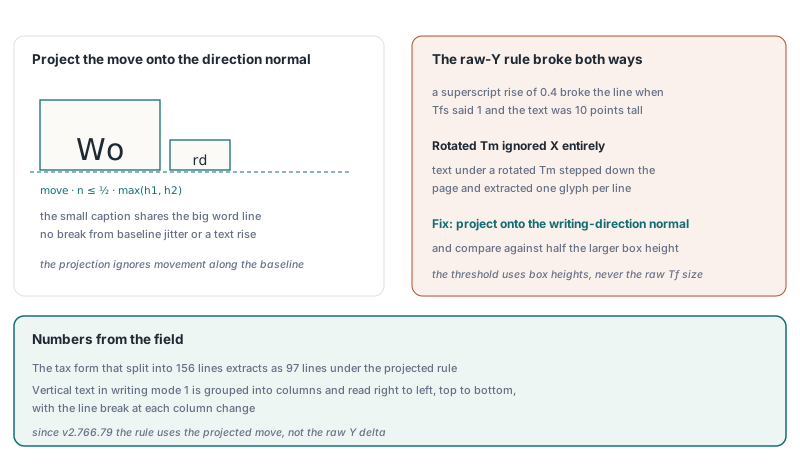
Le texte vertical en mode d'écriture 1 (§9.7.4.3) suit une voie séparée. Ces glyphes sont groupés en colonnes sur leur X d’origine, avec la moitié de la taille de police comme tolérance de colonne, puis lus de droite à gauche et de haut en bas, avec un saut de ligne à chaque changement de colonne. Une page qui mélange un corps japonais vertical avec un en-tête courant horizontal reçoit aussi un saut de ligne à chaque bascule entre les deux directions
Quels glyphes entrent dans le texte de page
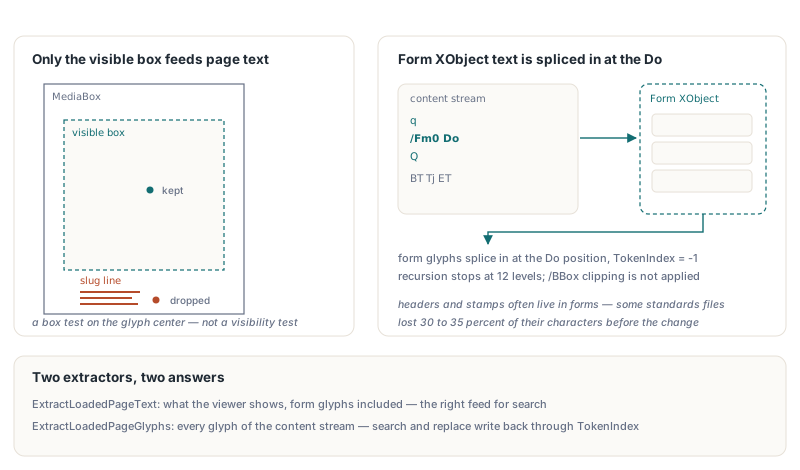
ExtractLoadedPageText renvoie le texte qu'une visionneuse montre. Il ne garde que les glyphes dont le centre de boîte tombe dans GetLoadedPageVisibleBox, le CropBox clippé à la MediaBox (§14.11.2), donc les slug lines et autres marques d'imprimeur composées en texte hors de la zone de coupe tombent. ExtractLoadedPageGlyphs continue de renvoyer chaque glyphe du flux de contenu de la page, slug line comprise, pour les travaux qui en ont besoin. Le filtre est un test géométrique sur un point par glyphe. Le texte caché par un chemin de clipping, peint en blanc ou couvert par une image sort quand même, car décider de la visibilité réelle voudrait dire rendre la page
uses
  SysUtils, HPDFDoc, HPDFContentStream;

var
  Pdf: THotPDF;
  Raw, Merged: THPDFGlyphArray;
  PageText: UnicodeString;
  L, B, R, T: Single;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('trimmed-proof.pdf');
    if Pdf.GetLoadedPageVisibleBox(0, L, B, R, T) then
      Writeln(Format('Visible box: %.1f %.1f %.1f %.1f', [L, B, R, T]));
    // chaque glyphe du flux de contenu de la page, slug line comprise
    if Pdf.ExtractLoadedPageGlyphs(0, Raw) then
      Writeln(Length(Raw), ' glyphs in the page content stream');
    // flux de page plus texte des Form XObjects, dans l'ordre de peinture, avant la coupe
    if Pdf.ExtractLoadedPageGlyphsWithForms(0, Merged) then
      Writeln(Length(Merged), ' glyphs including forms');
    // ce que la page montre : formulaires insérés, glyphes hors coupe abandonnés
    if Pdf.ExtractLoadedPageText(0, PageText) then
      Writeln(PageText);
    // les mêmes règles d'espacement appliquées au flux non filtré, pour comparaison
    Writeln(HPDFAssemblePageText(Raw));
  finally
    Pdf.Free;
  end;
end.
Le texte peint via des Form XObjects fait partie du texte de page. Les en-têtes, tampons et filigranes logent très souvent dans des formulaires, et un extracteur qui ne lit que le flux de contenu de la page ne les voit jamais. HotPDF enregistre chaque Do avec la CTM en vigueur, interprète le formulaire à son /Matrix fois cette CTM (§8.10.1), et insère les glyphes du formulaire à la position du Do, en récurse dans les formulaires imbriqués. Un formulaire sans /Resources propre emprunte celles du flux qui le peint, la disposition plus ancienne que §7.8.3 décrit. Les glyphes dont le centre tombe hors du /BBox du formulaire sont laissés de côté, car cette boîte clippe le formulaire quand il est peint. Un formulaire qui se peint lui-même, directement ou via un autre formulaire, n'est pas entré une seconde fois, et l'imbrication s'arrête à 12 niveaux
Les glyphes de formulaire portent TokenIndex = -1 et ItemIndex = -1. La même raison garde ExtractLoadedPageGlyphs limité aux glyphes du flux de page : recherche, remplacement et rédaction réécrivent leurs changements via TokenIndex, et un glyphe de formulaire dans ce tableau pointerait vers des octets d'un autre flux. Quand il vous faut la liste fusionnée au niveau glyphe, ExtractLoadedPageGlyphsWithForms la renvoie dans l’ordre de peinture, avant que le filtre de boîte visible ne tourne
Une dernière passe tourne avant les règles d'espacement. Des logos surimprimés et du gras simulé en peignant le même texte deux fois avec un petit décalage s'extrairaient sinon avec chaque lettre doublée. Quand un glyphe peint le même caractère à la même taille à moins d'un dixième de cette taille le long de la ligne de base, et d'un cinquième en travers, d'un glyphe antérieur, une seule copie est gardée ; les espaces ne sont jamais retirés ainsi. L'article sur le faux gras et les glyphes dupliqués dans l’extraction de texte détaille ce cas
L'état de texte à travers q et Q
Le texte après un Q se décode de travers dans tout extracteur qui ne sauvegarde que la CTM sur q. Les paramètres d'état de texte, à savoir police, taille, Tc, Tw, Tz, TL, mode de rendu et élévation, appartiennent à l'état graphique (§9.3.1), donc Q doit les restaurer avec tout le reste de la pile (§8.4.2). Un motif expose vite la faute : une police deux octets Identity-H est sélectionnée dans q … Q pour une seule cellule de tableau, et le texte après le Q montre des chaînes WinAnsi un octet sans Tf propre. Un interpréteur qui garde la police interne lit ces octets par paires, et les filets de la table des matières se changent en une chaîne de caractères CJK sans rapport. L'interpréteur de HotPDF empile les huit valeurs d’état de texte avec la CTM à chaque q et les dépile à chaque Q
Tout ce qui précède s'applique à chaque page, donc un document entier peut partir vers un fichier UTF-8 en un appel. ExtractLoadedPagesTextToStream prend une plage de pages à base 1 (une chaîne vide signifie toutes les pages), un séparateur écrit entre les pages, et un drapeau pour la marque d'ordre des octets, et renvoie le nombre de pages extraites. La sortie s'ajoute à la position courante du flux, donc rien de plus grand que le texte d'une page n'est tenu en mémoire
uses
  SysUtils, Classes, HPDFDoc;

var
  Pdf: THotPDF;
  Output: TFileStream;
  Pages: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('report.pdf');
    Output := TFileStream.Create('report.txt', fmCreate);
    try
      // plage vide = toutes les pages ; saut de page entre pages ; BOM UTF-8
      Pages := Pdf.ExtractLoadedPagesTextToStream(Output, '', #12, True);
      Writeln(Pages, ' pages extracted');
    finally
      Output.Free;
    end;
  finally
    Pdf.Free;
  end;
end.
Choisir l'API de texte selon le travail
Pour la recherche et l’indexation, ExtractLoadedPageText est le bon aliment : il suit l'ordre du flux de contenu et reflète ce que la page montre. La chaîne de décodage en dessous, des tables /ToUnicode aux polices CID, est traitée dans l'extraction de texte de PDF chargés avec HotPDF. L'ordre du flux de contenu est le plus faible sur les documents étiquetés dont le producteur a écrit l'en-tête courant en dernier ou a entrelacé deux colonnes ; pour ceux-là, l'extraction de texte dans l'ordre de structure parcourt l’arbre de structure dans l'ordre de composition au lieu de le déduire de la géométrie. Les données enfermées dans des tableaux sont mieux servies par l'extraction de tableaux typée à travers les sauts de page, qui renvoie des cellules avec leurs valeurs. Le code qui édite la page appartient à ExtractLoadedPageGlyphs, dont les index de jetons pointent vers les octets qu'il réécrira
Les champs d'enregistrement de glyphe utilisés dans ces exemples, avec le reste de l'API d'extraction de texte et un build d’essai, sont documentés sur la page produit HotPDF Delphi PDF Component