Les couches de texte OCR, les bornes de codes-barres et les zones de floutage de visages dérivent sur les pages PDF rognées quand les pixels du bitmap sont remappés à travers la MediaBox au lieu de la box que le moteur de rendu a réellement rastérisée : la CropBox rognée par la MediaBox (ISO 32000-1 §14.11.2). HotPDF remappe les résultats de ApplyLoadedOCRTextLayer, DecodeLoadedPageBarcodes et DetectLoadedRedactionFindings à travers cette box visible, et tout moteur ou détecteur personnalisé que vous écrivez doit faire de même
Le symptôme se reconnaît facilement dès qu’on l’a vu. Une archive de contrats scannés passe par un pipeline OCR, la sortie est interrogeable, et le résultat de recherche d’un numéro d’article est surligné un demi-pouce plus bas et à gauche du numéro imprimé. La plupart des fichiers du lot sont corrects. Ceux qui sont décalés viennent tous d’une station de scan qui écrit une /CropBox pour rogner la marge du plateau. Ce seul détail sépare l’image que le moteur OCR a vue du repère dans lequel la couche de texte a été placée, et le même décalage touche les bornes des codes-barres et, plus grave encore, les zones de floutage de visages
Pourquoi la couche de texte OCR dérive-t-elle loin des mots scannés ?
La couche de texte dérive quand deux moitiés du pipeline divergent sur le rectangle que le bitmap couvre. Le rendu HotPDF, l’export SVG, la visionneuse et l’impression honorent tous la CropBox : une page est affichée à travers sa CropBox rognée par sa MediaBox, ce que prescrit ISO 32000-1 §14.11.2, et GetLoadedPageVisibleBox retourne cette box visible. Une transformation dispositif-vers-page construite à partir de GetLoadedPageBox(PageIndex, pbMediaBox, ...) suppose que le raster couvre la MediaBox, si bien que le raster et la transformation décrivent deux rectangles différents et chaque position reconnue revient décalée de l’écart entre les deux
Bien faire les choses, c’est maintenir trois éléments en accord pour chaque fonctionnalité de reconnaissance : la transformation, l’estimation du budget de pixels, et la page box remise à un moteur personnalisé dans le record de requête. HotPDF dérive les trois de la box visible, ce qui signifie aussi que la reconnaissance ne voit que le contenu que les visionneuses affichent réellement
Quelques cas sont immunisés contre le décalage :
- Les pages sans
/CropBox, ou dont la CropBox égale la MediaBox, se remappent identiquement par l’une ou l’autre box DecodeLoadedPageBarcodesavecHasRegionactif rend exactement la région que vous passez et remappe à travers cette même région ; le contrôle que la région tient dans la page utilise la MediaBox- Les résultats de suppression par motifs (emails, numéros de carte, etc.) proviennent de l’extraction de texte en espace utilisateur, pas d’un raster, donc seuls les résultats de détection de visages dépendent du mapping raster
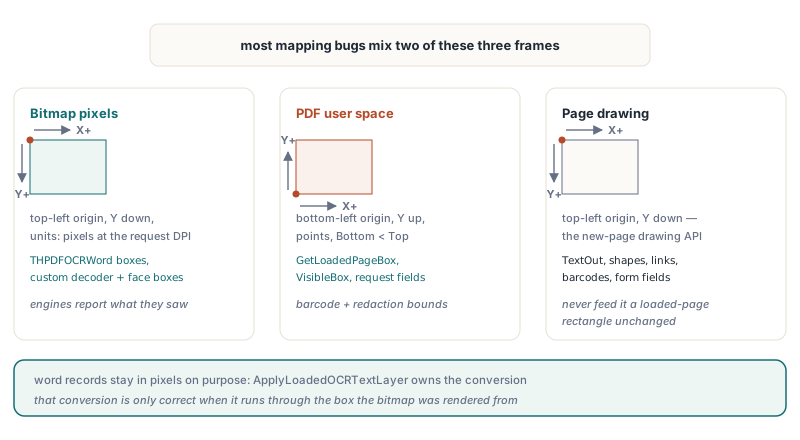
Trois repères de coordonnées, et quelles API HotPDF utilisent chacun
Le code qui touche à la reconnaissance HotPDF manipule trois repères, et la plupart des erreurs de mapping viennent d’en mélanger deux
- Pixels du bitmap : origine en haut à gauche, Y croît vers le bas, les unités sont des pixels au DPI de la requête.
THPDFOCRWord.Left,Top,RightetBottomsont dans ce repère, tout comme les points de baseline optionnels, les résultats qu’unIHPDFBarcodeDecoderpersonnalisé renvoie, et les boîtes d’unIHPDFFaceDetectorpersonnalisé - Espace utilisateur PDF d’une page chargée : origine en bas à gauche, Y croît vers le haut, les unités sont des points, avec
Bottom < Top.GetLoadedPageBoxetGetLoadedPageVisibleBoxrenvoient Left, Bottom, Right, Top dans ce repère, tout comme les champsPageLeft,PageBottom,PageRightetPageTopdeTHPDFOCRRequest, les bornes dansTHPDFDecodedBarcodeet les rectangles dansTHPDFRedactionFinding - Coordonnées de dessin de page HotPDF : l’API que vous employez pour construire de nouvelles pages (sortie de texte, formes, codes-barres, liens, champs de formulaire) fonctionne avec une origine en haut à gauche et Y croissant vers le bas. Ce repère appartient à la génération de documents et n’a rien à voir avec les API de document chargé ci-dessus, donc ne lui donnez jamais tel quel un rectangle en espace utilisateur de page chargée
Le record de mot OCR est délibérément en pixels : un moteur rapporte ce qu’il a vu dans l’image, et ApplyLoadedOCRTextLayer possède la conversion. Cette division ne fonctionne que si la conversion utilise la bonne box, voilà pourquoi HotPDF la construit à partir de la box visible
La transformation dispositif-vers-page derrière OCR, codes-barres et visages
HotPDF remappe les pixels du bitmap vers la page avec une seule matrice affine construite à partir de cinq entrées : la rotation, l’échelle DPI / 72, la hauteur du bitmap, et les Left, Bottom, Right et Top de la box rendue. OCR, décodage de codes-barres et détection de visages partagent une seule routine pour cela, donc l’entrée box décide de l’exactitude des trois à la fois. Pour une page non tournée, la matrice page-vers-dispositif [A B C D E F] est :
A = ScaleetD = -Scale, oùScale = DPI / 72; leDnégatif retourne l’espace utilisateur (Y vers le haut) en espace bitmap (Y vers le bas)B = C = 0, parce qu’une page non tournée n’a ni cisaillement ni échange entre axesE = -Left * Scale, qui amène le bord gauche de la box à la colonne de pixels 0F = BitmapHeight + Bottom * Scale, qui remappe le bord bas de la box à y = BitmapHeight, le bord bas du bitmap, si bien que le bord haut atterrit sur la ligne 0
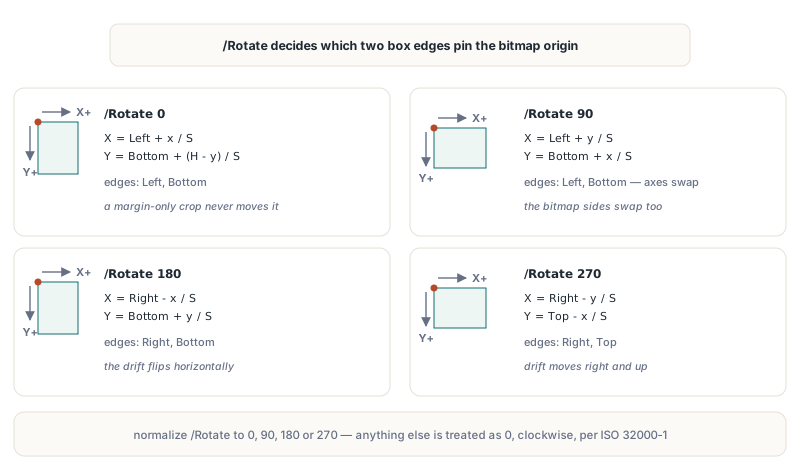
Les pixels reviennent vers la page par l’inverse de cette matrice. Request.PageRotation porte le /Rotate de la page normalisé à 0, 90, 180 ou 270 (toute valeur qui n’est pas un multiple de 90 est traitée comme 0), et le moteur de rendu tourne la page dans le sens horaire comme l’exige ISO 32000-1 §7.7.3.3. Sous rotation, les axes s’échangent et une autre paire de bords de box est arrimée à l’origine du bitmap. Écrites comme formules inverses, avec S = DPI / 72, x et y en pixels et H la hauteur du bitmap :
| /Rotate | Page X | Page Y | Bords de box dont dépend le remappage |
|---|---|---|---|
| 0 | Left + x / S | Bottom + (H - y) / S | Left, Bottom |
| 90 | Left + y / S | Bottom + x / S | Left, Bottom |
| 180 | Right - x / S | Bottom + y / S | Right, Bottom |
| 270 | Right - y / S | Top - x / S | Right, Top |
La dernière colonne explique pourquoi un mapping basé sur la MediaBox paraît aléatoire en production. Une CropBox qui ne rogne que le haut de la page laisse Left et Bottom intacts, si bien que les pages droites ressortent parfaitement et que seules les pages portant /Rotate 270 dérivent. La rotation échange aussi les dimensions du bitmap : à 90 et 270, le bitmap fait (Top - Bottom) * S pixels de large et (Right - Left) * S pixels de haut
Qu’est-ce qui cloche avec MediaBox [0 0 612 792] et CropBox [36 36 576 756] ?
Avec un rogne d’un demi-pouce sur chaque côté, la couche de texte d’une page non tournée atterrit exactement 36 points à gauche et 36 points en dessous des mots scannés quand on utilise le MediaBox. Prenons une page US Letter dont le CropBox rogne 36 points (0,5 pouce) sur chaque bord. La box visible fait 540 par 720 points, donc à la résolution OCR par défaut de 300 DPI, l’échelle vaut 300 / 72 ≈ 4,1667 et le bitmap fait 2250 par 3000 pixels
Supposons que le moteur rapporte un mot avec la boîte en pixels Left 450, Top 600, Right 900, Bottom 660 et pas de baseline. HotPDF place alors la baseline 20 pour cent de la hauteur du mot au-dessus du bord bas, à la ligne de pixels 648, et remappe le point de départ (450, 648) :
- Par la box visible : x = 36 + 450 / 4.1667 = 144.0 et y = 36 + (3000 - 648) / 4.1667 = 600.48, ce qui est l’endroit où le mot est imprimé
- Par le MediaBox : x = 0 + 108.0 = 108.0 et y = 0 + 564.48 = 564.48, un décalage uniforme de (-36, -36) points
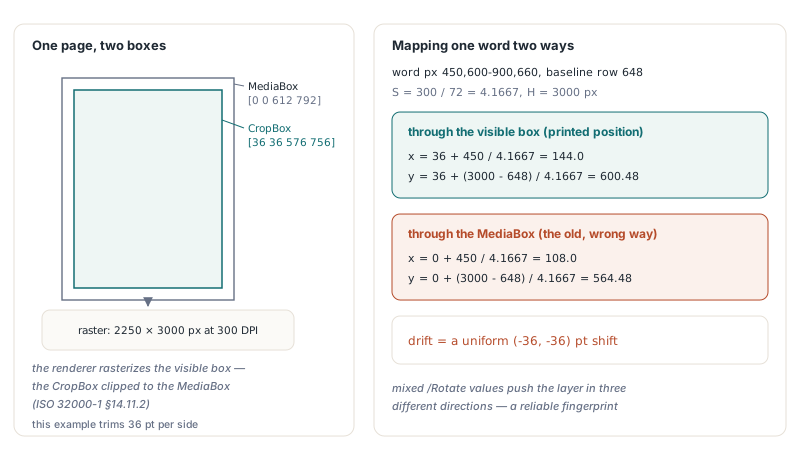
Faites tourner la même page et la direction de l’erreur change, car ce sont d’autres bords qui entrent en jeu. À /Rotate 180 le terme X utilise Right, et 612 au lieu de 576 pousse la couche de 36 points vers la droite tandis que Bottom la tire toujours de 36 points vers le bas. À /Rotate 270 Right et Top sont tous deux trop grands, donc la couche se déplace de 36 points à droite et de 36 points vers le haut. Un document aux orientations mixtes peut montrer la dérive dans trois directions, une empreinte fiable pour cette erreur. Le code écrit à la main qui dérive l’échelle de la box, comme Bitmap.Width / (Right - Left), étire aussi chaque coordonnée de 612 / 540, soit environ 13 pour cent, en plus du décalage
Quelles pages PDF ont besoin d’un mapping conscient du CropBox ?
Un document PDF demande de l’attention dès qu’au moins une page possède une box visible différente de sa MediaBox, et HotPDF peut vous le dire en quelques lignes. Comparez GetLoadedPageBox avec pbMediaBox à GetLoadedPageVisibleBox pour chaque page, et imprimez GetLoadedPageRotation à côté pour prédire la direction de la dérive depuis la table ci-dessus. THPDFPageBoundary propose aussi pbCropBox, pbBleedBox, pbTrimBox et pbArtBox, mais GetLoadedPageBox(pbCropBox) retombe sur la MediaBox quand aucune crop box n’existe et ne rogne pas, donc la box visible est la bonne chose à comparer
uses
  System.SysUtils, HPDFDoc;

procedure ReportCroppedPages(const FileName: string);
var
  Pdf: THotPDF;
  I: Integer;
  ML, MB, MR, MT, VL, VB, VR, VT, Tmp: Single;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile(FileName) < 1 then
      raise Exception.Create('Cannot load ' + FileName);
    for I := 0 to Pdf.LoadedPageCount - 1 do
    begin
      if not Pdf.GetLoadedPageBox(I, pbMediaBox, ML, MB, MR, MT) then
        Continue;
      // le tableau stocké peut lister ses coins dans n’importe quel ordre
      if MR < ML then begin Tmp := ML; ML := MR; MR := Tmp; end;
      if MT < MB then begin Tmp := MB; MB := MT; MT := Tmp; end;
      // déjà normalisée et écrêtée par le MediaBox
      if not Pdf.GetLoadedPageVisibleBox(I, VL, VB, VR, VT) then
        Continue;
      if (Abs(VL - ML) > 0.01) or (Abs(VB - MB) > 0.01) or
         (Abs(VR - MR) > 0.01) or (Abs(VT - MT) > 0.01) then
        Writeln(Format('Page %d  MediaBox [%g %g %g %g]  visible [%g %g %g %g]  /Rotate %d',
          [I + 1, ML, MB, MR, MT, VL, VB, VR, VT,
           Pdf.GetLoadedPageRotation(I)]));
    end;
  finally
    Pdf.Free;
  end;
end;
Deux détails de GetLoadedPageVisibleBox importent pour des scripts comme celui-ci. La fonction laisse ses paramètres de sortie intacts en cas d’échec, donc prépositionner une taille de page par défaut avant l’appel est un motif sûr. Et quand une CropBox malformée n’intersecte pas du tout la MediaBox, la fonction retourne la MediaBox plutôt qu’un rectangle vide. Si le rapport liste des pages qu’un pipeline antérieur a traitées par OCR via un mapping basé sur la MediaBox, rappelez-vous que la couche de texte déjà enregistrée reste dans le fichier sauvegardé : l’option par défaut SkipPagesWithText sautera ces pages à une seconde passe, sauf à la désactiver ou à supprimer d’abord l’ancienne couche
Comment un IHPDFOCREngine personnalisé doit-il remapper les pixels vers l’espace PDF ?
Un IHPDFOCREngine personnalisé doit retourner les boîtes de mots en pixels du bitmap et laisser HotPDF faire le mapping ; convertissez en espace utilisateur seulement pour vos propres décisions, et utilisez alors la box de la requête, jamais la MediaBox. Les PageLeft, PageBottom, PageRight et PageTop de la requête décrivent la box visible rendue, donc ils correspondent exactement à Request.Bitmap. Le helper ci-dessous est l’inverse de la transformation de la bibliothèque, y compris son usage de la hauteur réelle du bitmap pour les pages droites, donc il s’accorde avec HotPDF au pixel près
uses
  System.SysUtils, System.Math, Vcl.Graphics, HPDFDoc;

// Pixel du bitmap (origine haut gauche, Y vers le bas) vers l’espace
// utilisateur PDF (origine bas gauche, Y vers le haut), par la box de rendu du bitmap
procedure HotPixelToPage(Rotation, DPI, BitmapHeight: Integer;
  Left, Bottom, Right, Top: Single; X, Y: Double;
  out PageX, PageY: Double);
var
  S: Double;
begin
  S := DPI / 72.0;
  case Rotation of
    90:  begin PageX := Left + Y / S;  PageY := Bottom + X / S; end;
    180: begin PageX := Right - X / S; PageY := Bottom + Y / S; end;
    270: begin PageX := Right - Y / S; PageY := Top - X / S; end;
  else
    PageX := Left + X / S;
    PageY := Bottom + (BitmapHeight - Y) / S;
  end;
end;
Une raison réaliste de vouloir l’espace utilisateur à l’intérieur d’un moteur est une règle de zone : des factures dont l’en-tête ne doit jamais devenir cherchable, ou une zone de tampon qui embrouille le reconnaisseur. Le moteur ci-dessous, écrit avec TInterfacedObject pour que le comptage de références gère sa durée de vie, filtre les mots selon où leurs centres tombent sur la page, puis renvoie les survivants intacts en coordonnées pixels. RunRecognizer tient lieu de votre propre appel de reconnaissance
type
  TZoneFilterOCREngine = class(TInterfacedObject, IHPDFOCREngine)
  private
    FSkipLeft, FSkipBottom, FSkipRight, FSkipTop: Single;  // espace utilisateur
    function RunRecognizer(Bitmap: TBitmap; MaxWords: Integer;
      out Words: THPDFOCRWords): boolean;  // votre reconnaisseur, boîtes en pixels
  public
    constructor Create(SkipLeft, SkipBottom, SkipRight, SkipTop: Single);
    function GetName: AnsiString;
    function Recognize(const Request: THPDFOCRRequest;
      out Words: THPDFOCRWords; out Diagnostic: AnsiString): boolean;
  end;

function TZoneFilterOCREngine.Recognize(const Request: THPDFOCRRequest;
  out Words: THPDFOCRWords; out Diagnostic: AnsiString): boolean;
var
  Raw: THPDFOCRWords;
  I, Count: Integer;
  CX, CY: Double;
begin
  Diagnostic := '';
  SetLength(Words, 0);
  if not RunRecognizer(Request.Bitmap, Request.MaxWords, Raw) then
  begin
    Diagnostic := 'recognizer failed';
    Exit(False);
  end;
  SetLength(Words, Length(Raw));
  Count := 0;
  for I := 0 to High(Raw) do
  begin
    HotPixelToPage(Request.PageRotation, Request.DPI,
      Request.Bitmap.Height, Request.PageLeft, Request.PageBottom,
      Request.PageRight, Request.PageTop,
      (Raw[I].Left + Raw[I].Right) / 2, (Raw[I].Top + Raw[I].Bottom) / 2,
      CX, CY);
    if (CX >= FSkipLeft) and (CX <= FSkipRight) and
       (CY >= FSkipBottom) and (CY <= FSkipTop) then
      Continue;
    Words[Count] := Raw[I];  // toujours des pixels : HotPDF les remappe lui-même
    Inc(Count);
  end;
  SetLength(Words, Count);
  Result := True;
end;
Remettez le moteur à ApplyLoadedOCRTextLayer(PageIndices, Engine, Options, Info) comme avec n’importe quel autre moteur. La bibliothèque valide ce qui revient avant de s’y fier : un mot est abandonné et compté dans Info.DroppedWordCount quand sa boîte sort du bitmap, quand Right <= Left ou Bottom <= Top, ou quand Confidence est hors de 0..1 ou en dessous de MinimumConfidence. Renvoyer plus de mots que MaxWordsPerPage, ou pousser le total courant au-delà de MaxTotalWords, fait échouer tout l’appel avec une erreur de budget, donc honorez Request.MaxWords dans le moteur. Ne convertissez pas les boîtes de mots vers l’espace utilisateur avant de les renvoyer ; HotPDF traiterait les valeurs en points comme des pixels et la couche s’effondrerait vers l’origine du bitmap
Cartographier la sortie de votre propre détecteur
Le même helper sert un pipeline maison bâti sur RenderLoadedPageToBitmap, qui rend la box visible et applique /Rotate exactement comme les fonctions de reconnaissance. Lisez la box avec GetLoadedPageVisibleBox, normalisez la rotation comme le fait HotPDF, et remappez deux coins opposés de chaque boîte en pixels. L’axe Y se retourne et, à 90 et 270 degrés, les axes s’échangent, si bien que les coins remappés sortent sans ordre fixe ; prenez le minimum et le maximum des points remappés, ce qui est aussi la façon dont HotPDF bâtit les bornes de codes-barres
const
  DPI = 200;
var
  Pdf: THotPDF;
  Bmp: TBitmap;
  VL, VB, VR, VT: Single;
  Rotation: Integer;
  PxL, PxT, PxR, PxB, X1, Y1, X2, Y2: Double;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('scanned-ids.pdf');
    if not Pdf.GetLoadedPageVisibleBox(0, VL, VB, VR, VT) then Exit;
    Rotation := Pdf.GetLoadedPageRotation(0) mod 360;
    if Rotation < 0 then Inc(Rotation, 360);
    if (Rotation <> 90) and (Rotation <> 180) and (Rotation <> 270) then
      Rotation := 0;
    Bmp := Pdf.RenderLoadedPageToBitmap(0, DPI);
    if Bmp = nil then Exit;
    try
      MyDetector(Bmp, PxL, PxT, PxR, PxB);  // votre code, boîte en pixels
      HotPixelToPage(Rotation, DPI, Bmp.Height, VL, VB, VR, VT,
        PxL, PxT, X1, Y1);
      HotPixelToPage(Rotation, DPI, Bmp.Height, VL, VB, VR, VT,
        PxR, PxB, X2, Y2);
      Writeln(Format('User-space box [%.2f %.2f %.2f %.2f]',
        [Min(X1, X2), Min(Y1, Y2), Max(X1, X2), Max(Y1, Y2)]));
    finally
      Bmp.Free;
    end;
  finally
    Pdf.Free;
  end;
end;
Le comportement de rotation est approfondi dans l’aplatissement de la rotation de page sans casser les boxes de page, et le pipeline de décodage de codes-barres qui consomme la même transformation dans le décodage des QR codes tournés depuis des pages PDF. Si votre moteur encapsule un reconnaisseur externe, l’adaptateur OCR Tesseract pour PDF cherchable montre le côté isolation de processus et annulation de la même interface
Aide-mémoire : cartographie des coordonnées sûre vis-à-vis du CropBox
- Le moteur de rendu rastérise la box visible, la CropBox rognée par la MediaBox (ISO 32000-1 §14.11.2) ; tout mapping pixel-vers-page doit utiliser cette box, lue avec
GetLoadedPageVisibleBox ApplyLoadedOCRTextLayer,DecodeLoadedPageBarcodespage entière et les visages deDetectLoadedRedactionFindingsremappent tous à travers la box visible, et tout moteur ou détecteur personnalisé doit faire de même- Les boîtes
THPDFOCRWordsont en pixels du bitmap à origine en haut à gauche ;GetLoadedPageBoxetGetLoadedPageVisibleBoxretournent l’espace utilisateur PDF à origine en bas à gauche avecBottom < Top - L’échelle vaut
DPI / 72; dérivez-la du DPI, jamais d’une page box divisée dans la largeur du bitmap - /Rotate décide des bords qui comptent : Left et Bottom à 0 et 90, Right et Bottom à 180, Right et Top à 270
- Retournez les mots OCR en pixels et laissez HotPDF les remapper ; ne convertissez que pour votre propre logique de filtrage
- En relançant l’OCR sur des pages qui portent déjà une couche de texte, rappelez-vous que
SkipPagesWithTextles saute sauf à désactiver l’option ou à supprimer d’abord l’ancienne couche
Les fonctions de reconnaissance, les requêtes de boxes de page et le rendu de document chargé utilisés ici se livrent tous dans le composant HotPDF pour Delphi et C++Builder ; licences, téléchargements d’essai et liste complète des fonctionnalités sont sur la page du composant HotPDF Delphi PDF