Un JPEG CMYK qui sort d'un PDF avec des couleurs baveuses, décalées ou négatives signifie presque toujours que le décodeur s'est trompé sur l'un de deux faits : les échantillons étaient-ils stockés en YCCK et demandent-ils une conversion, ou ont-ils été stockés inversés selon la convention Adobe. Les décodeurs de HotPDF honorent le paramètre /ColorTransform DCTDecode pour les images à trois et quatre canaux, rejettent les valeurs que la spec ne définit pas, et laissent un marqueur Adobe APP14 dans les données JPEG primer sur cette entrée de dictionnaire, comme l'exige la table 13 de l'ISO 32000-1. Deux règles voisines appartiennent à la même famille de pièges : les flux multi-filtres doivent porter des tableaux /DecodeParms alignés par étape, et les images JPEG 2000 gardent un mappage /Decode explicite
Les trois partagent un thème. Le PDF dit déjà ce qu'il veut dire, et le piège, c'est un renderer qui répond à une question légèrement différente
Pourquoi un JPEG CMYK se rend-il inversé ou délavé dans un PDF ?
Un JPEG CMYK tourne mal dans un PDF pour l'une de deux raisons, et elles se distinguent à l'écran. Une image en négatif, où le papier blanc devient noir et les teintes claires sombres, pointe vers un stockage inversé. Une image délavée ou aux teintes décalées, où la peau verdit et les noirs grisent tandis que le détail du K reste net, pointe vers une transformation de couleur appliquée à tort, ou sautée alors qu'elle était requise
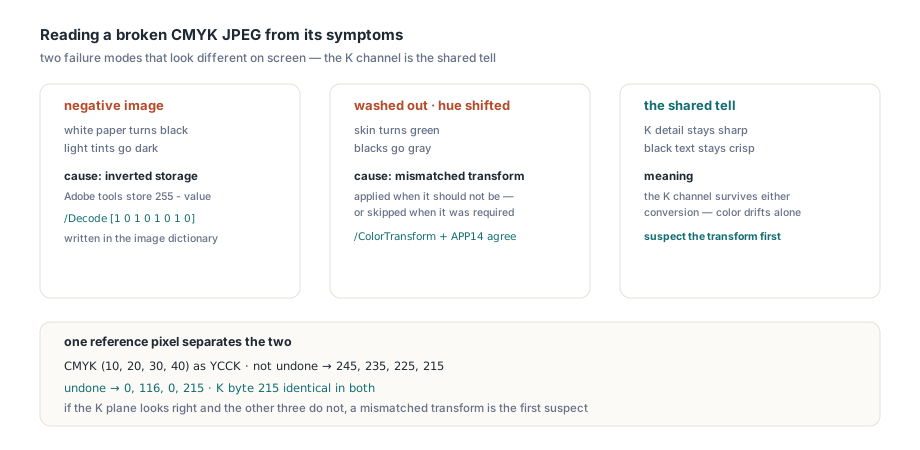
Le problème de transformation vient de la façon dont le JPEG compresse la couleur. Le JPEG baseline compresse au mieux quand la luminance est séparée de la chrominance, donc les encodeurs convertissent d'habitude RGB en YCbCr avant compression, et les encodeurs à quatre canaux convertissent CMY en YCC en laissant passer le K intact, ce qui est le format appelé YCCK. Le décodeur doit annuler exactement la conversion qu'a appliquée l'encodeur. Annulez-en une qui n'a jamais eu lieu, ou sautez-en une qui a eu lieu, et chaque pixel bouge. Le canal noir survit dans les deux cas, voilà pourquoi une image CMYK cassée garde souvent du texte noir net pendant que tout le reste dérive
Le problème d'inversion est historique. Photoshop et d'autres outils Adobe écrivent des JPEG CMYK avec chaque échantillon stocké en 255 - value, et ils marquent le fichier d'un marqueur Adobe APP14. Rien dans le standard JPEG ne le dit ; c'est une convention, et chaque consommateur doit la connaître. Dans un PDF, on attend du producteur qu'il exprime l'inversion dans le dictionnaire d'image plutôt que de la laisser à la devinette
Que dit /ColorTransform au décodeur ?
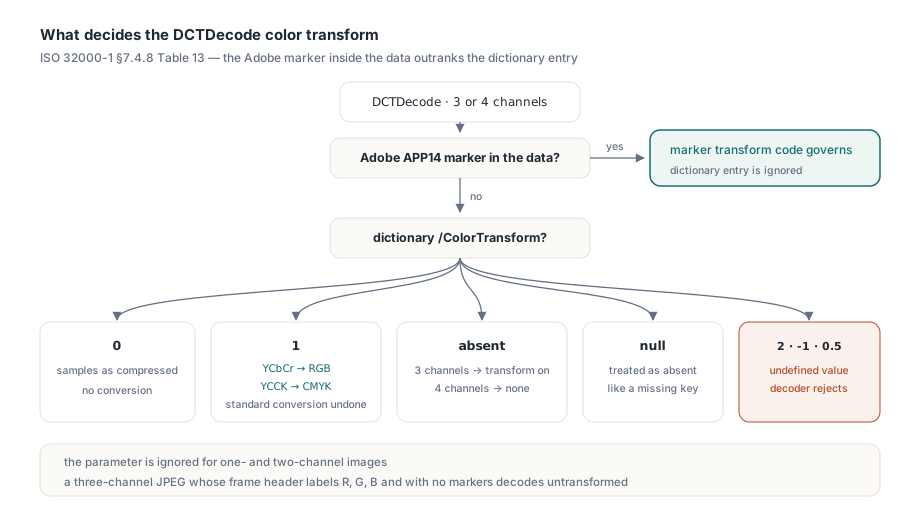
/ColorTransform est l'énoncé au niveau PDF de la conversion que le décodeur doit annuler. L'ISO 32000-1 §7.4.8, table 13, définit deux valeurs. Zéro signifie aucune transformation : le décodeur renvoie les échantillons tels que compressés. Un signifie que l'encodeur a appliqué la conversion standard, donc une image à trois canaux repasse de YCbCr à RGB et une image à quatre canaux repasse de YCCK à CMYK. Le paramètre est ignoré pour les images à un et deux canaux. La table 13 pose aussi une règle de précédence facile à rater : quand les données encodées portent un marqueur Adobe avec son propre code de transformation, ce code gouverne et l'entrée du dictionnaire est ignorée. Seul un JPEG sans ce marqueur retombe sur le dictionnaire, et quand l'entrée est absente aussi, une image à trois canaux prend la transformation par défaut et une image à quatre canaux n'en prend aucune
L'erreur facile, c'est un chemin d'image qui accepte le dictionnaire de paramètres sans jamais le passer au décodeur JPEG. Un JPEG RGB d'un pixel portant la couleur (128, 63, 31) l'expose aussitôt : un tel décodeur renvoie [128, 63, 31] pour /ColorTransform 0 comme pour /ColorTransform 1, alors que la réponse correcte pour zéro est le triplet YCbCr brut [79, 101, 163]
HotPDF applique le paramètre au niveau des octets. HPDFDecodeHeadlessTerminalImage parcourt d'abord la structure de segments JPEG jusqu'au marqueur start-of-scan et cherche un segment Adobe APP14 ; des octets qui y ressemblent seulement, au milieu d'un segment de commentaire, ne comptent pas. Si les données portent le marqueur, son code de transformation décide et la valeur du dictionnaire est ignorée. Sinon, le décodeur construit une copie privée du JPEG avec un segment APP14 inséré juste avant le marqueur start-of-scan, portant le code de transformation 0, 1, ou, pour une image à quatre canaux avec valeur 1, le code YCCK 2. Chaque fois que la transformation effective d'une image à trois canaux est 0, la copie désarme aussi l'en-tête JFIF, car un en-tête JFIF à lui seul dit à libjpeg-turbo de supposer YCbCr. Le tampon de l'appelant n'est jamais touché, et quand un segment est inséré, ses 16 octets en plus sont décomptés du budget d'octets de travail avant toute allocation du décodeur
Insérer seulement quand aucun marqueur n'existe compte, à cause d'un détail de libjpeg : il utilise le dernier segment APP14 qu'il voit. Insérez un segment après un marqueur existant et une valeur explicite du dictionnaire prime silencieusement sur un marqueur conflictuel dans les données, exactement l'inverse de la table 13. HotPDF applique l'ordre de la table 13 sur le chemin d'image XObject complet comme sur le chemin d'image inline
Vous pouvez appeler le même décodeur terminal directement quand une seule image semble fautive et que vous voulez voir ses échantillons sans rendre la page. La fonction vit dans l'unité HPDFHeadlessImageCodecs, prend le nom du filtre, les octets encodés, un dictionnaire de paramètres optionnel, et la géométrie du dictionnaire d'image, qui doit correspondre à l'en-tête de trame JPEG
uses
  SysUtils, HPDFObjs, HPDFHeadlessImageCodecs;

// ColorTransform < 0 signifie « entrée absente » : laissons les marqueurs JPEG décider
function DecodeDCT(const Encoded: TBytes; Width, Height, Channels,
  ColorTransform: Integer): TBytes;
var
  Parms: THPDFDictionaryObject;
begin
  Parms := nil;
  if ColorTransform >= 0 then
  begin
    Parms := THPDFDictionaryObject.Create(nil);
    Parms.AddNumericValue('ColorTransform', ColorTransform);
  end;
  try
    Result := HPDFDecodeHeadlessTerminalImage('DCTDecode', Encoded, nil, Parms,
      Width, Height, Channels, 8, 64 * 1024 * 1024, nil);
  finally
    Parms.Free;
  end;
end;
Le décodeur est strict sur ce qui compte comme valeur légale. Un -1 explicite, un 2, ou un non-entier tel que 0.5 lève EHPDFHeadlessImageError au lieu de retomber sur un défaut, car une valeur que la spec ne définit pas ne donne au décodeur rien de fiable sur quoi agir. Le contrôle reste en place même quand un marqueur Adobe dans les données rend l'entrée sans objet, car une valeur non définie est une erreur structurelle du document lui-même. Un budget trop petit pour la copie transformée échoue de la même façon, avec un message nommant le budget d'octets de travail
Un null explicite est un autre cas, car ce n'est pas une valeur du tout. L'ISO 32000-1 §7.3.9 dit qu'une entrée de dictionnaire dont la valeur est null équivaut à une entrée absente, donc /ColorTransform null retombe sur le marqueur ou sur le défaut selon le nombre de composantes exactement comme si la clé manquait. HotPDF le traite ainsi sur chaque chemin, headless et VCL, flux et inline de même
Un autre défaut mérite une mention, car c'est là que HotPDF va délibérément au-delà de la lettre de la table 13. Un JPEG à trois composantes sans en-tête JFIF ni marqueur Adobe, dont l'en-tête de trame étiquette les composantes R, G et B, dit dans ses propres octets qu'il contient du RGB. La table 13 le mettrait quand même par défaut en transformation, mais libjpeg et les lecteurs construits dessus le décodent sans transformation, et HotPDF aussi. Les décodeurs headless et VCL le traitent tous les deux ainsi, donc le rouge et le bleu restent où les données les ont mis. Un 0 ou 1 explicite du dictionnaire prime toujours sur cette inférence
uses
  System.IOUtils;

var
  Jpeg, Stored, Converted, ByMarkers: TBytes;
begin
  // octets DCTDecode bruts d'une image CMYK 640 x 480, sauvegardés depuis le flux PDF
  Jpeg := TFile.ReadAllBytes('suspect-image.jpg');
  try
    // Avec un marqueur Adobe APP14 dans les données, les trois appels sont d'accord :
    // le marqueur décide et la valeur du dictionnaire est ignorée
    Stored    := DecodeDCT(Jpeg, 640, 480, 4, 0);   // sans marqueur : échantillons tels que compressés
    Converted := DecodeDCT(Jpeg, 640, 480, 4, 1);   // sans marqueur : YCCK ramené en CMYK
    ByMarkers := DecodeDCT(Jpeg, 640, 480, 4, -1);  // sans marqueur : défaut quatre canaux, aucune
    Writeln(Format('pixel 0: stored %d,%d,%d,%d  converted %d,%d,%d,%d',
      [Stored[0], Stored[1], Stored[2], Stored[3],
       Converted[0], Converted[1], Converted[2], Converted[3]]));
  except
    on E: EHPDFHeadlessImageError do
      Writeln('Decoder refused the image: ', E.Message);
  end;
end;
Un pixel de référence à quatre canaux montre quoi chercher. Un pixel CMYK de (10, 20, 30, 40) stocké en YCCK revient en [245, 235, 225, 215] quand la conversion YCCK n'est pas annulée et en [0, 116, 0, 215] quand elle l'est. L'octet K, 215, est identique dans les deux. Si le plan K semble correct et pas les trois autres, une transformation inadaptée est le premier suspect
La convention CMYK inversée appartient à /Decode
Le décodeur terminal de HotPDF renvoie les échantillons CMYK exactement comme libjpeg-turbo les produit et ne les retourne pas sur la seule foi d'un marqueur Adobe. Les chiffres ci-dessus rendent la convention visible : 245, 235, 225, 215 sont simplement 255 moins 10, 20, 30, 40, la forme inversée que stockent les encodeurs à la Adobe. Les ramener à des quantités d'encre est le travail du dictionnaire d'image, où un producteur qui embarque un tel JPEG devrait écrire /Decode [1 0 1 0 1 0 1 0]. Le renderer applique le tableau /Decode à chaque composante, donc un fichier correctement écrit s'imprime correctement
L'envers de la médaille mérite d'être dit clairement. Un PDF qui embarque un JPEG CMYK inversé à la Adobe sans le tableau /Decode correspondant se rendra en négatif dans HotPDF, parce que le fichier lui-même décrit l'image ainsi. Certains viewers détectent le marqueur APP14 et compensent en silence. HotPDF n'ajoute pas cette heuristique, donc la réparation d'un tel fichier appartient au logiciel qui l'a écrit
Pourquoi un seul dictionnaire DecodeParms pour deux filtres est-il une erreur ?
Un flux dont le /Filter est un tableau de plusieurs étapes doit fournir /DecodeParms comme un tableau de même longueur, un dictionnaire de paramètres ou null par étape. L'ISO 32000-1 §7.3.8.2, table 5, énonce cette règle, et HotPDF l'applique : un flux multi-filtres qui fournit un dictionnaire partagé unique est rapporté comme document invalide au lieu d'être décodé
L'alternative laxiste est pire qu'elle n'en a l'air. Un décodeur qui vérifie la longueur seulement quand /DecodeParms est déjà un tableau réutilisera, devant un dictionnaire unique et deux filtres, ce dictionnaire à chaque étape en silence. C'est inoffensif quand le dictionnaire est vide et destructeur sinon : un /Predictor 12 destiné à l'étape Flate interne s'appliquerait aussi à l'externe, et la sortie devient une poubelle d'apparence plausible plutôt qu'une erreur franche. Comme l'intention d'un tel fichier est irrécupérable, HotPDF le refuse, même dans le cas vide, comme un flux de contenu de page avec /Filter [/FlateDecode /FlateDecode] et /DecodeParms << >>
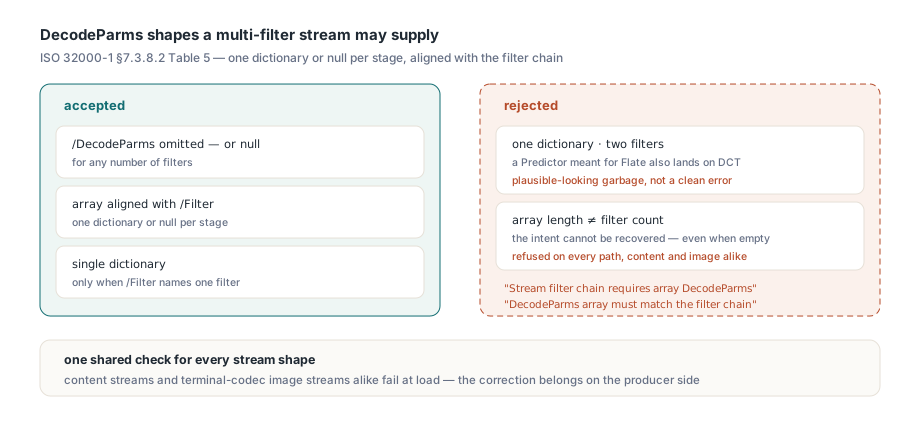
Les formes acceptées et refusées sont faciles à énumérer :
- Accepté :
/DecodeParmsomis, ounull, pour un nombre quelconque de filtres - Accepté : un tableau dont la longueur égale le nombre de filtres, chaque entrée un dictionnaire ou
null - Accepté : un dictionnaire unique quand
/Filternomme exactement un filtre - Refusé : un dictionnaire unique partagé par deux filtres ou plus, avec le diagnostic « Stream filter chain requires array DecodeParms »
- Refusé : un tableau dont la longueur diffère du nombre de filtres, avec « DecodeParms array must match the filter chain »
Le même contrôle tourne pour les flux de contenu ordinaires et pour les flux d'images dont le dernier filtre est un codec terminal tel que DCTDecode, donc une chaîne malformée échoue au même endroit quelle que soit la charge du flux. L'interaction avec les limites de décompression est couverte dans l'article sur les budgets de chaînes de filtres et les bombes de décodage PDF. Depuis le code applicatif, l'erreur surgit quand la page est rendue
uses
  SysUtils, HPDFHeadlessDocument, HPDFHeadlessCairoDevice;

var
  Document: THPDFHeadlessDocument;
  Options: THPDFHeadlessRenderOptions;
  Info: THPDFHeadlessRenderResult;
begin
  Document := THPDFHeadlessDocument.Create;
  try
    try
      Document.LoadFromFile('catalog-cmyk.pdf');
      Options := THPDFHeadlessRenderOptions.Default;
      Info := HPDFRenderHeadlessPagePNGFile(Document.GetRenderAccess(0),
        'page1.png', Options);
      Writeln('images=', Info.Images, ' decoded bytes=', Info.DecodedBytes);
    except
      on E: Exception do
        Writeln('Rejected: ', E.ClassName, ': ', E.Message);
    end;
  finally
    Document.Free;
  end;
end;
Les images JPEG 2000 gardent leur /Decode explicite
Une image JPEG 2000 ignore /Decode seulement quand son dictionnaire n'a pas de /ColorSpace et qu'elle n'est pas un masque d'image. L'ISO 32000-1 §8.9.5 fait de cela une condition, et HotPDF la suit. Jeter le /Decode de chaque image JPX non stencil est le raccourci facile, et il fait simplement disparaître une inversion explicite : un échantillon JPX DeviceGray de 64 sous /Decode [1 0] doit se rendre en 191, pas en 64
Avoir juste cette seule condition ne suffit pas à elle seule. Les branches d'espaces couleur comme Lab et ICCBased qui posent des plages de composantes par défaut dès que l'image est JPX écraseraient une seconde fois un tableau légitimement appliqué, donc le renderer enregistre si un tableau /Decode valide a réellement été appliqué, et ne remplit des plages par défaut que quand aucune ne l'a été. Les plages Lab et ICCBased explicites survivent donc, et la déclaration de couleur du codestream gouverne toujours quand le dictionnaire est muet. Le côté décodeur du format est décrit dans l'article JPEG 2000 et JPXDecode
Quels chemins de décodage suivent ces règles ?
Les deux pipelines les suivent. Côté headless, cela signifie le chargement THPDFHeadlessDocument, le décodeur de flux partagé, et le renderer de pages à base de Cairo derrière HPDFRenderHeadlessPagePNGFile. Côté VCL, cela signifie l'extraction d'images chargées vers un TBitmap et le rendu de pages VCL, qui appliquent le même ordre de la table 13 sur le décodage d'image complète comme de région réduite, donc un en-tête JFIF ne peut pas forcer YCbCr contre une transformation Adobe de 0, et une valeur illégale rend l'image indécodable là aussi. Les images DCT inline suivent les mêmes règles de marqueur, null, défaut et rejet que les images XObjects, avec des noms de clés abrégés comme complets, dont un dictionnaire /DP << … >> et des tableaux de filtres abrégés comme /F [/AHx /DCT], et une image inline aux paramètres illégaux est sautée pendant que le reste de la page se rend. Le guide d'extraction des images d'un PDF chargé couvre le reste de la gestion des filtres de cette API
Quelques notes pratiques avant de compter sur ce comportement :
- Le décodage JPEG exige une bibliothèque TurboJPEG compatible à l'exécution ;
HOTPDF_TURBOJPEG_LIBRARYremplace leturbojpeg.dlloulibturbojpeg.so.0par défaut - Les contrôles structurels stricts rejettent des fichiers que des lecteurs laxistes ouvrent, notamment le dictionnaire
/DecodeParmsvide partagé, et la réparation de ces fichiers est du côté producteur
Pour un workflow d'impression à gestion des couleurs, la leçon pratique est courte. Écrivez des JPEG CMYK avec un /ColorTransform explicite qui concorde avec tout marqueur Adobe dans les données, plus le tableau /Decode qui correspond à leur stockage, donnez à chaque flux multi-filtres un tableau /DecodeParms aligné par étape, et attendez-vous à ce que HotPDF tienne les fichiers à ce qu'ils disent réellement
Le loader headless, les décodeurs de flux et le renderer de pages Cairo montrés ici se livrent avec le composant PDF HotPDF pour Delphi pour Delphi, C++Builder et Lazarus, aux côtés du moteur de documents VCL classique