PDF Library for Delphi écrit des plages d'étiquettes de pages avec AddPageLabels, et depuis la v3.539.10 cet appel marche aussi sur les fichiers chargés dont l'arbre numérique /PageLabels est découpé en nœuds /Kids : la racine est aplatie en une unique feuille /Nums avant que la nouvelle plage n'entre, si bien que l'étiquette apparaît vraiment dans le lecteur au lieu d'être ignorée en silence. La victime typique, c'est un PDF façon livre sorti d'un outil de mise en page, avec des chiffres romains dans les pages liminaires, une numérotation arabe dans le corps et un appendice étiqueté A-1, A-2, où vous vouliez seulement réétiqueter l'appendice et où rien n'a changé
Que sont les étiquettes de pages PDF et comment sont-elles stockées ?
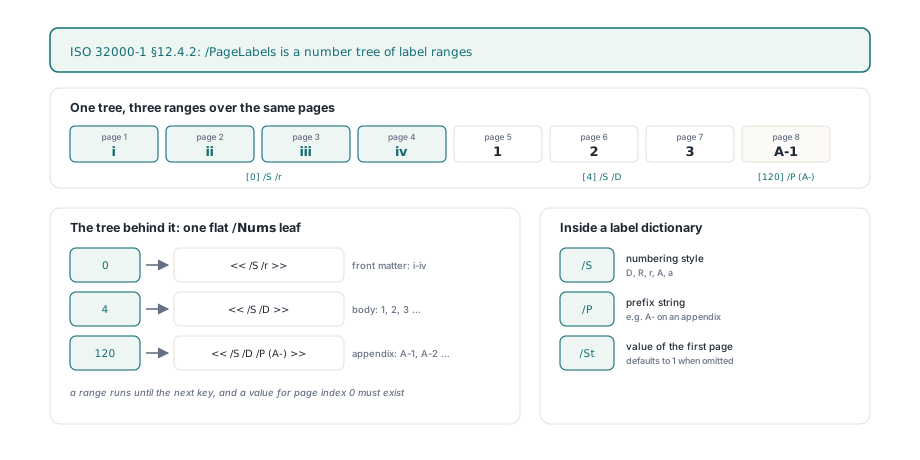
Les étiquettes de pages sont les chaînes qu'un lecteur affiche dans sa boîte de page au lieu de l'index physique de la page, et ISO 32000-1 §12.4.2 les stocke sous forme d'arbre numérique sous la clé de catalogue /PageLabels. Chaque clé est un index de page à base zéro qui démarre une plage d'étiquetage, et chaque valeur est un dictionnaire d'étiquette avec au plus trois entrées : /S pour le style de numérotation (D, R, r, A ou a), /P pour une chaîne de préfixe, et /St pour la valeur numérique de la première page de la plage, qui vaut 1 par défaut. Une plage court jusqu'à la clé suivante, et la spécification exige que l'arbre contienne une valeur pour l'index de page 0, si bien que chaque page est couverte par quelque plage
var
  Lib: TPDFlib;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('handbook.pdf', '') <> 1 then
      Exit;
    // Pages 1-4 : i, ii, iii, iv (romain minuscule)
    Lib.AddPageLabels(1, 3, 1, '');
    // Pages 5-120 : 1, 2, 3 ... (décimal)
    Lib.AddPageLabels(5, 1, 1, '');
    // Pages 121 et suivantes : A-1, A-2 ... (décimal avec préfixe)
    Lib.AddPageLabels(121, 1, 1, 'A-');
    WriteLn(Lib.GetPageLabel(5));    // 1
    WriteLn(Lib.GetPageLabel(122));  // A-2
    Lib.SaveToFile('handbook-labeled.pdf');
  finally
    Lib.Free;
  end;
end;
TPDFlib.AddPageLabels(Start, Style, Offset, Prefix) fait correspondre ses arguments à ce dictionnaire sans surprises dès que vous connaissez trois règles. Start est à base 1 comme tout autre argument de page dans la bibliothèque, et il est écrit dans l'arbre sous la forme Start - 1. Style va de 0 à 5, où 0 signifie préfixe seul et 1 à 5 deviennent les valeurs /S D, R, r, A et a ; tout ce qui sort de cet intervalle renvoie 0 et ne touche à rien. Offset ne devient /St que s'il est supérieur à zéro, donc passer 0 omet simplement la clé et le lecteur retombe sur la valeur par défaut 1. Comme les étiquettes de pages sont arrivées avec PDF 1.3, l'appel exécute aussi EnsureMinVersion('1.3', '/PageLabels'), qui remonte la version de sortie d'un fichier plus ancien sauf si vous avez explicitement verrouillé la version de sauvegarde
Pourquoi les nouvelles étiquettes disparaissent-elles quand l'arbre a des /Kids ?
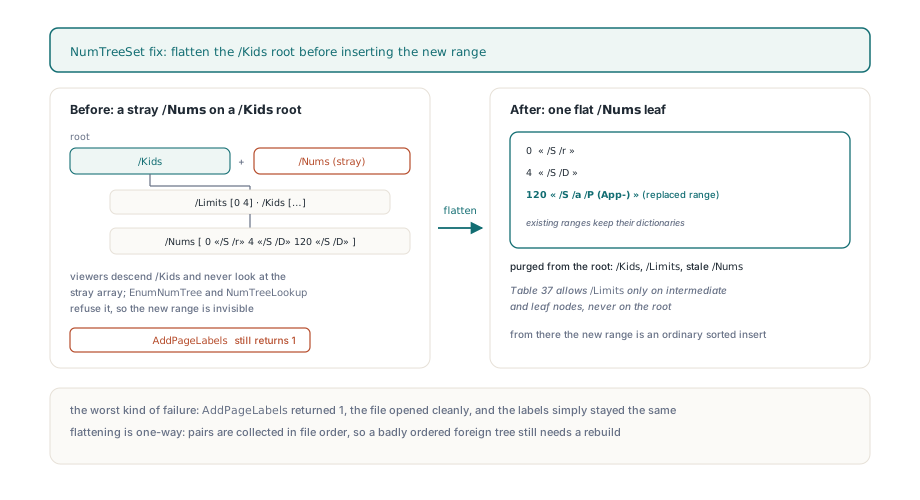
Les nouvelles étiquettes disparaissent parce que ISO 32000-1 §7.9.7 (Table 37) impose à la racine d'un arbre numérique de porter soit /Kids soit /Nums, jamais les deux, et que l'ancien helper NumTreeSet ne savait chercher que /Nums. Les producteurs qui émettent de longs documents découpent souvent l'arbre en nœuds intermédiaires, chacun avec une paire /Limits, et les suspendent à une racine qui n'a que des /Kids. L'ancien code ne trouvait pas de /Nums sur cette racine, en créait un neuf à côté des /Kids existants, et insérait la nouvelle plage là. Le résultat était une racine avec deux points d'entrée mutuellement exclusifs. Les lecteurs descendent par les /Kids et ne regardent jamais le tableau égaré, l'EnumNumTree de la bibliothèque vérifie aussi les /Kids d'abord, et NumTreeLookup refuse un nœud où HasKids xor HasNums est faux. AddPageLabels renvoyait toujours 1 et le fichier sauvegardé s'ouvrait toujours proprement, ce qui est la pire espèce d'échec : rien ne se plaint, les étiquettes restent juste les mêmes
Le correctif dans NumTreeSet convertit la racine en feuille avant d'insérer quoi que ce soit. Quand la racine porte des /Kids, EnumNumTree parcourt chaque feuille dans l'ordre et collecte chaque paire clé-valeur, un nouveau tableau plat /Nums est bâti à partir de cette liste, et /Kids, /Limits et tout /Nums périmé sont purgés de la racine avant que le tableau plat ne soit attaché. Supprimer /Limits n'est pas cosmétique, puisque la Table 37 n'autorise cette entrée que sur les nœuds intermédiaires et les feuilles, jamais sur la racine. À partir de là, l'insertion est une insertion triée ordinaire dans un seul tableau, et les plages existantes survivent avec leurs dictionnaires d'étiquette d'origine. Le compromis est délibéré : l'arbre n'est pas reconstruit ensuite en nœuds /Kids équilibrés. Pour des étiquettes de pages, cela ne coûte rien, parce que même un gros manuel de référence a rarement plus de quelques dizaines de plages, et une feuille unique est ce que la plupart des producteurs écrivent de toute façon
// Réétiqueter l'appendice dans un fichier dont la racine /PageLabels utilise /Kids
if Lib.LoadFromFile('vendor-manual.pdf', '') = 1 then
begin
  WriteLn('Before: ', Lib.GetPageLabel(121));  // p. ex. A-1
  // Remplacer la plage qui démarre à la page 121 : App-a, App-b ...
  if Lib.AddPageLabels(121, 5, 1, 'App-') = 1 then
    Lib.SaveToFile('vendor-manual-relabeled.pdf');
  // Les plages romaine et décimales existantes restent dans la feuille aplatie
  WriteLn('After: ', Lib.GetPageLabel(121));   // App-a
  WriteLn('Front: ', Lib.GetPageLabel(2));     // ii, inchangé
end;
Comment un tableau /Nums peut-il être mal lu comme des clés ?
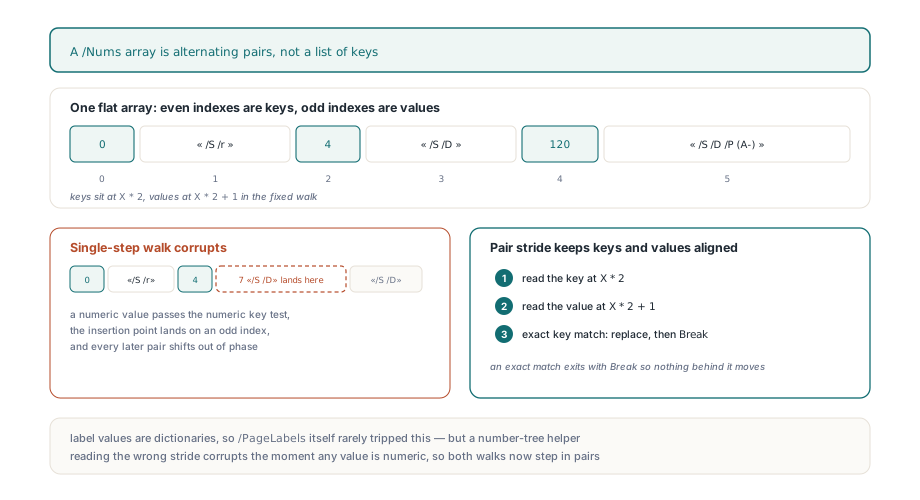
Un tableau /Nums est mal lu quand le code le parcourt un élément à la fois, parce que ce tableau est une suite plate de paires alternées, [key0 value0 key1 value1 ...], et que seules les positions paires sont des clés. La boucle de l'ancien NumTreeSet testait le type numérique de chaque élément, si bien qu'une valeur qui tombait être un nombre était comparée comme si c'était une clé ; un coup de inférieur-à pouvait placer le point d'insertion sur un index impair et lâcher la nouvelle paire au milieu d'une paire existante, décalant toutes les paires suivantes hors phase. EnumNumTree avait le même parcours à pas simple. Les deux itèrent maintenant les paires avec un pas de deux, en lisant la clé à X * 2 et la valeur à X * 2 + 1, et une correspondance exacte de clé remplace la valeur et sort avec Break. À décharge, les valeurs d'étiquettes de pages sont des dictionnaires, donc ce second bug se déclenchait rarement sur /PageLabels lui-même, mais un helper d'arbre numérique qui lit le mauvais pas est corrompu dès qu'une valeur est numérique, et il a été corrigé dans la même passe
Relire les étiquettes et faire des allers-retours
TPDFlib.GetPageLabel(Page) renvoie l'étiquette d'une page à base 1 et a deux replis à connaître. Sans aucune entrée /PageLabels, il renvoie le numéro de page décimal, donc un appelant peut l'utiliser sans condition. Avec un arbre présent mais aucune plage couvrant la page, il renvoie une chaîne vide, ce qui est exactement ce qui arrive quand un fichier saute l'entrée d'index 0 obligatoire ; la documentation de référence dit qu'une plage démarrant à la page 1 doit exister pour que les étiquettes s'affichent correctement, et le code rend cette exigence visible. Les styles de lettres suivent la spécification plutôt que les colonnes de tableur : après Z vient AA, puis BB, en répétant la lettre au lieu de propager une retenue
var
  P: Integer;
  Data: WideString;
begin
  // Audit rapide de ce qu'un lecteur affichera dans sa boîte de page
  for P := 1 to Lib.PageCount do
    WriteLn(P, ' -> ', Lib.GetPageLabel(P));

  // La valeur d'option 4 exporte uniquement les plages d'étiquettes en enregistrements PageLabelBegin
  Data := Lib.ExportDocumentData(4);
  // L'import les rejoue via ClearPageLabels + AddPageLabels
  Lib.ImportDocumentData(Data, 0);
end;
Pour les éditions en masse, ExportDocumentData avec la valeur d'option 4 écrit chaque plage en un bloc PageLabelBegin avec des lignes PageLabelNewIndex, PageLabelStart, PageLabelPrefix et PageLabelNumStyle, et ImportDocumentData traite le premier enregistrement d'étiquette aperçu comme un remplacement complet : il appelle ClearPageLabels une fois puis passe chaque enregistrement à AddPageLabels. Cela rend un aller-retour texte déterministe même quand le fichier d'origine utilisait un arbre /Kids, parce que l'effacement retire toute l'entrée du catalogue et que l'arbre reconstruit est une feuille unique dès le départ
Qu'est-ce que le correctif ne garantit toujours pas ?
L'aplatissement est à sens unique et fait confiance à l'ordre qu'il trouve. EnumNumTree collecte les paires dans l'ordre du fichier, et GetPageLabel applique la dernière plage dont la clé est inférieure ou égale à l'index de la page, donc un fichier étranger dont les feuilles sont en désordre — ce que §7.9.7 interdit mais qui circule quand même — peut encore produire de mauvaises étiquettes tant que vous n'avez pas reconstruit les plages avec ClearPageLabels et de nouveaux appels AddPageLabels. Les étiquettes sont aussi liées aux index de pages, pas aux objets page, donc toute opération qui change le nombre de pages ou l'ordre laisse les plages où elles étaient. Un échange sur place comme remplacer des pages en préservant les numéros d'objets garde le compte et donc les étiquettes alignées, alors qu'un merge comme l'interclassement de scans recto-verso entrelacés produit une nouvelle séquence de pages qui mérite un jeu de plages fraîchement écrit
Les appels d'étiquettes de pages, la gestion d'arbre numérique et l'export et l'import de données de document décrits ici sont tous livrés dans PDF Library for Delphi pour Delphi, C++Builder et Lazarus, avec l'entrée de référence de AddPageLabels documentant les valeurs de style et les codes de retour