PDFlibPas, la PDF Library losLab pour Delphi, parcourt les arbres de noms et les arbres de nombres PDF avec une pile explicite et un ensemble de visités depuis v3.539.45, si bien que des /Kids cycliques, des enfants partagés et des arbres profonds de milliers de niveaux n’épuisent plus la pile d’appels ni ne dupliquent d’entrées. Depuis v3.539.51, une paire /Limits absente, mal formée ou inversée ne masque plus jamais une branche qui détient la clé. Destinations nommées, étiquettes de page, pièces jointes et JavaScript au niveau document passent tous par ces deux chemins de code, ce qui en fait une partie de la surface d’attaque de tout PDF que vous n’avez pas produit vous-même
Le déclencheur est rarement exotique. Un fuzzer, un téléversement hostile ou une sauvegarde incrémentale buggée écrit une entrée /Kids qui pointe vers un ancêtre, et un parcours récursif meurt d’un débordement de pile sur un fichier de deux kilooctets. L’échec le plus discret est une recherche qui fait confiance à un tableau /Limits cassé et répond « introuvable » pour une destination parfaitement présente
Où les arbres de noms et les arbres de nombres apparaissent-ils dans un PDF ?
Les arbres de noms et les arbres de nombres apparaissent partout où un PDF associe un grand ensemble de clés à des objets, et PDFlibPas en lit au moins quatre via des API publiques. ISO 32000-1 §7.9.6 définit l’arbre de noms (clés chaînes, Table 36) et §7.9.7 l’arbre de nombres (clés entières, Table 37). Ce sont des arbres à peu près équilibrés dont les nœuds racine et intermédiaires portent /Kids, dont les feuilles portent les paires clé/valeur triées dans /Names ou /Nums, et dont les nœuds non racines portent un tableau /Limits à deux éléments avec la plus petite et la plus grande clé en dessous d’eux
| Arbre | Où il se trouve | Spécification | API de lecture PDFlibPas |
|---|---|---|---|
| Destinations nommées | /Dests dans le dictionnaire des noms | §12.3.2.3 | GetNamedDestination, puis GetDestPage / GetDestType |
| Étiquettes de page | /PageLabels dans le catalogue (arbre de nombres) | §12.4.2 | GetPageLabel |
| Pièces jointes | /EmbeddedFiles dans le dictionnaire des noms | §7.7.4, §7.11.4 | EmbeddedFileCount, GetEmbeddedFileStrProperty |
| JavaScript au niveau document | /JavaScript dans le dictionnaire des noms | §7.7.4 | GlobalJavaScriptCount, GlobalJavaScriptPackageName |
Deux détails de cette table sont faciles à rater. Les destinations nommées ont aussi une forme PDF 1.1 plus ancienne, un simple dictionnaire /Dests dans le catalogue indexé par des objets name, et GetNamedDestination consulte d’abord ce dictionnaire avant de descendre dans l’arbre de noms PDF 1.2. Et GetDocJavaScript n’est pas du tout un lecteur d’arbre de noms : il renvoie les scripts attachés aux déclencheurs document du dictionnaire /AA du catalogue (WS, DS, WP, DP, DC), tandis que les paquets de scripts nommés qui s’exécutent à l’ouverture d’un document vivent dans l’arbre de noms /JavaScript
Chaque octet de ces structures vient du fichier. La spécification dit ce qu’un rédacteur doit produire ; elle ne peut pas empêcher un lecteur de recevoir autre chose, ce qui est la même leçon que le durcissement d’un parseur PDF Pascal contre les fichiers malveillants, appliquée ici à la forme de l’arbre plutôt qu’aux tailles de tampons
Pourquoi un tableau /Kids cyclique plante-t-il un parcours récursif d’arbre ?
Un tableau /Kids cyclique plante un parcours récursif parce que rien dans la récursion ne remarque qu’elle a déjà vu un nœud, si bien qu’un enfant qui référence son propre ancêtre transforme un fichier fini en descente infinie. Avant v3.539.45, NameTreeLookup, NumTreeLookup, EnumNumTree et le TPDFNameTree.ProcessNode interne s’appelaient tous eux-mêmes une fois par enfant. Une seule auto-référence suffisait à tuer le processus, et un arbre légitime mais très profond pouvait faire pareil sans aucun cycle
Une variante plus douce corrompt les résultats au lieu de planter. Quand deux entrées /Kids référencent la même feuille, une énumération naïve la visite deux fois, et un compte de pièces jointes ou une liste de paquets de scripts rapporte des entrées qui n’existent pas
La correction remplace la récursion par une pile explicite dernier entré premier sorti sur le tas et un ensemble de visités indexé par identité de dictionnaire. Un nœud est marqué quand il est dépilé, pas quand il est empilé, si bien qu’une référence cyclique peut siéger brièvement dans la pile mais est jetée dès qu’elle remonte. Chaque nœud distinct déploie ses enfants exactement une fois, ce qui borne le travail total par le nombre de dictionnaires distincts plus la longueur totale de leurs tableaux /Kids. La profondeur cesse de compter : une chaîne de 4 096 niveaux n’est que 4 096 itérations d’une boucle et 4 096 entrées dans un hash set
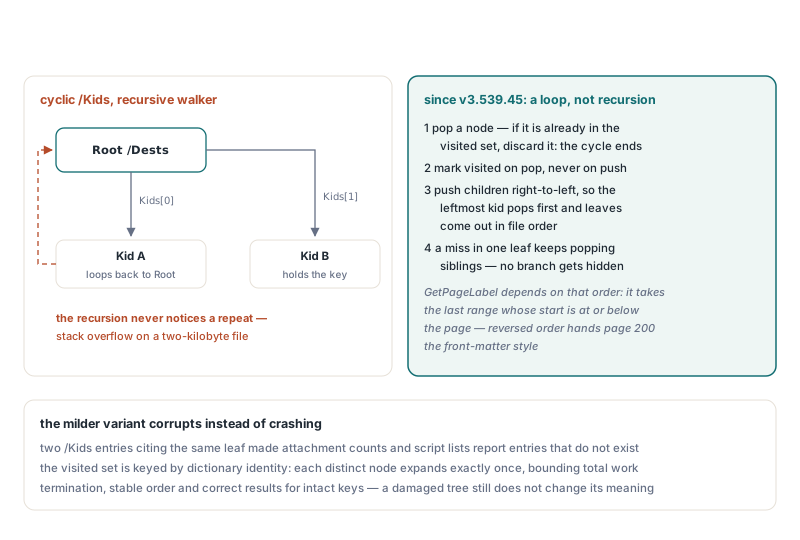
L’ordre compte toujours pourtant, et il faut alimenter la pile à l’envers pour le garder. Les enfants sont empilés du dernier index vers le premier, si bien que l’enfant le plus à gauche est dépilé en premier et que les feuilles sortent dans le même ordre de gauche à droite que celui écrit par le producteur. GetPageLabel en dépend : il parcourt chaque plage énumérée et applique la dernière dont l’index de départ est au plus celui de la page, donc inverser l’énumération remettrait en silence le style des pages liminaires à la page 200. Le squelette ci-dessous montre le motif sur un type de nœud abstrait, indépendant de tout modèle objet PDF
uses
  System.Generics.Collections;

type
  TTreeNode = class
  public
    Kids: TArray<TTreeNode>;   // vide sur une feuille
    Keys: TArray<string>;      // clés de feuille, triées par un producteur sage
    Values: TArray<Integer>;   // parallèle à Keys
    HasLimits: Boolean;
    LoKey, HiKey: string;
  end;

// /Limits est un indice : seule une paire bien formée et ordonnée peut élaguer
function LimitsExclude(Node: TTreeNode; const Key: string): Boolean;
begin
  Result := Node.HasLimits and (Node.LoKey <= Node.HiKey) and
    ((Key < Node.LoKey) or (Key > Node.HiKey));
end;

function FindValue(Root: TTreeNode; const Key: string;
  out Value: Integer): Boolean;
var
  Pending: TList<TTreeNode>;
  Visited: TDictionary<TTreeNode, Byte>;
  Node: TTreeNode;
  I: Integer;
begin
  Result := False;
  Value := 0;
  if Root = nil then
    Exit;
  Pending := TList<TTreeNode>.Create;
  Visited := TDictionary<TTreeNode, Byte>.Create;
  try
    Pending.Add(Root);
    while Pending.Count > 0 do
    begin
      Node := Pending[Pending.Count - 1];
      Pending.Delete(Pending.Count - 1);
      if Visited.ContainsKey(Node) then
        Continue;                      // cycle ou enfant partagé : déjà vu
      Visited.Add(Node, 0);
      if Length(Node.Kids) > 0 then
      begin
        // Empilez de droite à gauche pour dépiler d’abord le kid le plus à gauche
        for I := High(Node.Kids) downto 0 do
          if (Node.Kids[I] <> nil) and not LimitsExclude(Node.Kids[I], Key) then
            Pending.Add(Node.Kids[I]);
      end
      else
        for I := 0 to High(Node.Keys) do
          if (Node.Keys[I] = Key) and (I <= High(Node.Values)) then
          begin
            Value := Node.Values[I];
            Exit(True);
          end;
      // Un raté dans cette feuille n’est pas un verdict : continuez à dépiler
    end;
  finally
    Visited.Free;
    Pending.Free;
  end;
end;
Pourquoi une recherche ne peut-elle pas s’arrêter à la première branche correspondante ?
Une recherche ne peut pas s’arrêter à la première branche dont la plage correspond, parce que les plages /Limits d’un vrai fichier peuvent se chevaucher ou mentir, et la branche qui revendique la clé n’est pas forcément celle qui la détient. Les recherches d’avant v3.539.45 posaient un drapeau Found sur le premier enfant dont les /Limits couvraient la clé, descendaient dedans, et ne regardaient plus aucun autre frère. Si cet enfant se révélait vide, périmé ou une boucle vers la racine, la réponse était nil, même quand le frère suivant tout de suite détenait la clé
Le FindTreeValue réécrit, qui porte désormais NameTreeLookup et NumTreeLookup, empile tout enfant dont la plage n’exclut pas la clé et continue de dépiler jusqu’à trouver une correspondance ou vider la pile. Un raté dans une feuille n’est qu’un raté dans une feuille. Dans un arbre bien formé ça ne coûte rien de plus ; dans un arbre endommagé ça coûte quelques visites de nœuds de plus et renvoie la bonne réponse
La recherche dans la feuille suit la même philosophie. ISO 32000-1 exige que les clés d’un tableau /Names soient triées par valeur d’octet, donc la feuille est d’abord fouillée par recherche dichotomique. Si ça échoue, PDFlibPas retombe sur un balayage linéaire des paires, parce qu’une feuille désordonnée rendrait sinon une clé présente invisible. Le tri est un chemin rapide, pas un filtre
La recherche refuse aussi de deviner face à une contradiction structurelle. La Table 36 laisse un nœud porter soit /Kids soit /Names, jamais les deux, et le chemin de recherche traite un nœud qui porte les deux comme mal formé et le saute plutôt que de choisir une interprétation. Les chemins d’énumération comme EnumNumTree sont plus tolérants et suivent /Kids quand les deux sont présents
À quoi un lecteur peut-il faire confiance avec /Limits ?
Un lecteur ne peut faire confiance à /Limits que pour épargner du travail, jamais pour décider qu’une clé est absente, et seulement quand la paire est bien formée. La Table 36 dit que les nœuds intermédiaires et les feuilles doivent porter /Limits comme un tableau à deux éléments des clés la plus petite et la plus grande, mais en pratique l’entrée disparaît après des éditions à la main, contient des nombres dans un arbre de noms, ou arrive avec ses bornes inversées. PDFlibPas v3.539.45 et v3.539.51 règlent chaque cas de la même façon : si la plage ne se lit pas comme une paire ordonnée du bon type, l’enfant reste cherchable
/Limitsabsents : l’ancien contrôle de plage renvoyait False et l’enfant était sauté purement et simplement, si bien qu’un producteur qui oubliait l’entrée rendait tout son sous-arbre inatteignable. Depuis v3.539.45, l’enfant est fouillé- Mauvais type ou mauvaise longueur, comme des nombres dans un arbre de noms ou un tableau à un élément : traité exactement comme une entrée absente depuis v3.539.45
- Bornes inversées comme
[(Z) (A)]ou[9 0]: v3.539.45 les utilisait encore, et aucune clé ne peut satisfaireLo <= Key <= HiquandLo > Hi, donc la branche était exclue pour toute recherche. Depuis v3.539.51, une plage ne sert à l’élagage que si sa borne basse ne dépasse pas sa borne haute - Bien formée, ordonnée et correcte : sert à sauter la branche, ce qui est tout l’intérêt de l’entrée
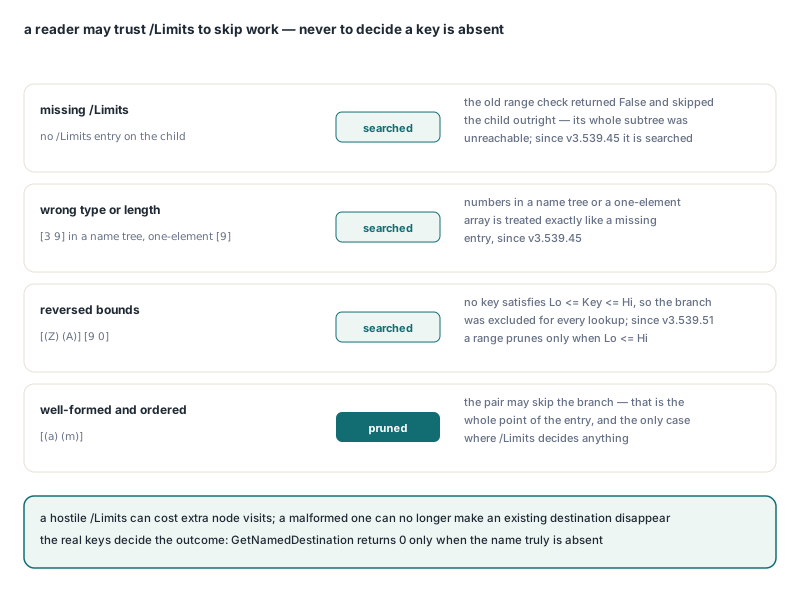
Les vraies clés tranchent dans tous les cas. Des /Limits hostiles peuvent faire visiter à PDFlibPas plus de nœuds que nécessaire, mais des /Limits mal formés ne peuvent plus faire disparaître une destination existante. Côté appelant, rien ne change : GetNamedDestination renvoie 0 quand le nom est réellement absent et un ID de destination sinon, et les fonctions de destination prennent le relais
uses
  PDFlibrary;

procedure LookUpDestination(const FileName, DestName: string);
var
  Lib: TPDFlib;
  DestID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
    begin
      WriteLn('Load failed, error ', Lib.LastErrorCode);
      Exit;
    end;
    // /Dests du catalogue (PDF 1.1) d’abord, puis l’arbre de noms /Dests
    DestID := Lib.GetNamedDestination(DestName);
    if DestID = 0 then
      WriteLn('No destination named ', DestName)
    else if Lib.GetDestPage(DestID) = 0 then
      WriteLn(DestName, ' exists but does not resolve to a page')
    else
      WriteLn(DestName, ' -> page ', Lib.GetDestPage(DestID),
        ', view type ', Lib.GetDestType(DestID));  // 1 = XYZ, 2 = Fit ...
  finally
    Lib.Free;
  end;
end;
Passée sur un fichier fait main dont la racine /Dests a un enfant qui reboucle vers la racine sous une plage [(a) (z)] et un second enfant détenant la vraie entrée sous des limites inversées [(z) (a)], cette procédure résout la destination vers la page 2 avec le type de vue 2 (Fit). Avant v3.539.45, la même recherche renvoyait 0, parce que l’enfant bouclé revendiquait la clé en premier et que la fouille n’atteignait jamais son frère ; v3.539.45 seul renvoyait encore 0, parce que la plage inversée excluait la vraie feuille. Si vous lisez ensuite le outline qui pointe vers ces destinations, l’article compagnon sur la lecture des actions de signets et d’annotations PDF en Delphi couvre le côté actions
Comment une feuille de 32 769 noms a-t-elle cassé TPDFNameTree ?
Une feuille de 32 769 paires nom/valeur a cassé TPDFNameTree parce que son FindIndex interne tassait deux nombres dans un seul Integer 32 bits : la position de la feuille dans la liste de tableaux interne dans les 16 bits hauts et l’offset d’entrée dans le tableau /Names de cette feuille dans les 16 bits bas. Chaque paire occupe deux cases, donc la 32 769e paire, d’index 32 768, démarre à l’offset 65 536, soit $10000. Cette valeur se propage par retenue dans la moitié haute, et le décodeur la relisait comme l’offset 0 de la feuille suivante
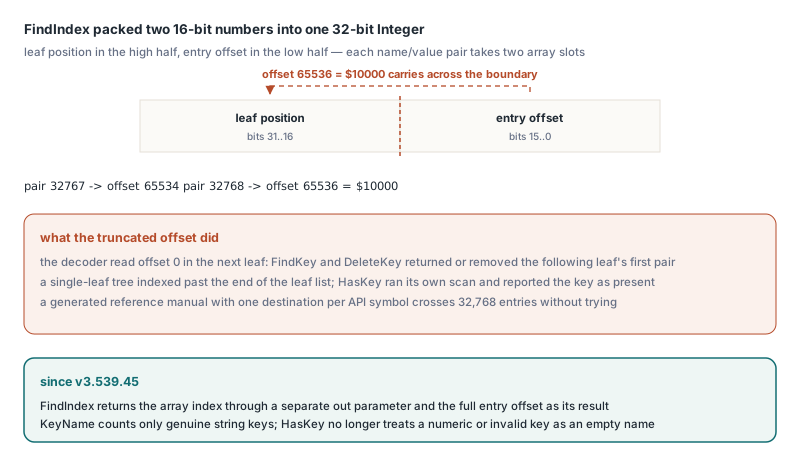
TPDFNameTree est la classe derrière les pièces jointes, les paquets JavaScript globaux et les écritures de destinations nommées, ce qui rend les conséquences concrètes. Dans un arbre à feuille unique, il n’y a pas de feuille suivante, donc FindKey et DeleteKey indexaient au-delà de la fin de la liste de feuilles ; dans un arbre à feuilles multiples, ils renvoyaient ou supprimaient la première paire de la feuille suivante au lieu de celle demandée. Pendant ce temps HasKey menait son propre balayage et déclarait la clé présente, si bien que la classe se contredisait. Un manuel de référence généré avec une destination nommée par symbole d’API dépasse 32 768 entrées sans forcer, et certains producteurs écrivent tout ça dans une seule feuille plate
Depuis v3.539.45, FindIndex renvoie l’index de tableau par un paramètre out séparé et l’offset d’entrée complet en résultat, si bien qu’aucune des deux valeurs n’est tronquée. La même version a resserré deux voisins. KeyName ne compte et ne renvoie plus que les vraies clés chaînes et renvoie une chaîne vide pour un index de 0 ou en dessous, là où il castait auparavant n’importe quel objet suivant une clé invalide. HasKey ne traite plus une clé numérique ou autrement invalide comme un nom vide. Pour une feuille telle que [(Valid) 42 123 456], HasKey('') vaut désormais False et KeyName(2) renvoie une chaîne vide
procedure AuditTrees(const FileName: string);
var
  Lib: TPDFlib;
  I: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
      Exit;
    // Arbre de nombres /PageLabels ; sans lui, numéros de page bruts
    for I := 1 to Lib.PageCount do
      WriteLn('Page ', I, ' label: ', Lib.GetPageLabel(I));
    // Arbre de noms /EmbeddedFiles ; index à partir de 1, clés non chaînes sautées
    for I := 1 to Lib.EmbeddedFileCount do
      WriteLn('Attachment ', I, ': ', Lib.GetEmbeddedFileStrProperty(I, 1),
        ' (', Lib.GetEmbeddedFileStrProperty(I, 2), ')');  // nom, type MIME
    // Arbre de noms /JavaScript : liste les noms de paquets, n’exécute rien
    for I := 1 to Lib.GlobalJavaScriptCount do
      WriteLn('Script package: ', Lib.GlobalJavaScriptPackageName(I));
  finally
    Lib.Free;
  end;
end;
Sur le même fichier fait main, dont la racine /PageLabels liste une feuille deux fois et se référence elle-même, cet audit imprime i et A-1 pour les deux pages, chaque plage une fois, et l’unique paquet de scripts d’un arbre /JavaScript qui pointe aussi vers sa propre racine. Le côté écriture des étiquettes de page a sa propre histoire avec les racines /Kids, traitée dans la correction des étiquettes de page PDF stockées dans des arbres de nombres /Kids ; AddPageLabels aplatit une telle racine avant d’insérer, et il repose sur la même énumération EnumNumTree décrite ici
Que ce durcissement ne garantit-il toujours pas ?
Le durcissement garantit la terminaison, un ordre stable et des résultats corrects pour les arbres dont les vraies clés sont intactes ; il ne fait pas dire à un arbre endommagé ce que son auteur voulait. Plusieurs limites méritent d’être connues avant de bâtir dessus
- L’ensemble de visités fonctionne par identité d’objet. Deux dictionnaires distincts au contenu identique sont deux nœuds, si bien qu’un producteur qui copie une feuille au lieu de la référencer produit toujours des entrées dupliquées
- Des
/Limitsbien formés, ordonnés mais faux élaguent toujours. Un lecteur qui utilise les plages comme optimisation ne peut pas non plus être immunisé contre une plage qui ment de façon plausible ; la seule alternative est d’ignorer/Limitsentièrement et de balayer chaque feuille - L’énumération préserve l’ordre du fichier mais ne trie pas.
GetPageLabelapplique la dernière plage énumérée au plus celle de la page, si bien qu’un producteur qui écrit des plages en désordre obtient une sémantique d’ordre fichier - La mémoire croît avec le nombre de nœuds et d’entrées distincts. Le parcours ajoute une liste et un hash set, rien de plus, mais un arbre de noms de 100 Mo reste un arbre de noms de 100 Mo après le parse
- Les clés dupliquées dans une même feuille ne sont pas rapportées. La recherche dichotomique renvoie la première paire correspondante qu’elle touche ; le repli linéaire garde la dernière correspondance qu’il balaye
Aide-mémoire : lire des arbres PDF de fichiers non fiables
- Passez à v3.539.45 ou ultérieure pour un parcours des arbres de noms et de nombres à l’épreuve des cycles et de la pile, et à v3.539.51 ou ultérieure pour que des
/Limitsinversés ne cachent plus de clés - Traitez un
GetNamedDestinationrenvoyant 0 comme « absent », et unGetDestPagerenvoyant 0 comme « présent mais inutilisable » - Utilisez
GlobalJavaScriptCountetGlobalJavaScriptPackageNamepour l’arbre de noms/JavaScript;GetDocJavaScriptlit les déclencheurs/AAdu catalogue à la place - Indexez les pièces jointes et les paquets de scripts de 1 au compte que la bibliothèque rapporte ; les clés invalides ne sont pas comptées
- Dans votre propre code d’arbre, marquez les nœuds visités au dépilement, empilez les enfants en ordre inverse, et laissez
/Limitsn’élaguer que s’il forme une paire bien typée et ordonnée
Les outils de préflight, les archiveurs et les visualiseurs lisent ces arbres avant tout rendu de page, donc ils doivent survivre à tout ce qui arrive dans une file de téléversement. Les lecteurs d’arbres décrits ci-dessus sont livrés avec PDFlibPas, la PDF Library for Delphi, qui se compile aussi bien en Delphi qu’en Free Pascal