Une sauvegarde PDF qui ne change rien peut quand même corrompre les métadonnées du document de deux façons : quand /CreationDate et /ModDate référencent le même objet chaîne, une mise à jour automatique de ModDate qui écrit dans cet objet réécrit les deux, et quand l'objet XMP est créé avant que le flux /Metadata d'origine ne soit lu, un paquet par défaut remplace l'original. PDF Library for Delphi remplace les références de dictionnaire au lieu de muter des objets partagés, et capture le paquet existant avant l'initialisation paresseuse de XMP
Enregistrer est l'opération la moins intéressante qu'une bibliothèque PDF accomplisse : charger un fichier, l'enregistrer sous un nouveau nom, ne rien toucher entre les deux. Les pages se rendent à l'identique avant et après, et les hachages des flux de contenu concordent. Un fichier peut passer tous ces contrôles et rester faux à deux endroits qu'aucun moteur de rendu ne vous montrerait jamais. Les deux pièges se trouvent dans le chemin lecture-modification-écriture par lequel passe toute édition réelle, donc n'importe quelle sauvegarde suffit à les déclencher, et seul un second analyseur indépendant comparant les sémantiques non visuelles des deux fichiers les révèle
Pourquoi une sauvegarde PDF change-t-elle sa CreationDate ?
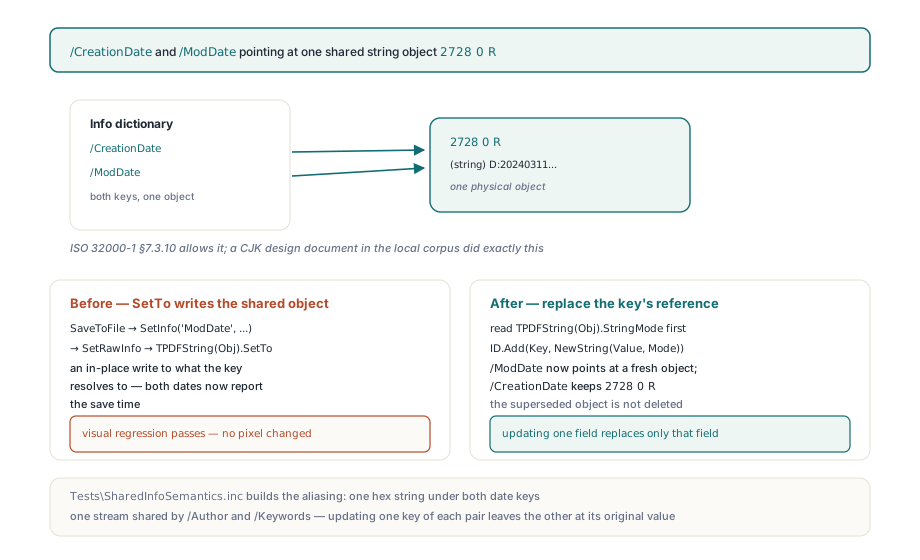
Parce que le dictionnaire d'informations du document a le droit de référencer un même objet chaîne indirect depuis deux clés, et qu'un writer qui met à jour l'objet plutôt que la clé change les deux. ISO 32000-1 §7.3.10 autorise n'importe quelle valeur de dictionnaire à être une référence indirecte, et rien dans la Table 317 de §14.3.3 ne dit que la valeur sous /CreationDate doit être un objet différent de la valeur sous /ModDate. Un producteur qui a écrit deux fois le même horodatage à la création peut, en toute légalité, pointer les deux clés sur un seul 2728 0 R, et des fichiers réels font exactement cela
Le déclencheur est la date de modification automatique. Sauf si UserModDate est défini, SaveToFile appelle SetInfo('ModDate', ...) avec l'heure courante avant d'écrire, ce qui atteint SetRawInfo. Un SetRawInfo naïf cherche l'objet sous la clé et, s'il trouve un TPDFString, appelle SetTo dessus. C'est une écriture en place dans l'objet que la clé résout à cet instant, et quand cet objet est partagé, /CreationDate rapporte l'heure de sauvegarde elle aussi. Le document s'ouvre toujours, s'imprime et se rend pixel pour pixel comme avant, donc une suite de régression visuelle passe sans broncher
var
  Lib: TPDFlib;
  Before, After: WideString;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('design.pdf', '');
    Before := Lib.GetInformation(7);          // 7 = CreationDate, 8 = ModDate
    Lib.SaveToFile('design-resaved.pdf');
    Lib.LoadFromFile('design-resaved.pdf', '');
    After := Lib.GetInformation(7);
    if Before <> After then
      Log('a save that changed nothing rewrote CreationDate');
  finally
    Lib.Free;
  end;
end;
La règle dans TPDFDocument.SetRawInfo est petite et le principe derrière est général : mettre à jour une entrée de dictionnaire remplace la référence de cette entrée, jamais l'objet qu'elle résolvait par hasard. Le code lit le TPDFStringMode existant pour qu'une chaîne hexadécimale reste hexadécimale et qu'une chaîne littérale reste littérale, puis ajoute une chaîne neuve issue de FStructure.NewString(Value, StringMode) sous la clé. Deux autres détails comptent tout autant. Une entrée de type flux est remplacée sans d'abord vider l'ancien flux, parce qu'un SetTo('') dessus viderait la valeur pour toutes les autres clés pointant encore sur ce flux. Et l'objet remplacé n'est pas supprimé, parce que la structure le possède et que d'autres références peuvent encore en avoir besoin
// Naïf : muter l'objet que la clé résout à cet instant
if Obj is TPDFString then
  TPDFString(Obj).SetTo(Value);

// Correct : garder la représentation, ne remplacer que la référence de cette clé
StringMode := smLiteral;
if Obj is TPDFString then
  StringMode := TPDFString(Obj).StringMode;
ID.Add(Key, FStructure.NewString(Value, StringMode));
Un test pour cela doit construire l'aliasing délibérément plutôt que de compter sur un fichier qui partage des objets par hasard : une chaîne hexadécimale référencée par les deux clés de date, une chaîne directe partagée par /Title et /Subject, un flux partagé par /Author et /Keywords. Après mise à jour d'une clé de chaque paire, l'autre doit toujours lire sa valeur d'origine et la chaîne mise à jour doit rester hexadécimale. La référence publique de SetInformation énonce la garantie en une phrase : mettre à jour un champ Info ne remplace que ce champ, même quand d'autres champs référencent le même objet
Pourquoi un paquet XMP existant est-il remplacé par les valeurs par défaut ?
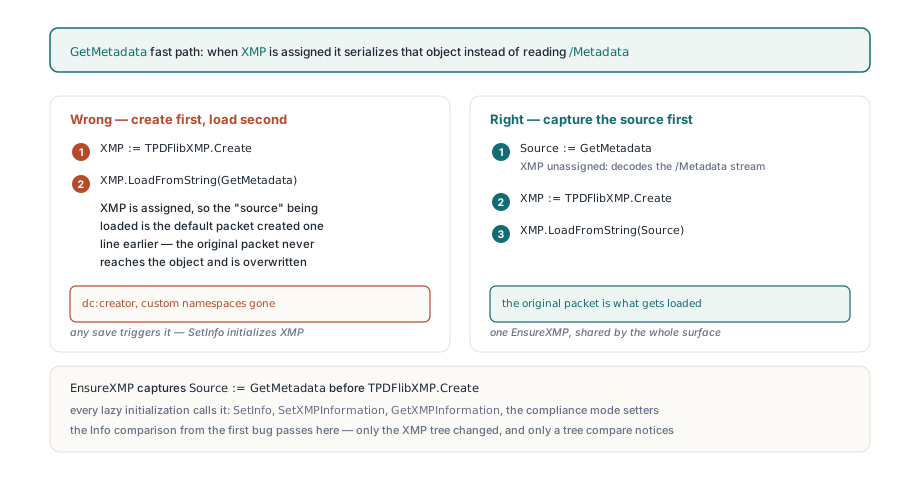
À cause de l'ordre de deux lignes. TPDFDocument.GetMetadata a un chemin rapide : quand le champ XMP est déjà affecté, il renvoie XMP.SaveToString au lieu de décoder le flux /Metadata du catalogue. Une initialisation paresseuse écrite XMP := TPDFlibXMP.Create; XMP.LoadFromString(GetMetadata); se lit naturellement et est fausse : au moment où GetMetadata s'exécute, XMP est affecté, donc la « source » chargée est le paquet par défaut sérialisé d'un objet créé une ligne plus tôt. Le paquet d'origine, avec son dc:creator, ses espaces de noms personnalisés et son éventuelle identification de norme, n'atteint jamais l'objet et est écrasé à la sauvegarde. La même date de modification automatique suffit à le déclencher, parce que SetInfo initialise XMP avant de toucher au dictionnaire Info pour que xmp:ModifyDate reste en phase avec /ModDate. Notez derrière quoi ce piège se cache : la comparaison du dictionnaire Info du premier piège passe, puisque /Author et /Title dans /Info ne sont pas touchés. Seul l'arbre XMP a changé, et seul un contrôle qui analyse et compare cet arbre le remarque
// Faux : GetMetadata sérialise maintenant l'objet créé à la ligne précédente
XMP := TPDFlibXMP.Create;
XMP.LoadFromString(GetMetadata);

// Juste : capturer le flux /Metadata d'abord, puis créer et charger
Source := GetMetadata;
XMP := TPDFlibXMP.Create;
XMP.LoadFromString(Source);
PDF Library for Delphi garde cet ordre à un seul endroit. TPDFDocument.EnsureXMP capture Source := GetMetadata avant TPDFlibXMP.Create, et chaque initialisation paresseuse du document passe par elle : SetInfo, SetXMPInformation, GetXMPInformation, les setters de mode PDF/A, PDF/X, PDF/E, PDF/VT, PDF/VCR et PDF/UA, et le chemin de réparation des métadonnées. Les points d'entrée publics comme SetXMPProperty passent aussi par EnsureXMP, et GetXMPProperty lit via GetDocumentMetadata, donc toute la surface partage un seul ordre d'initialisation. Une seule copie correcte d'une séquence de trois lignes vaut mieux que dix copies qui se trouvent d'accord aujourd'hui
Deux pièges plus petits sur le même chemin
Le sérialiseur XMP sous Windows utilise l'écrivain XML de la plateforme, qui émet une déclaration XML que le paquet ne doit pas porter. La manière évidente de la retirer, effacer des caractères jusqu'à atteindre <?xpacket, échoue sur une entrée valide : ISO 16684-1 §7.3.2 rend le wrapper xpacket facultatif, et un producteur qui écrit un simple élément <x:xmpmeta> reste dans la norme, donc sur un tel paquet cette boucle supprime le document entier, valide. Le sérialiseur localise le ?> fermant de la déclaration et ne retire que cela. Un contrôle de rétention digne d'être copié s'exécute deux fois, une fois avec le wrapper et une fois avec le wrapper retiré, et vérifie qu'un marqueur d'espace de noms personnalisé et l'auteur d'origine survivent à SetInfo, GetMetadata, SaveToString et à un rechargement. Le second piège est un symbole de préprocesseur. NOVCL est défini pour les compilations Free Pascal, mais le backend XMP est conditionné par le système d'exploitation, pas par le framework, puisque PDFlibXMP.pas ne définit NO_XMP que lorsque OS_WINDOWS est absent. Garder la synchronisation Info vers XMP dans SetInfo par NOVCL laisserait une compilation Lazarus Windows avec un objet XMP fonctionnel et un SetInfo qui saute silencieusement sa mise à jour. Le garde est NO_XMP, si bien qu'une application Free Pascal Windows obtient la même synchronisation que Delphi
Comment garder la ModDate d'origine sur une sauvegarde en transit ?
Définissez KeepModDate dans TPDFlibSaveOptions et enregistrez via SaveToFileOptions. L'option définit UserModDate pour la durée de l'appel, et SaveToFile saute alors l'horodatage automatique, qui est aussi l'étape qui initialise paresseusement l'objet XMP. Un document dont vous n'avez jamais touché les métadonnées, et pour lequel aucun mode de conformité n'a été activé, garde son dictionnaire Info et son flux /Metadata tels que chargés. Appeler SetInformation(8, ...) a le même effet de façon permanente, puisque définir vous-même la date de modification la marque comme contrôlée par l'utilisateur
var
  Options: TPDFlibSaveOptions;
begin
  FillChar(Options, SizeOf(Options), 0);
  Options.OptimizeContentStreams := True;
  Options.PackObjectStreams := True;
  Options.KeepModDate := True;      // pas de /ModDate automatique, pas d'init XMP paresseuse
  if Lib.SaveToFileOptions('design-resaved.pdf', Options) <> 1 then
    Log(Format('save failed, LastErrorCode=%d', [Lib.LastErrorCode]));
end;
Soyez honnête sur ce que cela vous achète. KeepModDate est le bon choix pour une étape de transit dont la sortie doit décrire la même révision que son entrée, et c'est le mauvais choix pour tout ce qui édite réellement du contenu, parce que §14.3.3 attend de /ModDate qu'elle reflète la modification la plus récente. Ce n'est pas non plus un substitut à une gestion correcte des références, puisqu'il n'évite que la seule écriture qui déclenche la mise à jour automatique. Remplacer des références au lieu de muter des objets partagés, et capturer le paquet avant l'initialisation, sont ce qui rend une sauvegarde ordinaire sûre ; l'option est ce qui rend un no-op délibéré honnête
Comment vérifier qu'une sauvegarde ne change rien d'autre que la ModDate ?
Pas avec les pixels et pas avec les hachages de flux, parce que les deux pièges laissent chaque page et chaque flux de contenu identiques octet pour octet. Le contrôle qui les attrape est un instantané sémantique non visuel pris par un analyseur indépendant, qui ne partage aucun code avec la bibliothèque testée, depuis le fichier source et depuis le fichier enregistré, suivi d'une comparaison structurelle. L'instantané couvre le dictionnaire Info sans /ModDate, l'arbre des signets avec chaque signet résolu en numéro de page plutôt qu'en numéro d'objet, les destinations nommées et les cibles de liens résolues de la même façon, les valeurs des champs de formulaire, les octets des pièces jointes sous forme de hachages, et le paquet XMP analysé comme un arbre plutôt que comparé comme du texte. Les numéros d'objet n'en font délibérément pas partie, puisqu'une réécriture complète renumérote tout et qu'une comparaison basée sur eux ne rapporterait que du bruit
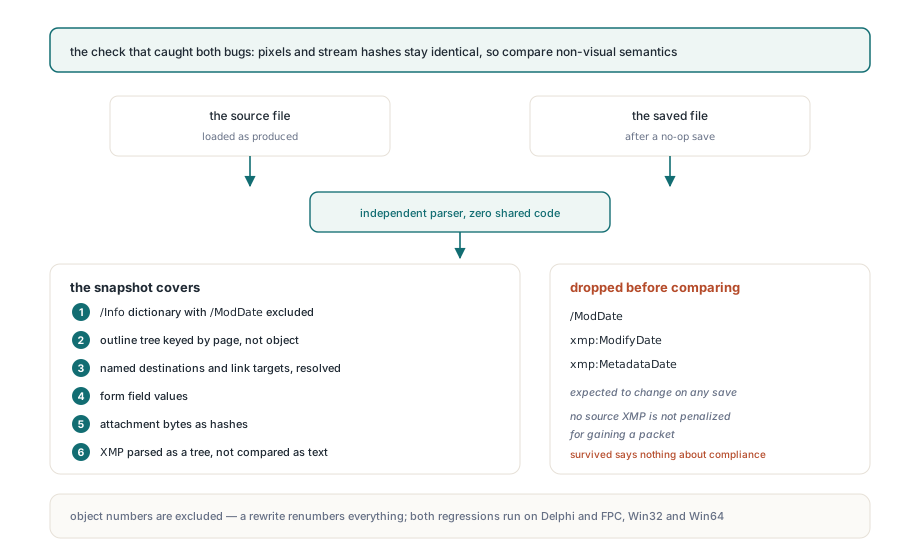
Les exclusions comptent autant que les inclusions. /ModDate, xmp:ModifyDate et xmp:MetadataDate sont censées changer et sont écartées avant la comparaison ; un fichier dont la source ne portait aucun XMP n'est pas pénalisé pour avoir gagné un paquet. Ce que le contrôle ne prétend pas est tout aussi explicite : conserver un paquet existant ne dit rien de la validité de ce paquet au regard du schéma, ni de la conformité du document à PDF/UA ou à une partie PDF/A. Ce sont des questions séparées avec des outils séparés, et confondre « les métadonnées ont survécu » avec « les métadonnées sont conformes » est la manière dont une réécriture de date partagée peut rester cachée longtemps
Si vous travaillez au niveau en dessous de ces règles, la mécanique de la réécriture des objets lors d'une sauvegarde est traitée dans les mises à jour incrémentales et la sauvegarde en ajout seul, qui est le seul mode de sauvegarde où un objet partagé reste simplement là où il était, et dans les niveaux de modification et le diff de révision, qui est l'autre endroit où une date périmée ou réécrite trompe un lecteur. La vue côté réparation de ce même couple Info et XMP, où les deux moitiés sont amenées à s'accorder plutôt que simplement préservées, se trouve dans la conversion en PDF/A et la réparation des métadonnées
PDF Library for Delphi est une bibliothèque PDF Pascal native pour Delphi, C++Builder et Lazarus, et le chemin lecture-modification-écriture décrit ici est celui par lequel passe chaque édition dans votre propre processus, donc les garanties ci-dessus s'appliquent que vous enregistriez une fois ou mille fois par jour — voyez la page produit PDF Library for Delphi pour les compilateurs et plateformes pris en charge