Prenons un fichier dont le dictionnaire d'informations dit /Title (Annual Maintenance Report) alors que son paquet XMP n'a aucun dc:title. Les visionneurs affichent le titre sans broncher, mais un validateur PDF/A rejette le fichier parce que les deux copies de métadonnées divergent. Un second fichier a l'air tout aussi sain mais n'a pas d'entrée pdfaid:part dans son XMP, et le validateur répond avec des dizaines d'erreurs : il juge le fichier comme un PDF ordinaire et rapporte chaque règle de la partie réclamée comme échouée, tout cela pour une ligne manquante
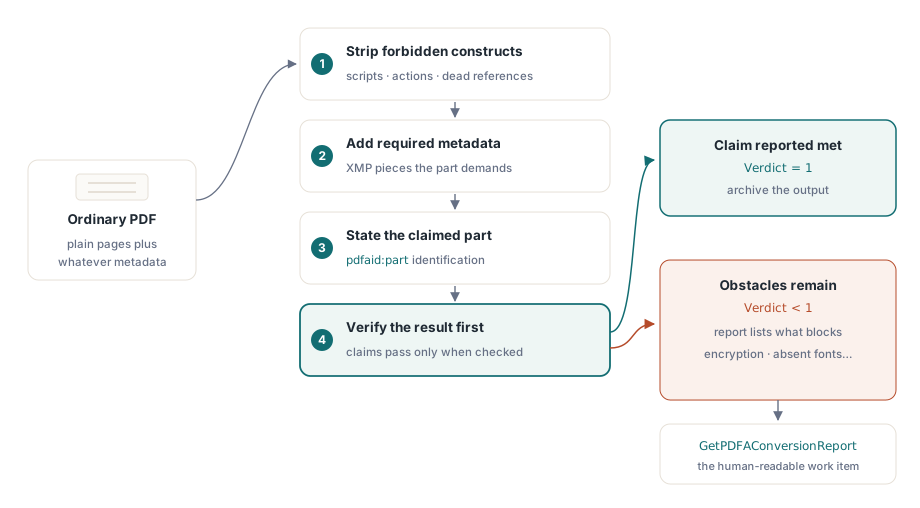
Les deux problèmes demandent des quantités de travail très différentes. Réconcilier les métadonnées est un correctif étroit que vous pouvez faire tourner sur n'importe quel fichier. Transformer un PDF arbitraire en document d'archivage signifie retirer ce que la partie cible interdit, ajouter ce qu'elle exige, énoncer la réclamation, puis valider les octets réellement produits. Nous avons construit la conversion autour de cette dernière étape exprès. ConvertToPDFA, qui part avec l'édition Enterprise (TPDFlibEnterprise) avec GetPDFAConversionReport, enregistre le document converti en mémoire, fait tourner la vérification PDF/A sur ces octets et ne renvoie 1 que quand la vérification passe
Pourquoi un PDF qui s'ouvre bien échoue-t-il à une vérification PDF/A ?
Les deux échecs viennent de règles de métadonnées. Un PDF enregistre titre, auteur, producteur et dates dans le dictionnaire d'informations du document, et PDF/A exige aussi les mêmes faits dans un paquet de métadonnées XMP ; ISO 19005-1 §6.7.3 demande que les deux soient équivalents, et PDF/A-2 et PDF/A-3 gardent la règle. Parmi les fichiers qui échouent sur cette règle, le schéma habituel est un producteur qui a rempli le dictionnaire d'informations sans jamais écrire la moitié XMP, donc le validateur trouve un titre d'un côté et rien de l'autre
L'identification manquante est plus silencieuse. Les entrées pdfaid:part et pdfaid:conformance sont ce qui marque un fichier comme PDF/A, et un fichier peut être parfaitement bien formé sans elles. Le cas que nous voyons le plus souvent est une application qui fournit son propre paquet XMP, remplaçant celui que l'écrivain PDF avait généré ; le paquet personnalisé porte les champs de l'application sans entrées pdfaid, donc la liste d'erreurs ne pointe nulle près de la vraie cause
RepairDocumentMetadata traite les deux cas et renvoie le nombre d'entrées qu'il a changées. Il est disponible dans chaque édition, tout comme SetPDFAMode et SanitizeDocument. La réparation parcourt Title, Author, Subject, Keywords, Creator, Producer, CreationDate et ModDate. Là où seul le XMP porte une valeur, le dictionnaire d'informations est rempli depuis lui, donc rien de déjà enregistré n'est jeté. Là où les deux portent des valeurs et qu'elles diffèrent, le dictionnaire d'informations gagne. Nous avons pris cette décision parce que le dictionnaire d'informations est la moitié que les producteurs positionnent le plus souvent, ce qui en fait la trace la plus probable de ce que l'auteur visait
Si votre XMP est la copie qui fait autorité (disons qu'il a été conservé dans un système de gestion documentaire), poussez les valeurs voulues dans le dictionnaire d'informations avec SetInformation et faites tourner la réparation seulement après. Faire l'inverse écrasera votre titre XMP conservé avec ce que le producteur original avait écrit
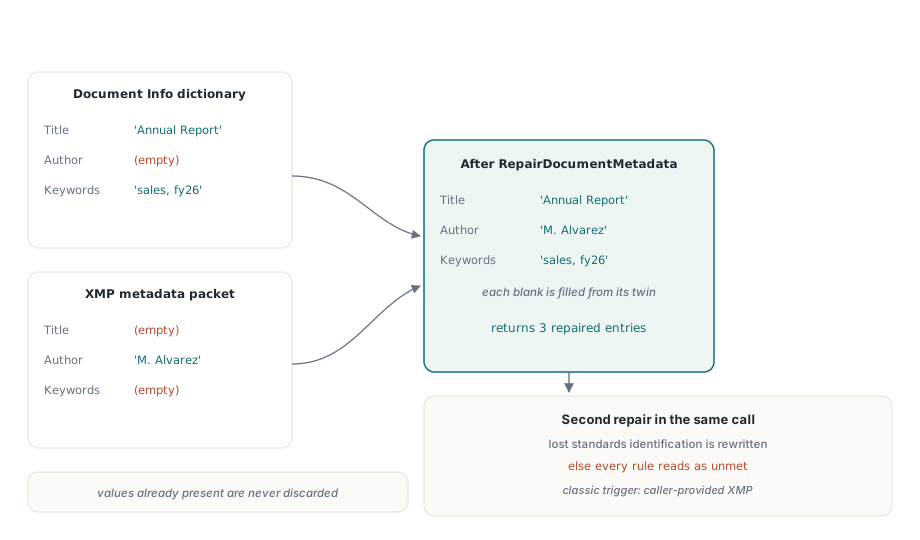
La réparation de l'identification demande une seule chose de vous : le document doit savoir quelle partie il vise. Un fichier fraîchement chargé n'a aucun mode PDF/A positionné, donc appelez SetPDFAMode avant la réparation. Avec un mode en place, RepairDocumentMetadata écrit les entrées pdfaid correspondantes, ajoute pdfaid:rev avec l'année 2020 pour les modes de la partie 4, et positionne dc:format à application/pdf, que les validateurs vérifient aussi
uses
  SysUtils, PDFlibrary;

procedure RepairIncoming(const InName, OutName: string);
var
  Lib: TPDFlib;
  Fixed: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(InName, '') <> 1 then
      raise Exception.CreateFmt('Cannot open %s', [InName]);

    // Le titre conservé va d'abord dans le dictionnaire d'informations,
    // parce que cette copie gagne quand les deux moitiés divergent
    Lib.SetInformation(2, 'Annual Maintenance Report 2025');

    Lib.SetPDFAMode(3);                  // 3 = PDF/A-2b, voir le tableau ci-dessous
    Fixed := Lib.RepairDocumentMetadata;
    Writeln(Format('%d metadata entries brought into agreement', [Fixed]));

    Lib.SaveToFile(OutName);
  finally
    Lib.Free;
  end;
end;
Choisir la partie cible et son numéro de mode
Choisissez la partie selon ce que le document doit transporter, et seulement ensuite cherchez le numéro. SetPDFAMode et ConvertToPDFA partagent un schéma de numérotation, et il ne suit pas l'ordre que les noms de parties laissent croire
| Mode | Partie et niveau | Notes |
|---|---|---|
| 1 | PDF/A-1a | PDF 1.4, balisé |
| 2 | PDF/A-1b | PDF 1.4 |
| 3 | PDF/A-2b | PDF 1.7 |
| 4 | PDF/A-2a | PDF 1.7, balisé |
| 5, 6, 7 | PDF/A-3b, 3a, 3u | Fichiers incorporés de tout type permis |
| 8 | PDF/A-2u | PDF 1.7, texte Unicode exigé |
| 9, 10, 11 | PDF/A-4, 4e, 4f | PDF 2.0 ; 4e ajoute 3D et médias riches, 4f permet les fichiers incorporés |
Le mode 3 est PDF/A-2b et le mode 4 est PDF/A-2a. Cette inversion attrape les gens qui comptent à partir de 1a en supposant que le niveau a mène toujours. PDF/A-2u apparaît à 8, après les modes de la partie 3
Le choix aux vraies conséquences concerne les pièces jointes. Les parties 1 et 2 interdisent les fichiers incorporés, donc ConvertToPDFA les retire pour les modes 1 à 4 et le mode 8. Convertissez une facture Factur-X ou ZUGFeRD en mode 3 et la facture XML structurée disparaît de la sortie, avec la raison d'être du fichier. Pour tout ce qui transporte une pièce jointe, visez le mode 5 (PDF/A-3b), qui est aussi la partie sur laquelle ces formats de facture sont définis, ou le mode 11 si vous avez besoin de PDF 2.0. Chaque pièce jointe d'un fichier de partie 3 ou partie 4 doit énoncer comment elle se rapporte au document via /AFRelationship, et PDF Library for Delphi écrit cette entrée pour chaque fichier incorporé qu'elle enregistre dans ces modes
La partie 4 s'identifie différemment. Elle n'a pas de lettre de conformité pour le PDF/A-4 simple, utilise E ou F pour les deux extensions, et exige pdfaid:rev avec l'année de publication de sa partie. ConvertToPDFA élève le fichier à PDF 2.0 pour les modes 9 à 11, parce que ISO 19005-4 §6.1.2 bâtit la partie sur PDF 2.0, et la vérification juge ces fichiers contre PDF 2.0 au lieu de 1.7
Ce que ConvertToPDFA change dans le fichier
ConvertToPDFA fait une séquence fixe de réparations, note chacune dans un rapport en texte brut, enregistre le résultat en mémoire et valide ces octets. Une vérification échouée renvoie 0, et un mode hors 1 à 11 aussi, qui renvoie avant tout rapport écrit. La séquence vaut d'être connue, parce que chaque étape est quelque chose que la sortie perdra ou gagnera :
- Un document chiffré dont le mot de passe est inconnu arrête la conversion immédiatement avec une ligne
blocked:; rien en son intérieur ne peut être lu, et encore moins réparé - Le JavaScript au niveau du document et l'action d'ouverture qui l'exécute sont retirés, avec chaque entrée d'actions supplémentaires et les types d'actions qu'aucune partie ne permet, parmi eux Launch, Sound, Movie, ResetForm, ImportData, Hide, SetOCGState, Rendition et Trans. Les liens GoTo et URI restent, si bien que la navigation continue de marcher
- Les fichiers incorporés sont retirés pour les parties qui les interdisent, comme décrit plus haut
- Les annotations cachées ou réglées pour ne jamais s'afficher sont supprimées. PDF/A exige que les annotations soient visibles et imprimables, et les révéler changerait l'apparence de la page, donc nous avons choisi la suppression
- Les apparences des champs de formulaire sont régénérées avant que le drapeau
/NeedAppearancesne soit effacé, si bien que les valeurs saisies restent visibles - Les polices utilisées mais non incorporées sont incorporées depuis les polices installées sur la machine
- Les objets que plus rien ne référence sont jetés, et un output intent sRGB est ajouté si le fichier n'en a pas
- Enfin la partie et le niveau sont énoncés dans le XMP, et les octets sont vérifiés
Sur un serveur, l'étape des polices est celle qui fait le plus souvent piétiner une conversion. Un document qui utilise une police inexistante sur l'hôte de conversion ne peut pas être réparé depuis l'intérieur du fichier, et le rapport le dira. Installez sur la machine de conversion les polices que vos documents utilisent réellement ; la visite guidée sur l'incorporation des polices manquantes dans un PDF existant couvre cette étape à part
Comment un travail par lots doit-il traiter une conversion qui échoue ?
Traitez la valeur de retour comme un portail et le rapport comme le bon de travail. Archivez les fichiers qui renvoient 1, et acheminez les autres vers un humain avec le rapport joint. N'enregistrez pas la sortie d'une conversion échouée dans l'archive juste parce qu'elle a l'air plus propre que l'entrée. Ce fichier porte maintenant une réclamation PDF/A que la vérification a refusé de confirmer, ce qui est exactement la situation que l'étape de vérification existe pour empêcher
Le rapport de GetPDFAConversionReport est une ligne par action, chacune commençant par un verbe : removed:, regenerated:, repaired:, embedded:, added:, stated:, plus blocked: si quelque chose a arrêté l'exécution, et une ligne finale result:. La vérification derrière le verdict s'arrête au premier échec, donc quand un fichier échoue, la conversion fait tourner la vérification à nouveau en entier et le rapport montre chaque problème d'un coup. Acheminer sur les préfixes prend quelques lignes
uses
  Classes, SysUtils, PDFlibrary, PDFlibEnterprise;

function ArchiveOne(const InName, ArchiveDir, ReviewDir: string): Boolean;
var
  Lib: TPDFlibEnterprise;
  Report: TStringList;
  I: Integer;
  Blocked: Boolean;
begin
  Result := False;
  Lib := TPDFlibEnterprise.Create;
  Report := TStringList.Create;
  try
    if Lib.LoadFromFile(InName, '') <> 1 then
      Exit;
    Result := Lib.ConvertToPDFA(5) = 1;      // 5 = PDF/A-3b, garde les pièces jointes
    Report.Text := Lib.GetPDFAConversionReport;
    if Result then
      Lib.SaveToFile(IncludeTrailingPathDelimiter(ArchiveDir) + ExtractFileName(InName))
    else
    begin
      Blocked := False;
      for I := 0 to Report.Count - 1 do
        if Pos('blocked:', Report[I]) = 1 then
          Blocked := True;
      // Gardez l'original intact ; seul le rapport voyage avec lui
      Report.SaveToFile(IncludeTrailingPathDelimiter(ReviewDir) +
        ChangeFileExt(ExtractFileName(InName), '.pdfa-report.txt'));
      if Blocked then
        Writeln(InName, ': needs a password or a rebuilt source file');
    end;
  finally
    Report.Free;
    Lib.Free;
  end;
end;
Une ligne blocked: signifie en général que le correctif est hors du PDF : un mot de passe, un autre fichier source, ou une relance de ce qui a produit le document. Les problèmes de validation purs après une conversion complète sont plus souvent du contenu qui porte du sens et ne peut pas simplement être supprimé, et ce sont les cas où un humain doit décider
Lire la marque PDF/A qu'un fichier porte déjà
Avant de convertir, regardez ce que le document prétend déjà de lui-même. Les fichiers arrivant de scanners, de suites bureautiques et d'autres outils PDF portent souvent déjà une marque PDF/A, et reconvertir un PDF/A-3 valide vers la partie 2 lui coûterait ses pièces jointes pour rien
Le piège est que XMP permet d'écrire la même propriété de deux façons. Certains producteurs écrivent la partie comme élément enfant, <pdfaid:part>2</pdfaid:part> ; d'autres l'écrivent comme attribut sur rdf:Description, pdfaid:part="2". Les deux sont du XMP ordinaire, valide. Un détecteur qui ne cherche qu'une seule forme décide que les fichiers de l'autre famille de producteurs ne portent aucune marque, et un vérificateur construit ainsi finit par juger un PDF/A-2 valide contre la partie 1 et à le rapporter comme non marqué et de version PDF trop haute, l'exact contraire de la vérité. Le validateur de PDF Library for Delphi lit les deux formes. Si vous reniflez la marque vous-même, faites pareil :
function DeclaredPDFAPart(Lib: TPDFlib): string;
const
  ElemTag = '<pdfaid:part>';
  AttrDQ  = 'pdfaid:part="';
  AttrSQ  = 'pdfaid:part=''';
var
  Packet: string;
  P: Integer;
begin
  Result := '';
  Packet := Lib.GetDocumentMetadata;
  P := Pos(ElemTag, Packet);                   // forme élément
  if P > 0 then
    Exit(Copy(Packet, P + Length(ElemTag), 1));
  P := Pos(AttrDQ, Packet);                    // forme attribut, guillemets doubles
  if P = 0 then
    P := Pos(AttrSQ, Packet);                  // forme attribut, guillemets simples
  if P > 0 then
    Result := Copy(Packet, P + Length(AttrDQ), 1);
end;
Un résultat vide signifie aucune marque sous aucune forme. Un chiffre vous dit quelle partie le producteur visait, et ce nombre est celui à comparer à votre cible avant de décider de convertir ou pas du tout
Assainir les scripts avant que le fichier entre dans l'archive
La conversion d'archivage et l'assainissement de sécurité tournent en général ensemble, puisque le contenu qu'une politique de sécurité veut voir partir chevauche largement ce que PDF/A interdit. SanitizeDocument prend un masque de bits de drapeaux SANITIZE_* et renvoie combien de suppressions il a appliquées. ConvertToPDFA lui-même l'appelle avec SANITIZE_JAVASCRIPT or SANITIZE_OPEN_ACTION comme première étape
Un détail compte pour les validateurs. Les scripts au niveau du document vivent dans un arbre de noms /JavaScript sous le dictionnaire /Names du catalogue, et quand le dernier script est retiré, l'arbre devenu vide est retiré avec lui. Un arbre vide annonce encore que le document a des scripts, et certains vérificateurs réagissent à la clé elle-même sans compter ce qui se trouve dessous
Quel que soit l'outil qui a assaini, vérifiez le fichier enregistré par un chargement frais au lieu de faire confiance à l'état en mémoire. Le rouvrir coûte peu :
var
  Lib, Check: TPDFlib;
begin
  Lib := TPDFlib.Create;
  Check := TPDFlib.Create;
  try
    Lib.LoadFromFile('upload.pdf', '');
    Lib.SanitizeDocument(SANITIZE_JAVASCRIPT or SANITIZE_OPEN_ACTION);
    Lib.SaveToFile('upload-clean.pdf');

    Check.LoadFromFile('upload-clean.pdf', '');
    if Check.GlobalJavaScriptCount > 0 then
      raise Exception.Create('Document-level scripts survived the save');
  finally
    Check.Free;
    Lib.Free;
  end;
end;
Pour les étapes voisines d'un pipeline d'archivage, voir les guides préflight PDF/A et PDF/UA, censure véritable et suppression de contenu, et schémas d'extension XMP PDF/A-3 pour Factur-X, qui reprend le côté métadonnées une fois qu'un document archivé transporte aussi des données de facture structurées
Toute la conversion, la réparation de métadonnées et la validation montrées ici tournent à l'intérieur de votre propre processus Delphi, C++Builder ou Lazarus, sans convertisseur externe ni validateur en ligne de commande dans la chaîne. La page produit PDF Library for Delphi liste les parties PDF/A, les éditions et les plateformes cibles