Voici une erreur qu'un lecteur JBIG2 écrit à la main commet sur le premier fichier inhabituel qu'il rencontre. Il parse l'en-tête de fichier, parse le premier en-tête de segment, lit la longueur de données sur quatre octets et prend autant d'octets comme corps du segment. Sur la plupart des fichiers .jb2, c'est exactement ce qu'il faut. Sur un fichier dont l'octet de drapeaux a le bit 0 à zéro, ces octets de « corps » sont en réalité les deuxième, troisième et quatrième en-têtes de segment, et le décodeur arithmétique en fait un bitmap de bruit ou file au-delà de la fin du tampon. Le fichier n'est pas cassé. Il utilise l'organisation à accès direct de l'annexe D.2 de l'ITU-T T.88, où tous les en-têtes de segment viennent d'abord et toutes les données de segment suivent ensuite, dans le même ordre
Les fichiers à accès direct sont rares. Ils sortent de systèmes d'archivage et d'imagerie documentaire qui veulent qu'un lecteur voie chaque page et chaque dépendance de dictionnaire avant de toucher un octet compressé. Si un job de conversion mélange des fichiers d'une telle source avec des scans ordinaires, un fichier à accès direct peut se retrouver au milieu d'un lot par ailleurs entièrement séquentiel. Le décodeur qui les lit est le même décodeur Pascal natif qui gère les tables de Huffman personnalisées et les codes préfixes canoniques JBIG2, donc le côté codage ne change pas ; seul l'ordre dans lequel les segments sont trouvés diffère
Trois dispositions de fichier derrière un seul octet de drapeaux
PDF Library for Delphi lit les fichiers JBIG2 autonomes via TPLJBIG2Decoder dans l'unité PDFlibJBIG2, et le décodeur déduit tout seul la disposition à partir de l'en-tête de fichier. L'annexe D du T.88 autorise trois arrangements pour les mêmes segments : le séquentiel (D.1) place chaque en-tête juste devant ses données, l'accès direct (D.2) place tous les en-têtes d'abord et toutes les données ensuite, et l'embarqué (D.3) est la forme sans en-tête utilisée dans d'autres conteneurs. Un fichier autonome commence par l'identifiant de huit octets 97 4A 42 32 0D 0A 1A 0A, puis un octet de drapeaux, puis un compte de pages sur quatre octets sauf si les drapeaux disent que le compte est inconnu
Le bit 0 de cet octet de drapeaux choisit l'organisation : 1 signifie séquentiel, 0 signifie accès direct. Le bit 1 à un signifie que le nombre de pages est inconnu et que le compte sur quatre octets est absent, donc le premier en-tête de segment commence à l'octet 9 au lieu de l'octet 13. Les bits 2 à 7 sont réservés ; le décodeur accepte les fichiers qui les positionnent au lieu de les rejeter, parce qu'un bit réservé égaré ne dit rien sur la lisibilité des segments eux-mêmes
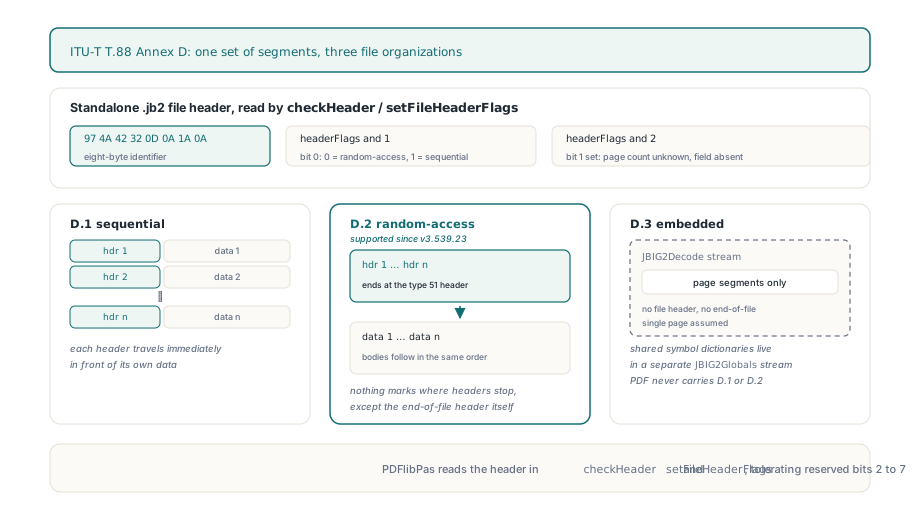
Le PDF lui-même ne transporte jamais la disposition à accès direct. Un flux d'image JBIG2Decode, décrit dans ISO 32000-1 §7.4.7, ne contient que des segments de page sous forme embarquée, avec les dictionnaires de symboles partagés déplacés dans un flux JBIG2Globals séparé et sans en-tête de fichier, ni segments end-of-page ou end-of-file. Quand le décodeur ne trouve pas l'identifiant de huit octets, il traite l'entrée exactement comme ce type de flux : séquentiel, une page. Dans l'autre sens, quand PDF Library for Delphi exporte une image JBIG2Decode en fichier .jb2 natif, il écrit l'octet de drapeaux $03 (séquentiel, compte de pages inconnu) et ajoute un en-tête de segment end-of-file. L'accès direct n'arrive donc jamais que de l'extérieur, comme fichier autonome passé directement à TPLJBIG2Decoder, en général en route vers une conversion ou une recompression pour PDF avec les backends d'encodage JBIG2 de PDFlibPas
Pourquoi ne peut-on pas lire un fichier à accès direct dans l'ordre du fichier ?
Parce que rien dans le flux d'octets ne marque où le bloc d'en-têtes finit et où le bloc de données commence, sauf l'en-tête de segment end-of-file (type 51) lui-même. Les en-têtes de segment JBIG2 n'ont pas de taille fixe. Le compte de segments référencés est soit une forme courte sur trois bits, soit une forme longue suivie d'un bitmap de rétention ; chaque numéro de segment référencé occupe un, deux ou quatre octets selon la taille du numéro du segment courant ; le champ d'association de page fait un octet ou quatre. Un lecteur doit parser chaque champ d'un en-tête rien que pour savoir où commence le suivant
Un lecteur séquentiel qui parcourt le fichier dans l'ordre a le premier en-tête juste et tout le reste faux. Pire, il peut ne rien remarquer pendant un moment : un décodeur de région générique nourri d'octets d'en-tête produit des pixels, pas une erreur, jusqu'à ce qu'un contrôle de longueur ou de référence ultérieur finisse par déclencher. Notre avis est qu'un décodeur qui n'indexe pas d'abord les en-têtes devrait refuser tout net les fichiers à accès direct. Un rejet clair coûte un fichier dans un lot ; un bitmap d'apparence plausible mais faux peut finir dans une archive et y rester
Indexer chaque en-tête avant le premier corps
Quand l'octet de drapeaux dit accès direct, PDF Library for Delphi fait une passe sur le bloc d'en-têtes avant de décoder quoi que ce soit. Chaque en-tête est parsé en entier puis jeté ; la seule chose conservée est son offset en octets dans le fichier. Les données compressées ne sont jamais copiées dans un second tampon réordonné, ce qui compte sur de gros scans d'archive où le bloc de données peut représenter l'essentiel du fichier. La passe s'arrête au premier en-tête end-of-file, et à ce moment la position de lecture se trouve sur le premier octet des données du premier segment
Un fichier à accès direct a moins de redondance qu'un fichier séquentiel, donc le pré-balayage est strict. Il rejette le fichier quand :
- un en-tête est coupé par la fin du tampon, signalé par
JBIG2 truncated random-access header at byte Navec l'offset où cet en-tête commençait - les numéros de segment ne croissent pas strictement (comparés en valeurs non signées), parce que deux en-têtes revendiquant le même numéro rendent ambiguë la liste de références d'une région ultérieure
- une longueur de données a son bit de poids fort à un, ce qui inclut le marqueur
0xFFFFFFFFde « longueur inconnue » ; dans cette disposition, il n'y a aucun autre moyen de trouver où commence le corps suivant, donc le décodeur la refuse immédiatement au lieu de chercher un marqueur de fin plus loin - l'en-tête end-of-file déclare des données, ou n'apparaît jamais (
JBIG2 random-access file is missing its end-of-file header) - les longueurs déclarées totalisent plus que les octets restants, ou moins
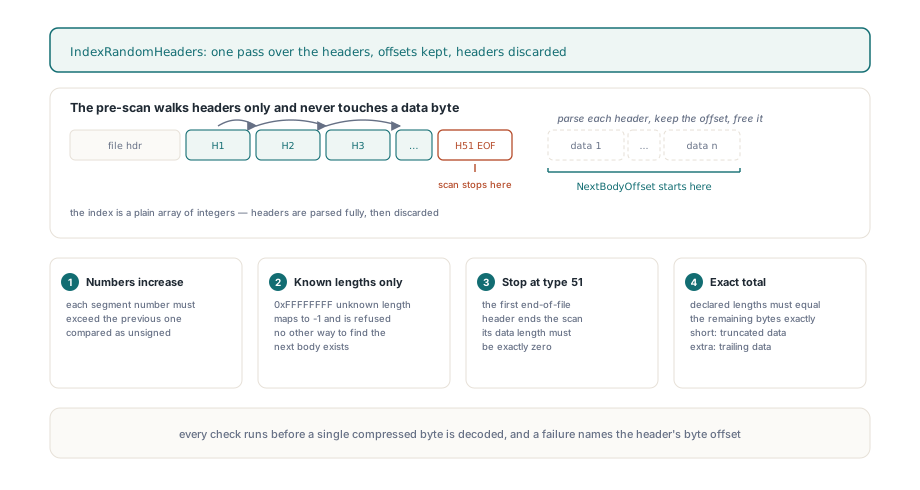
La dernière règle est celle sur laquelle on trébuche. Un seul octet de trop après le dernier corps échoue avec JBIG2 trailing random-access data. Cela paraît dur à côté du chemin séquentiel, où le décodage s'arrête simplement au segment end-of-file et où tout ce qui suit est ignoré. L'asymétrie a une raison. En disposition séquentielle, chaque en-tête est collé à ses propres données, donc des déchets en fin de fichier n'ont rien pu décaler. En disposition à accès direct, les en-têtes sont la seule carte du bloc de données, et si les longueurs ne tombent pas juste, le décodeur ne peut pas distinguer un remplissage inoffensif d'un octet perdu ou ajouté bien plus tôt qui a décalé tous les corps suivants
Pourquoi une boucle comptée en octets perd-elle le dernier segment end-of-page ?
Une boucle qui tourne « tant qu'il reste des octets » se termine trop tôt sur un fichier à accès direct, parce que les données s'épuisent avant l'index des en-têtes. Les segments end-of-page (type 49) et end-of-file transportent zéro octet de données et viennent normalement en dernier. Une fois le dernier corps de région consommé, la position de lecture est exactement à la fin du tampon ; une boucle comptée en octets sort là, et le segment end-of-page de longueur nulle n'est jamais dispatché, ce qui laisse la page inachevée
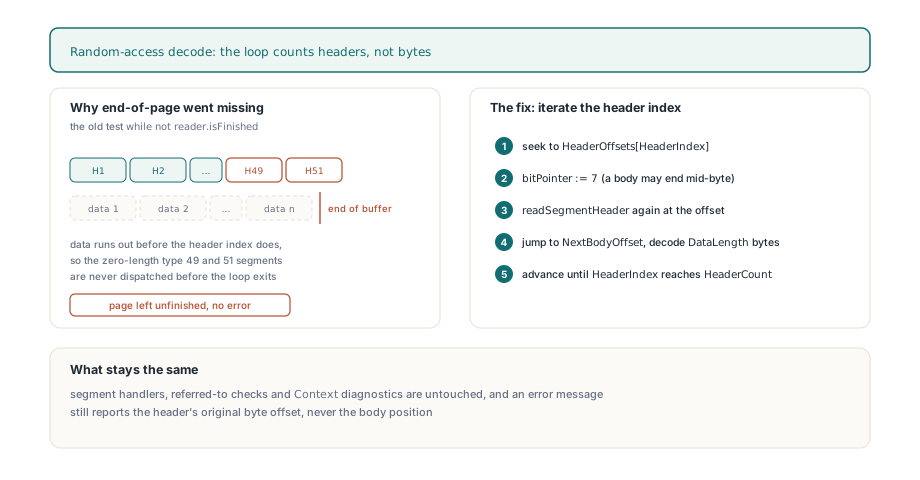
Pour les fichiers à accès direct, le décodeur compte donc des en-têtes, pas des octets. Chaque étape revient en arrière sur le prochain en-tête indexé, se réaligne sur une frontière d'octet (un corps codé arithmétiquement peut finir au milieu d'un octet), parse l'en-tête à nouveau, puis saute en avant là où commence le corps suivant et avance de la longueur déclarée. Un corps dont le décodeur termine tôt est sauté jusqu'à sa fin déclarée ; un corps qui lit au-delà est rejeté. À partir de là, le segment passe par les mêmes handlers et contrôles de référence que dans un fichier séquentiel. Les erreurs levées pendant le décodage d'un corps portent la position d'origine de l'en-tête, sous la forme JBIG2 segment N (type T) at byte B: ..., si bien que l'offset dans LastError pointe vers quelque chose que vous pouvez retrouver dans un éditeur hexadécimal
Charger un fichier .jb2 à accès direct en Delphi
Le code applicatif ne change pas avec l'organisation. TPLJBIG2Decoder.LoadFromByteArray détecte l'en-tête de fichier et la disposition, renvoie False sur toute entrée rejetée avec la raison dans LastError, et expose la page décodée via Width, Height et GetScanline, qui remplit un octet par pixel avec 1 pour le noir
uses
  SysUtils, Classes, PDFlibJBIG2;

function ReadJb2(const FileName: string): TJBIG2ByteArray;
var
  FS: TFileStream;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    SetLength(Result, FS.Size);
    if Length(Result) > 0 then
      FS.ReadBuffer(Result[0], Length(Result));
  finally
    FS.Free;
  end;
end;

function CountBlackPixels(const FileName: string): Integer;
var
  Decoder: TPLJBIG2Decoder;
  Row: TJBIG2ByteArray;
  X, Y: Integer;
begin
  Result := 0;
  Decoder := TPLJBIG2Decoder.Create;
  try
    // Fichiers autonomes séquentiels et à accès direct passent par le même appel
    if not Decoder.LoadFromByteArray(ReadJb2(FileName)) then
      raise Exception.Create('JBIG2 rejected: ' + Decoder.LastError);
    for Y := 0 to Decoder.Height - 1 do
      if Decoder.GetScanline(Y, Row) then
        for X := 0 to Decoder.Width - 1 do
          if Row[X] = 1 then
            Inc(Result);
  finally
    Decoder.Free;
  end;
end;
Si vous voulez savoir quelle disposition utilise un fichier, pour la journalisation ou pour trier un corpus avant une conversion, lisez l'octet de drapeaux vous-même. La bibliothèque n'expose pas l'organisation qu'elle a détectée, et neuf octets suffisent. Le helper ci-dessous est à ajouter à votre propre code ; il ne fait que reformuler les règles d'en-tête du T.88 :
type
  TJb2Layout = (jlNoFileHeader, jlSequential, jlRandomAccess);

// Votre propre helper, hors PDFlibJBIG2 : classe un tampon d'après son en-tête de fichier T.88
function DetectJb2Layout(const Data: TJBIG2ByteArray;
  out PageCountKnown: Boolean): TJb2Layout;
const
  Signature: array[0..7] of Byte = ($97, $4A, $42, $32, $0D, $0A, $1A, $0A);
var
  I: Integer;
begin
  Result := jlNoFileHeader;          // p. ex. un flux embarqué extrait d'un PDF
  PageCountKnown := False;
  if Length(Data) < 9 then
    Exit;
  for I := 0 to 7 do
    if Data[I] <> Signature[I] then
      Exit;
  PageCountKnown := (Data[8] and 2) = 0;   // bit 1 à un : pas de compte de pages sur quatre octets
  if (Data[8] and 1) = 0 then
    Result := jlRandomAccess
  else
    Result := jlSequential;
end;
Jobs par lots : tampons rembourrés et fichiers rejetés
La règle des données traînantes est l'endroit où le code de traitement par lots a tendance à se tromper, et quand un fichier qui s'ouvre ailleurs est rejeté de cette façon, regardez le tampon avant d'accuser le fichier. Un .jb2 tiré d'une colonne BLOB de base de données, d'une lecture réseau de taille fixe ou d'un format conteneur avec remplissage d'alignement peut arriver avec quelques octets nuls après la vraie fin. Un fichier séquentiel s'en moque. Un fichier à accès direct avec le même remplissage échoue avec JBIG2 trailing random-access data, et il en va de même d'un tampon coupé quelques octets trop court, qui échoue comme tronqué. Passez exactement les octets du fichier, dimensionnés d'après la vraie longueur de la source, jamais d'après une taille de chunk ou une capacité
Un fichier rejeté ne laisse rien derrière lui non plus. LoadFromByteArray remet à zéro Width, Height et les scanlines avant de commencer à décoder, donc un appel en échec rapporte des dimensions nulles plutôt que la page du fichier précédent, et la même instance de décodeur peut enchaîner directement sur le fichier suivant :
procedure DecodeBatch(const Files, Log, Quarantine: TStrings);
var
  Decoder: TPLJBIG2Decoder;
  I: Integer;
begin
  Decoder := TPLJBIG2Decoder.Create;
  try
    for I := 0 to Files.Count - 1 do
      if Decoder.LoadFromByteArray(ReadJb2(Files[I])) then
        Log.Add(Format('%s: %d x %d', [Files[I], Decoder.Width, Decoder.Height]))
      else
      begin
        // Width et Height valent 0 ici ; rien du fichier précédent ne survit
        Log.Add(Files[I] + ': ' + Decoder.LastError);
        if Pos('trailing random-access data', Decoder.LastError) > 0 then
          Quarantine.Add(Files[I]);   // vérifiez comment les octets ont été stockés avant d'accuser le fichier
      end;
  finally
    Decoder.Free;
  end;
end;
Vérifier cela dans votre propre pipeline ne demande pas de fichiers d'exemple rares. Réorganisez un .jb2 séquentiel en disposition à accès direct, en gardant chaque en-tête et chaque octet compressé, déplacez les en-têtes end-of-page et end-of-file à la fin du bloc d'en-têtes, et les pixels décodés doivent correspondre exactement à l'original séquentiel, avec et sans le champ de compte de pages. Puis donnez-lui chaque préfixe tronqué, un numéro de segment dupliqué, un octet de trop en fin et une longueur 0xFFFFFFFF ; chacun doit renvoyer False avec Width et Height à zéro
Ce que le décodeur renvoie, et ce qu'il attend
L'accès direct est ici une propriété de la disposition du fichier. TPLJBIG2Decoder renvoie le bitmap de la première page quelle que soit l'organisation du fichier, et Width et Height décrivent cette page. Chaque segment doit déclarer sa longueur de données ; le T.88 permet à une région générique immédiate d'utiliser le marqueur 0xFFFFFFFF, et le décodeur rejette ce marqueur dans les deux dispositions avec unknown or oversized segment length is not supported. Les longueurs de préfixes Huffman personnalisés et les comptes d'entrées de table sont plafonnés comme dans les fichiers séquentiels
Décoder le JBIG2 est une étape d'un chemin image plus long qui couvre aussi l'extraction d'images PDF, la recompression et l'encodage JBIG2 ; la page produit PDF Library for Delphi couvre le reste de ce pipeline et les formats d'image pris en charge