Déposez un segment Tables JBIG2 (type 53) octet par octet et la première surprise est ce qu’il laisse de côté : les codes Huffman eux-mêmes. Vous obtenez un octet de drapeaux, deux bornes et une suite de petits nombres, et ces nombres sont des longueurs de code. Encodeur et décodeur reconstruisent tous deux les motifs de bits réels à partir des longueurs avec la procédure de l’annexe B.3 du T.88 de l’UIT-T. Reconstruisez-les dans un ordre légèrement différent et vous obtenez encore un code préfixe valide, chaque motif se décode encore, et chaque valeur ressort attachée au mauvais motif
Sur une page codée avec des identifiants de symboles Huffman et des tables fournies par l’encodeur, cet écart ressemble à un scan raté : glyphes décalés de quelques pixels, caractères bâtis avec les mauvais symboles, ou nombres plausibles jusqu’à ce qu’une largeur sorte de son intervalle plusieurs segments plus loin. La plupart du JBIG2 dans les fichiers PDF est codé arithmétiquement, et la plupart du JBIG2 codé Huffman s’en tient aux tables standard B.1 à B.15. Les fichiers qui livrent leurs propres tables sont rares, et ils tendent à exercer en même temps l’analyseur de tables, le raffinement codé Huffman et les bitmaps collectifs non compressés
Ce que transporte réellement un segment Tables
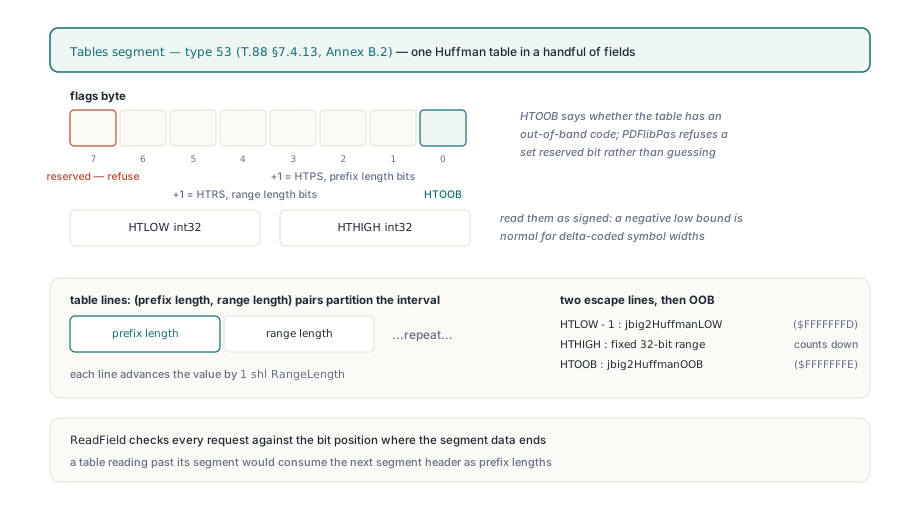
Un segment Tables décrit exactement une table Huffman. Le §7.4.13 et l’annexe B.2 du T.88 la présentent comme un octet de drapeaux, un HTLOW signé de 32 bits, un HTHIGH signé de 32 bits, puis des paires (longueur de préfixe, longueur de plage) qui pavent l’intervalle de HTLOW à HTHIGH. Le bit 0 des drapeaux est HTOOB, qui dit si la table possède un code hors bande. Les bits 1 à 3 plus un donnent HTPS, la largeur de chaque champ de longueur de préfixe. Les bits 4 à 6 plus un donnent HTRS, la largeur de chaque champ de longueur de plage. Le bit 7 est réservé
Les bornes sont l’endroit où un analyseur écrit à la main trébuche d’abord. Lisez HTLOW comme non signé et une table qui démarre à -2, ce qui est ordinaire pour des largeurs et hauteurs de symboles codées en deltas, prétend soudain démarrer juste sous 4,3 milliards. PDF Library for Delphi lit les deux bornes comme des valeurs signées, refuse une table dont HTLOW n’est pas inférieur à HTHIGH ou dont la longueur de plage dépasse 32, et contrôle chaque lecture de champ contre le bit où les données déclarées du segment prennent fin. Ce dernier contrôle compte plus qu’il ne paraît : une table qui lit au-delà de son segment consomme l’en-tête du segment suivant comme des longueurs de préfixe et s’analyse en charabia complet. Un bit 7 actif échoue avec reserved custom Huffman table flag. Nous préférons ce refus à une supposition, parce qu’une table devinée produit de mauvais pixels que personne ne peut remonter jusqu’à leur cause
Après les lignes régulières viennent les lignes d’échappement de l’annexe B.2. La ligne de plage basse démarre à HTLOW moins un et compte à rebours par un offset de 32 bits, la ligne de plage haute démarre à HTHIGH avec une plage de 32 bits, et la ligne hors bande n’existe que si HTOOB est actif. Ces lignes portent les mêmes marqueurs que les tables standard intégrées, si bien qu’une table personnalisée et la table B.6 traversent une seule boucle de décodage. Une table personnalisée peut contenir jusqu’à 65 536 lignes
Pourquoi les codes préfixes doivent-ils être attribués dans l'ordre des lignes de table ?
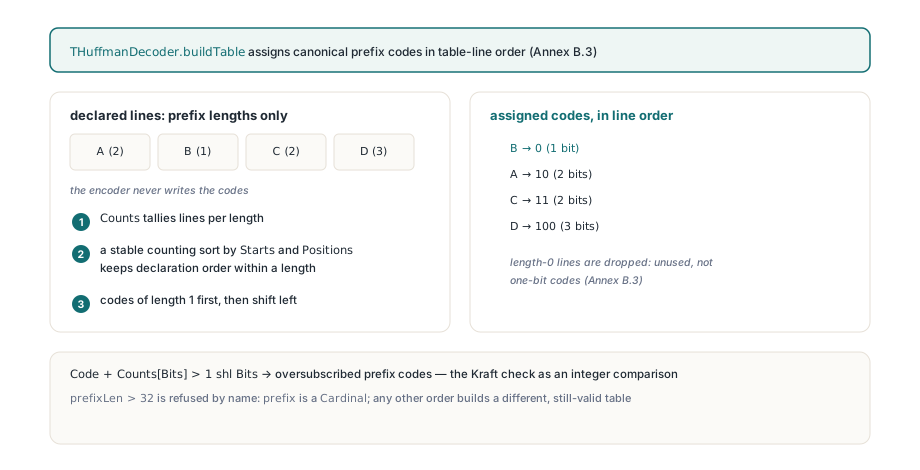
Parce que l’ordre de déclaration est la seule chose qui lie un motif de bits à un intervalle de valeurs. L’annexe B.3 compte combien de lignes utilisent chaque longueur de préfixe, distribue d’abord les codes de longueur 1, décale à gauche pour passer à la longueur 2, et ainsi de suite ; à l’intérieur d’une longueur, les codes vont aux lignes dans l’ordre où elles apparaissent dans le segment. Une petite table rend cela concret. Six lignes, étiquetées A à F dans l’ordre du fichier, avec ces longueurs de préfixe :
| Ligne | Longueur de préfixe | Code (ordre de fichier conservé) | Code si B et D s’échangent |
|---|---|---|---|
| A | 2 | 00 | 00 |
| B | 3 | 100 | 101 |
| C | 2 | 01 | 01 |
| D | 3 | 101 | 100 |
| E | 3 | 110 | 110 |
| F | 0 | inutilisé | inutilisé |
Les deux colonnes sont des codes préfixes valides. Seule celle de gauche est ce que l’encodeur voulait : avec B et D échangés, le motif 100 donne l’intervalle de valeurs de D et le décodeur continue avec un nombre du mauvais intervalle. La ligne F a une longueur 0, ce que B.3 définit comme inutilisé ; donnez-lui un code d’un bit et chaque attribution suivante se décale
Le moyen facile d’obtenir la colonne de droite est un tri généraliste par longueur de préfixe. TArray.Sort et TList<T>.Sort de Delphi ne sont pas stables, si bien que des longueurs égales peuvent revenir dans n’importe quel ordre. Pour des codes canoniques dans votre propre outillage, parcourez les lignes dans l’ordre du fichier une fois par longueur :
uses
  System.SysUtils;

type
  TCodeLine = record
    PrefixLen: Integer;   // telles que lues dans le segment Tables
    Code: Cardinal;       // affecté ci-dessous
  end;

// Affectation canonique de l’annexe B.3, écrite pour votre propre outillage.
// Les longueurs égales gardent leur ordre de fichier ; la longueur 0 ne reçoit aucun code.
procedure AssignCanonicalCodes(var Lines: array of TCodeLine);
var
  LenCount: array[0..32] of UInt64;
  FirstCode: array[0..32] of UInt64;
  NextCode: UInt64;
  CurLen, I: Integer;
begin
  FillChar(LenCount, SizeOf(LenCount), 0);
  for I := 0 to High(Lines) do
  begin
    if (Lines[I].PrefixLen < 0) or (Lines[I].PrefixLen > 32) then
      raise Exception.Create('prefix length out of range');
    Inc(LenCount[Lines[I].PrefixLen]);
  end;
  LenCount[0] := 0;
  FirstCode[0] := 0;
  for CurLen := 1 to 32 do
  begin
    FirstCode[CurLen] := (FirstCode[CurLen - 1] + LenCount[CurLen - 1]) shl 1;
    // Contrôle de Kraft : plus de codes que cette longueur ne peut en porter
    if FirstCode[CurLen] + LenCount[CurLen] > (UInt64(1) shl CurLen) then
      raise Exception.Create('oversubscribed prefix lengths');
    NextCode := FirstCode[CurLen];
    for I := 0 to High(Lines) do       // l’ordre de fichier départage les égalités
      if Lines[I].PrefixLen = CurLen then
      begin
        Lines[I].Code := Cardinal(NextCode);
        Inc(NextCode);
      end;
  end;
end;
Nourrissez-la des six lignes ci-dessus et A reçoit 00, C reçoit 01, B reçoit 100, D reçoit 101 et E reçoit 110 ; F ne garde aucun code. PDF Library for Delphi fait le même travail avec une passe de comptage, stable par construction et qui évite de rescanner la table 32 fois, et applique les deux mêmes garde-fous. Des longueurs en sursouscription échouent avec oversubscribed Huffman prefix codes ; les laisser passer et un motif peut correspondre à deux lignes. Des préfixes de plus de 32 bits échouent aussi par leur nom, bien que le T.88 les autorise sur le papier. Nous pensons que ce plafond est le bon compromis : chaque code tient dans un mot machine, et un fichier qui en demande plus a bien plus de chances d’être endommagé que malin
Les valeurs exigent le même soin. La ligne de plage basse se décode comme HTLOW moins un moins un offset non signé de 32 bits, et avec un intermédiaire Integer de 32 bits cette soustraction peut boucler vers une largeur positive d’apparence ordinaire. Le décodeur le fait en 64 bits et lève Huffman value exceeds signed integer range quand le vrai résultat ne tient pas
Ordre des sélecteurs, et deux pièges qui se couvrent l’un l’autre
Une région de texte ou un dictionnaire de symboles ne nomme pas ses tables. Il porte des sélecteurs de deux bits, et chaque sélecteur réglé sur personnalisé prend le segment Tables suivant de la liste référencée, dans l’ordre de référencement. Le §7.4.3.1.2 du T.88 ordonne les sélecteurs de région de texte en FS, DS, DT, RDW, RDH, RDX, RDY et RSIZE ; le §7.4.2.1.1 ordonne les sélecteurs de dictionnaire de symboles en DH, DW, BMSIZE et AGGINST. Les valeurs 0 et 1 prennent des tables standard, 3 prend une table personnalisée, et 2 est réservé sur les champs qui n’ont que deux tables standard. PDF Library for Delphi rejette les valeurs de sélecteur réservées, et échoue avec missing custom Huffman table reference quand les sélecteurs veulent plus de tables personnalisées que la région n’en référence
Si vous écrivez votre propre décodeur, deux erreurs sont faciles à faire ici, et chacune cache l’autre. La première mord en Delphi, ou en FPC en mode Delphi (le mode objfpc rejette le code comme identifiant dupliqué) : un setter de drapeaux dont le paramètre porte le même nom que le champ. Le paramètre masque le champ, Flags := Flags s’affecte à lui-même, et le champ reste à zéro. Chaque sélecteur lit alors zéro, une région de texte utilise les tables standard B.6, B.8 et B.11 pour FS, DS et DT quoi que demande le fichier, et le chemin personnalisé ne s’exécute jamais
Le second se loge dans le dictionnaire de symboles. Un dictionnaire Huffman peut stocker ses symboles comme un bitmap collectif non compressé (BMSIZE à zéro), où chaque ligne se termine par un octet partiel. La valeur de bourrage est le nombre de bits valides dans cet octet, et la tentation est de la lire comme la position du bit valide le plus bas :
// Dernier octet d’une ligne de bitmap collectif, bits lus MSB d’abord.
// Padding := TotalWidth mod 8  -> nombre de bits VALIDES dans cet octet

// Faux : traite Padding comme le plus bas index de bit à copier
for BitPos := 7 downto Padding do
  CopyPixel((LastByte shr BitPos) and 1);

// Juste : le plus bas index de bit valide est 8 - Padding (0 quand Padding = 0)
for BitPos := 7 downto ((8 - Padding) and 7) do
  CopyPixel((LastByte shr BitPos) and 1);

// CopyPixel représente ce qui écrit le pixel dans votre propre décodeur
Vérifiez les largeurs de bordure. Une ligne de 63 pixels a un bourrage de 7 : la boucle fausse copie un bit du dernier octet, la boucle juste sept. Une ligne de 9 pixels a un bourrage de 1 : la boucle fausse copie sept, la juste copie un. À 64 pixels les deux copient les huit, si bien que les multiples de 8 ne l’exposent jamais. Des bitmaps collectifs synthétiques de 7 et 9 pixels de large épinglent les deux côtés de la frontière d’octet. Et le dégât voyage, parce que le raffinement utilise ces symboles comme références
Si votre propre décodeur a les deux pièges, le débogage devient misérable. Corrigez le setter seul et le chemin personnalisé s’exécute enfin, droit dans les bitmaps collectifs cassés, si bien que la page reste fausse. Corrigez le bourrage seul et rien de visible ne change, parce que le chemin personnalisé reste inatteignable. Testez les deux avec des entrées synthétiques avant de faire confiance au moindre des deux changements. Un détail connexe : un dictionnaire de symboles Huffman dont l’entrée et les nouveaux symboles s’additionnent à un obtient une longueur de code de symbole de 0 par la formule log2, pourtant la variante Huffman écrit chaque identifiant de symbole avec au moins un bit. PDF Library for Delphi monte cette longueur à 1 en mode Huffman
Où le raffinement Huffman lit-il sa taille de bitmap ?
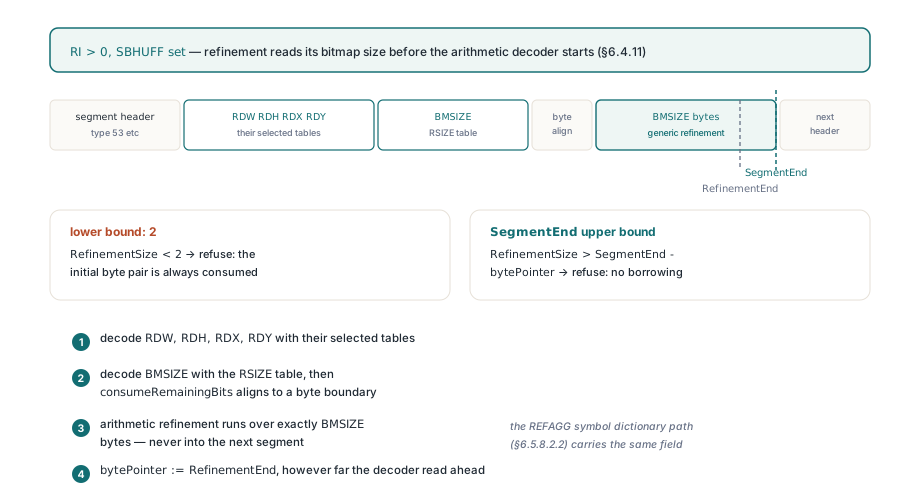
D’un champ BMSIZE qui n’existe qu’en mode Huffman, décodé devant les données de raffinement arithmétique. Quand une instance de région de texte a le raffinement (RI non nul) et SBHUFF actif, le §6.4.11 du T.88 fait lire au décodeur RDW, RDH, RDX et RDY avec leurs tables sélectionnées, puis BMSIZE avec la table RSIZE, puis sauter à une frontière d’octet, et seulement alors lancer le décodage de raffinement générique sur exactement BMSIZE octets. Les régions de texte en mode arithmétique n’ont pas un tel champ, si bien qu’un décodeur qui partage un chemin de code entre les modes le saute, démarre le décodeur arithmétique en avance, et raffine chaque symbole contre du bruit. Le chemin du dictionnaire de symboles avec REFAGG et une seule instance de raffinement (§6.5.8.2.2) a le même champ
PDF Library for Delphi borne BMSIZE des deux côtés. Le minimum est 2, la paire d’octets initiale que le décodeur arithmétique consomme toujours. Le maximum est ce qui reste du segment courant, délibérément pas du flux entier : un BMSIZE qui ne tient qu’en empruntant des octets au segment suivant est malformé, et un contrôle sur la longueur du flux laisserait le décodeur arithmétique lire dans l’en-tête suivant. Les tailles hors intervalle échouent avec invalid refinement bitmap size. Ensuite le lecteur Huffman reprend exactement BMSIZE octets après le champ, quoi qu’ait lu en avance le décodeur arithmétique
La longueur de segment déclarée est la frontière
Chaque en-tête de segment déclare combien d’octets de données suivent, et le décodeur tient le segment à ce nombre dans les deux sens : lire au-delà de la fin est une erreur, finir plus tôt est normal, et l’en-tête suivant est toujours lu là où le fichier dit qu’il commence. Des règles plus petites suivent. La longueur de données inconnue du §7.2.7 du T.88 est refusée d’entrée au lieu de chercher un terminateur. Les segments référencés doivent porter des numéros plus petits que le segment courant et doivent déjà exister. END_OF_PAGE et END_OF_FILE doivent déclarer zéro octet de données. Un segment Profiles (type 52) doit faire exactement 4 plus 4 fois son compte d’identifiants ; il est alors sauté mais conservé, si bien que des segments ultérieurs peuvent toujours s’y référer, et un identifiant de profil inconnu n’arrête pas le décodage
Le cas classique de fin anticipée est MMR. Un décodeur MMR a terminé une fois qu’il produit le dernier pixel de la dernière ligne, ce qui peut arriver avant le terminateur EOFB que le §6.2.5.7 du T.88 place à la fin des données. Un lecteur qui suppose qu’il se trouve désormais à l’en-tête suivant analyse les octets EOFB restants comme un numéro de segment et échoue quelques octets plus loin, loin de la vraie cause. Sauter à la fin déclarée évite la question. La même habitude traverse la façon dont PDF Library for Delphi analyse les structures PDF non fiables en général
Décoder un flux d’image JBIG2 depuis Delphi
Le décodeur vit dans l’unité PDFlibJBIG2 comme TPLJBIG2Decoder. LoadFromByteArray prend les données JBIG2 embarquées d’une image /JBIG2Decode et, en option, les données de son flux /JBIG2Globals, c’est là que vivent d’habitude les tables personnalisées et les dictionnaires de symboles partagés. Il renvoie False sur tout refus et laisse la raison dans LastError ; la sortie d’un appel antérieur est effacée au début de chaque appel, si bien qu’un décodage raté ne laisse jamais de vieux pixels derrière lui pour que l’appelant les prenne pour un résultat
uses
  System.SysUtils, PDFlibJBIG2;

// ImageBytes : les données du flux d’image, filtres précédant
//   JBIG2Decode déjà retirés
// GlobalBytes : les données du flux /JBIG2Globals, ou un tableau vide
function DecodeAndCountBlack(const ImageBytes, GlobalBytes: TJBIG2ByteArray;
  out BlackPixels: Int64): Boolean;
var
  Decoder: TPLJBIG2Decoder;
  Line: TJBIG2ByteArray;
  Row, Col: Integer;
begin
  BlackPixels := 0;
  Decoder := TPLJBIG2Decoder.Create;
  try
    Result := Decoder.LoadFromByteArray(ImageBytes, GlobalBytes);
    if not Result then
    begin
      // Forme : 'JBIG2 segment <n> (type <t>) at byte <offset>: <reason>'
      Writeln('JBIG2 refused: ', Decoder.LastError);
      Exit;
    end;
    for Row := 0 to Decoder.Height - 1 do
    begin
      Decoder.GetScanline(Row, Line);   // un octet par pixel, 0 ou 1
      for Col := 0 to Decoder.Width - 1 do
        Inc(BlackPixels, Line[Col]);    // 1 = noir en JBIG2
    end;
  finally
    Decoder.Free;
  end;
end;
Le compte de pixels noirs est votre propre contrôle, une empreinte bon marché pour comparer avec un second moteur de rendu. Les échecs au niveau segment arrivent préfixés du numéro de segment, du type et de l’offset d’octet, si bien que (type 53) devant oversubscribed Huffman prefix codes pointe droit sur un segment Tables. Gardez les deux canaux d’erreur séparés : TPLJBIG2Decoder.LastError est le texte de diagnostic de ce décodeur, tandis que TPDFlib.LastErrorCode est le code numérique de l’API au niveau bibliothèque. La sélection de page suit le flux : le décodeur renvoie le bitmap du premier segment d’information de page qu’il rencontre et ne recherche pas l’association de page 0, parce que le JBIG2 embarqué dans un PDF ne porte qu’une page et que les encodeurs la numérotent routinièrement 1
Comparer des moteurs de rendu sur ces fichiers demande un peu d’humilité, parce que des décodeurs JBIG2 indépendants ne sont pas toujours d’accord sur les fichiers à tables personnalisées avec raffinement Huffman. Deux décodeurs en désaccord ne tranchent rien. Les champs du format, si : quelles tables les sélecteurs ont choisies, ce que BMSIZE déclarait, où chaque segment se termine
L’encodage est couvert dans l’article sur les backends d’encodeur JBIG2 et leur liaison. Le chemin de lecture doit prendre ce que l’encodeur de quelqu’un d’autre a produit, et il partage ses règles avec le décodeur TIFF intégré et ses contrôles BigTIFF et disposition en tuiles : refuser par son nom, ne jamais emprunter d’octets au-delà d’une frontière déclarée, garder l’arithmétique intermédiaire large. Si un dossier de PDF scannés fait trébucher d’autres toolkits en boucle, vérifiez si les images sont du JBIG2 codé Huffman avec tables personnalisées, puis essayez-les contre le chemin de lecture natif Delphi et C++Builder décrit sur la page produit de PDF Library for Delphi