Échappez correctement le commentaire d’un client, pour que <b>urgent</b> entre dans votre gabarit HTML sous la forme <b>urgent</b>, remettez-le à un moteur qui analyse le balisage deux fois, et le PDF peut revenir avec le mot urgent en gras. L’échappement était correct. Le moteur l’a décodé une fois par passe. Tout chemin HTML vers PDF qui analyse, réécrit le résultat en HTML et analyse à nouveau doit décoder les entités exactement une fois sur tout le trajet
La version support client de cette histoire est ordinaire. Les tickets sont exportés en PDF, le commentaire du client se trouve dans un <p>, et quelqu’un tape des chevrons dans la boîte de commentaire. Un nom de tag inconnu disparaît simplement de la page. Une ancre échappée devient une annotation de lien cliquable dans un document que votre personnel considère fiable. Le fichier est valide et s’ouvre partout ; il dit simplement autre chose que les données
Là où le texte échappé redevient du balisage
Le texte échappé devient du balisage à l’endroit où un moteur à deux passes réécrit du texte déjà décodé en HTML sans le rééchapper. Ce que la première analyse a décodé devient alors de la syntaxe vivante pour la seconde
Les deux passes de DrawHTMLText et DrawHTMLTextBox de PDF Library for Delphi (PDFlibPas) existent pour une bonne raison. La première analyse découpe l’entrée en tags et en mots. Le moteur résout ensuite la cascade de feuilles de style : les règles des blocs <style> sont rapprochées de chaque tag, fusionnées avec les attributs style inline, et toute la liste d’éléments est réécrite en une chaîne HTML normalisée où chaque tag porte son style final. La passe de mise en page analyse cette chaîne. Le rapprochement de sélecteurs, flexbox, grid et le reste du support CSS décrit dans flexbox, CSS grid et mise en page de notes dans le rendu HTML de PDFlibPas dépendent tous de cette étape intermédiaire
Le danger se loge dans la façon dont les mots ressortent. Les tags peuvent être réécrits depuis leur forme source, mais les mots sont détenus comme du texte décodé, parce que c’est ce que mesure le coupeur de lignes. Ajoutez le mot venu de <unsafe> à la chaîne normalisée telle quelle, et <unsafe> arrive à la seconde analyse comme un élément. Une conception qui décode une fois doit aussi fermer trois fuites plus petites :
- Si
&n’est pas dans le jeu décodé,R&Ds’imprime littéralement et il n’y a aucun moyen du tout de poser l’orthographe<sur la page comme du texte - Si l’étape de dessin remplace
encore une fois après la fin de l’analyse, une orthographe d’entité littérale disparaît au tout dernier moment - Si un producteur HTML en amont, comme un convertisseur Markdown ou un exporteur de dataset, n’échappe que les chevrons, une orthographe d’entité dans un exemple de code ou une valeur de cellule est décodée en balisage
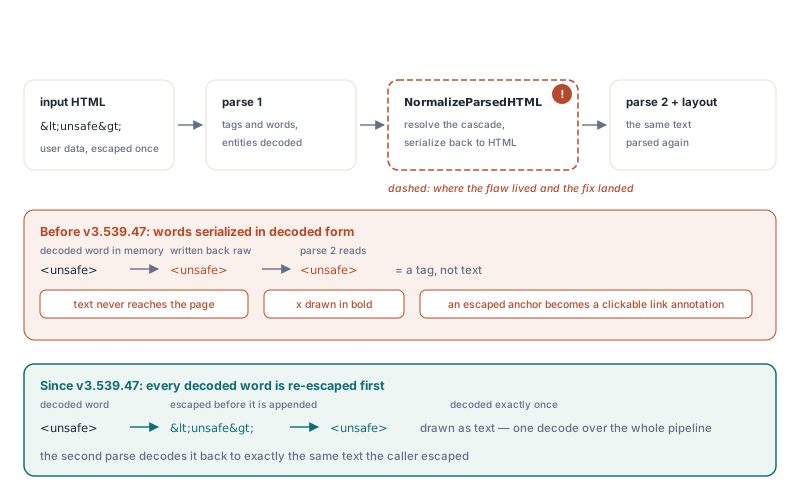
Le tableau ci-dessous liste ce qui atteint la page pour une poignée d’entrées, en comparant un moteur à deux passes naïf avec le pipeline PDFlibPas
| Entrée atteignant le moteur | Moteur à deux passes naïf | PDFlibPas |
|---|---|---|
<unsafe> | Analysé comme balise, le texte n’atteint jamais la page | <unsafe> dessiné comme texte |
<b>x</b> | x dessiné en gras | <b>x</b> dessiné comme texte |
R&D | R&D imprimé littéralement | R&D |
&lt; | &lt; imprimé littéralement | < |
Portée de code Markdown contenant | Une espace insécable | dessiné comme du texte |
Valeur de cellule de dataset < | < | < |
Comment PDF Library for Delphi décode-t-elle chaque entité exactement une fois ?
PDF Library for Delphi décode chaque entité exactement une fois en suivant trois règles ensemble : l’analyseur décode & en dernier, l’étape de dessin ne décode rien, et tout endroit qui remet des mots décodés en HTML les échappe d’abord. Retirez l’une des trois et l’une des lignes du tableau ci-dessus bascule vers la colonne naïve
Commencez par ce qui est décodé. Dans le contenu texte, l’analyseur reconnaît <, >, & et . Les références numériques comme A et les entités nommées comme " restent du texte littéral. Cette courte liste décide comment vous devriez échapper votre propre entrée, ce qui revient plus bas
L’ordre à l’intérieur du décodeur compte même dans une seule passe. Décodez & d’abord et l’entrée &lt; devient <, et le remplacement suivant très immédiat la transforme en < : un double décodage sans aucune seconde analyse. Le chemin des mots 8 bits remplace donc <, > et d’abord et & en dernier, si bien que l’esperluette qu’il produit n’est plus jamais regardée. Le chemin des mots UTF-16 prend une autre route vers le même résultat — un seul scan de gauche à droite par pas de deux octets qui réécrit chaque correspondance sur place et la dépasse
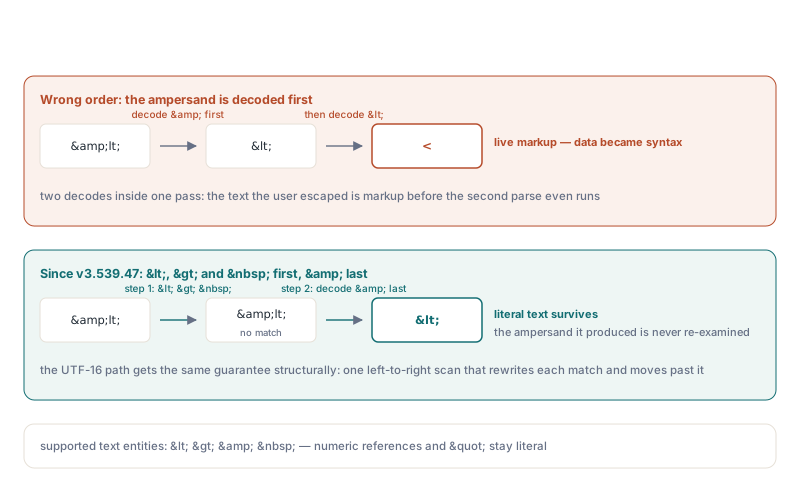
L’étape de dessin ne reçoit aucun remplacement tardif de . Un mot qui atteint le coupeur de lignes est du texte final, et le décodage vit dans l’analyseur et nulle part ailleurs
La règle de frontière porte le plus de poids. Quand le moteur écrit le HTML normalisé, il échappe &, < et > dans chaque mot décodé avant de l’ajouter, et la seconde analyse le décode vers les mêmes caractères. Effet net sur les deux passes : un décodage. La chaîne de continuation que DrawHTMLTextBox renvoie suit la même règle. Les mots qui n’entraient pas sont échappés avant d’entrer dans le reste, et le reste du reliquat est copié depuis le HTML normalisé, qui est déjà échappé. Une boîte qui prend tout renvoie une chaîne vide
Pourquoi l’échappement UTF-16BE ne peut-il pas passer par un remplacement au niveau octet ?
L’échappement UTF-16BE ne peut pas employer un remplacement au niveau octet parce que les deux octets d’une esperluette peuvent enjamber deux caractères sans rapport. L’unité de code 16 bits entière est la seule unité de travail sûre
Le moteur garde les mots Unicode en UTF-16 grand-indien tassé dans des chaînes d’octets, octet haut d’abord, si bien qu’une esperluette est 00 26. Prenez U+0100 (A majuscule latin à macron, octets 01 00) suivi de U+2603 (le bonhomme de neige, octets 26 03). Le tampon se lit 01 00 26 03, et les octets deux et trois épellent 00 26. Une recherche d’octet de #0'&' trouve une esperluette qu’aucun caractère ne contient, greffe & au milieu de deux points de code, et décale chaque caractère ultérieur d’un octet
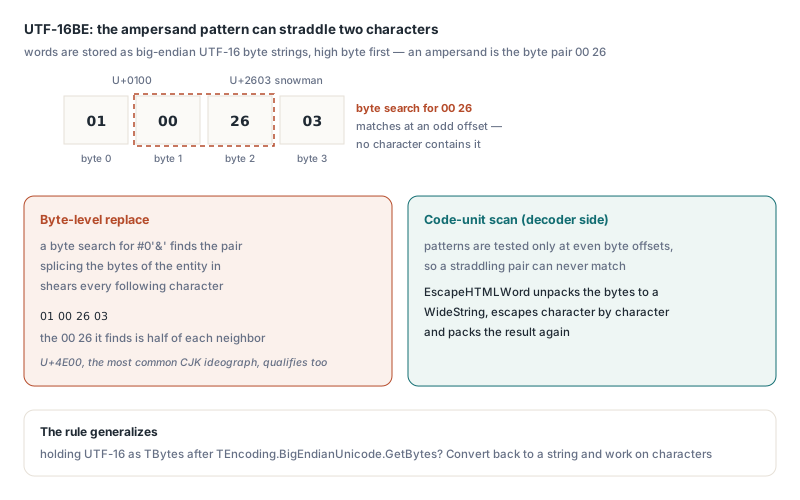
Ce n’est pas un coin exotique. Tout caractère dont l’octet bas est zéro peut fournir la première moitié, et U+4E00, l’un des idéogrammes CJK les plus fréquents, est un tel caractère. Les chevrons sont exposés de la même façon : 00 3C et 00 3E apparaissent chaque fois qu’un tel caractère est suivi d’un caractère de U+3C00 à U+3EFF dans l’extension CJK A. Alors PDFlibPas échappe les mots Unicode en les dépaquetant vers un WideString, en échappant caractère par caractère et en repaquetant le résultat. Le décodeur est sûr pour la raison symétrique : il ne teste les motifs qu’aux offsets pairs
Votre propre code peut buter sur le même mur. Une fois du texte UTF-16 logé dans TBytes, par exemple après TEncoding.BigEndianUnicode.GetBytes, le chercher pour des motifs d’octets est un bug qui attend la bonne paire de caractères. Reconvertissez en chaîne et travaillez sur des caractères
Code Markdown et cellules de dataset : l’esperluette passe d’abord
Les deux producteurs HTML dans PDFlibPas, le convertisseur Markdown et l’exporteur de dataset, échappent l’esperluette avant les chevrons, si bien que l’unique décodage du moteur restaure le texte d’origine octet pour octet
Dans MarkdownToHTML, les portées de code inline et les blocs de code clôturés ou indentés associent & à &, < à < et > à >. Les espaces deviennent des et une tabulation en devient quatre, ce qui garde l’indentation intacte. La prose ordinaire n’échappe que les chevrons : du HTML brut tapé dans la prose ne peut pas injecter de tags, tandis qu’un auteur qui écrit délibérément & obtient quand même une esperluette, comme les auteurs Markdown s’y attendent. DrawMarkdownText et DrawMarkdownTextBox exécutent la même conversion, si bien qu’un bloc de code apparaît exactement comme tapé :
uses
System.SysUtils, PDFlibrary;
procedure RenderCodeSample;
var
Lib: TPDFlib;
Md, Html: WideString;
begin
Md := 'Comparison helper:' + sLineBreak + sLineBreak +
'```' + sLineBreak +
'if (A < B) and (Flags <> 0) then' + sLineBreak +
' WriteLn(''<tag> & R&D'');' + sLineBreak +
'```';
Lib := TPDFlib.Create;
try
// Inspection du HTML : dans le code, '&' devient '&' et '<' devient '<'
Html := Lib.MarkdownToHTML(Md);
Lib.SetOrigin(1); // origine en haut à gauche, Y croît vers le bas
Lib.SetMeasurementUnits(0); // points
// La page montre le code exactement comme tapé, orthographes d’entités comprises
Lib.DrawMarkdownText(50, 50, 495, Md);
Lib.SaveToFile('code-sample.pdf');
finally
Lib.Free;
end;
end;L’exporteur de dataset est là où vit le raccourci tentant. Si un moteur ne décodait pas &, échapper l’esperluette imprimerait & dans chaque cellule qui en contient une, si bien que n’échapper que les chevrons paraît le choix le plus aimable. Cela s’effondre à la première cellule dont la valeur contient par hasard <, qui atteint alors la page comme <. Comme le moteur décode bien &, l’exporteur derrière PDFlibExportDataSet échappe & d’abord, et une valeur comme R&D < & atterrit dans le PDF verbatim. Le reste de cet exporteur est couvert dans l’export d’un TDataSet vers un rapport PDF en Delphi
Pourquoi d’abord, et pas simplement quelque part dans la chaîne ? Échappez < en premier et vous obtenez <. Échappez & en second et cela devient &lt;, qu’un décodage unique correct affiche comme < plutôt que <. Une chaîne de remplacements séquentiels ne fonctionne que quand le caractère d’échappement lui-même est traité avant toute étape qui en introduit
Comment échapper un texte non fiable pour DrawHTMLTextBox ?
Échappez le contenu texte non fiable pour PDFlibPas en remplaçant &, puis <, puis >, exactement une fois, et gardez les données non fiables hors des valeurs d’attributs entièrement. Le helper ci-dessous est à ajouter chez vous ; c’est du code RTL pur :
uses
System.SysUtils, PDFlibrary;
// Votre propre helper (pas une partie de la bibliothèque) : échappe du texte
// non fiable pour du contenu texte HTML PDFlibPas. '&' doit être remplacé en premier,
// sinon l’esperluette à l’intérieur d’un '<' tout frais produit est
// échappée une seconde fois
function EscapeHTMLText(const S: string): string;
begin
Result := StringReplace(S, '&', '&', [rfReplaceAll]);
Result := StringReplace(Result, '<', '<', [rfReplaceAll]);
Result := StringReplace(Result, '>', '>', [rfReplaceAll]);
end;
procedure RenderTicket(const CustomerComment: string);
var
Lib: TPDFlib;
Html: WideString;
begin
Lib := TPDFlib.Create;
try
Lib.SetOrigin(1);
Lib.SetMeasurementUnits(0);
Html := '<p><b>Customer comment</b></p>' +
'<p>' + EscapeHTMLText(CustomerComment) + '</p>';
Lib.DrawHTMLText(50, 50, 495, Html);
Lib.SaveToFile('ticket.pdf');
finally
Lib.Free;
end;
end;Nourrissez-le du commentaire Try <a href="https://example.com">this</a> & <b> et la page montre ces caractères un pour un. Sous un moteur qui décode deux fois, la même entrée échappée devient une annotation de lien vivante. C’est le pas du pépin cosmétique au problème de sécurité : un commentaire de ticket ne devrait jamais pouvoir planter une URL cliquable dans un PDF qui part vers votre propre personnel
Remarquez ce que le helper laisse tranquille. Les échappeurs généralistes transforment aussi " en " et ' en ', ce qui est juste pour un navigateur et faux ici — le décodage de texte PDFlibPas ne connaît que les quatre entités listées plus haut, si bien que ces deux-là s’imprimeraient littéralement comme " et '. Ne réutilisez pas un échappeur de navigateur pour cela. Les guillemets sont inoffensifs dans le contenu texte ; ils ne comptent qu’à l’intérieur de valeurs d’attributs, et le moteur ne décode pas du tout les entités dans les attributs. Pour les attributs nous préférons une règle à un échappeur plus malin, parce qu’aucun schéma d’échappement n’y est contrôlé de toute façon : gardez les valeurs utilisateur hors de href, src et style. Si une cible de lien doit vraiment venir d’une entrée utilisateur, validez-la vous-même contre une liste blanche de schémas et de caractères et rejetez tout ce qui contient des guillemets ou des chevrons
Deux habitudes découlent directement du décodage en une seule passe :
- Échappez toujours
&. Passez-le, et du texte utilisateur contenant<apparaît comme<— inoffensif, mais pas ce que l’utilisateur a tapé - Échappez à un seul endroit. Un texte qui traverse deux échappeurs rend
<comme l’orthographe visible<, alors trouvez l’unique endroit où vos données entrent dans la chaîne HTML et échappez là
Paginer avec LeftOverText sans casser les échappements
DrawHTMLTextBox renvoie le HTML qui n’entrait pas, d’habitude appelé LeftOverText, et ce reliquat garde les orthographes d’entités littérales et les chevrons échappés intacts quand il entre dans la boîte suivante. Remettez-le exactement tel que vous l’avez reçu
const
  BoxLeft = 50;
  BoxTop = 50;
  BoxWidth = 495;    // dimensionné pour une page A4 en points
  BoxHeight = 740;
  MaxPages = 500;    // votre propre garde-fou

procedure RenderLongHTML(Lib: TPDFlib; const Html: WideString);
var
  Rest: WideString;
  Pages: Integer;
begin
  Lib.SetOrigin(1);
  Lib.SetMeasurementUnits(0);
  Rest := Lib.DrawHTMLTextBox(BoxLeft, BoxTop, BoxWidth, BoxHeight, Html);
  Pages := 1;
  while (Rest <> '') and (Pages < MaxPages) do
  begin
    Lib.NewPage;
    Inc(Pages);
    // Le reliquat est déjà du HTML échappé : ne le rééchappez jamais et ne le décodez jamais
    Rest := Lib.DrawHTMLTextBox(BoxLeft, BoxTop, BoxWidth, BoxHeight, Rest);
  end;
  if Rest <> '' then
    raise Exception.CreateFmt('Content still left after %d pages', [MaxPages]);
end;
Traitez le reliquat comme opaque. C’est du HTML normalisé avec les styles déjà résolus sur chaque tag, si bien que le passer dans votre propre échappeur transforme chaque < en &lt;, et le décoder remet des tags vivants à la boîte suivante. Greffer du texte utilisateur frais dedans a les deux mêmes modes d’échec. Le plafond de pages coûte une comparaison : si quelque élément ne peut jamais entrer dans la boîte, une boucle sans plafond n’a aucune sortie naturelle
Markdown a sa propre continuation. DrawMarkdownTextBox renvoie un reliquat qui commence par un commentaire marqueur, qui dit aux points d’entrée Markdown de sauter la conversion à l’appel suivant. Remettez-le à DrawMarkdownTextBox ou DrawMarkdownText, de la même façon que vous rendriez LeftOverText à DrawHTMLTextBox. Un reliquat Markdown appartient aux points d’entrée Markdown, alors gardez-le de ce côté et ne routez que les reliquats de DrawHTMLTextBox à travers les appels HTML
La forme derrière tout cela — analyser, réécrire dans la même syntaxe, analyser encore — se retrouve aussi dans les moteurs de gabarits, les assainisseurs HTML et les chaînes Markdown vers HTML vers PDF, et l’échec arrive dans deux directions. Trop peu de réencodage transforme des données en syntaxe. Trop d’encodage, ou un décodeur qui tourne deux fois, montre des orthographes d’entités au lecteur ou les avale. Rapiécer une seule direction tend à casser l’autre, voilà pourquoi le moteur PDFlibPas traite le décodage de &, son décodage en dernier, l’absence de décodage tardif et le rééchappement à chaque frontière comme un seul paquet. La direction export suit la même règle dans l’export sémantique PDF vers Markdown et DOCX depuis Delphi, où chaque caractère littéral est échappé pour la syntaxe cible exactement une fois
Le dessin HTML et Markdown, l’exporteur de rapports de dataset et le reste du moteur de mise en page se livrent en source Pascal native dans PDF Library for Delphi, pour Delphi comme pour Free Pascal. Les éditions, la couverture de plateformes et le téléchargement d’essai sont listés sur la page produit de PDF Library for Delphi