Un demi-point décide de tout. Dans un rapport avec un corps de texte à 10 points, un titre de section composé en gras à 11 points se convertit en Markdown comme un paragraphe ordinaire, tandis qu'une légende de couverture à 12 points, en graisse normale, revient en ### Quarterly figures. Cela paraît à l'envers jusqu'à ce qu'on se rappelle ce qu'une page PDF stocke réellement : des glyphes à des coordonnées, un nom de police et une taille. Rien sur la page ne dit "titre". Chaque titre qu'émet un convertisseur est une conjecture bâtie sur ces trois faits, et la conjecture a des seuils
Pourquoi une page PDF n'a pas de paragraphes à exporter
Une page PDF contient des opérateurs d'affichage de texte, pas des paragraphes. Chaque opérateur place une suite de glyphes à une position, dans l'ordre où l'application productrice est arrivée à les émettre, et ISO 32000-1 n'impose au producteur aucune obligation de dire que deux suites appartiennent à la même phrase, et encore moins au même élément de liste ou à la même cellule de tableau. Le format décrit une page imprimée exactement, et il y parvient en jetant la structure qui a produit la page
Chaque convertisseur doit donc rebâtir ce que le générateur a jeté. Les lignes viennent des lignes de base partagées et de l'espacement vertical. Les fins de paragraphe viennent des changements d'espacement et d'indentation. Une liste est une suite de blocs qui commencent par une puce ou un motif de numéro. Un tableau est une grille de blocs de texte dont les bords s'alignent en travers des lignes et des colonnes. Sur les documents qui suivent les habitudes typographiques ordinaires, cela marche bien ; sur une brochure composée pour l'effet visuel, cela a très peu à quoi se raccrocher
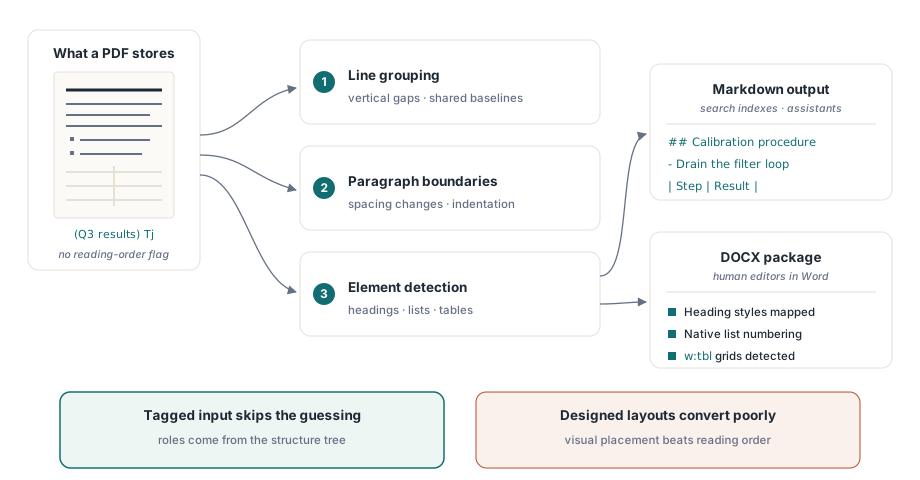
Les PDF balisés sont la grande exception. Quand un document porte un arbre de structure, les rôles de paragraphe, de titre, de liste et de tableau sont enregistrés par le producteur au lieu d'être devinés ensuite, et voilà pourquoi le travail décrit dans la structure d'accessibilité des PDF balisés paie aussi en qualité de conversion. Si vous maîtrisez le producteur, baliser la sortie est la chose la moins chère que vous puissiez faire pour qui devra la convertir plus tard
D'où viennent les niveaux de titres
PDF Library for Delphi décide des niveaux de titres de deux façons, selon l'entrée. Sur une page balisée, un bloc dont le rôle de structure est H1 à H6 garde ce niveau, et H ou Title devient niveau 1. Sur une page non balisée, l'export retombe sur la taille de police relativement au corps de texte de la page, et il ne considère que les paragraphes d'une seule ligne de 200 caractères au plus
La règle de taille demande à la fois un ratio et un écart absolu, mesurés contre la taille dominante du corps :
| Sortie Markdown | Plus grand texte de la ligne | Avec un corps à 10 pt |
|---|---|---|
# | au moins 1,6 fois la taille du corps et au moins 4 pt de plus | 16 pt et plus |
## | au moins 1,35 fois et au moins 2,5 pt de plus | 13,5 pt et plus |
### | au moins 1,15 fois et au moins 1,25 pt de plus | 11,5 pt et plus |
Cela explique l'exemple d'ouverture. Un titre en gras à 11 points sur du texte à 10 points manque le troisième palier d'un demi-point, et la graisse ne joue aucun rôle dans le niveau. La légende de couverture à 12 points le franchit. L'écart absolu existe pour les petites tailles de corps : sur du texte de note à 6 points, un ratio seul promouvrait une ligne à 7 points en titre, et l'exigence supplémentaire de 1,25 pt empêche cela
Nous pensons que c'est le bon arbitrage. Le gras est bien trop courant à l'intérieur du corps de texte (phrases d'amorce, termes définis, totaux dans une ligne de synthèse) pour être un signal de titre fiable à lui seul, et un convertisseur qui promeut chaque ligne en gras produit un Markdown avec des douzaines de sections fantômes. Manquer quelques titres en gras uniquement coûte moins cher. Si vos documents s'appuient sur des titres en gras à la taille du corps, la correction fiable est en amont : balisez-les, ou montez la taille du titre d'un point et demi
Le gras et l'italique dans la sortie se lisent depuis le nom de police. Une suite dont le nom de police contient Bold, Black ou Demi devient **bold** ; Italic ou Oblique devient *italic*. Les producteurs qui sous-ensemblent les polices sous des noms opaques tels que F3, ou qui simulent le gras en vectorisant des glyphes normaux, ne donnent rien à lire à l'export, et ce texte arrive sans style
Export Markdown pour les pipelines de récupération
Le chemin Markdown est celui vers lequel se tourner quand la destination est un pipeline de texte : un site de documentation, un index de recherche, un corpus découpé pour un assistant. ExportPageMarkdown renvoie une page sous forme de WideString, ExportDocumentMarkdown renvoie une plage de pages, et SaveMarkdownToFile et SaveMarkdownToStream écrivent le même texte en UTF-8 sans marque d'ordre d'octets. L'absence de BOM est délibérée ; un certain nombre de générateurs de sites statiques et d'outils de diff le traitent comme du contenu
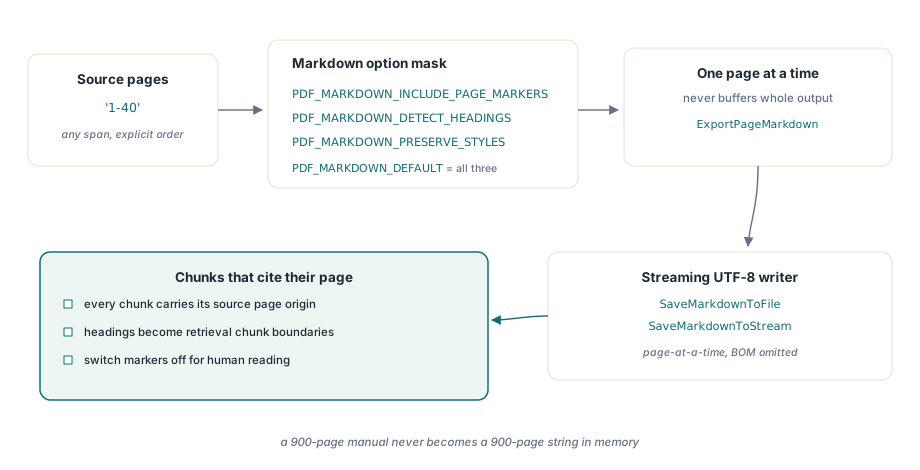
Les options sont un masque de bits : PDF_MARKDOWN_INCLUDE_PAGE_MARKERS (1), PDF_MARKDOWN_DETECT_HEADINGS (2) et PDF_MARKDOWN_PRESERVE_STYLES (4), avec PDF_MARKDOWN_DEFAULT qui combine les trois. Un second réglage, à l'échelle du document, contrôle l'analyse elle-même : SetStructuredTextOptions prend les drapeaux PDF_STRUCTURED_*, et son défaut détecte les colonnes, détecte les en-têtes et pieds courants, et rassemble les tableaux qui continuent après un saut de page
uses
  SysUtils, PDFlibrary;

var
  Pdf: TPDFlib;
  Exported: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    if Pdf.LoadFromFile('handbook.pdf', '') = 0 then
      raise Exception.Create('Cannot open handbook.pdf');

    // La détection des en-têtes et pieds courants est active par défaut ;
    // ajouter EXCLUDE_FURNITURE les retire aussi de la sortie
    Pdf.SetStructuredTextOptions(PDF_STRUCTURED_ADVANCED_DEFAULT or
      PDF_STRUCTURED_EXCLUDE_FURNITURE);

    // Marqueurs de page et titres, mais pas d'emphase ** et *
    Exported := Pdf.SaveMarkdownToFile('1-40',
      PDF_MARKDOWN_INCLUDE_PAGE_MARKERS or PDF_MARKDOWN_DETECT_HEADINGS,
      'handbook.md');
    if Exported = 0 then
      raise Exception.CreateFmt('Markdown export failed, error %d',
        [Pdf.LastErrorCode]);

    // JSON avec une entrée par page : readingSource vaut tagged, mixed,
    // geometric ou geometric-columns
    Writeln(Pdf.GetLastStructuredTextDiagnostics);
  finally
    Pdf.Free;
  end;
end;
Pour un corpus de récupération nous abandonnons PDF_MARKDOWN_PRESERVE_STYLES. L'emphase est appliquée suite par suite, si bien qu'une phrase en gras composée de plusieurs suites sort en **Net** **revenue**, ce qui se lit très bien à l'écran et ajoute du bruit à chaque embedding. Les marqueurs de page sont le cas inverse : gardez-les. Chaque marqueur est un commentaire HTML, <!-- page: 12 -->, invisible quand le Markdown est rendu et trivial à analyser quand vous découpez des fragments, si bien qu'un passage récupéré peut citer la page d'où il vient. Quand un tableau se prolonge depuis la page précédente, le marqueur de la nouvelle page est omis pour que la table à barres reste d'un seul tenant
Deux comportements piègent ceux qui exportent page par page dans une boucle. D'abord, les en-têtes courants sont reconnus par répétition : un paragraphe dans les 12 pour cent du haut ou du bas de la page compte comme mobilier quand un texte correspondant se trouve dans la même bande sur une autre page du même export, avec les chiffres normalisés pour que "Page 3 of 40" corresponde à "Page 4 of 40". Un appel mono-page n'a pas d'autre page à laquelle se comparer, si bien qu'un en-tête courant non balisé reste dans le texte. Ensuite, les images dans le Markdown sont intégrées en ligne comme des URIs data:, ce qui garde le fichier autonome et fait qu'une page avec une grande photographie peut ajouter des centaines de kilooctets de base64 au fichier. Si votre découpeur a une limite de taille, retirez les lignes commençant par 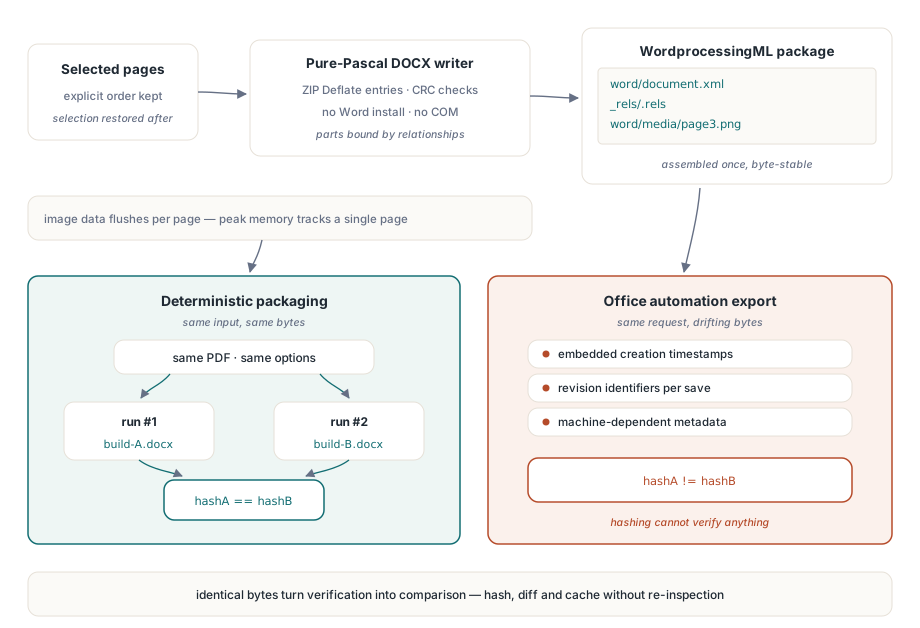
Deux choix font tenir cela. Chaque entrée ZIP porte la même date DOS figée, le 1er janvier 1980, au lieu de l'heure de l'exécution, et la partie propriétés de base n'a pas de dates de création ni de modification. Chaque entrée n'est compressée en Deflate brut que quand cela la rend réellement plus petite, si bien que les médias PNG, déjà compressés, sont stockés tels quels. Vous pouvez confirmer le premier point avec unzip -v handbook.docx : chaque ligne montre la même date
L'automatisation Office ne peut pas vous donner cela. Enregistrer via Word estampille l'heure courante dans les métadonnées du paquet et les en-têtes ZIP, si bien que le même document converti deux fois diffère de façons qui battent un hachage. Le même raisonnement est derrière les identifiants de fichier stables de les IDs PDF déterministes pour des builds reproductibles : une fois la sortie reproductible, la vérification devient une comparaison
Quelles entrées se convertissent bien, et lesquelles jamais
La qualité de conversion varie davantage avec l'entrée qu'avec le convertisseur, et cela vaut la peine de le dire à vos utilisateurs d'emblée. Les PDF balisés et les documents d'affaires proprement générés (factures, rapports, contrats) se convertissent bien : les titres atterrissent en titres, les tableaux survivent, les listes se renumérotent dans Word. Les mises en page académiques à deux colonnes passent dans le bon ordre de lecture quand la géométrie des colonnes est régulière, et les diagnostics rapporteront geometric-columns pour ces pages. Les tableaux qui se coupent entre pages sont ressemblés par inférence, alors contrôlez-les au coup par coup. Le matériel marketing très composé, où le texte est placé pour l'effet plutôt que dans l'ordre de lecture, ne laisse à aucun convertisseur grand-chose à récupérer ; attendez-vous à retoucher le résultat à la main
Les documents numérisés sont un cas à part. Une page qui est une grande image ne contient aucun objet de texte, si bien qu'il n'y a rien à exporter tant qu'une couche de texte n'existe pas, et faire tourner l'OCR est un prérequis pour les deux formats. Avant de vous engager dans un gros lot, échantillonnez une douzaine de fichiers représentatifs et énumérez ce que leurs pages contiennent, comme décrit dans la recherche de texte et l'énumération d'éléments de page ; une page avec des images et aucun run de texte vous en dira plus en une seconde que la lecture de la sortie convertie
Choisissez le format selon ce qui vient ensuite. Le Markdown convient aux machines et aux pipelines : les titres deviennent des limites de fragments, les tableaux restent lisibles en tables à barres, et les marqueurs de page donnent à chaque fragment une citation. Le DOCX convient aux gens qui doivent modifier le document, parce que ce qu'ils veulent en retour est un fichier éditable dans Word, avec de vraies listes et de vrais tableaux, et le texte seul ne leur donne pas cela
PDF Library for Delphi existe pour Delphi, C++Builder et Lazarus, avec des éditions DLL et ActiveX qui exposent les mêmes appels d'export Markdown et DOCX à C#, C++ et aux hôtes de script. La référence de chaque drapeau d'option et un téléchargement d'essai sont sur la page produit de PDF Library for Delphi