Escribe un pequeño validador. Abre un PDF, se posiciona al final, encuentra startxref, lee el desplazamiento, y espera aterrizar en la palabra clave xref con una tabla de referencias cruzadas de ancho fijo debajo. De esa tabla recoge los desplazamientos de objeto, y luego escanea hacia atrás en busca de la palabra clave trailer para averiguar /Root y /Size. Funciona perfectamente en cada archivo que generó para probarlo. Entonces llega un archivo producido por una versión actual de Word, o por una biblioteca dirigida a PDF 1.5, y el validador lo declara roto. No hay ninguna palabra clave xref donde apunta el desplazamiento, no hay ningún diccionario trailer en ninguna parte, y la tabla de objetos que construyó el validador está casi vacía. El archivo es válido. El validador lo está leyendo a través de una lente de hace quince años
Esta es la razón más común, con diferencia, por la que una comprobación de PDF a nivel de bytes escrita contra el diseño clásico falla en documentos modernos. La estructura de la que depende, la tabla de referencias cruzadas en texto plano y la palabra clave trailer, se hizo opcional en PDF 1.5 y con frecuencia está ausente. Dos funciones la sustituyeron: el flujo de referencias cruzadas y el flujo de objetos comprimido. Ambas se describen en ISO 32000-1, y un validador que no sabe de ellas ve un archivo sano como un montón de objetos ausentes
Qué cambió PDF 1.5 sobre la cola del archivo
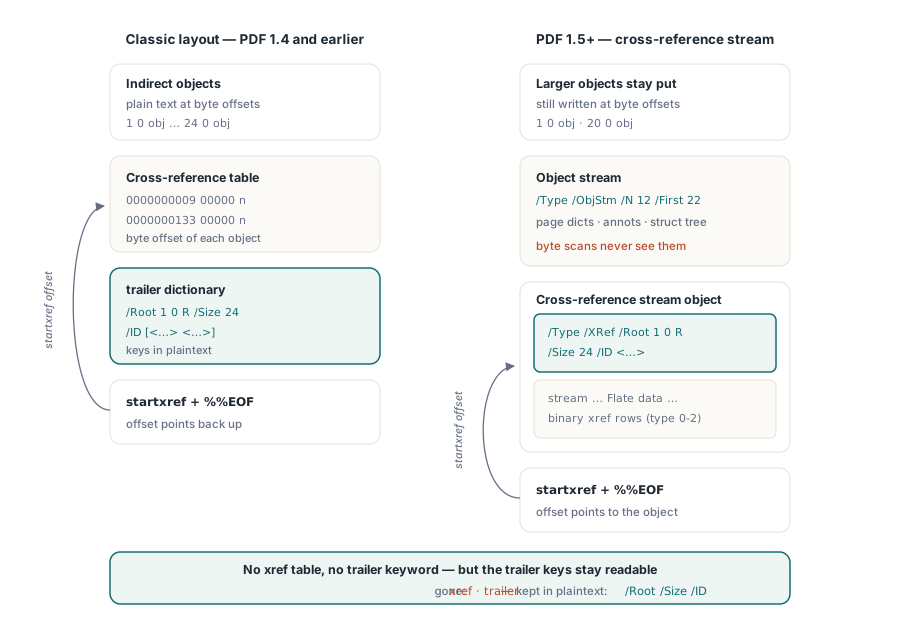
ISO 32000-1 §7.5.8 define el flujo de referencias cruzadas, y §7.5.7 define el flujo de objetos de tipo /ObjStm. Juntas permiten a quien escribe prescindir de las dos estructuras en las que se apoya un analizador clásico. Un archivo PDF 1.5 puede terminar sin ninguna tabla xref en absoluto. En su lugar, el objeto al que apunta startxref es un objeto de flujo corriente cuyo diccionario lleva /Type /XRef, y ese flujo contiene los datos de referencias cruzadas en una forma binaria compacta. Tampoco hay ninguna palabra clave trailer, porque el tráiler es ahora el propio diccionario del flujo. Las claves que un analizador clásico buscaba, /Root, /Size y /ID, viven dentro de ese diccionario
El segundo cambio traslada a los propios objetos. En lugar de escribir cada objeto indirecto en su propio desplazamiento de bytes, quien escribe puede empaquetar muchos objetos pequeños, los diccionarios de página, los diccionarios de anotación, el árbol de estructura, en un único flujo de objetos y comprimir todo el contenedor con Flate. Los objetos individuales ya no tienen un desplazamiento de bytes en el archivo. Tienen una posición dentro de un blob comprimido. Un validador que escanea los bytes crudos en busca de 1 0 obj nunca los encuentra, porque ese texto solo existe después de inflar. Para un analizador clásico, la mitad del documento simplemente ha desaparecido
Las claves del tráiler son texto sin formato, incluso en un archivo comprimido
La parte tranquilizadora es que leer el tráiler de un flujo de referencias cruzadas no exige inflar nada. Un objeto de flujo se escribe como un diccionario seguido de la palabra clave stream y después los bytes comprimidos. El diccionario es texto plano. Así que cuando startxref apunta a un flujo de referencias cruzadas, los bytes inmediatamente posteriores al número de objeto parecen un diccionario corriente, y /Root, /Size y /ID están ahí, en claro, antes de que empiecen la palabra clave stream y los datos Flate
Eso significa que un validador puede averiguar los tres datos que más necesita, dónde está el catálogo, cuántos objetos afirma tener el archivo, y el identificador de archivo, analizando solo el diccionario del flujo. No tiene que descomprimir los datos de referencias cruzadas, ni tiene que interpretar las entradas binarias que contienen. El trabajo que derrota a un analizador ingenuo no es leer el tráiler; es encontrar los objetos. Son dos problemas separables, y resolver el primero es barato
Flujos de objetos: una cabecera, después un blob Flate
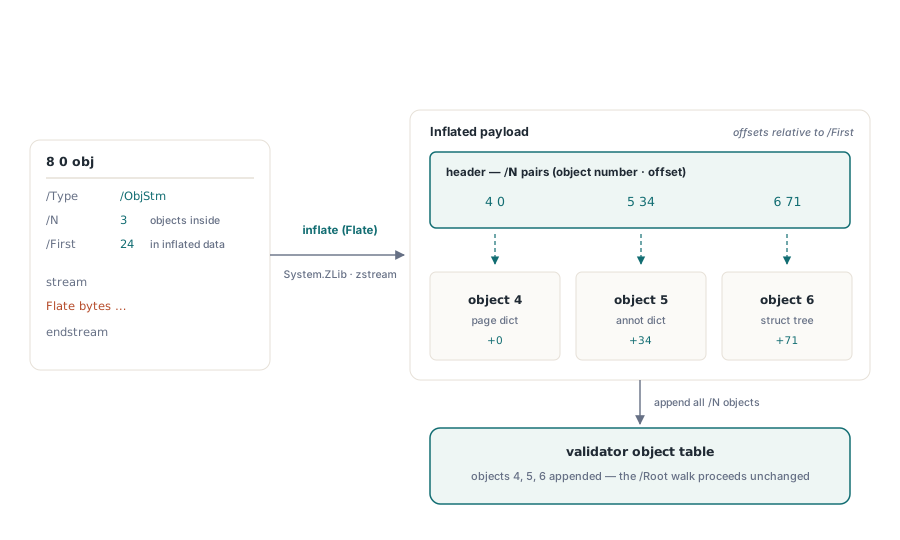
Un flujo de objetos es un contenedor. Su diccionario lleva /Type /ObjStm, una entrada /N que da el número de objetos empaquetados dentro, y una entrada /First que da el desplazamiento de bytes, dentro de los datos inflados, donde empieza el cuerpo del primer objeto. La carga útil comprimida, una vez inflada, empieza con una pequeña cabecera de pares de enteros /N. Cada par es un número de objeto y el desplazamiento del cuerpo de ese objeto en relación con /First. Después de la cabecera vienen los propios cuerpos de objeto, concatenados
Expandir uno es mecánico una vez inflados los bytes. Lee el diccionario para obtener /N y /First, infla el flujo con un decodificador Flate, recorre los /N pares iniciales para averiguar qué número de objeto vive en qué desplazamiento, y después extrae cada cuerpo como si fuera un objeto indirecto corriente. La única dependencia real es el decodificador Flate, y ya tiene uno: Delphi incluye System.ZLib, y Free Pascal incluye la unidad zstream, ambos envuelven zlib e inflan un flujo Flate crudo sin ningún código de terceros. Una rutina que añade cada objeto extraído a la tabla de objetos del validador hace que el resto del validador, la parte que recorre /Root y comprueba el árbol de páginas, se comporte exactamente como lo haría con un archivo clásico
Lo que no tiene que implementar
Es fácil sobrestimar el trabajo. Leer las claves del tráiler de un archivo comprimido no exige decodificar las entradas binarias del flujo de referencias cruzadas. El flujo de referencias cruzadas de §7.5.8 usa tres tipos de entrada, y la entrada de tipo 2, la que dice este objeto vive dentro del flujo de objetos N en el índice i
, es lo que decodificaría para construir un mapa de desplazamientos completo. Necesita ese mapa para resolver objetos arbitrarios por número. No lo necesita para leer /Root, /Size y /ID, que están en el diccionario de texto plano, y no lo necesita para expandir flujos de objetos, porque cada /ObjStm anuncia su propio contenido mediante /N y /First
Tampoco tiene que gestionar las funciones predictoras PNG y TIFF que un flujo de referencias cruzadas puede aplicar mediante su /DecodeParms, solo para obtener las claves del tráiler. Los predictores filtran las filas binarias de referencias cruzadas para que compriman mejor; no tienen nada que ver con el diccionario que precede al flujo. La actualización mínima que hace que un validador clásico sea consciente del PDF moderno es, por tanto, pequeña: cuando startxref aterriza en un flujo en lugar de en la palabra clave xref, analice el diccionario del flujo en busca de las claves del tráiler, y expanda cualquier objeto /ObjStm que encuentre para que su contenido entre en la tabla de objetos. Decodificar las entradas de tipo 2 y los predictores es una tarea aparte y más grande que puede posponer hasta que realmente necesite la resolución aleatoria de objetos
Por qué una comprobación de conformidad debe expandir primero los flujos
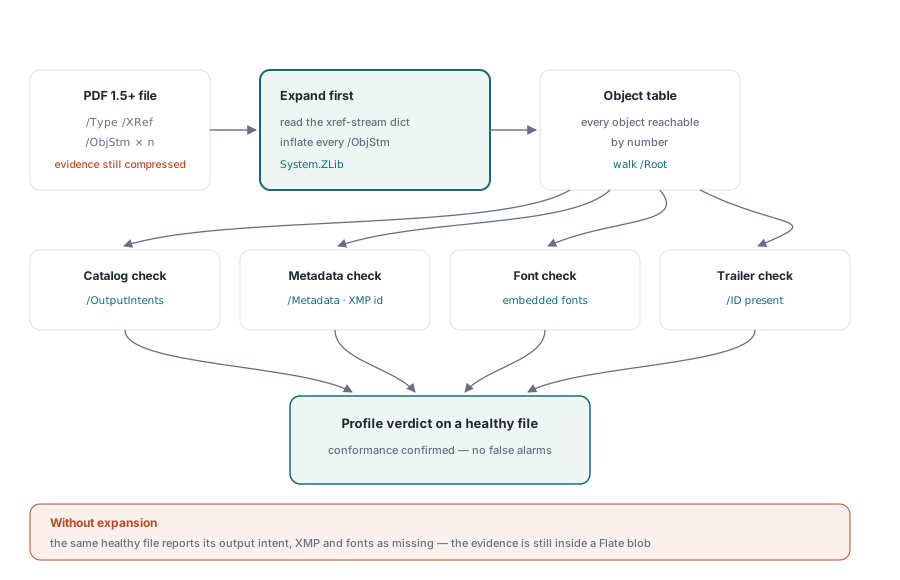
Esto deja de ser académico en el momento en que ejecuta una comprobación de perfil. Un validador PDF/A o PDF/X inspecciona objetos concretos: el catálogo del documento en busca de un array /OutputIntents, el flujo /Metadata en busca de un paquete XMP con el identificador correcto, cada descriptor de fuente en busca de un archivo de fuente incrustado, el tráiler en busca de un /ID. En un archivo comprimido, la mayoría de esos objetos están dentro de flujos de objetos. Un validador que no ha expandido los flujos de objetos no puede ver las claves del catálogo, no puede encontrar los metadatos, y no puede enumerar las fuentes. Informará de que un documento perfectamente conforme carece de su intención de salida, carece de su XMP, y carece de la mitad de su estructura, porque la evidencia que necesita sigue alojada en un blob Flate que nunca infló
El orden importa. La expansión tiene que suceder antes de que se ejecuten las comprobaciones, no junto a ellas, porque toda comprobación asume que puede alcanzar un objeto por número. Si conecta una comprobación de perfil directamente a un escaneo de bytes crudos, hereda la ceguera del analizador clásico y produce violaciones falsas precisamente en los archivos modernos que tienen más probabilidad de estar bien formados, ya que salieron de cadenas de herramientas lo bastante nuevas como para escribir flujos de referencias cruzadas en primer lugar
Dejar que PDFium analice por usted
El PDFium Component analiza flujos de referencias cruzadas y flujos de objetos como parte de la carga de un documento, que es la manera práctica de evitar programar a mano el paso de inflar y expandir. Cuando carga un archivo con el componente TPdf, los objetos empaquetados en contenedores /ObjStm ya están resueltos, y los puntos de entrada de validación ven el documento totalmente expandido. ValidatePdfA devuelve un registro TPdfAValidationResult cuyo campo Conformance es un valor TPdfAConformance como pac1b o pacNone, cuyo campo Issues es un conjunto de los problemas específicos encontrados, y cuyo método IsCompliant es verdadero solo cuando se detectó un nivel de conformidad y el conjunto de problemas está vacío. Como los objetos se expandieron durante la carga, un array /OutputIntents o una fuente incrustada que vivía dentro de un flujo de objetos se encuentra, no se informa como ausente
uses
  PDFium, FPdfPdfa;

function CheckPdfA(const FileName: string): TPdfAValidationResult;
var
  Pdf: TPdf;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;            // analiza flujos xref/de objetos al cargar
    Result := Pdf.ValidatePdfA;    // ve la tabla de objetos expandida
  finally
    Pdf.Free;
  end;
end;
Lo mismo aplica a ValidatePdfX, que devuelve un TPdfXValidationResult con la misma forma. El punto de encauzar todo a través de PDFium es que la descompresión estructural descrita arriba sucede una vez, correctamente, dentro del cargador, así que su código de validación nunca ve la diferencia entre un archivo clásico y uno totalmente comprimido. Ambos llegan al validador como un conjunto resuelto de objetos
function PdfXConformanceName(C: TPdfXConformance): string;
begin
  case C of
    pxc1a: Result := 'PDF/X-1a';
    pxc3 : Result := 'PDF/X-3';
    pxc4 : Result := 'PDF/X-4';
  else
    Result := 'none';
  end;
end;

var
  Pdf: TPdf;
  R  : TPdfXValidationResult;
  Issue: TPdfXValidationIssue;
  IssueCount: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'Press_Ready.pdf';
    Pdf.Active := True;
    R := Pdf.ValidatePdfX;
    if R.IsCompliant then
      Writeln('PDF/X conformance: ', PdfXConformanceName(R.Conformance))
    else
    begin
      IssueCount := 0;
      for Issue in R.Issues do   // Issues es un conjunto: cuenta sus miembros
        Inc(IssueCount);
      Writeln('Not conformant; issue count = ', IssueCount);
    end;
  finally
    Pdf.Free;
  end;
end;
Si los bytes ya están en memoria en lugar de en disco, la misma secuencia de cargar y después validar funciona a través de la sobrecarga LoadDocument(const Data: TBytes), que toma el contenido crudo del archivo y analiza sus flujos de referencias cruzadas y de objetos de la misma manera que lo hace la ruta de archivo. La lección para un validador escrito a mano es la regla estructural, no la API: lea las claves del tráiler del diccionario del flujo en texto plano, expanda cada /ObjStm con un decodificador Flate antes de recorrer el documento, y trate la decodificación de las entradas binarias de referencias cruzadas como la tarea más grande y opcional que es
Una vez expandida la estructura, un validador puede impulsar el resto de un flujo de trabajo sobre ella. Para un arnés de preflight de línea de comandos que informa de la conformidad en toda una carpeta de entradas, vea nuestro recorrido sobre cómo construir un CLI de informe de preflight por lotes. Cuando la validación es una puerta previa a desmontar un documento grande, las técnicas de nuestra guía para dividir documentos PDF en varios archivos combinan de forma natural con el patrón de cargar y comprobar mostrado aquí. Ambas se construyen sobre la superficie de carga y validación del PDFium Component para Delphi y C++Builder