Para un manual de usuario de 40 páginas cuyo primer marcador de primer nivel apunta a la página 5, un divisor que corta «de este marcador al siguiente» escribe ficheros de capítulo que suman 36 páginas. La portada, la página de copyright y una tabla de contenido de dos páginas van delante de toda entrada del esquema, así que nunca aterrizan en fichero alguno. Un esquema solo marca dónde empiezan las secciones. No cubre lo que va antes de la primera entrada, y nada en el formato exige que las entradas vayan listadas en orden de páginas, así que un divisor fiable recoge las páginas de los marcadores como puntos de corte, las ordena y añade un rango explícito de material previo
Un solo bucle detrás de cada modo de división
PDFium Component divide un documento con los mismos cuatro pasos sobre un segundo TPdf, decida lo que decida los límites: CreateDocument arranca un PDF vacío en memoria, ImportPages copia un rango de páginas del origen hacia él, SaveAs escribe el fichero, y Active := False cierra de nuevo la salida. La división página a página, los trozos de tamaño fijo y las secciones por marcador difieren solo en el string de rango que se entrega a ImportPages
El reinicio al final de cada pasada no es opcional. CreateDocument se niega a correr sobre un componente que siga activo y lanza un EPdfError cuyo mensaje empieza por "Cannot perform this operation on an active", así que la segunda iteración de un bucle que olvida Active := False se para con una excepción después de haber escrito exactamente un fichero. Poner el reinicio en un bloque finally evita que una importación o guardado fallido dejen la salida abierta para la siguiente pasada. Una única instancia de TPdf sirve para toda la corrida, y solo un documento de salida está en memoria en cada momento
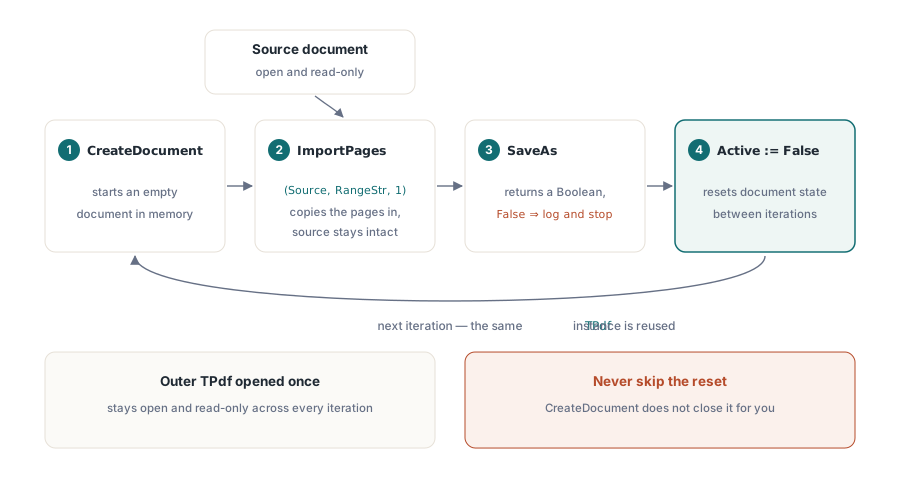
Abrir el origen merece su propia comprobación. Asignar Active := True jamás lanza: cuando el fichero falta, está dañado o necesita una contraseña que no se suministró, TPdf captura el error de carga y deja Active en False. ImportPages también intenta activar el origen por su cuenta, lo que significa que un origen sin abrir solo asoma como un retorno False en la primera página y no da pista alguna de la causa. Abrirlo explícitamente y comprobar Active convierte eso en un error que nombra el fichero antes de que exista salida alguna:
procedure SplitIntoPages(const SourceFile, OutputDir: string);
var
  Source, PdfOut: TPdf;
  I: Integer;
  OutFile: string;
begin
  Source := TPdf.Create(nil);
  PdfOut := TPdf.Create(nil);
  try
    Source.FileName := SourceFile;
    Source.Active := True;               // un fallo de carga deja Active = False
    if not Source.Active then
      raise Exception.Create('Cannot open ' + SourceFile);

    for I := 1 to Source.PageCount do
    begin
      PdfOut.CreateDocument;             // lanza mientras PdfOut siga activo
      try
        // El rango es base 1; la posición 1 es el inicio del documento vacío
        if not PdfOut.ImportPages(Source, IntToStr(I), 1) then
          raise Exception.CreateFmt('Cannot import page %d', [I]);
        OutFile := IncludeTrailingPathDelimiter(OutputDir) +
          Format('page_%.4d.pdf', [I]);
        if not PdfOut.SaveAs(OutFile) then
          raise Exception.Create('Cannot save ' + OutFile);
      finally
        PdfOut.Active := False;          // cerrad la salida antes de la siguiente pasada
      end;
    end;
  finally
    PdfOut.Free;
    Source.Free;
  end;
end;
El tercer argumento de ImportPages es la posición base 1 en el destino donde aterriza la primera página importada. En un documento vacío, 1 es la única posición que hay. La sintaxis del rango en sí (páginas sueltas, tramos cerrados como '5-10', listas por comas) y los fallos de posición que invierten un paquete fusionado están cubiertos en cómo fusionar varios ficheros PDF en un documento, que es la misma API apuntada al revés
Trozos de tamaño fijo y rangos suministrados por quien llama
Cortar un documento cada N páginas es un problema de conteo, y el único caso que necesita cuidado es la cola. Un escaneo de 230 páginas dividido en partes de 25 páginas da nueve partes completas y una décima de cinco páginas, así que el final de cada tramo se recorta a Source.PageCount:
procedure SplitEvery(Source: TPdf; ChunkSize: Integer; const OutputDir: string);
var
  PdfOut: TPdf;
  FirstPage, LastPage, Part: Integer;
  Range, OutFile: string;
begin
  if ChunkSize < 1 then
    raise Exception.Create('ChunkSize must be at least 1');
  PdfOut := TPdf.Create(nil);
  try
    Part := 0;
    FirstPage := 1;
    while FirstPage <= Source.PageCount do
    begin
      LastPage := FirstPage + ChunkSize - 1;
      if LastPage > Source.PageCount then
        LastPage := Source.PageCount;    // la última parte suele ser más corta
      if FirstPage = LastPage then
        Range := IntToStr(FirstPage)     // una cola de una página como número plano
      else
        Range := Format('%d-%d', [FirstPage, LastPage]);
      Inc(Part);

      PdfOut.CreateDocument;
      try
        if not PdfOut.ImportPages(Source, Range, 1) then
          raise Exception.Create('Cannot import pages ' + Range);
        OutFile := IncludeTrailingPathDelimiter(OutputDir) +
          Format('part_%.3d.pdf', [Part]);
        if not PdfOut.SaveAs(OutFile) then
          raise Exception.Create('Cannot save ' + OutFile);
      finally
        PdfOut.Active := False;
      end;
      FirstPage := LastPage + 1;
    end;
  finally
    PdfOut.Free;
  end;
end;
Los rangos tecleados por un usuario son otra historia. ImportPages reporta un rango malo a través de su valor de retorno: un número de página que se pasa de Source.PageCount, un cero, un tramo invertido o texto que no parsea hacen que la llamada devuelva False, y ninguna de las páginas de ese string se copia. Dentro de un bucle, ese fallo llega en la cuarta entrada cuando ya existen tres ficheros de sección en disco. Comprobar cada entrada contra Source.PageCount antes del primer CreateDocument cuesta unas líneas de parseo y significa que una errata en la entrada cuarta no escribe nada, que es el comportamiento que espera quien reintenta el trabajo
Cuando la selección ya vive en un array de enteros, por ejemplo páginas marcadas en una vista de miniaturas, ImportPagesByIndex(Source, PageIndices, InsertAt) se salta el paso del string. Tanto los índices como InsertAt son base cero allí, así que la misma selección que como rango se lee '1,3-5' se convierte en [0, 2, 3, 4]
¿Por qué las secciones por marcador salen cortas o desaparecen?
Las secciones por marcador salen mal cuando el código confía en que el esquema esté ordenadito. TPdf.Bookmarks devuelve las entradas de primer nivel en el orden en que el autor las dispuso, cada una como un record TBookmark con un Title y un PageNumber base 1. Cuatro cosas en ficheros reales rompen la regla ingenua de «de esta entrada a la siguiente»:
- Un elemento del esquema puede llevar su destino como entrada
/Desto como acción GoTo en/A(ISO 32000-1 §12.3.3 y §12.6.4.2).PageNumberse rellena desde/Dest; en un elemento basado en acción se queda en0y la página está enActionPageNumberen su lugar - El orden del esquema es el orden de lectura tal como lo vio el autor. Una entrada «Index» colocada segunda, o un apéndice listado antes de los capítulos, hace que «el marcador siguiente menos uno» sea menor que el inicio actual, y esa sección desaparece
- Dos entradas de primer nivel pueden apuntar a la misma página, típicamente un título de parte y su primer capítulo
- Una entrada puede apuntar más allá de la última página cuando se borraron páginas con una herramienta que dejó el esquema tal cual
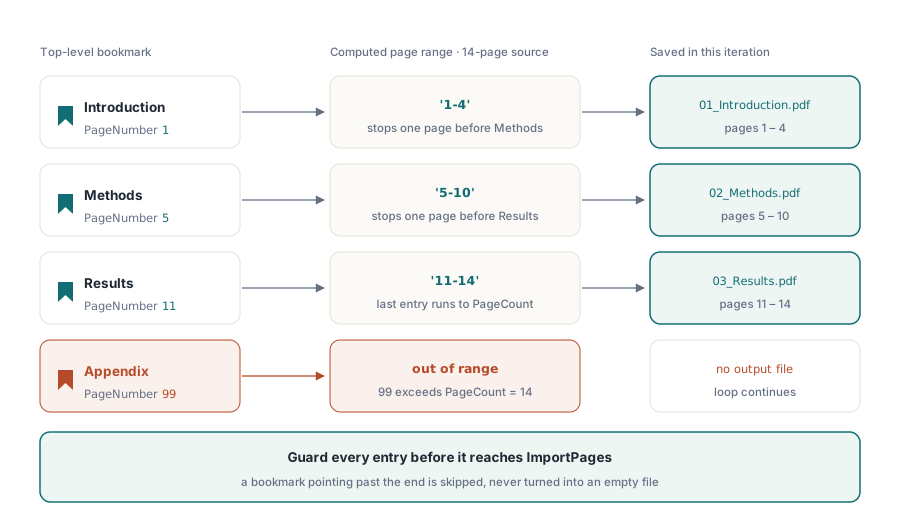
La versión de abajo trata el esquema como una fuente de puntos de corte. Resuelve la página de cada entrada, suelta las entradas que no apuntan a ninguna parte o se pasan del final, conserva el primer título de una página compartida, ordena por número de página y añade una sección «Front matter» cuando el primer corte cae después de la página 1. El material previo recibe aquí su propio fichero en lugar de pegarse al capítulo 1, porque quien recibe el capítulo 1 espera que se abra en la página que nombraba el marcador, no en una tabla de contenido
procedure SplitByBookmarks(Source: TPdf; const OutputDir: string);
var
  Bm: TBookmarks;
  Starts: array of Integer;
  Titles: array of string;
  I, J, K, N, P, EndPage: Integer;
  Known: Boolean;
  PdfOut: TPdf;
  OutFile: string;
begin
  Bm := Source.Bookmarks;                // solo entradas de primer nivel
  if Length(Bm) = 0 then
    Exit;                                // nada por lo que cortar
  SetLength(Starts, Length(Bm) + 1);     // +1 deja sitio para el material previo
  SetLength(Titles, Length(Bm) + 1);
  N := 0;
  for I := 0 to High(Bm) do
  begin
    P := Bm[I].PageNumber;               // resuelto desde /Dest
    if P < 1 then
      P := Bm[I].ActionPageNumber;       // resuelto desde una acción GoTo en /A
    if (P < 1) or (P > Source.PageCount) then
      Continue;                          // sin resolver, o más allá de la última página
    Known := False;
    for J := 0 to N - 1 do
      if Starts[J] = P then
        Known := True;                   // el primer título de una página gana
    if Known then
      Continue;
    J := N;                              // ordenación por inserción por número de página
    while (J > 0) and (Starts[J - 1] > P) do
    begin
      Starts[J] := Starts[J - 1];
      Titles[J] := Titles[J - 1];
      Dec(J);
    end;
    Starts[J] := P;
    Titles[J] := Bm[I].Title;
    Inc(N);
  end;
  if N = 0 then
    Exit;
  if Starts[0] > 1 then                  // portada, índice y todo lo anterior
  begin
    for J := N downto 1 do
    begin
      Starts[J] := Starts[J - 1];
      Titles[J] := Titles[J - 1];
    end;
    Starts[0] := 1;
    Titles[0] := 'Front matter';
    Inc(N);
  end;

  PdfOut := TPdf.Create(nil);
  try
    for K := 0 to N - 1 do
    begin
      if K < N - 1 then
        EndPage := Starts[K + 1] - 1
      else
        EndPage := Source.PageCount;
      PdfOut.CreateDocument;
      try
        if not PdfOut.ImportPages(Source,
          Format('%d-%d', [Starts[K], EndPage]), 1) then
          raise Exception.CreateFmt('Cannot import pages %d-%d',
            [Starts[K], EndPage]);
        // Declarad SafeFileName (mostrada más abajo) antes de esta rutina
        OutFile := IncludeTrailingPathDelimiter(OutputDir) +
          Format('%.2d_%s.pdf', [K + 1, SafeFileName(Titles[K])]);
        if not PdfOut.SaveAs(OutFile) then
          raise Exception.Create('Cannot save ' + OutFile);
      finally
        PdfOut.Active := False;
      end;
    end;
  finally
    PdfOut.Free;
  end;
end;
Como los inicios quedan estrictamente crecientes tras la ordenación, cada tramo calculado es válido y la guarda de ImportPages no debería dispararse jamás con un origen legible. Un documento sin marcadores sencillamente no produce ficheros en este modo; quien llama decide si eso recae en el troceado. Para cortar un nivel más profundo, por ejemplo en capítulos dentro de partes, BookmarkChildren[Bm[I]] devuelve los hijos de una entrada de primer nivel en la misma forma TBookmarks, y la misma lógica de puntos de corte aplica a la lista combinada
Qué lleva cada fichero de salida
Cada fichero de salida lleva las páginas en sí y todo aquello a lo que sus diccionarios de página referencian: content streams, fuentes, imágenes y la lista de anotaciones de cada página. Los widgets de formulario vienen como anotaciones, pero el fichero nuevo no tiene AcroForm, así que dejan de ser campos operativos. El origen solo se lee. ImportPages copia objetos al documento nuevo y deja el origen abierto intacto, así que la misma instancia Source alimenta cada iteración
El esquema se queda atrás. Los marcadores viven en el catálogo del documento bajo /Outlines (ISO 32000-1 §7.7.2), fuera de toda página, así que un fichero construido desde páginas importadas empieza sin marcador alguno. Para ficheros de capítulo eso suele ir bien. Cuando cada parte necesita su propia navegación, el esquema hay que construirlo para la nueva numeración de páginas, que es el asunto de editar un esquema PDF y remapear sus páginas. Los enlaces internos se portan igual: un enlace «ver capítulo 7» en la página 12 apunta a una página que se fue a otro fichero, y en este fichero no tiene donde aterrizar
Los orígenes cifrados necesitan la contraseña antes de que arranque el bucle. Asignad Source.Password con el componente inactivo, y luego poned Active := True; con la contraseña equivocada el componente se queda inactivo, lo que la comprobación de SplitIntoPages convierte en un error. La salida que escribe SaveAs es un documento nuevo sin diccionario de cifrado. Eso conviene a los ficheros divididos pensados para destinatarios distintos, y cuando cada parte tiene que protegerse de nuevo, SaveAsEncrypted(FileName, Options) recibe un record TPdfEncryptOptions con sus propias contraseñas de usuario y propietario
Nombres de fichero, guardados fallidos y reejecuciones
Los títulos de marcador son cadenas de texto PDF y pueden contener cualquier cosa, incluidos caracteres que Windows rechaza en nombres de fichero. Las reglas vienen del sistema de ficheros, no del PDF: < > : " / \ | ? * y los caracteres de control son inválidos, los espacios y puntos finales los recortan las APIs de fichero Win32, y nombres como CON, PRN o COM1 son dispositivos reservados. El prefijo numerado de SplitByBookmarks ya se encarga de los nombres de dispositivo, mantiene los ficheros en orden de lectura en un listado de directorio, y evita que dos capítulos titulados ambos «Summary» se sobreescriban. El resto es una función pequeña que escribís vosotros:
// Ayudante del lado del lector, no forma parte de PDFium Component
function SafeFileName(const Title: string): string;
const
  Forbidden = '<>:"/\|?*';
var
  I: Integer;
begin
  Result := Title;
  if Length(Result) > 80 then
    SetLength(Result, 80);               // mantiene las rutas completas bien por debajo de MAX_PATH
  for I := 1 to Length(Result) do
    if (Ord(Result[I]) < 32) or (Pos(Result[I], Forbidden) > 0) then
      Result[I] := '_';
  while (Result <> '') and
    ((Result[Length(Result)] = '.') or (Result[Length(Result)] = ' ')) do
    SetLength(Result, Length(Result) - 1);
  if Result = '' then
    Result := 'section';
end;
SaveAs con un nombre de fichero escribe a un fichero temporal en la carpeta de destino y lo cambia a su sitio solo después de que el guardado tenga éxito. El destino es, por tanto, o el fichero anterior o uno nuevo completo, nunca escrito a medias, así que reejecutar una división sobre una carpeta de salida existente es inofensivo. Los fallos vuelven por dos caminos. SaveAs devuelve False cuando el documento no puede serializarse, y el fichero temporal se elimina. Los problemas del sistema de ficheros, como una carpeta de salida que no existe, una ruta que el SO rechaza o un destino bloqueado por un visor, lanzan una excepción desde la capa de ficheros
Cómo reacciona un lote ante esos fallos es una elección, y para dividir difiere de fusionar. Un paquete fusionado al que le falta una parte es un documento equivocado, así que pararse es lo correcto ahí. Las salidas divididas son independientes entre sí: si section_147.pdf no puede escribirse porque un colega lo tiene abierto, las demás secciones siguen siendo buenas. Para trabajos de división, cazad las excepciones por fichero dentro del bucle, registrad el nombre de fichero y el mensaje, seguid, y comparad al acabar el bucle el número de ficheros escritos con el número de rangos previstos. Los ejemplos de arriba lanzan al primer fallo solo para ser breves. Un log que dice que se escribieron 199 de 200 ficheros y nombra el bloqueado se arregla con una reejecución, mientras que una corrida que abortó en el fichero 147 deja a alguien calculando cuáles 53 ficheros faltan
El bucle de división, los records de marcadores y el guardado cifrado usados aquí vienen todos con PDFium Component, la biblioteca PDF basada en PDFium para Delphi y C++Builder