Importa un FDF en un formulario y los valores de los campos vuelven sutilmente mal: una viñeta llega como una daga, unos puntos suspensivos como una raya. PDFium Component rastreó toda esa familia de síntomas hasta una sola fila de su tabla PDFDocEncoding — el bloque de caracteres especiales del Anexo D.2 de ISO 32000-1 empieza en $80, no en $7F
¿Por qué una importación FDF devuelve el carácter vecino?
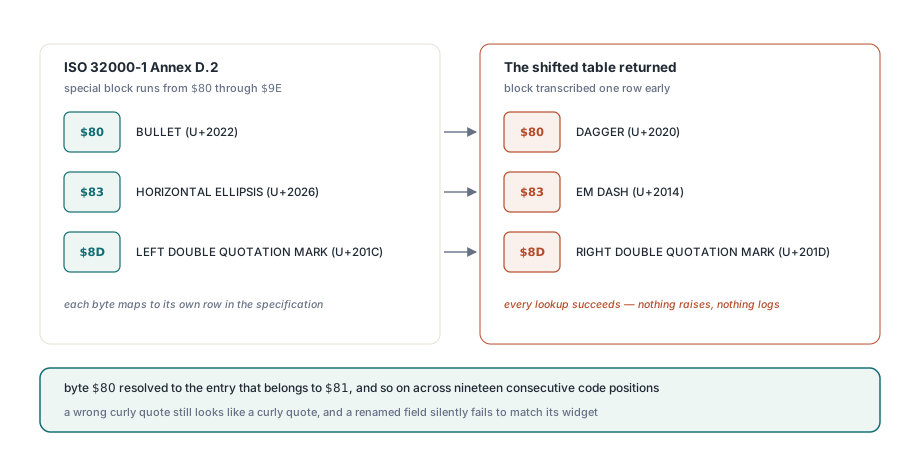
Porque una tabla de codificación desplazada una posición sigue siendo una tabla con aspecto perfectamente válido, y todas las búsquedas en ella tienen éxito. El bloque que el Anexo D.2 asigna de $80 a $9E se había transcrito una fila antes, así que el byte $80 resolvía a la entrada que pertenece a $81, el byte $81 a la entrada de $82, y así a lo largo de diecinueve posiciones de código consecutivas. Nada saltó, nada se logueó y ningún campo fue rechazado jamás — TPdf.ImportFDF reportó el mismo recuento de campos de siempre
El daño era uniforme y silencioso. Un byte con $80, que el Anexo D.2 define como BULLET (U+2022), volvía como DAGGER (U+2020). El byte $83, HORIZONTAL ELLIPSIS (U+2026), volvía como EM DASH (U+2014). El byte $8D, LEFT DOUBLE QUOTATION MARK (U+201C), volvía como RIGHT DOUBLE QUOTATION MARK (U+201D) — el caso que nadie nota, porque una comilla curva equivocada sigue pareciendo una comilla curva en un campo de formulario. Los nombres de campo sufrían la misma suerte que los valores, que es peor: un nombre que ya no coincide con el widget del documento falla silenciosamente al aplicarse
Los strings de texto de PDF llevan dos codificaciones distintas
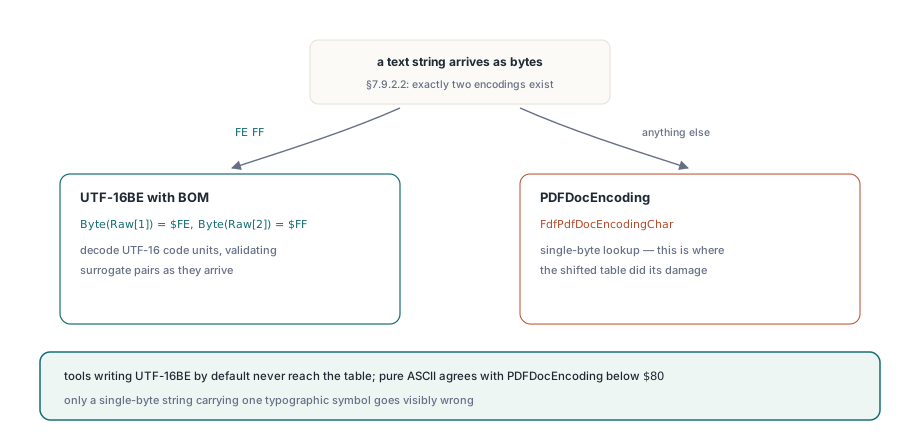
ISO 32000-1 §7.9.2.2 define el tipo de string de texto como una de exactamente dos codificaciones, elegida inspeccionando los dos primeros bytes y no por ninguna entrada de diccionario. Un string que abre con la marca de orden de bytes FE FF es UTF-16BE; cualquier otra cosa es PDFDocEncoding. Esa única rama decide cuál de dos decodificadores completamente distintos corre, y PDFium Component la aplica dentro del parser FDF antes de tocar un solo carácter
// String de texto FDF: UTF-16 si hay BOM, PDFDocEncoding en caso contrario
if (Length(Raw) >= 2) and
   (((Byte(Raw[1]) = $FE) and (Byte(Raw[2]) = $FF)) or
    ((Byte(Raw[1]) = $FF) and (Byte(Raw[2]) = $FE))) then
begin
  BigEndian := Byte(Raw[1]) = $FE;
  // ... decodifica unidades de código UTF-16, validando pares de sustitución
end
else
begin
  SetLength(Result, Length(Raw));
  for I := 1 to Length(Raw) do
    Result[I] := FdfPdfDocEncodingChar(Byte(Raw[I]));
end;
Por eso el bug se escondió tanto tiempo en las pruebas ordinarias. Cualquier FDF producido por una herramienta que escribe UTF-16BE por defecto no llega nunca a FdfPdfDocEncodingChar, así que la tabla desplazada se queda dormida. Solo los strings de un solo byte — que es lo que muchos generadores de FDF emiten para nombres de campo latinos simples, porque son más cortos — bajan por la rama donde la tabla importa. Los nombres de campo ASCII puros se decodifican bien de todos modos, porque por debajo de $80 PDFDocEncoding y ASCII coinciden. Necesitas un string de un solo byte que contenga un símbolo tipográfico antes de que nada se vea mal
La tabla corregida, y los dos anclajes que la fijan
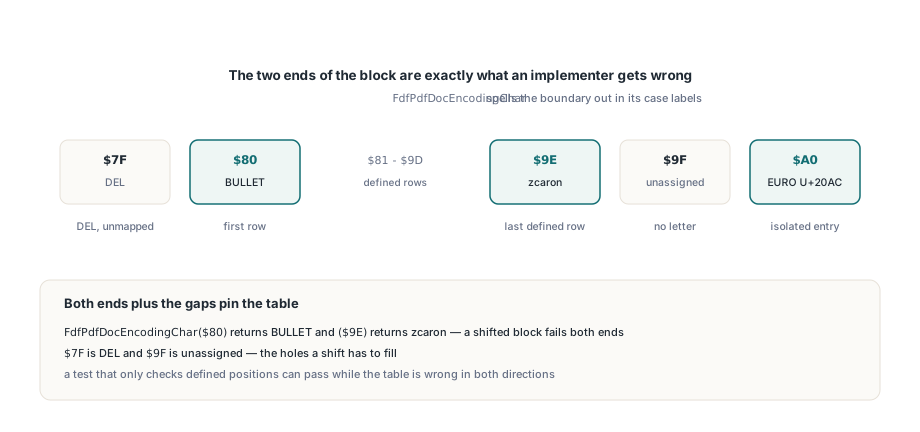
PDFium Component ahora explicita el límite en el propio FdfPdfDocEncodingChar, porque los dos extremos del bloque son exactamente lo que un implementador se salta. $7F es DEL y no tiene ningún significado PDFDocEncoding; el bloque abre en $80 con BULLET y corre hasta $9E con zcaron; $9F está sin asignar; y el signo del euro se sienta solo en $A0
function FdfPdfDocEncodingChar(Value: Byte): WideChar;
begin
  case Value of
    // Anexo D.2 de ISO 32000-1. El bloque va de $80, no de $7F: $7F es DEL y
    // no tiene significado PDFDocEncoding, y el euro está en $A0, que la
    // rama por defecto devolvería como espacio de no separación
    $7F: Result := WideChar($FFFD);
    $80: Result := WideChar($2022);   // BULLET, primera fila del bloque
    $81: Result := WideChar($2020);   // DAGGER
    // ... de $82 a $9D
    $9E: Result := WideChar($017E);   // zcaron, última fila definida
    $9F: Result := WideChar($FFFD);   // sin asignar en el Anexo D.2
    $A0: Result := WideChar($20AC);   // EURO SIGN
  else
    Result := WideChar(Value);
  end;
end;
Mira lo que el desplazamiento le hizo a esos dos extremos, porque ahí es donde un off-by-one deja de ser cosmético. zcaron estaba en $9E en la especificación pero en $9D en la tabla desplazada, así que un byte de documento $9E caía más allá de la última fila que alguien había transcrito y se colaba directo al fallback de identidad, devolviendo un carácter de control C1 en lugar de una letra. Y $A0, el euro, nunca se escribió en la tabla en primer lugar — la rama de identidad lo devolvía como U+00A0 NO-BREAK SPACE, un carácter que sobrevive a toda validación posterior, no imprime nada y nunca coincide con el nombre de campo que buscas
¿Cómo pruebas una tabla de codificación transcrita?
Prueba la primera fila, la última fila y los huecos — no una muestra del medio. Esta es la parte del arreglo que merece la pena llevarse a cualquier otra tabla que copies de una especificación, porque una comprobación al azar en medio del bloque es precisamente la prueba que un desplazamiento de bloque entero sobrevive. Verificar que $8D da una comilla doble izquierda no prueba nada cuando $8C también da algo plausible; verificar que $80 da BULLET y $9E da zcaron fija ambos extremos, y un bloque desplazado no puede satisfacer los dos a la vez
procedure CheckPdfDocEncodingAnchors;
begin
  // Ambos extremos del bloque especial del Anexo D.2: un desplazamiento de bloque entero los rompe
  Assert(FdfPdfDocEncodingChar($80) = WideChar($2022), 'first row: BULLET');
  Assert(FdfPdfDocEncodingChar($9E) = WideChar($017E), 'last row: zcaron');
  // Las posiciones de código que la especificación deja sin definir no deben decodificar a una letra
  Assert(FdfPdfDocEncodingChar($7F) = WideChar($FFFD), '$7F is DEL, unmapped');
  Assert(FdfPdfDocEncodingChar($9F) = WideChar($FFFD), '$9F is unassigned');
  // La entrada aislada por encima del bloque, fácil de omitir del todo
  Assert(FdfPdfDocEncodingChar($A0) = WideChar($20AC), 'EURO SIGN');
end;
Las posiciones sin definir merecen sus propios asserts en lugar de saltárselas por poco interesantes. Un off-by-one tiene que poner algo en algún sitio, y donde lo pone casi siempre es una posición de código que la especificación dejó vacía — $7F delante, $9F detrás. Una prueba que solo comprueba posiciones definidas puede pasar con la tabla mal en las dos direcciones; una prueba que fija los huecos atrapa el desplazamiento en la primera ejecución
Qué cuesta esto en un flujo de formularios con round-trip
Una importación FDF que reescribe silenciosamente un carácter por símbolo es peor que una que falla, porque el fallo aflora río abajo y parece otra cosa. Los nombres de campo son el filo afilado aquí. TPdf.ImportFDF empareja los nombres entrantes con los widgets del documento abierto, y un nombre que se decodificó con un carácter mal simplemente no coincide — el campo se queda vacío, el valor de retorno sigue contando el campo como parseado, y el informe que sale del pipeline llega corto de un valor sin nada en el log que explique por qué. Cualquiera que monte un bucle de exportar-y-reimportar del tipo descrito en exportar e importar datos de formulario y anotaciones XFDF con PDFium Component debería hacer round-trip de un nombre de campo que contenga un símbolo tipográfico, y no solo ASCII simple, antes de confiar en el bucle
También merece la pena ser honesto sobre los límites del arreglo. La tabla ahora coincide con el Anexo D.2 para los 256 valores de byte, lo que hace que los strings FDF de un solo byte se decodifiquen bien, pero PDFDocEncoding en sí cubre un repertorio latino y nada más — cualquier cosa fuera de él tiene que llegar como UTF-16BE con BOM, que es exactamente lo que §7.9.2.2 pretende. Y un string UTF-16 tiene todavía sus propios peligros separados en el lado de Delphi, porque un code point más allá de U+FFFF necesita un par de sustitución y no un solo WideChar, el problema que cubre por qué los emojis y los caracteres CJK rompen WideChar en Delphi. El punto de fondo va más allá de las tablas de codificación: un parser de PDF puede rechazar algo que debería aceptar, que lo encuentras de inmediato, o aceptar algo y equivocarse en silencio, que lo encuentras en producción. Las trampas de tokens de nombre que describe parsear diccionarios de PDF con seguridad están en esa segunda categoría, y también lo está una tabla desplazada una fila — el camino de código tiene éxito, el valor de retorno parece razonable, y solo una prueba escrita contra la especificación y no contra la implementación dice lo contrario
ImportFDF, ExportFDF e ImportXFDF en TPdf, junto con los parsers FDF y XFDF que hay detrás, forman parte del PDFium Component estándar para Delphi y C++Builder