Las búsquedas de subcadena como Pos('/Length', Dict) son la herramienta equivocada para leer un diccionario PDF, porque las claves de nombre de PDF comparten prefijos: /Length es un prefijo de /Length1, y /Encrypt es un prefijo de /EncryptMetadata. ISO 32000-1 §7.3.5 define un nombre como un token que termina únicamente en un delimitador o en un espacio en blanco, de modo que una clave solo cuenta como encontrada cuando el byte que la sigue es uno de esos caracteres. Un lector de diccionarios que se salte esa única comprobación acabará leyendo el valor equivocado de un archivo perfectamente válido
El fallo que nos enseñó esto no se parecía en nada a un problema de analizador léxico. Un escaneo de conformidad empezó a informar de un flujo FontFile como dañado: el programa de fuente descomprimido era un fragmento, cortado a mitad de tabla. El archivo se abría bien en todos los visores. Los datos del flujo en disco estaban intactos. La causa raíz estaba en una línea de nuestro lector de diccionarios compartido: Pos('/Length', ...) había coincidido con /Length1, una clave estándar que los diccionarios de flujo FontFile llevan según la Tabla 127 de ISO 32000-1, y el lector tomó el entero que venía tras /Length1 como longitud del flujo. El escritor de ese archivo en concreto serializó /Length1 antes que /Length, algo que es enteramente libre de hacer, ya que las entradas de un diccionario no están ordenadas según §7.3.7. El flujo quedó truncado a un recuento de bytes basura, y todas las comprobaciones posteriores que lo consumían se quedaron ciegas en silencio
¿Por qué la coincidencia por subcadena rompe el análisis de diccionarios PDF?
La coincidencia por subcadena se rompe porque el espacio de nombres de PDF está lleno de familias de prefijos deliberadas, y porque el orden de las entradas de un diccionario no está especificado. La Tabla 127 de ISO 32000-1 define /Length1, /Length2 y /Length3 para los flujos de fuentes incrustadas, todos ellos junto a un /Length en el mismo diccionario. El diccionario de cifrado empareja /Encrypt en el tráiler con /EncryptMetadata dentro de él. Las claves cortas son peores: una búsqueda construida como Pos('/' + Key, ...) con Key = 'N' aterriza tan campante sobre /Name o /Nums. Ninguna de estas colisiones exige un archivo mal formado. Un escritor que ordene /Length1 antes que /Length es plenamente conforme, lo que significa que el fallo de subcadena no es una carencia de robustez frente a entradas rotas — es una carencia de corrección frente a entradas válidas
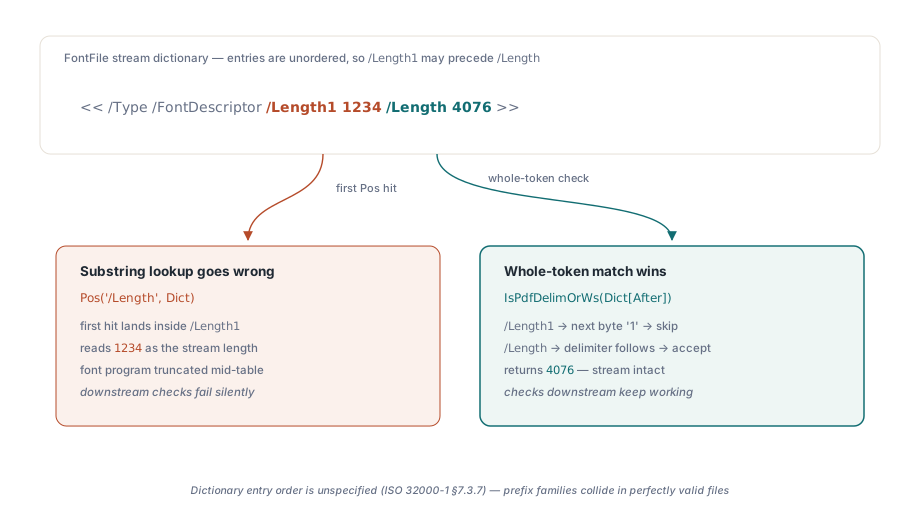
El modo de fallo es además del tipo silencioso. Un /Length equivocado no lanza una excepción; le entrega una porción de bytes más corta o más larga que la que el flujo ocupa realmente. Si esa porción alimenta una comprobación de subconjunto de fuentes, un análisis de CMap o un escaneo de metadatos, el consumidor ve basura y por lo general no informa de nada en absoluto, porque medio flujo zlib sencillamente no se descomprime y el código sigue adelante. Publicamos exactamente esta clase de defecto y lo corregimos en la v2.14.3 de nuestro lector compartido, después de que una auditoría cláusula por cláusula de ISO 32000-1 §7.2–§7.3 marcara como sospechosa toda búsqueda de claves al estilo Pos
Qué define exactamente ISO 32000-1 §7.3.5 como nombre
La sección 7.3.5 es corta y precisa: un objeto de nombre es una barra inclinada seguida de una secuencia de caracteres regulares, y el token termina en el primer carácter delimitador o de espacio en blanco. Los delimitadores son los ocho caracteres de paréntesis y corchete más la barra y el signo de porcentaje — ( ) < > [ ] { } / % — y el espacio en blanco es nulo, tabulador, salto de línea, avance de página, retorno de carro y espacio (§7.2.2–§7.2.3). Esa regla de terminación es toda la historia. /Length1 no es "/Length seguido de un 1"; es un token único e indivisible, exactamente igual que LengthOne y Length son identificadores distintos en Pascal. Cualquier lector que encuentre claves mediante una búsqueda de bytes en bruto está reimplementando el analizador léxico con la regla de terminación borrada
Esta es la forma del defecto, reducida a lo esencial. Esta versión compila, pasa las pruebas contra archivos cuyos escritores ordenan /Length primero, y corrompe flujos con los escritores que no lo hacen
// INCORRECTO: coincide también con /Length1, /Length2, /Length3
function ReadStreamLength(const Dict: AnsiString): Integer;
var
  P: Integer;
begin
  Result := -1;
  P := Pos('/Length', Dict);
  if P > 0 then
    Result := ReadIntAt(Dict, P + Length('/Length'));
end;
Coincidencia de token completo: compruebe el byte posterior a la clave
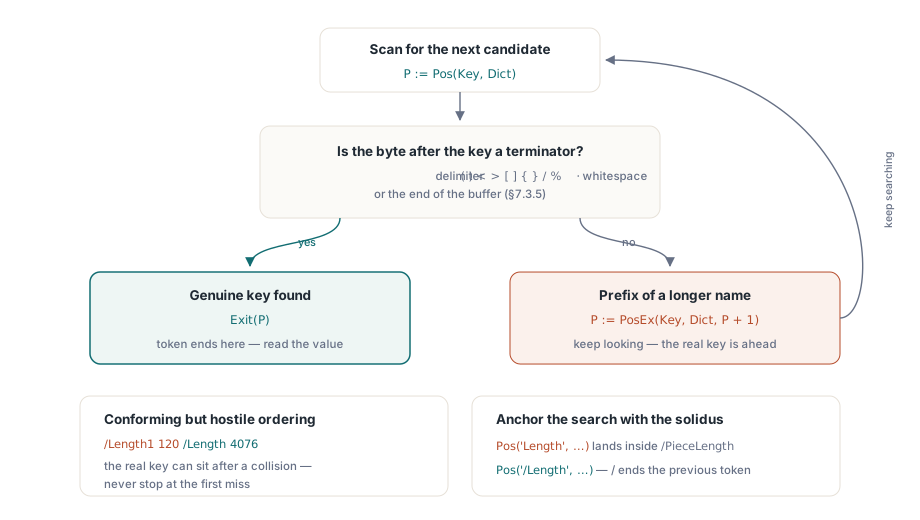
El predicado correcto se deriva directamente de §7.3.5: una coincidencia candidata es una clave real solo si el carácter inmediatamente posterior es un delimitador, un espacio en blanco o el final del búfer. Todo lo demás es un nombre más largo que simplemente comparte un prefijo, así que la búsqueda debe continuar más allá en lugar de darse por vencida. La corrección en nuestro lector sustituyó cada búsqueda Pos en bruto por una única rutina compartida construida sobre esta regla
function IsPdfDelimOrWs(C: AnsiChar): Boolean;
begin
  Result := C in [#0, #9, #10, #12, #13, ' ',
    '(', ')', '<', '>', '[', ']', '{', '}', '/', '%'];
end;

// Correcto: coincidencia de token completo según ISO 32000-1 §7.3.5
function FindDictKey(const Dict, Key: AnsiString): Integer;
var
  P, After: Integer;
begin
  Result := 0;
  P := Pos(Key, Dict);
  while P > 0 do
  begin
    After := P + Length(Key);
    if (After > Length(Dict)) or IsPdfDelimOrWs(Dict[After]) then
      Exit(P);                       // el token acaba aquí: clave genuina
    P := PosEx(Key, Dict, P + 1);    // prefijo de un nombre más largo: seguir
  end;
end;
Dos detalles de ese bucle tienen peso. Primero, sigue buscando en lugar de devolver un fallo en la primera colisión de prefijo, porque /Length1 120 /Length 4076 es una ordenación legal y la clave real sigue por delante. Segundo, el caso de final de búfer cuenta como terminador, ya que un fragmento de diccionario puede terminar legítimamente justo después de un nombre. Un punto más sutil que conviene auditar en su propio código: la misma regla se aplica en el lado izquierdo de la coincidencia si su cadena de búsqueda no incluye la barra, porque si no Pos('Length', ...) puede aterrizar dentro de /PieceLength. Anclar la cadena de búsqueda con la / inicial, como arriba, resuelve el borde izquierdo porque / es en sí misma un delimitador que termina el token precedente
¿Cómo puede un PDF hostil convertir un fallo del analizador en una reserva de un gigabyte?
Un archivo mal formado o malicioso escala estos errores léxicos hasta el agotamiento de recursos, porque los enteros de un diccionario alimentan con frecuencia tamaños de reserva de memoria. Nuestra auditoría encontró una cadena exactamente de esta forma en la expansión de flujos de objetos. La entrada /N de un diccionario ObjStm indica cuántos objetos comprimidos contiene el flujo, y el código de expansión llamaba a SetLength con un array dimensionado por ella. El analizador de enteros, sin embargo, dejaba su parámetro de salida intacto en caso de fallo y aun así lo devolvía — de modo que un /N no numérico entregaba a SetLength un valor de pila sin inicializar. Un entero positivo basura ahí significa una petición de reserva de gigabytes, disparada por unos pocos bytes de entrada corrupta, mientras meramente se escanea un documento en el que usted ni siquiera ha aceptado confiar todavía
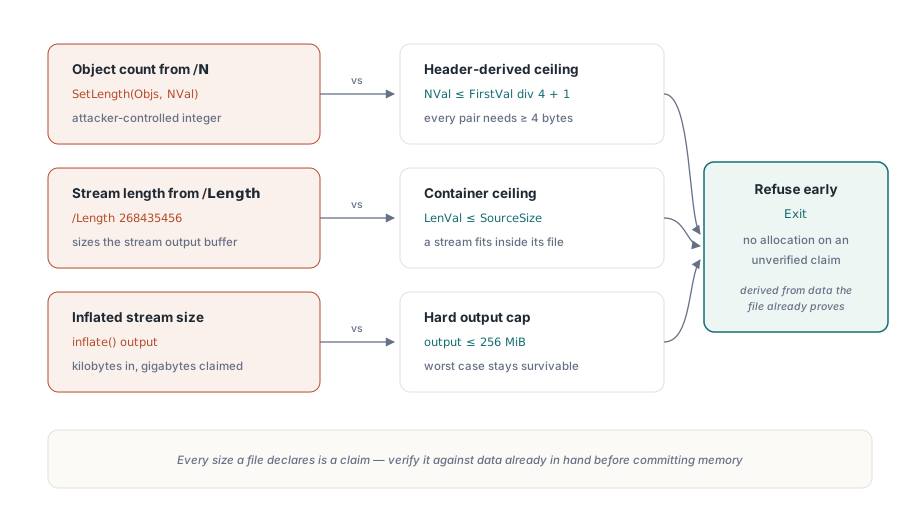
La reparación tuvo dos partes independientes, y ambas se generalizan. El analizador ahora devuelve un 0 explícito en caso de fallo, nunca memoria sin inicializar. Y el consumidor ya no confía sin más en la aritmética de /N: la región de cabecera de ObjStm anterior a /First almacena un par de enteros — número de objeto y desplazamiento — por cada objeto comprimido, y cada par ocupa al menos cuatro bytes contando los separadores. Cualquier /N por encima de FirstVal div 4 + 1 es por tanto físicamente imposible para el tamaño de cabecera declarado y se rechaza antes de que ocurra reserva alguna. El límite cuesta una comparación y se deriva de datos que ya se tienen a mano, que es el patrón que hay que buscar: un techo que el propio archivo demuestra, no una constante arbitraria
// /N lo controla el atacante; acótelo por lo que /First puede contener
if not TryReadDictInt(Dict, '/N', NVal) then
  NVal := 0;                          // cero explícito, nunca basura de pila
if (NVal <= 0) or (NVal > FirstVal div 4 + 1) then
  Exit;                               // la cabecera no admite tantos pares

// /Length nunca puede exceder el archivo que contiene el flujo
if (LenVal < 0) or (LenVal > SourceSize) then
  Exit;                               // rechazar antes de reservar el búfer
Otros dos techos completan el perímetro defensivo de nuestro lector, ambos publicados en la v2.12.0. El lector de flujos rechaza cualquier /Length mayor que el archivo completo antes de reservar el búfer de resultado — un flujo no puede ser mayor que el contenedor en el que vive, así que la comprobación está libre de falsos positivos. Y la ruta de inflate limita la salida descomprimida a 256 MiB, lo que corta de raíz la clásica bomba zlib en la que unos pocos kilobytes de entrada se expanden sin límite; el tope es generoso para cualquier flujo PDF real y mantiene el peor caso dentro de lo soportable. El tema común a los tres es el mismo: cada tamaño que un archivo declara es una afirmación, y el analizador verifica cada afirmación contra algo que puede medir antes de comprometer memoria en ella. La misma postura de auditoría se aplica una capa más abajo, en la frontera del binding, que se trata en endurecer la ABI de PDFium y la seguridad de memoria en Delphi
Dónde la regla del token completo no basta
Límites honestos, para que no confíe en exceso en la rutina anterior. La coincidencia de token completo arregla la identificación de claves, pero una búsqueda plana de bytes sobre un tramo de diccionario sigue sin poder distinguir si una coincidencia está dentro de un diccionario anidado, de una cadena literal o de un comentario — FindDictKey sobre un objeto de página puede aterrizar en una clave de su subdiccionario /Resources si le entrega un tramo demasiado amplio. Nuestro lector restringe primero el tramo al cuerpo de un solo objeto y trata los contextos de cadena y de comentario como un punto de auditoría aparte, todavía abierto. La seguridad frente a subcadenas es un peldaño de una escalera, no la escalera entera: la consistencia de las referencias cruzadas es una disciplina propia, tratada en validar los flujos de objetos y de xref, y el catálogo de amenazas más amplio para documentos que usted no ha creado está en auditar los riesgos de seguridad de un PDF
Si mantiene un lector de diccionarios escrito a mano en Delphi o Lazarus, la lista de comprobación de este incidente es corta. Busque con grep cada Pos('/ del código base y encamine los aciertos a través de un único ayudante de token completo. Enumere las familias de prefijos en las que participan sus claves — /Length, /Encrypt, /N, /Type frente a /Type1 aparecen todas en archivos reales. Después recorra cada entero que llega a SetLength, GetMem o a un bucle de copia y pregúntese qué lo acota: el tamaño del archivo, un techo derivado de la cabecera, o nada. La capa de análisis descrita aquí es el cimiento bajo nuestro PDFium Component, donde el lector a nivel de bytes y el motor de renderizado se comprueban mutuamente en cada documento que tocan