Las tres últimas líneas de un PDF bien formado siguen un patrón: la palabra clave startxref, un número decimal como 48211, y %%EOF. Ese número es un offset de bytes, y es lo primero que mira un lector. Un PDF es un conjunto de objetos numerados más un índice que mapea cada número de objeto a su posición en el fichero, y la incrustación de fuentes, los rangos de bytes de las firmas y los guardados incrementales se siguen todos de ese único modelo
Word y RTF dejan la maquetación a la máquina que visualiza. El PDF guarda en cambio el resultado terminado: instrucciones de dibujo posicionadas, programas de fuente e imágenes, atados en un grafo de objetos autocontenido para que todo renderer conforme pinte la misma página
Objetos, números y referencias indirectas
ISO 32000-1 §7.3 define ocho tipos de objeto básicos: booleano, numérico (entero y real), cadena, nombre, array, diccionario, stream y null. Casi todo lo que tiene significado es un diccionario cuyas claves son nombres como /Type y cuyos valores pueden ser cualquier objeto, incluida una referencia escrita como 7 0 R: objeto 7, generación 0. En un fichero escrito de una pasada cada generación es 0; las generaciones solo se mueven cuando una actualización incremental libera un número de objeto y lo reutiliza. Un stream es un diccionario seguido de bytes en bruto entre stream y endstream, con /Length dando el conteo de bytes y /Filter nombrando el paso de decodificación, casi siempre /FlateDecode
12 0 obj
<< /Type /Page
   /Parent 3 0 R
   /MediaBox [0 0 612 792]
   /Resources << /Font << /F1 7 0 R >> >>
   /Contents 13 0 R
>>
endobj
¿Cómo encuentra un lector la página 5.000 sin leer las páginas 1 a 4.999?
Un lector llega a cualquier página por una cadena que empieza al final del fichero: el /Root del tráiler apunta al catálogo, el /Pages del catálogo apunta a la raíz del árbol de páginas, y cada nodo intermedio /Pages lleva un /Count de las páginas hoja por debajo. Para encontrar la página 5.000, el lector resta conteos según desciende y se salta subárboles enteros sin abrirlos. ISO 32000-1 §7.7.3 no exige un árbol equilibrado; un único array /Kids con 10.000 entradas es legal, solo que más lento de recorrer
El árbol de páginas guarda una trampa para el código que solo lee la hoja. /Resources, /MediaBox, /CropBox y /Rotate son heredables (§7.7.3.4), así que una página sin /MediaBox no está rota; el valor vive en un ancestro. El media box fija el espacio de coordenadas: origen abajo a la izquierda, Y hacia arriba, una unidad igual a 1/72 de pulgada salvo que un /UserUnit de PDF 1.6 lo escale
La tabla de referencias cruzadas hace que todo esto sea rápido. En su forma clásica empieza con la palabra clave xref, una cabecera de subsección como 0 6, y entradas de exactamente 20 bytes: un offset de 10 dígitos, una generación de 5 dígitos, n o f para en uso o libre, y un fin de línea de dos bytes (§7.5.4). El ancho fijo permite al lector calcular dónde está la entrada del objeto N y leer solo esos 20 bytes. El tráiler posterior nombra /Size, /Root y opcionalmente /Encrypt, /ID y /Prev
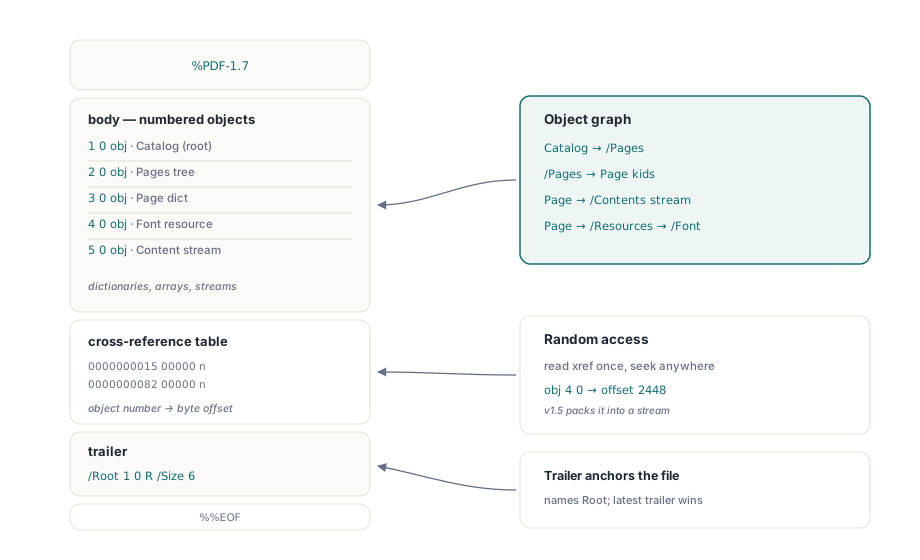
Los offsets absolutos son frágiles. Guarda un PDF desde un editor de texto que normalice finales de línea y cada byte tras la primera línea cambiada se mueve, mientras que la tabla sigue apuntando a las posiciones antiguas. Los lectores con pasada de reparación reconstruyen el índice escaneando palabras clave obj; los lectores sin ella rechazan el fichero, que es por lo que un PDF dañado puede abrirse en un visor y fallar en otro. El recorrido byte a byte de un PDF escrito a mano lista cada offset de un fichero de una página
Localizar el índice tú mismo lleva código RTL corriente. Las dos funciones de abajo son ayudantes tuyos, no llamadas a la biblioteca
uses
  System.SysUtils, System.Classes;

// Tu propio ayudante: devuelve el offset escrito tras la última
// palabra clave startxref, o -1 cuando la cola no guarda ninguno
function FindLastStartXref(const FileName: string): Int64;
const
  TailSize = 1024;  // una suposición; amplíalo para ficheros con basura final
var
  FS: TFileStream;
  Buf: TBytes;
  Tail, Num: string;
  P: Integer;
begin
  Result := -1;
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    if FS.Size > TailSize then
      FS.Position := FS.Size - TailSize;
    SetLength(Buf, FS.Size - FS.Position);
    if Length(Buf) > 0 then
      FS.ReadBuffer(Buf[0], Length(Buf));
  finally
    FS.Free;
  end;
  Tail := TEncoding.ASCII.GetString(Buf);
  P := Tail.LastIndexOf('startxref');  // la revisión más reciente es la última
  if P < 0 then
    Exit;
  Num := Tail.Substring(P + Length('startxref')).TrimLeft;
  P := 0;
  while (P < Num.Length) and CharInSet(Num.Chars[P], ['0'..'9']) do
    Inc(P);
  if P > 0 then
    Result := StrToInt64(Num.Substring(0, P));
end;

// Tu propio ayudante: tabla clásica, stream de referencias cruzadas o un offset obsoleto
function DescribeXrefAt(const FileName: string; Offset: Int64): string;
var
  FS: TFileStream;
  Buf: TBytes;
  Head: string;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    FS.Position := Offset;
    SetLength(Buf, 32);
    SetLength(Buf, FS.Read(Buf[0], Length(Buf)));
  finally
    FS.Free;
  end;
  Head := TEncoding.ASCII.GetString(Buf);
  if Head.StartsWith('xref') then
    Result := 'classic cross-reference table'
  else if Head.Contains(' obj') then
    Result := 'cross-reference stream (PDF 1.5 or later)'
  else
    Result := 'stale offset: the file needs a repair pass';
end;
La ventana de 1024 bytes es una convención, no una regla. ISO 32000-1 §7.5.5 solo exige %%EOF en la última línea. LastIndexOf importa porque un fichero actualizado incrementalmente guarda un startxref por revisión, y solo el último describe el documento actual
Streams de referencias cruzadas y object streams en PDF 1.5
PDF 1.5 movió el índice a un stream comprimido (§7.5.8). Su diccionario lleva /Type /XRef, un array /W que da el ancho en bytes de cada columna, y un /Index opcional de rangos de objetos cubiertos. Cada fila binaria es tipo 0 (libre), tipo 1 (offset de bytes) o tipo 2 ("el objeto k vive dentro del object stream n"). Las claves del tráiler se mudan al mismo diccionario, así que el fichero no tiene palabra clave trailer alguna
48 0 obj
<< /Type /XRef /Size 49 /Root 1 0 R
   /W [1 3 1] /Index [0 49]
   /Filter /FlateDecode /Length 162 >>
stream
...binary rows: 1 + 3 + 1 bytes each...
endstream
endobj
startxref
48211
%%EOF
Los object streams (/Type /ObjStm, §7.5.7) empaquetan muchos diccionarios pequeños en un único stream comprimido con Flate, con /N dando el conteo y /First el offset del primer objeto en los datos decodificados. Los streams, los objetos con generación distinta de cero y el diccionario de cifrado no pueden ir nunca dentro, ni tampoco el catálogo ni los objetos de página de un fichero linealizado. Los ficheros híbridos conservan una tabla clásica y añaden la clave de tráiler /XRefStm (§7.5.8.4) para lectores PDF 1.5
En HotPDF ambas características son interruptores explícitos en THotPDF: UseXRefStream sustituye la secuencia xref/trailer textual por un stream /Type /XRef, y UseObjectStreams añade el empaquetado /ObjStm por encima
uses
  System.SysUtils, HPDFDoc;

var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.AutoLaunch := False;
    Pdf.FileName := 'compact.pdf';
    Pdf.Version := pdf17;
    Pdf.Compression := cmFlateDecode;
    Pdf.FontEmbedding := True;
    Pdf.EnableFontSubsetting := True;  // incrustar solo los glifos usados
    Pdf.UseXRefStream := True;         // /Type /XRef en lugar de la palabra clave xref
    Pdf.UseObjectStreams := True;      // empaqueta diccionarios pequeños en /ObjStm
    Pdf.BeginDoc;
    Pdf.CurrentPage.SetFont('Arial', [], 12);
    Pdf.CurrentPage.TextOut(72, 720, 0, 'Objects, offsets, and one compressed index');
    Pdf.EndDoc;
  finally
    Pdf.Free;
  end;
  // Usa los ayudantes del listado anterior.
  // Esperado: 'cross-reference stream (PDF 1.5 or later)'
  Writeln(DescribeXrefAt('compact.pdf', FindLastStartXref('compact.pdf')));
end.
Con Version por debajo de pdf15, o con un perfil PDF/A-1 activo, el writer emite una tabla clásica y se salta los object streams, porque ambos son construcciones de PDF 1.5 e ISO 19005-1 §6.1.4 prohíbe directamente los streams de referencias cruzadas. UseObjectStreams solo surte efecto junto con UseXRefStream, ya que las entradas de tipo 2 no tienen forma en tabla clásica. LinearizeOutput escribe tablas clásicas por compatibilidad amplia con los lectores
Para PDFs que se van de tu control, como adjuntos de correo, entrada a archivos o imprentas, la tabla clásica es el valor por defecto más seguro, porque un lector anterior a PDF 1.5 aún puede parsearla. Los object streams rinden cuando un documento guarda miles de diccionarios pequeños: anotaciones, campos de formulario, elementos de estructura. En un informe dominado por imágenes y fuentes no ahorran casi nada, porque los streams nunca entran en un object stream
Content streams: cada página es un pequeño programa
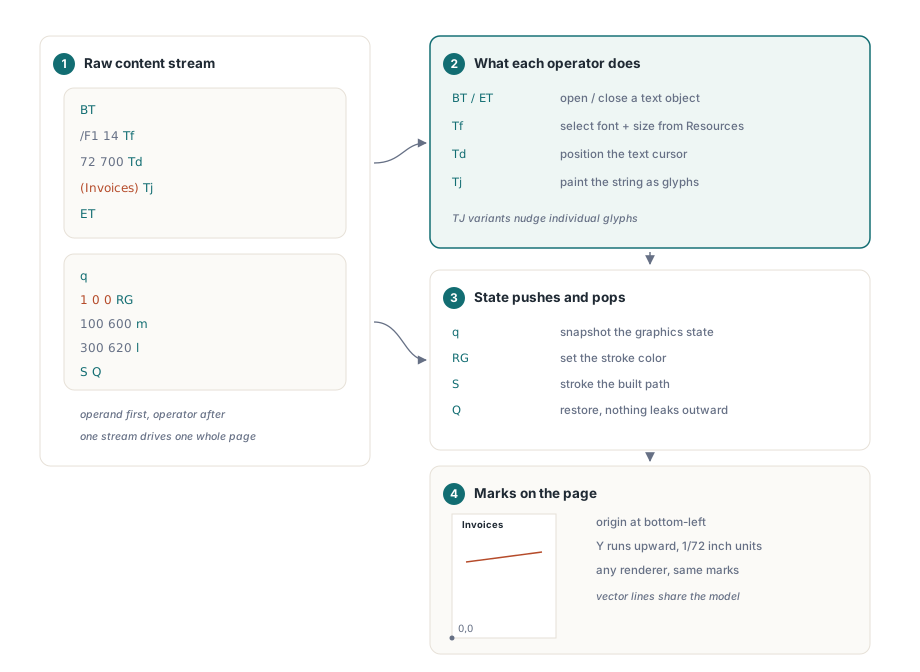
El contenido visible de una página es una secuencia de operadores postfijos en uno o más content streams. BT abre un objeto de texto, Tf selecciona un recurso de fuente y un tamaño, Td mueve la posición del texto, Tj o TJ pintan una cadena, y ET cierra el objeto. Los paths siguen la misma pauta: m, l, c y re construyen la forma, f o S la rellenan o le dan trazo
q
1 0 0 1 72 700 cm     % mueve el origen a (72, 700)
BT
  /F1 12 Tf           % recurso de fuente F1 a 12 puntos
  0 0 Td
  (Invoice 2026-0417) Tj
ET
0.2 0.2 0.8 RG        % color de trazo, acotado por q/Q
0 -6 m 140 -6 l S
Q
El estado gráfico (§8.4) guarda lo que esos operadores leen implícitamente: la matriz de transformación actual, el ancho de línea, los colores y la ruta de recorte. q empuja una copia y Q la saca, así que una transformación fijada dentro de la pareja no puede escapar. Cuando /Contents es un array, los streams se concatenan como si fueran uno y solo pueden partirse entre tokens. Un stream que acaba con un q sin pareja cambia por tanto el estado del siguiente stream del array
Los Form XObjects son content streams con su propio /Resources y /BBox, pintados en cualquier sitio con un Do. El artículo sobre operadores de gráficos PDF y la pila q/Q trata paths, colores y la matriz en profundidad
¿Por qué copiar y pegar devuelve basura cuando la página se ve bien?
Copiar y pegar falla cuando el fichero registra qué glifo dibujar pero no qué carácter representa. Renderizar solo necesita formas de glifo del programa de fuente incrustado; extraer necesita Unicode, que viene de una codificación estándar o de una CMap /ToUnicode en el diccionario de la fuente (§9.10.3). Una fuente compuesta con /Encoding /Identity-H escribe IDs de glifo en bruto en el content stream, y sin un mapa ToUnicode esos IDs no tienen relación definida con ningún carácter
El descriptor de fuente (§9.8) apunta al programa incrustado en /FontFile para Type 1, /FontFile2 para TrueType, o /FontFile3 para formatos compactos, incluido OpenType desde PDF 1.6. Una fuente de subconjunto lleva seis letras mayúsculas y un signo más antes del nombre, como en /BaseFont /AAAAAA+ArialMT (§9.6.4). HotPDF deja EnableFontSubsetting apagado por defecto para que quien reciba el documento y lo edite pueda teclear caracteres que el original nunca usó; actívalo para la salida final. El artículo sobre manejo de fuentes cubre fuentes CJK y extracción rota
El PDF etiquetado (§14.8) añade un árbol de estructura bajo /StructTreeRoot que etiqueta el contenido marcado como párrafos, encabezados o celdas de tabla. Los lectores de pantalla siguen ese árbol. Dale un fichero sin etiquetar y se quedan adivinando el orden de lectura a partir del orden de dibujo
Actualizaciones incrementales y el rango de bytes de la firma
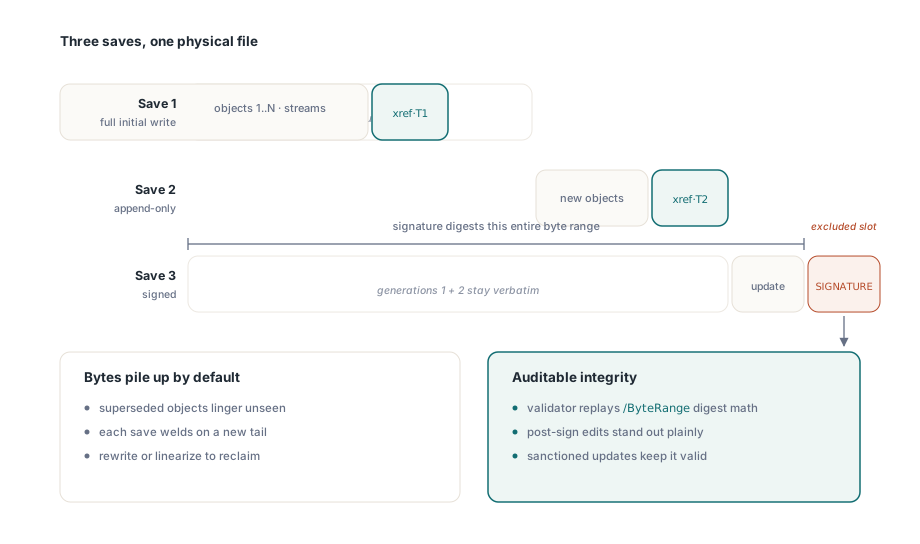
Una actualización incremental (§7.5.6) cambia un PDF sin reescribir un solo byte existente. Los objetos nuevos y cambiados se añaden tras el %%EOF original, seguidos de una sección de referencias cruzadas que cubre solo esos objetos y de un tráiler cuyo /Prev guarda el offset de la sección anterior. Si la actualización lista de nuevo el objeto 12, los lectores cargan la copia añadida, y el objeto 12 original se queda en el fichero sin nada apuntándole
El fichero crece en cada guardado. Menos obvio: el contenido "borrado" en una revisión posterior sigue sentado en una anterior. Una redacción guardada incrementalmente deja el texto original recuperable por cualquiera que trunque el fichero en el primer %%EOF, así que la salida redactada necesita una reescritura completa
Las firmas se apoyan en la misma propiedad de solo-añadir. El /ByteRange de un diccionario de firma lleva cuatro números, [0 a b c], que describen dos rangos que cubren el fichero entero salvo la cadena hexadecimal /Contents donde se aloja la firma CMS. Una revisión posterior aterriza tras el segundo rango, así que los bytes que hasheó el primer firmante nunca cambian, y un validador puede reconstruir la revisión firmada truncando en b + c
Una firma de certificación lleva una transformación DocMDP (§12.8.2.2) cuyo valor /P fija la regla: 1 no permite cambios, 2 permite rellenar formularios, instanciar plantillas de página y firmar, y 3 permite también editar anotaciones. Una contrafirma añadida a un documento certificado con /P 1 es criptográficamente sólida por sí sola, pero la certificación ya no se sostiene
HotPDF expone el camino de añadido mediante BeginIncrementalUpdate y SaveIncrementalUpdate. El primero carga el fuente y conserva sus bytes tal cual; los objetos creados después se marcan como cambiados automáticamente, y los objetos cargados que edites a mano se marcan con MarkDirty. El segundo escribe los bytes originales, los objetos cambiados bajo sus números existentes, una subsección de referencias cruzadas acorde, y un tráiler con /Prev. Contrafirmar un contrato ya firmado se ve así
const
  PfxFile = 'approver.pfx';
  PfxPassword = 'replace-with-your-pfx-password';
var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.AutoLaunch := False;
    Pdf.BeginIncrementalUpdate('contract-signed.pdf');
    // Índice de página 0, esquinas del rectángulo del campo en puntos, 8192 bytes de espacio CMS
    if Pdf.AddLoadedSignedSignatureField(0, 320, 60, 540, 110,
      'Approver', 8192) < 0 then
      raise Exception.Create('Page index out of range');
    Pdf.SaveIncrementalUpdate('contract-prepared.pdf');  // un fichero nuevo, el original se conserva
  finally
    Pdf.Free;
  end;
  // Rellena el marcador de /Contents; los bytes de la primera firma quedan intactos
  if not THotPDF.SignPDFWithPFX('contract-prepared.pdf',
    'contract-countersigned.pdf', PfxFile, PfxPassword) then
    raise Exception.Create('Signing failed');
end;
AddLoadedSignedSignatureField añade como nueva revisión el campo, su diccionario de firma, el AcroForm con /SigFlags 3 y las /Annots de la página; SignPDFWithPFX calcula después el CMS sobre un /ByteRange que abarca el fichero entero, primera firma incluida. Cuando un documento lleva una firma, mantenlo alejado de reescrituras completas, linealizadores y pasos de "optimización": cada uno mueve bytes que un firmante anterior hasheó, invalidando todas las firmas existentes de golpe. Cuando se esperan contrafirmas bajo una certificación, crea todos los campos de firma antes de la primera firma y certifica con /P 2
Del Acrobat 1.0 a ISO 32000-2
PDF 1.0 salió con Acrobat en 1993, construido sobre el modelo de imagen de PostScript. Las revisiones hasta 1.7 añadieron cifrado (1.1), formularios interactivos (1.2), firmas digitales y estructura lógica (1.3), transparencia (1.4), object streams y streams de referencias cruzadas (1.5), y cifrado AES (1.6). Adobe entregó PDF 1.7 a ISO en 2007, publicado como ISO 32000-1:2008. PDF 2.0 llegó como ISO 32000-2:2017, revisado en 2020: estandarizó la revisión 6 del manejador de contraseñas AES-256, desaprobó la mayor parte de /Info en favor de XMP y añadió ficheros asociados
Los estándares subset son restricciones sobre esa base. PDF/A (ISO 19005) prohíbe el cifrado y el contenido externo y exige fuentes incrustadas y metadatos XMP; PDF/A-1 se construye sobre PDF 1.4, PDF/A-2 sobre ISO 32000-1, y PDF/A-3 permite ficheros incrustados de cualquier formato. PDF/X (ISO 15930) apunta a la producción de imprenta, y PDF/UA (ISO 14289) exige estructura etiquetada y mapeos Unicode. Cada declaración es una propiedad XMP aparte, así que un fichero puede declarar PDF/A-2 y PDF/UA-1 lado a lado
Las secciones de ISO 32000-2 a las que el trabajo programático vuelve más son §7.5 (estructura de fichero y datos de referencias cruzadas), §7.7.3 (árbol de páginas), §8.4 (estado gráfico), §9.3 (estado de texto), §9.6 a §9.10 (fuentes, descriptores y ToUnicode), §12.7 y §12.8 (formularios y firmas), y §14.8 (PDF etiquetado). Si prefieres no llevar a mano offsets, enlaces /Prev y rangos de bytes, el HotPDF Delphi Component para Delphi y C++Builder escribe datos de referencias cruzadas clásicos o en stream, añade revisiones incrementales y los firma mediante las propiedades y métodos mostrados arriba