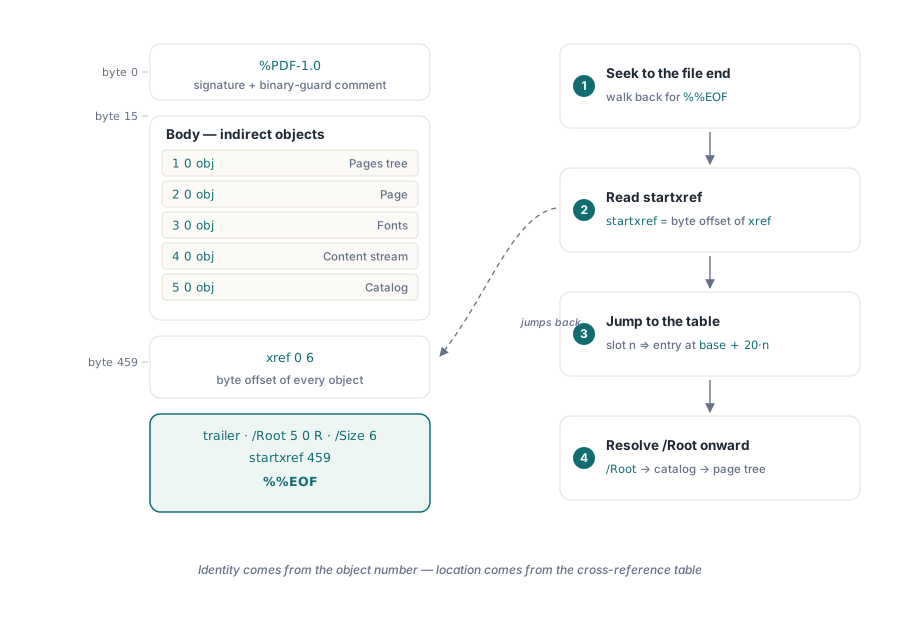
Un lector de PDF no empieza por el principio del fichero. Empieza por el final. Los últimos bytes guardan la dirección de todo lo demás, y un parser que no entienda ese orden malinterpretará el formato desde la primera línea. Así que la forma más práctica de aprender el PDF en disco es aprenderlo como lo hace un lector: la cola primero, luego saltar hacia atrás al mapa, y después resolver los objetos a los que el mapa apunta
Los bytes en sí son bastante legibles en un editor de texto cuando nada está comprimido. Un documento mínimo de una página que dibuja "Hello, World!" cabe en menos de quinientos bytes, y en él se ve cada elemento estructural del formato. Aquí está el fichero completo, con las cuatro partes marcadas. Los comentarios al margen son anotaciones para este artículo, y los offsets de bytes son ilustrativos; la última parte del artículo muestra cómo obtener los exactos con una herramienta:
%PDF-1.0                          % Header
%âãÏÓ

1 0 obj                           % Body: la secuencia de objetos
<<
/Kids [2 0 R]
/Count 1
/Type /Pages
>>
endobj

2 0 obj
<<
/Rotate 0
/Parent 1 0 R
/Resources 3 0 R
/MediaBox [0 0 612 792]
/Contents [4 0 R]
/Type /Page
>>
endobj

3 0 obj
<< /Font << /F0 << /BaseFont /Times-Italic /Subtype /Type1 /Type /Font >> >> >>
endobj

4 0 obj
<< /Length 65 >>
stream
1. 0. 0. 1. 50. 700. cm BT
  /F0 36. Tf
  (Hello, World!) Tj
ET
endstream
endobj

5 0 obj
<< /Pages 1 0 R /Type /Catalog >>
endobj

xref                              % Cross-reference table
0 6
0000000000 65535 f
0000000015 00000 n
0000000074 00000 n
0000000192 00000 n
0000000291 00000 n
0000000409 00000 n

trailer                           % Trailer
<<
/Root 5 0 R
/Size 6
>>
startxref
459
%%EOF
Cuatro partes, siempre en este orden a lo largo del fichero: una cabecera, un cuerpo de objetos, una tabla de referencias cruzadas y un tráiler. La pega es que se leen casi en orden inverso. ISO 32000-2 §7.5.1 describe la misma anatomía de cuatro partes. El acceso de atrás hacia delante va de velocidad: un lector que salta directamente al objeto que necesita gana a uno que escanea cada byte desde arriba, y el tráiler y la tabla de referencias cruzadas existen para hacer posible ese salto
La cabecera son dos líneas, y la segunda importa
La primera línea es %PDF-1.0. El signo de porcentaje la convierte en comentario en lo que a la sintaxis respecta, pero los lectores la tratan como firma del fichero y sacan de ella el número de versión. El manejo de versiones es laxo en la práctica. Un lector hecho para PDF 2.0 abrirá sin problemas un fichero que dice ser 1.0, y la mayoría lo intentará con un fichero cuya línea de versión esté mal o no esté exactamente en el byte cero. Trata el número como una pista de qué características esperar; los lectores rara vez rechazan un fichero por él
La segunda línea es la que la gente borra por accidente y luego se pasa una tarde depurando. También es un comentario, pero su carga son cuatro bytes por encima del ASCII 127. Existen para que cualquier cosa que mueva el fichero en "modo texto" lo reconozca como binario y deje de reescribir finales de línea. Un PDF lleva streams comprimidos cuyos bytes pueden coincidir por casualidad con un retorno de carro o un salto de línea; si una herramienta de transferencia los reescribe, la longitud de stream registrada en el diccionario ya no cuadra con los bytes en disco y el fichero queda corrupto. El comentario de bytes altos es una defensa antigua contra el FTP en modo ASCII, y todo escritor serio sigue emitiéndolo porque el fallo que evita es silencioso y total
El cuerpo contiene los objetos, cada uno numerado
Todo lo que compone el documento vive en el cuerpo como una secuencia plana de objetos indirectos. Cada uno abre con dos enteros y la palabra clave obj, contiene su contenido y cierra con endobj. El primer entero es el número de objeto, el segundo es el número de generación, que es cero para cada objeto en un fichero recién escrito. El objeto 1 contiene un diccionario, escrito entre << y >>, pero ahí puede ir cualquiera de los tipos de la siguiente sección
Lo que convierte esto en un grafo en lugar de una lista es el token de referencia 2 0 R. Significa "objeto 2, generación 0, esté donde esté en el fichero". El nodo del árbol de páginas de arriba no contiene su página; apunta al objeto 2, que apunta a sus recursos y a su content stream por el mismo mecanismo. Los objetos pueden aparecer en cualquier orden; las referencias los cosen en un árbol con raíz en el catálogo, la identidad viene del número de objeto y la ubicación viene de la tabla de referencias cruzadas
Ocho tipos de objeto, y cómo los objetos se apuntan entre sí
ISO 32000-1 §7.3 define qué pueden contener esos objetos, y la lista es corta: cada valor de un PDF es uno de ocho tipos básicos
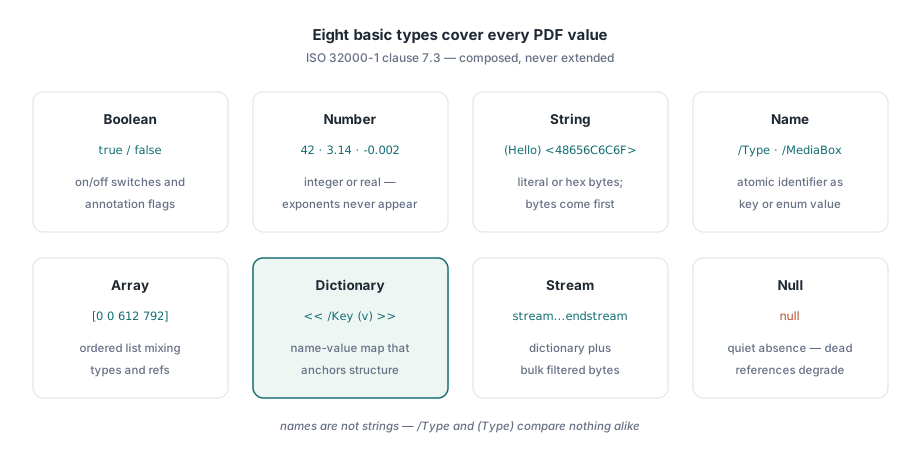
Los booleanos (true, false) y los números (enteros como 612, reales como 36.) son los escalares; el PDF no tiene notación exponencial, así que 1e6 nunca aparece en un fichero conforme. Las cadenas contienen bytes, escritas como (Hello, World!) o en hexadecimal como <48656C6C6F>; cómo se mapean esos bytes a caracteres depende de dónde se use la cadena. Los nombres como /Type o /Times-Italic son identificadores comparados byte a byte; escribir (Times-Italic) donde /BaseFont espera un nombre es un error de tipo aunque los caracteres coincidan. Los arrays contienen cualquier cosa en orden, como el MediaBox [0 0 612 792]. Los diccionarios mapean nombres a valores y cargan con la mayor parte de la estructura; página, catálogo y fuente en el ejemplo son todos diccionarios. Un stream es un diccionario más bytes en bruto, hogar del contenido de página, de los programas de fuente y de las imágenes. El octavo tipo es null: una entrada puesta a null cuenta como ausente, y una referencia a un objeto que no existe resuelve a null en lugar de elevar un error, lo que permite que un fichero dañado se degrade en lugar de fallar del todo
Cualquiera de esos valores puede escribirse de dos formas. Un objeto directo va en su sitio, como el 612 dentro del array MediaBox. Un objeto indirecto recibe una identidad, el envoltorio N G obj ... endobj, para que otros objetos puedan alcanzarlo con N G R. Así es como una fuente o imagen se define una vez y se comparte entre cien páginas. En el ejemplo, el diccionario de fuente es directo, anidado en los recursos, mientras que los recursos en sí son indirectos y la página los alcanza a través de 3 0 R
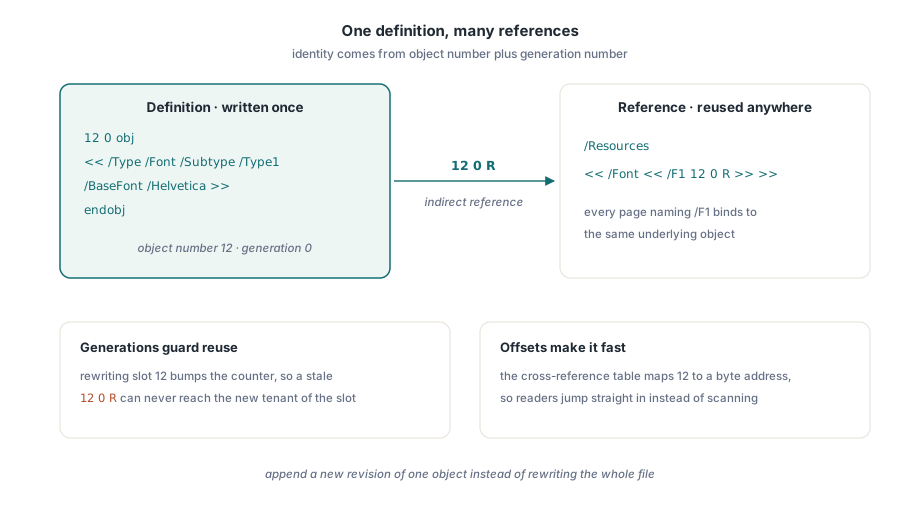
El número de generación está ahí para la reutilización. Cuando se borra un objeto, su número pasa a la lista de libres, y si una edición posterior reutiliza el número, la generación sube en uno. Un 12 0 R obsoleto que quede en algún sitio del fichero no puede entonces resolver en silencio al nuevo 12 1 obj. Casi todos los objetos que te encuentres son generación 0; uno distinto de cero te dice que el fichero se ha editado, y un parser que ignore el campo acabará cargando el objeto equivocado
La resolución empieza en el catálogo, el diccionario /Type /Catalog que nombra el tráiler (el objeto 5 en el ejemplo). Su entrada /Pages lleva al árbol de páginas, donde los nodos interiores reúnen páginas hoja en /Kids, mantienen un /Count y pueden pasar atributos como /MediaBox a sus descendientes. Cómo se forma ese árbol y por qué decide el orden de páginas se trata en árboles de páginas PDF y orden de páginas; los marcadores, los metadatos y las demás entradas opcionales del catálogo están en metadatos, marcadores y anotaciones PDF
La tabla de referencias cruzadas es un índice de desplazamientos de bytes
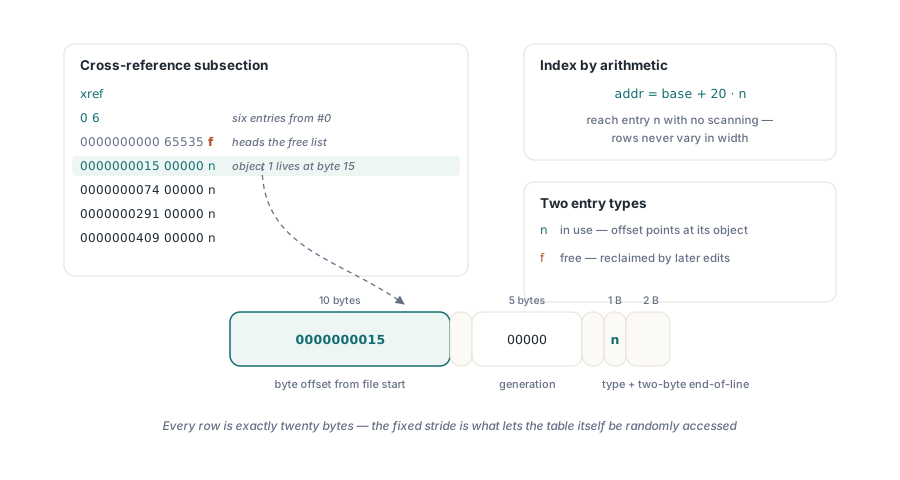
La tabla xref convierte números de objeto en posiciones de fichero, que es como un lector puede abrir un documento de mil páginas y renderizar la página 850 sin parsear las 849 anteriores. Cada entrada registra exactamente dónde empieza su objeto, contado en bytes desde el inicio del fichero:
xref
0 6                  % 6 entradas, empezando en el objeto 0
0000000000 65535 f   % entrada 0: cabeza de la lista de libres
0000000015 00000 n   % el objeto 1 empieza en el byte 15
0000000074 00000 n   % el objeto 2 empieza en el byte 74
0000000192 00000 n   % el objeto 3 empieza en el byte 192
0000000291 00000 n   % el objeto 4 empieza en el byte 291
0000000409 00000 n   % el objeto 5 empieza en el byte 409
La anchura fija es deliberada. Cada entrada tiene exactamente veinte bytes: un desplazamiento de diez dígitos, un espacio, una generación de cinco dígitos, un espacio, un tipo de un carácter y un final de línea de dos bytes. Como las filas son uniformes, un lector puede indexar directamente la entrada del objeto n mediante aritmética en lugar de escanear, por lo que la tabla que proporciona acceso aleatorio al cuerpo es en sí misma accesible aleatoriamente. La línea 0 6 es una cabecera de subsección: indica que las siguientes entradas describen seis objetos a partir del número 0
El objeto 0 es especial y siempre está presente. Su tipo es f de libre, su generación es 65535, y encabeza la lista enlazada de números de objeto libres. En un fichero que nunca se ha editado la lista de libres es solo esta entrada, una formalidad. Se gana el sueldo durante las actualizaciones incrementales, cuando borrar un objeto añade su número a esa lista para que una edición posterior pueda reclamarlo con la generación subida. Las demás entradas son de tipo n, en uso, y su número de diez dígitos es donde empieza la definición de ese objeto
El tráiler es el punto de entrada, y está al final
El tráiler se escribe el último y se lee el primero. Un parser abre el fichero, salta al final y camina hacia atrás buscando %%EOF. Justo encima está startxref seguido de un único número, y ese número es el offset de bytes de la palabra clave xref. Con él el lector salta directamente a la tabla de referencias cruzadas sin haber escaneado un solo objeto:
trailer
<<
/Root 5 0 R          % el catálogo del documento
/Size 6              % uno más que el número de objeto más alto
>>
startxref
459                  % offset en bytes de la tabla xref
%%EOF
El diccionario del tráiler lleva los dos valores que un lector necesita antes de poder hacer nada más. /Root apunta al catálogo del documento, el objeto 5 aquí. /Size es el conteo de entradas que debería contener la tabla de referencias cruzadas, uno más que el número de objeto más alto por la entrada libre de la posición cero. Desde %%EOF sale toda la secuencia de lectura: encontrar el marcador, leer startxref para localizar la tabla, cargar la tabla para saber dónde vive cada objeto, leer /Root para encontrar el catálogo y resolver objetos bajo demanda desde ahí
La actualización incremental añade un segundo mapa en lugar de reescribir
Ese diseño de cola primero rinde frutos cuando un fichero cambia. Un PDF puede editarse sin reescribir ninguno de los bytes ya en disco. Los objetos nuevos y modificados se añaden al final, seguidos de una sección de referencias cruzadas nueva y un tráiler nuevo, y el fichero original queda intacto. El único registro nuevo es una entrada /Prev en el nuevo tráiler, que contiene el desplazamiento de bytes de la tabla de referencias cruzadas anterior:
% ... original file, unchanged, ends here ...

6 0 obj                          % un objeto añadido por esta edición
<< /Type /Annot /Subtype /Text /Rect [100 700 120 720] >>
endobj

xref                             % una segunda sección xref, solo para el objeto nuevo
6 1
0000000612 00000 n

trailer
<<
/Root 5 0 R
/Size 7
/Prev 459                        % offset en bytes de la tabla xref anterior
>>
startxref
680                              % offset de esta nueva sección xref
%%EOF
Un lector sigue empezando por el %%EOF final, sigue el startxref hasta la tabla más reciente, pero ahora sigue la cadena /Prev hacia atrás hasta las tablas más antiguas, fusionándolas de modo que gane la entrada más nueva de cada número de objeto. Un objeto que una edición reemplazó sigue existiendo físicamente en su offset antiguo; simplemente ya no es alcanzable, porque una entrada xref posterior apunta a algún sitio más nuevo
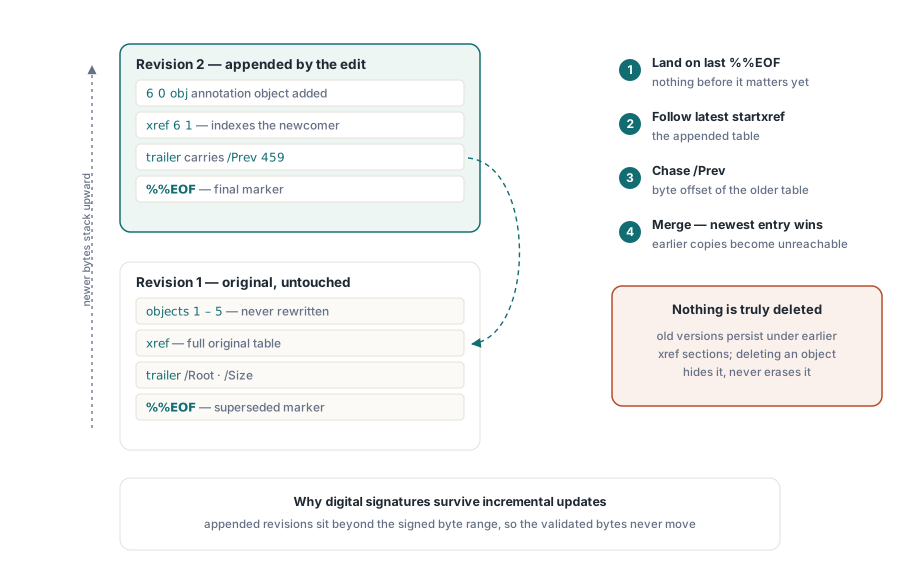
Este es el mecanismo que hace verificables los PDF firmados. Una firma digital cubre un rango de bytes del fichero, y como una actualización incremental solo añade al final, los bytes firmados nunca se mueven. También es por lo que un PDF puede llevar historial recuperable: cada objeto superado sigue en disco bajo una sección de referencias cruzadas anterior, lo que es una característica para el seguimiento de versiones y un pasivo para quien pensó que "borrar" significaba que los bytes desaparecían
El coste es el crecimiento. Cada edición añade; nada se recupera en el sitio, así que un fichero revisado muchas veces acumula objetos muertos y una larga cadena de secciones xref. El remedio es una reescritura completa: cargar el documento y guardarlo de nuevo, lo que renumera los objetos supervivientes, descarta los inalcanzables y emite una única tabla de referencias cruzadas limpia. Añadir es rápido y conserva firmas e historial; reescribir renuncia a ambas cosas a cambio de un fichero compacto
Leer las cuatro partes en la práctica
Conocer la disposición basta para depurar a mano la mayoría de problemas de "este fichero no abre", y los culpables habituales están en los dos extremos del fichero. Una descarga truncada pierde el tráiler, así que falta startxref o %%EOF y el lector no tiene punto de entrada; los lectores tolerantes recurren a escanear el fichero entero para reconstruir el xref, que es el camino lento que la tabla pretendía evitar. Una transferencia en modo texto chapucera corrompe bytes de stream o los offsets dejan de cuadrar con la realidad, y los objetos se cargan desde la posición equivocada
Escribir el fichero a mano y dejar que qpdf arregle los offsets
Teclear un PDF en un editor de texto hace que todo esto se quede, porque el fichero no abrirá hasta que las referencias estén bien. Trata los offsets y el /Length que tecleas como marcadores de posición desde el principio, el listado del comienzo de este artículo incluido: quítale los comentarios al margen o guárdalo con CRLF en vez de LF, y cada número de su tabla xref se mueve. Cablea los objetos tú mismo y deja la aritmética a una herramienta
La parte que merece escribirse con cuidado es el content stream, un pequeño programa en el lenguaje de descripción de página del PDF. Es postfijo: primero van los operandos, luego el operador que los consume. Aquí está el stream para el mismo saludo en su forma más común de cinco líneas:
BT
/F0 36 Tf
50 700 Td
(Hello, World!) Tj
ET
BT y ET abren y cierran un objeto de texto, y todo operador que posicione o muestre texto tiene que ir entre ellos. /F0 36 Tf selecciona la fuente que los recursos de la página llaman /F0, a 36 puntos. 50 700 Td mueve la posición de texto a (50, 700). (Hello, World!) Tj pinta la cadena en esa posición. Quita BT y un lector estricto rechaza los operadores de texto; llama a Tj antes que a Tf y no hay fuente actual con la que dibujar
El ejemplo del comienzo llega al mismo punto por otro camino. Ejecuta 1 0 0 1 50 700 cm antes de BT, lo que traslada todo el sistema de coordenadas para que su origen quede en (50, 700); BT empieza entonces el texto en ese origen, así que no hace falta Td. De cualquier forma los números están en el espacio de usuario del PDF: origen en la esquina inferior izquierda de la página, Y creciendo hacia arriba, una unidad por punto (1/72 de pulgada). En una página US Letter de 612 por 792, Y = 700 está cerca del borde superior. Tenlo presente para la versión Delphi de abajo, que cuenta al revés
/Length es el conteo de bytes de los datos del stream entre la línea stream y endstream, y tiene que ser exacto. Un lector se fía de él para saber dónde acaban los datos; si se queda corto, el lector aterriza en mitad del texto y nunca encuentra endstream donde lo esperaba. Los finales de línea cambian el total, que es por lo que contar a mano es una batalla perdida
Así que guarda el borrador como hello-draft.pdf con los offsets y longitudes que hayas tecleado, y deja que qpdf lo reescriba:
qpdf hello-draft.pdf hello.pdf
qpdf --check hello.pdf
qpdf parsea los objetos, recalcula cada offset y longitud de stream, y escribe una tabla xref y un tráiler limpios. Alimentado con un borrador de offsets tecleados y un /Length a cero, qpdf 12.3.2 dice que el fichero está dañado y que el xref no está donde apunta startxref, imprime "Attempting to reconstruct cross-reference table" y luego "attempting to recover stream length" con la longitud que encontró, y sale con estado 3, que qpdf usa para "terminó con avisos". Los avisos son sobre el borrador; --check sobre la salida no reporta errores de sintaxis ni de codificación de streams. Si tienes pdftk en su lugar, pdftk hello-draft.pdf output hello.pdf hace una reescritura parecida
La misma página desde Delphi con HotPDF
Generar la misma página desde código y leer la salida junto a tu fichero escrito a mano muestra qué llamada produjo qué objeto. Con HotPDF son un puñado de llamadas:
uses
  System.SysUtils, Vcl.Graphics, HPDFDoc;

procedure WriteHelloWorld(const FileName: string);
var
  HotPDF: THotPDF;
begin
  HotPDF := THotPDF.Create(nil);
  try
    HotPDF.AutoLaunch := False;       // el True por defecto abre el fichero en un visor
    HotPDF.FileName := FileName;
    HotPDF.Compression := cmNone;     // el valor por defecto, explícito: los streams siguen legibles
    HotPDF.SimpleLatinFonts := True;  // ASCII en una fuente estándar: fuente simple sin incrustar
    HotPDF.BeginDoc;                  // catálogo, árbol de páginas, diccionario info, primera página

    HotPDF.CurrentPage.Size := Letter;  // MediaBox [0 0 612 792]
    HotPDF.CurrentPage.SetFont('Times New Roman', [fsItalic], 36);
    HotPDF.CurrentPage.TextFromBaseLine(True);
    HotPDF.CurrentPage.TextOut(50, 792 - 700, 0, 'Hello, World!');

    HotPDF.EndDoc;                    // offsets, /Length, tabla xref, tráiler
  finally
    HotPDF.Free;
  end;
end;
El argumento Y es donde la gente tropieza. TextOut toma coordenadas de página con el origen en la esquina superior izquierda e Y creciendo hacia abajo, en puntos por defecto, y la página convierte cada Y restándola de la altura de la página antes de escribir el Td. Así que el 700 que el stream en bruto mide desde abajo se convierte en 792 − 700 = 92 medido desde arriba. El segundo detalle es a qué se refiere Y. Por defecto TextOut lo trata como la parte superior de la línea de texto y baja la línea base en la altura del texto; TextFromBaseLine(True) hace que Y sea la línea base, que es lo que Td significa en el stream escrito a mano. Sáltate esa llamada y el texto aterriza aproximadamente una línea más abajo que en tu fichero
El resto mapea directamente. BeginDoc crea el catálogo, el árbol de páginas, la primera página y un diccionario de información del documento que el fichero hecho a mano no tiene. SetFont('Times New Roman', [fsItalic], 36) resuelve a la fuente estándar Times-Italic, y con SimpleLatinFonts activado, el ASCII plano en una fuente estándar sale como fuente simple sin incrustar con /WinAnsiEncoding, el mismo tipo de diccionario de fuente que está dentro del objeto 3. TextOut escribe BT, Td, Tj y ET en el content stream de la página. EndDoc hace la parte que qpdf hizo por ti: rellena la longitud del stream, calcula cada offset y escribe la tabla xref y el tráiler. Con UseXRefStream en su valor por defecto false, eso es una tabla de texto clásica y no un stream de referencias cruzadas
Deja que la biblioteca lleve la contabilidad de bytes
Pasado el ejercicio de aprendizaje, entrega la contabilidad al código: offsets que coincidan con las posiciones de los objetos al byte, un tráiler que nombre la tabla correcta, revisiones encadenadas correctamente mediante /Prev. El HotPDF Delphi Component para Delphi y C++Builder hace todo eso al guardar y cubre las dos estrategias de la sección de actualización incremental: BeginIncrementalUpdate y SaveIncrementalUpdate añaden una revisión a un fichero existente, mientras que el camino BeginDoc / EndDoc escribe un fichero completo con una única tabla xref. Los propios operadores del content stream se tratan con más profundidad para texto y fuentes y para gráficos