Un loader en Delphi que parsea un paquete XLSX de ocho hojas en ocho hilos de trabajo puede mostrar una gráfica de CPU que apenas pasa de un núcleo, y barrer el número de hilos de dos a ocho deja el cronómetro casi donde estaba. Con dos hilos la carga puede salir incluso más lenta que un bucle serie plano. El código de parseo no toma ningún lock propio y las hojas no comparten datos, así que la espera ocurre en algún sitio que el fuente nunca menciona: dentro del gestor de memoria, al que cada uno de esos workers llama por cada nombre de elemento, valor de atributo y celda
El número de hilos es la rueda a la que todo el mundo echa mano primero. Para código limitado por asignaciones apenas mueve nada. Lo que mueve la curva es el número de asignaciones de heap que cuesta cada celda
Cómo HotXLS divide Open en tres fases
HotXLS parsea por defecto las hojas de un paquete XLSX multihoja en hilos de trabajo. TXLSXWorkbook.ParallelParse arranca en True, y ParallelParseThreads arranca en 0, lo que significa un worker por procesador lógico que reporte el sistema operativo, nunca más workers que hojas que parsear. Solo una de las tres fases de Open corre en esos workers. La fase A es serie: lee la parte del libro, las cadenas compartidas y los estilos, crea cada hoja con su nombre y visibilidad, y parsea el fichero de relaciones de cada hoja para que los destinos de hipervínculos y tablas ya estén resueltos. Para cuando un worker arranca, cada tabla de búsqueda que consulta está completa y solo se lee
La fase B entrega cada hoja a un worker. Los workers reclaman índices de hoja de un contador compartido con un incremento interlocked, así que un libro con una hoja grande y siete pequeñas se equilibra solo sin planificador: quien termina una hoja pequeña simplemente toma el siguiente índice. El contenedor ZIP es la parte que no se puede compartir ingenuamente, porque un stream deflate arrastra estado de un bloque al siguiente y dos hilos no pueden avanzar el mismo descompresor. Cada worker abre por tanto su propio descompresor sobre su propia entrada de hoja y vuelca el XML directamente a su propio reader. El handle de fichero es el único recurso compartido, y el lock a su alrededor cubre un solo seek-and-read de bytes comprimidos cada vez. Descompresión y parseo corren ambos en paralelo, y el XML de ninguna hoja se mantiene nunca inflado del todo en memoria. Cuando el parseo termina, el worker lee su entrada hasta el final para que las comprobaciones de tamaño y CRC del ZIP sigan ejecutándose
La fase C vuelve a un único hilo para las partes que cuelgan de cada hoja: comentarios y comentarios en hilo, drawings y gráficos, tablas y ajustes de impresora. En la mayoría de libros son pequeñas al lado del XML de celdas
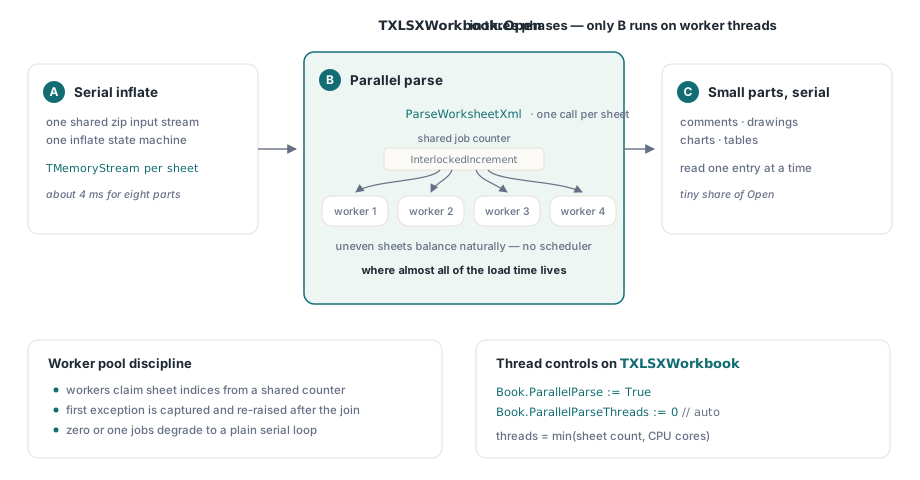
Los errores vuelven en el hilo llamante. Cuando una hoja eleva una excepción durante el parseo, el pool deja de repartir índices nuevos, espera a los workers que todavía corren y luego vuelve a elevar desde Open la excepción de la hoja con número más bajo que falló, así que el informe sigue el orden de hojas y quien llama nunca tiene que lidiar con una excepción escapando de un hilo de trabajo. Con RecoveryMode a True, una hoja que no se puede parsear se salta en su lugar, un aviso aterriza en Diagnostics y el resto de hojas cargan con normalidad. Poner ParallelParse a False ejecuta el mismo parser sobre las hojas de una en una y produce resultados idénticos
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    // Ambos valores son los por defecto; escribirlos deja la elección
    // visible en la revisión de código
    Book.ParallelParse := True;
    Book.ParallelParseThreads := 0;  // 0 = un worker por CPU lógica, con tope en el número de hojas
    Book.RecoveryMode := False;      // una hoja que no se puede parsear eleva desde Open
    if Book.Open('quarterly-ledger.xlsx') <> 1 then
      raise Exception.Create('open failed');
    // aquí cada hoja está cargada por completo; lee celdas como de costumbre
  finally
    Book.Free;
  end;
end;
¿Por qué más hilos hacen más lento un parser cargado de asignaciones?
El parseo de hojas es sobre todo asignaciones pequeñas, y el gestor de memoria por defecto de Delphi hace que los hilos se turnen en ellas. Un reader XML ingenuo produce una cadena por cada nombre de elemento, otra por cada nombre y valor de atributo, un Variant para la celda y una cadena para su texto. El gestor de memoria por defecto guarda los bloques pequeños en pools agrupados por tamaño y protege cada pool con un lock. Un hilo que encuentra el lock tomado se retira y duerme antes de reintentar. Cuando ocho workers piden todos el mismo puñado de tamaños diminutos, no paran de chocar en los mismos pools, y unos hilos que parecen independientes en el fuente acaban corriendo uno detrás de otro
Eso explica los dos síntomas del comienzo. El tiempo de CPU se queda cerca del tiempo de reloj porque un hilo dormido no quema CPU, y el barrido de hilos se queda plano porque el ritmo lo marcan los locks de los pools, no los núcleos. Dos hilos pueden perder contra uno sin paliativos: cada asignación paga ahora por pasarse un lock de un núcleo a otro, mientras que el bucle serie nunca compite
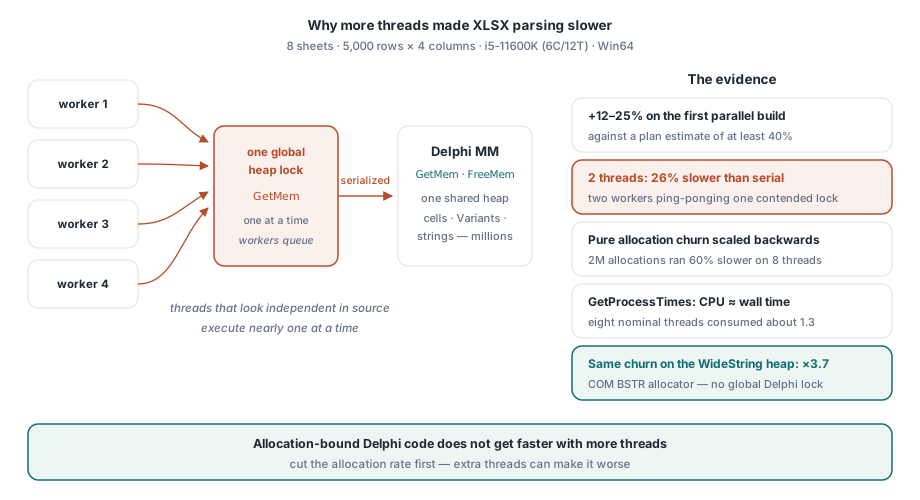
Un tipo de cadena queda fuera de esto en Windows. Un WideString es un BSTR de COM, asignado por el asignador de cadenas OLE del sistema y no por el gestor de memoria de Delphi, así que el tráfico de WideString nunca hace cola en los pools de Delphi. HotXLS guarda el texto de las celdas como WideString, lo que importa más para la carga paralela de lo que nunca importó para el camino serie
Medir la contención en tus propios libros
Dos números te dicen si una carga está limitada por asignaciones: cómo cambia el tiempo de reloj al subir el número de workers, y cuánta CPU consumió el proceso en ese mismo intervalo. Si el tiempo de CPU dividido por el de reloj se queda cerca de 1.0 mientras ocho workers están nominalmente ocupados, están haciendo cola en lugar de parsear. El barrido de abajo abre el mismo fichero con uno a ocho workers e imprime ambas cifras. Es un arnés de medida para tu propio proyecto de test; solo los miembros de TXLSXWorkbook vienen de HotXLS
uses
  Winapi.Windows, System.SysUtils, System.Math, System.Diagnostics;

// Tu propio ayudante: tiempo de CPU usuario + kernel de este proceso, en milisegundos
function ProcessCpuMs: Int64;
var
  Created, Exited, Kernel, User: TFileTime;
begin
  GetProcessTimes(GetCurrentProcess, Created, Exited, Kernel, User);
  Result := (Int64(Kernel) + Int64(User)) div 10000;  // ticks de 100 ns a ms
end;

procedure SweepThreads(const FileName: string);
var
  N: Integer;
  Book: TXLSXWorkbook;
  SW: TStopwatch;
  Cpu0, Cpu: Int64;
begin
  for N := 1 to 8 do
  begin
    Book := TXLSXWorkbook.Create;
    try
      Book.ParallelParseThreads := N;  // 1 ejecuta el bucle serie plano
      Cpu0 := ProcessCpuMs;
      SW := TStopwatch.StartNew;
      if Book.Open(FileName) <> 1 then
        raise Exception.CreateFmt('open failed: %s', [FileName]);
      SW.Stop;
      Cpu := ProcessCpuMs - Cpu0;
      Writeln(Format('%d workers: %d ms wall, CPU/wall %.2f',
        [N, SW.ElapsedMilliseconds, Cpu / Max(Int64(1), SW.ElapsedMilliseconds)]));
    finally
      Book.Free;
    end;
  end;
end;
Ejecuta el barrido varias veces y quédate con la mejor cifra de cada número de workers, ya que la primera ejecución paga también una caché de disco fría. Una curva de tiempo de reloj plana con CPU/reloj cerca de 1 significa que el gestor de memoria es el techo. Si el tiempo de reloj sigue bajando mientras CPU/reloj sube hacia el número de workers, el fichero está limitado por el parseo y los workers extra se están ganando el sitio
Una curva plana lleva a la siguiente pregunta: ¿qué asignaciones son responsables? Un wrapper del gestor de memoria que cuente llamadas por tamaño lo responde en unos minutos sin profiler de por medio. La versión de abajo solo cuenta GetMem y deja FreeMem y ReallocMem apuntando al gestor original, que es suficiente para ver de dónde viene el tráfico
// Diagnóstico que añades a tu propio arnés de test; no forma parte de HotXLS
var
  OldMM, NewMM: TMemoryManagerEx;
  AllocCount, TinyCount: Int64;

function CountingGetMem(Size: NativeInt): Pointer;
begin
  AtomicIncrement(AllocCount);
  if Size <= 32 then
    AtomicIncrement(TinyCount);  // el churn de bloques pequeños que merece vigilar
  Result := OldMM.GetMem(Size);
end;

procedure InstallCounter;
begin
  GetMemoryManager(OldMM);
  NewMM := OldMM;
  NewMM.GetMem := CountingGetMem;
  SetMemoryManager(NewMM);
end;

procedure RemoveCounter;
begin
  SetMemoryManager(OldMM);
end;
Instala el contador justo antes de Open, quítalo justo después y divide AllocCount por el número de celdas del fichero. Esa cifra por celda es la que seguir de build en build, y la proporción de bloques de 32 bytes o menos muestra si dominan las cadenas cortas. Compruébala antes de escribir un pool de objetos de celda: cada objeto de celda es una asignación, y las cadenas efímeras creadas mientras se parsea esa celda pueden superarlo fácilmente varias veces
Dónde se esconden las asignaciones en el XML de la hoja
Una celda como <c r="B7" s="3" t="s"><v>42</v></c> parece diminuta en disco. Un reader directo la convierte aun así en una ristra de cadenas nuevas: los nombres de elemento c y v, tres nombres de atributo, tres valores de atributo y el contenido de texto. Convertir cada token UTF-8 a través de la RTL añade un UnicodeString intermedio antes de que exista el WideString final. Ninguna de esas cadenas sobrevive a la celda, y cada una de ellas es un viaje por el gestor de memoria
El reader XML de HotXLS ataca las dos fuentes mayores. Los nombres de elemento en el XML de hojas vienen de un vocabulario muy pequeño (row, c, v, f, is), así que el reader guarda una caché corta de nombres que ya ha visto, compara los bytes en bruto de cada nombre nuevo contra esa caché y devuelve la cadena cacheada si coincide. Las copias cacheadas son deliberadamente AnsiString. AnsiString tiene conteo de referencias, así que entregar una instancia cacheada cuesta un incremento de contador y ninguna asignación. Una caché de nombres WideString no compraría nada: WideString no tiene conteo de referencias, y cada copia hace una nueva asignación del sistema
Los nombres de atributo, los valores de atributo y el texto de celda toman el otro camino. El reader decodifica UTF-8 directamente desde su búfer de escaneo en dos pasadas: la primera cuenta unidades de código UTF-16, la segunda rellena un WideString asignado una sola vez a exactamente esa longitud. Eso es una asignación por token, y aterriza en el asignador de cadenas del sistema en lugar de en los pools de Delphi. Las referencias de carácter como A y las entidades predefinidas las resuelve el escáner antes de que empiece la decodificación, así que el decodificador solo ve UTF-8 plano. Para secuencias de bytes que no son UTF-8 válido, el decodificador copia los bytes conflictivos uno a uno donde la conversión de la RTL los descartaría o reemplazaría, así que un fichero dañado sigue dando ASCII legible alrededor del punto malo. La entrada válida se decodifica al mismo texto de cualquiera de las dos formas
Las dos jugadas se trasladan a tu propio código de parseo en Delphi. Cachear cadenas solo ahorra asignaciones cuando el tipo de cadena tiene conteo de referencias, y decodificar directamente al tipo de destino elimina el temporal que las cómodas funciones de conversión de la RTL crean en cada llamada
Qué libros ganan y qué ajustes elegir
El parseo paralelo trabaja a granularidad de hoja, así que la forma del libro decide la mayor parte del resultado. Varias hojas de tamaño comparable son el mejor caso, incluidos los ficheros que obtienes al duplicar una hoja plantilla una vez por región o por mes. Un libro que es una única hoja gigante se parsea en un worker diga lo que diga ParallelParseThreads; para esa forma encaja mejor el reader directo en streaming, porque nunca construye el libro entero en memoria. El tiempo gastado en comentarios, gráficos y drawings se queda en la fase C serie. Un fichero con cero o una hoja que parsear se salta el pool y ejecuta el bucle serie plano
Cuando solo importan algunas hojas, lista sus nombres en SelectedSheets antes de llamar a Open. Las demás hojas se crean igualmente con su nombre y visibilidad pero sin celdas, los workers pasan de largo, y LoadSheet rellena una más tarde si el usuario la abre
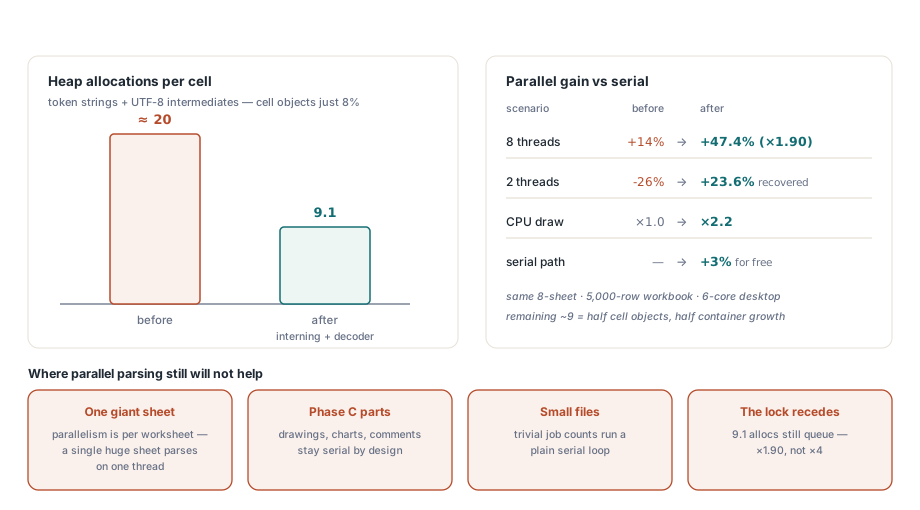
Deja ParallelParse activado para herramientas de escritorio y trabajos por lotes que abren un libro cada vez. Ese valor por defecto es el más seguro: los resultados coinciden con el camino serie, y una propiedad lo apaga si alguna vez surge una duda de threading. Un servidor que ya abre varios libros a la vez es distinto. Cada hilo de petición también está asignando, así que cada worker de parseo extra añade otro contendiente por los mismos pools del gestor de memoria; fija ahí ParallelParseThreads a 2, y súbelo solo después de que el barrido de arriba, ejecutado en ese servidor bajo su carga normal, muestre que los workers extra se pagan solos. Menos asignaciones por celda suben el techo sin quitarlo. Los objetos de celda y el crecimiento de contenedores siguen pasando por los pools de Delphi, que es por lo que la ganancia con ocho workers se queda bastante por debajo de ocho veces. Para el resto del kit de carga y guardado, desde la reutilización de estilos hasta los callbacks de filas en bloque, mira la guía de rendimiento con libros grandes en Delphi
El pool de workers, los interruptores ParallelParse y ParallelParseThreads y el reader XML austero en asignaciones vienen todos en el HotXLS Delphi Excel Component, que lee y escribe XLS, XLSX y ODS directamente desde código Delphi y C++Builder sin Excel instalado en la máquina