Cuando una exportación de 300.000 filas revienta su presupuesto de memoria, el recuento de filas suele llevarse la culpa. El recuento de filas normalmente es inocente. Las partes caras de un libro de trabajo grande son las que se crean como efecto secundario: un pool de estilos que crece una entrada por celda porque el formato se añadió dentro del bucle, el XML de la hoja ensamblado como una única cadena gigante en el momento de guardar, un millón de cuerpos de fórmula idénticos almacenados uno a uno. HotXLS, la biblioteca nativa de Delphi de losLab para archivos XLS y XLSX, le da una palanca específica para cada uno de estos costes. Ninguna está activada por defecto, porque cada una cambia un compromiso, así que saber qué palanca corresponde a qué síntoma es la auténtica habilidad de rendimiento
Dónde gasta memoria un libro de trabajo grande
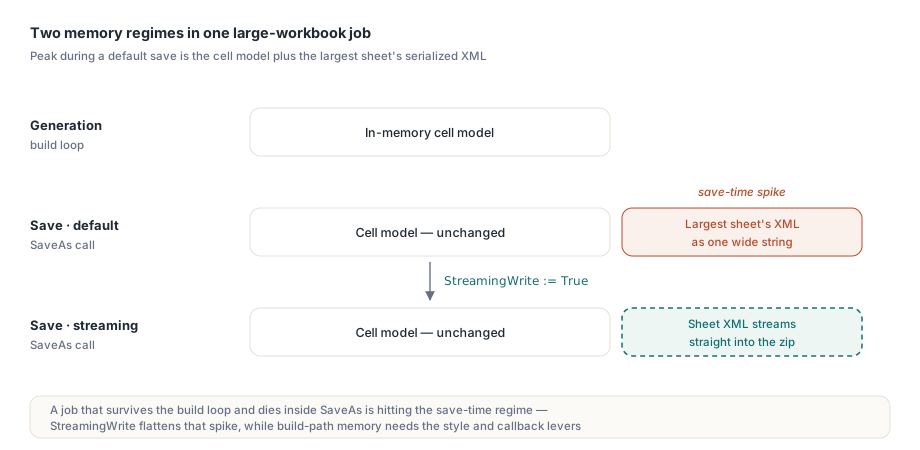
Hay dos regímenes de memoria distintos sobre los que razonar. Durante la generación, el modelo de celdas en memoria crece con cada celda que toca: valores, formatos, y fórmulas se convierten todos en objetos o entradas de pool. Durante el guardado, la ruta XLSX por defecto además renderiza el XML de cada hoja en una cadena ancha antes de comprimirla en el contenedor zip, así que el uso máximo es el modelo más la forma serializada de la hoja más grande. Un job que sobrevive al bucle de construcción y luego muere dentro de SaveAs está topando con el segundo régimen, no con el primero, y la solución de uno no hace nada por el otro
El tamaño de archivo sigue una regla relacionada: las celdas son solo un contribuyente, junto a los estilos, las cadenas compartidas, las fórmulas, las imágenes y los comentarios. Un paso de auditoría con ForEachCell y los recuentos de colección por hoja le dice qué recurso domina realmente un archivo problemático antes de que optimice el equivocado. Una sutileza de medición: Sheet.Cells.Count en el lado XLSX reporta el número de celdas instanciadas en el almacén disperso, no el área del rango usado. Una hoja cuyos datos ocupan un rectángulo de 1000 por 50 con la mitad de las celdas vacías cuenta aproximadamente 25.000, no 50.000. Esa distinción importa cuando compara el archivo "enorme" de un cliente con sus fixtures, porque el área del rango usado y la población real de celdas pueden diferir en un orden de magnitud en diseños financieros dispersos
StreamingWrite arregla la ruta de guardado, no la ruta de construcción
Fijar TXLSXWorkbook.StreamingWrite := True cambia SaveAs a un serializador en streaming que escribe el XML de la hoja directamente en el stream zip, eliminando el intermediario de cadena por hoja. Por defecto es False por compatibilidad de comportamiento, y activarlo es un cambio de una línea:
Book := TXLSXWorkbook.Create;
try
  Sheet := Book.Sheets.Add('Bulk');
  for R := 1 to 100000 do
  begin
    Sheet.Cells[R, 1].Value := R;
    Sheet.Cells[R, 2].Value := 'Row ' + IntToStr(R);
    Sheet.Cells[R, 3].Value := R * 1.5;
  end;
  Book.StreamingWrite := True;   // el XML de la hoja se transmite al contenedor zip
  Book.SaveAs('bulk.xlsx');
finally
  Book.Free;
end;
Sea preciso sobre lo que esto compra: el modelo de celdas construido por el bucle ocupa exactamente la misma memoria que antes. StreamingWrite aplana el pico del momento de guardar, que es la diferencia entre un job por lotes que se completa y uno que falla en la marca del 95%. Si el propio bucle de construcción agota la memoria, las palancas que necesita son las dos siguientes
Pools de estilo: añada una vez, reutilice el índice
El formato XLSX en HotXLS se basa en pools: Book.Fonts.Add(...), Fills.AddSolid(...) y Borders.Add(...) devuelven un índice de pool en base 0 al que hacen referencia las celdas. Llamar a Fonts.Add con parámetros idénticos dentro de un bucle se deduplica, así que desperdicia tiempo en lugar de espacio. Alignments.Add se comporta de forma distinta: devuelve un objeto nuevo en cada llamada, así que crear alineación por celda hace crecer el pool linealmente con el número de filas. Un hábito cubre ambos casos. Resuelva cada índice de pool una vez, fuera del bucle, y asigne los índices dentro de él
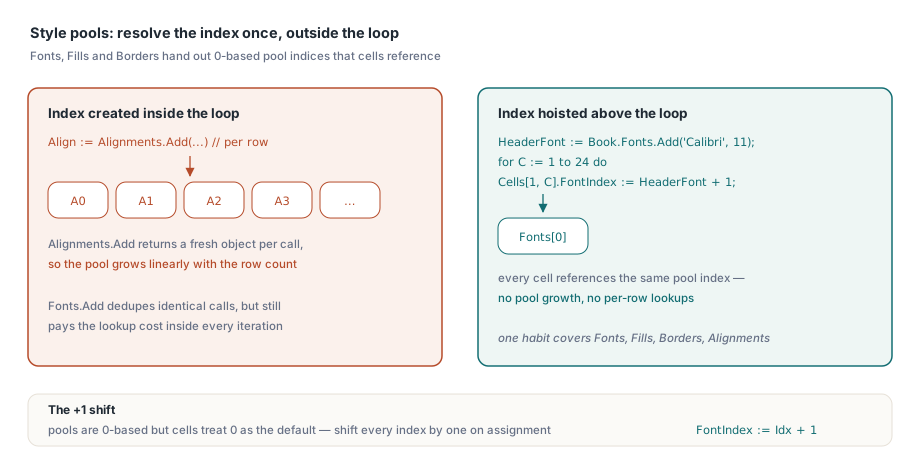
// saca las búsquedas de pool del bucle caliente
HeaderFont := Book.Fonts.Add('Calibri', 11, True, False);   // índice de pool en base 0
for C := 1 to 24 do
  Sheet.Cells[1, C].FontIndex := HeaderFont + 1;            // las celdas almacenan en base 1; 0 = por defecto
El + 1 no es una errata, y olvidarlo es el fallo clásico que genera este síntoma: los pools entregan índices en base 0, mientras que las propiedades del lado celda tratan el 0 como "por defecto", así que cada índice de pool debe desplazarse en uno al asignarlo. Equivóquese por omisión y sus cabeceras se renderizan silenciosamente en la fuente por defecto del libro de trabajo, un defecto que nadie nota hasta la revisión de marca
Sustituya el tráfico de Variant por celda con callbacks de fila
Cada Sheet.Cells[R, C].Value := X implica una búsqueda-o-creación de celda más una asignación de Variant. En unos pocos cientos de miles de celdas, ese sobrecoste por acceso se vuelve medible en los perfiles. HotXLS ofrece API de callback masivo en ambas fachadas (ForEachCell y ForEachRow para lectura, WriteCells y WriteRows para escritura) que mueven la iteración dentro del motor y entregan a su código filas enteras de una vez:
procedure TLedgerExport.FillRow(Sender: TObject;
  SheetIndex, Row, FirstCol, LastCol: Integer;
  var Values: Variant; var Skip: Boolean; var Cancel: Boolean);
begin
  if Row > FCount then
  begin
    Cancel := True;     // detiene toda la escritura
    Exit;
  end;
  Values := VarArrayOf([FRows[Row - 1].Account,
                        FRows[Row - 1].PostedOn,
                        FRows[Row - 1].Amount]);
end;

// una sola llamada al motor en lugar de cientos de miles de accesos a propiedades
Sheet.WriteRows(1, 1, FCount, 3, FillRow);
El indicador Skip del callback deja una fila intacta sin abortar, y Cancel termina la operación antes de tiempo, lo cual es útil cuando el origen es un lector cuya longitud descubre sobre la marcha. Combine WriteRows para la construcción con StreamingWrite para el guardado y la ruta de generación no le queda ningún punto caliente por celda
Palancas del lado de lectura en la fachada XLS
Los archivos .xls heredados grandes tienen su propio kit de herramientas. _DisableGraphics := True antes de Open se salta por completo el análisis de la capa de dibujo, lo que acelera la carga de libros de trabajo que llevan años de formas e imágenes incrustadas acumuladas. La restricción es dura: la capa de dibujo está entonces ausente del modelo, así que guardar tal libro de trabajo escribe un archivo sin sus dibujos. Reserve este indicador para jobs de análisis de solo lectura. SetTempDir redirige los archivos temporales del escritor BIFF, lo cual importa en servidores donde la ubicación temporal por defecto tiene una cuota o reside en almacenamiento lento. UseSharedFormulas agrupa cuerpos de fórmula repetidos en registros de fórmula compartida, reduciendo archivos donde una columna de fórmula se repite a lo largo de sesenta mil filas
Los bucles de lectura sobre datos XLS tienen una trampa de indexación que merece la pena señalar porque duplica el trabajo cuando se maneja de forma defensiva y corrompe los resultados cuando se pasa por alto: UsedRange reporta sus límites FirstRow, LastRow, FirstCol y LastCol en base 0, mientras que Cells.Item[Row, Col] es de base 1. Un escaneo que recorre el rango usado debe sumar uno a cada coordenada en el acceso a la celda, como en Cells.Item[Row + 1, Col + 1], o lee una cuadrícula desplazada diagonalmente una celda, descartando silenciosamente la última fila y columna e incluyendo una primera fantasma. El callback ForEachCell esquiva el desajuste por completo, que es una razón más para preferirlo en escaneos de hoja completa
Sondee los archivos antes de cargarlos
La operación más barata con un libro de trabajo grande es la que evita. GetSheetNames en ambas fachadas lista las hojas de un archivo sin cargar datos de celda. La implementación XLSX lee solo el manifiesto del libro de trabajo dentro del zip y deja explícitamente la instancia del libro de trabajo sin poblar, y la fachada XLS deja de escanear en el primer límite de subflujo. Eso la convierte en la comprobación previa correcta para "a qué hoja debería apuntar este job de importación", y CanReadEncrypted responde a "es esto un contenedor cifrado" antes de un intento de Open condenado al fracaso
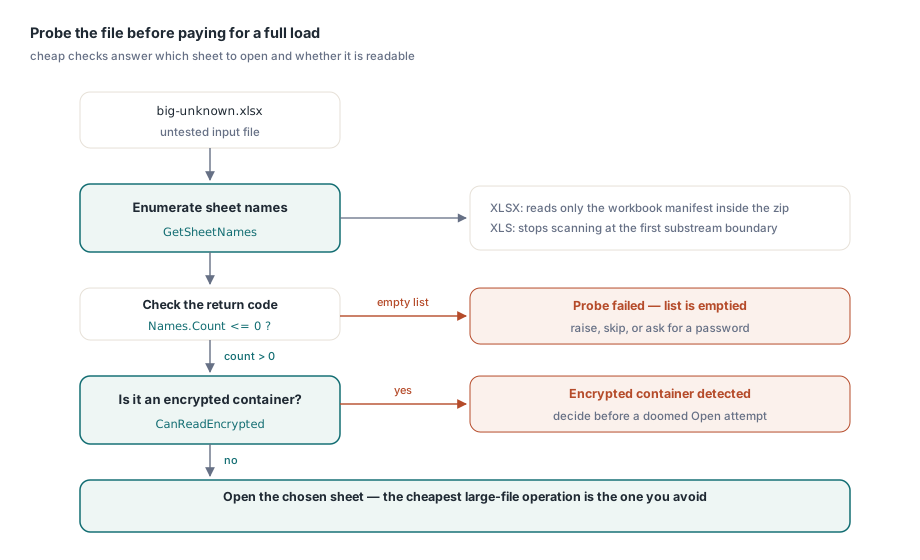
Names := TStringList.Create;
Book := TXLSXWorkbook.Create;
try
  if Book.GetSheetNames('big-unknown.xlsx', Names) <= 0 then
    raise Exception.Create('cannot enumerate sheets');   // el fallo vacía la lista
  // elija la hoja objetivo, y luego decida si merece la pena un Open completo
finally
  Book.Free;
  Names.Free;
end;
Observe la convención del código de retorno: estas funciones de sondeo señalan el fallo con valores en cero o por debajo y vacían la lista de salida, así que compruebe <= 0 en lugar de comparar contra un valor de éxito específico
Ajustar el enfoque al trabajo
Para pipelines desatendidos que generan muchos archivos grandes en secuencia, dos hábitos más completan el panorama. Los objetos de libro de trabajo no son seguros para hilos en uso compartido, pero nada impide un libro de trabajo independiente por hilo trabajador, lo que paraleliza limpiamente la conversión por lotes. Y cuando la salida va a HTTP en lugar de a disco, las sobrecargas de guardado con TStream se combinan con StreamingWrite para que una respuesta grande nunca se materialice como archivo temporal. Se aplica una nota operativa: el guardado en stream escribe desde la posición actual sin rebobinar, así que fije Position := 0 antes de entregar el stream al framework de respuesta. El artículo sobre escritura en streaming y jobs por lotes desarrolla ese patrón del lado servidor, y el artículo sobre exportación de base de datos muestra dónde encajan estas palancas en un informe dirigido por dataset
Por último, conserve un fixture de peor caso por familia de informe y cronométrelo en CI. Las regresiones de rendimiento en la generación de documentos rara vez se anuncian. Un estilo añadido dentro de un bucle o un sondeo sustituido por un Open completo no cambia nada funcionalmente, y el lote nocturno simplemente tarda cuarenta minutos más. Una prueba cronometrada sobre un fixture representativo de medio millón de celdas convierte esa deriva en una build en rojo en lugar de un incidente de operaciones
Las builds de evaluación, los proyectos de demostración con un ejemplo de generación masiva, y la referencia completa de la API están disponibles en la página de HotXLS Delphi Component