La pregunta «¿este libro sigue definiendo un nombre llamado TaxRate?» la responde una parte pequeña de un paquete XLSX. Los nombres de hojas, su estado oculto u oculto del todo y todos los nombres definidos a nivel de libro viven en xl/workbook.xml (ECMA-376 Part 1, §18.2), normalmente unos pocos kilobytes. Las celdas viven en otro sitio, una parte xl/worksheets/sheetN.xml por hoja más una tabla de cadenas compartidas, y ahí está casi todo el peso en bytes. Un cargador que exija construir el libro completo antes de dejarte preguntar nada infla y parsea todo eso, para cada archivo de la carpeta, para responder una pregunta que los primeros kilobytes ya tenían resuelta
La división que importa va entre leer la forma de un libro y leer su peso. Un cargador capaz de pararse tras la forma, cargar el peso para un subconjunto elegido de hojas y traer una hoja más más tarde convierte «abrir un libro» de un paso todo-o-nada en algo que acotas por llamada. También trae dos trampas consigo, una sobre las bases de índices y otra sobre cuánto tiempo tiene que quedarse quieto el archivo fuente
Qué lee un Open solo de metadatos, y dónde se para
Con TXLSXWorkbook.MetadataOnly a True antes de Open, HotXLS parsea la parte del libro, los estilos, el tema, los nombres definidos, los nombres de hojas y sus estados de visibilidad, las conexiones, los enlaces externos y las propiedades del documento desde docProps/core.xml y docProps/app.xml. Después se salta el XML de celdas de cada hoja y las partes satélite por hoja: comentarios, dibujos y tablas. La tabla de cadenas compartidas también se salta, lo que importa más de lo que suena, porque en libros cargados de texto esa única parte puede competir en tamaño con las propias hojas
El libro que vuelve está estructuralmente completo. Sheets.Count es correcto, cada hoja tiene su nombre real y su Visibility, DefinedNames está poblado, ExternalLinks lista cada destino enlazado, y Title, Author y LastModifiedBy llevan lo que el archivo declaró. Simplemente cada hoja tiene cero celdas
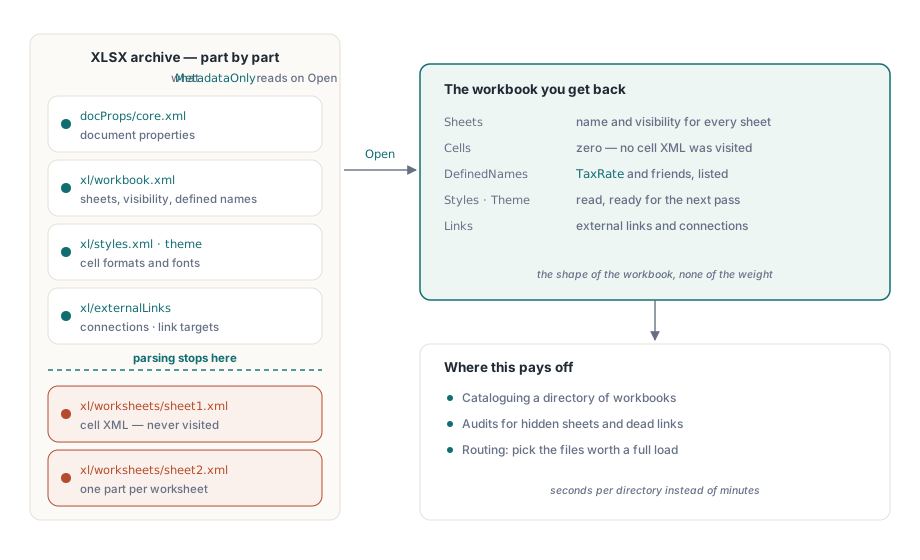
Esa es justamente la información sobre la que corre una auditoría. ¿Qué libros esconden una hoja? ¿Cuáles siguen definiendo TaxRate, y a qué? ¿Cuáles enlazan a un recurso compartido que se retiró el año pasado? El escáner de abajo responde las tres para un archivo. Fíjate en las dos convenciones de indexado lado a lado: Sheets[] es base 1, igual que el motor XLS, mientras que DefinedNames y ExternalLinks son listas corrientes base 0
procedure ScanWorkbook(const FileName: WideString; Report: TStrings);
var
  Workbook: TXLSXWorkbook;
  Name: TXLSXDefinedName;
  I: Integer;
begin
  Workbook := TXLSXWorkbook.Create;
  try
    Workbook.MetadataOnly := True;           // lo lee Open, así que fíjalo primero
    if Workbook.Open(FileName) <> 1 then
    begin
      Report.Add(FileName + ': open failed');
      Exit;
    end;
    for I := 1 to Workbook.Sheets.Count do   // Sheets[] es base 1
      case Workbook.Sheets[I].Visibility of
        xlsxSheetHidden:
          Report.Add(FileName + ': hidden sheet ' + Workbook.Sheets[I].Name);
        xlsxSheetVeryHidden:
          Report.Add(FileName + ': very hidden sheet ' + Workbook.Sheets[I].Name);
      end;
    Name := Workbook.DefinedNames.FindByName('TaxRate');
    if Name <> nil then
      Report.Add(FileName + ': TaxRate = ' + Name.Formula);
    for I := 0 to Workbook.ExternalLinks.Count - 1 do   // lista base 0
      Report.Add(FileName + ': links to ' + Workbook.ExternalLinks[I].Target);
  finally
    Workbook.Free;
  end;
end;
El escáner lee Visibility en lugar del Boolean Visible a propósito. Visible es False para los dos estados ocultos, y una hoja oculta del todo es justo la que una auditoría más quiere marcar, porque el diálogo Mostrar de Excel no la lista y solo VBA o una edición directa del archivo la devuelve
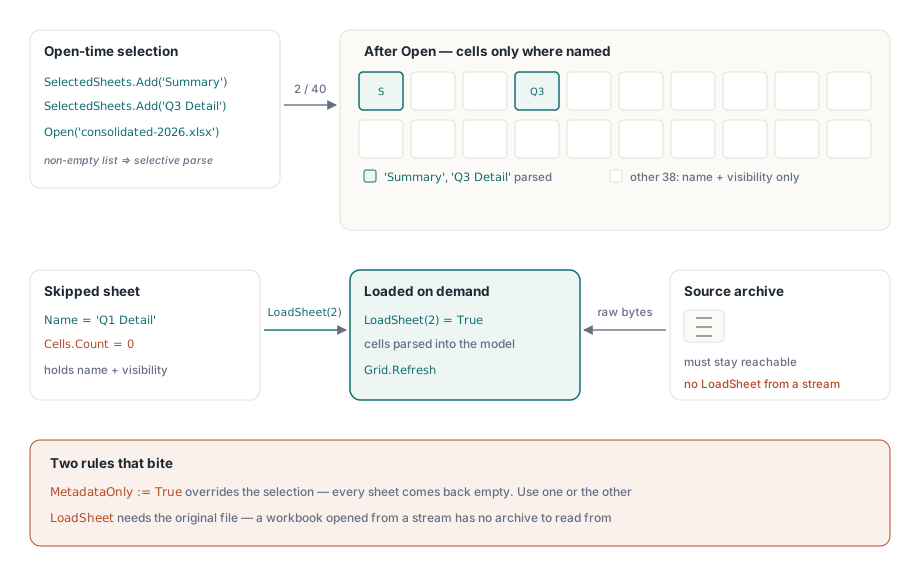
Cargar dos hojas de cuarenta con SelectedSheets
SelectedSheets es una TStringList propiedad del libro. Cuando lleva al menos un nombre, Open parsea el XML de celdas solo para las hojas que nombra; todas las demás se crean con su nombre y visibilidad correctos y sin celdas. Una lista vacía, el valor por defecto, carga todas las hojas. Los nombres se buscan con el IndexOf propio de la lista, así que con los ajustes por defecto la comparación ignora mayúsculas, lo que casa con la regla de Excel de que dos nombres de hoja en un libro no pueden diferir solo en mayúsculas
Workbook := TXLSXWorkbook.Create;
Workbook.SelectedSheets.Add('Summary');
Workbook.SelectedSheets.Add('Q3 Detail');
if Workbook.Open('consolidated-2026.xlsx') = 1 then
  ShowSheet(Workbook.Sheets[1]);   // ShowSheet es tu propio código de interfaz
Los dos conmutadores interactúan en una sola dirección. MetadataOnly = True se impone a la selección y se salta todas las hojas, así que un libro configurado con ambos vuelve sin celdas en ningún sitio, y la selección parece rota cuando simplemente fue relevada. Usa uno por Open: solo metadatos para descubrir, una selección para trabajo dirigido
La carga selectiva también pasa por la fase de parseo en paralelo cuando ParallelParse está activado; las hojas no elegidas se saltan dentro de los trabajos de los workers, así que los hilos gastan su tiempo en las hojas que pediste. Las mismas dos propiedades se aplican cuando el origen es un libro binario .xlsb, con una regla de alcance: un .xlsb que lleve un proyecto VBA tiene que abrirse sin estas dos opciones; con cualquiera de las dos puestas, Open informa la lectura selectiva como no soportada
¿Por qué LoadSheet(1) carga la hoja equivocada?
Porque LoadSheet toma una posición base 0 mientras Sheets[] es base 1. LoadSheet(1) materializa la segunda hoja del libro, y como cargar una hoja que ya tiene celdas es un no-op que devuelve True, un índice liado puede parecer éxito mientras la hoja que el usuario pinchó sigue vacía. La conversión pertenece a exactamente un sitio de tu código
La segunda trampa es la vida del archivo. LoadSheet no mantiene el archivo abierto entre llamadas. Reabre el archivo original por nombre, parsea la parte del libro, los estilos y las cadenas compartidas, y después parsea la hoja pedida. Antes de fiarse de ese archivo, HotXLS compara su tamaño y su hora de última escritura con los valores capturados en el Open; si otro proceso guardó encima del libro mientras tanto, LoadSheet devuelve False en lugar de mezclar celdas de otra versión en el modelo que ya sostienes
procedure TReportForm.ShowSheetNo(SheetNo: Integer);  // SheetNo es base 1, como Sheets[]
var
  Sheet: TXLSXWorksheet;
begin
  Sheet := FWorkbook.Sheets[SheetNo];
  if Sheet.Cells.Count = 0 then
    if not FWorkbook.LoadSheet(SheetNo - 1) then      // LoadSheet quiere la posición base 0
    begin
      StatusBar.SimpleText := 'The workbook changed on disk; reopen it';
      Exit;
    end;
  Grid.ShowSheet(Sheet);                              // tu propio código de cuadrícula
end;
De ese diseño se siguen unas cuantas consecuencias. Un libro abierto desde un TStream no tiene archivo fuente al que volver, así que LoadSheet devuelve False para un .xlsx abierto por stream; lo mismo vale para un libro cifrado, que se descifra a memoria antes de parsear. Un .xlsb binario abierto selectivamente desde un stream es la excepción, porque HotXLS deja en escena una copia temporal del stream para las hojas aplazadas. Y una hoja genuinamente vacía se releerá en cada llamada, porque cero celdas es también lo que parece una hoja saltada
El modelo de costes decide cómo usarlo. Cada llamada a LoadSheet vuelve a parsear la tabla de cadenas compartidas, así que materializar diez hojas una a una paga esa parte diez veces. Para un visor donde el usuario abre una pestaña más de vez en cuando, es un precio razonable. Cuando ya conoces el conjunto de hojas, reabre con SelectedSheets: una pasada por el archivo, un parseo de cadenas compartidas. También hay una diferencia de contenido: LoadSheet trae las celdas, valores, fórmulas y formatos de una hoja, mientras que los comentarios, dibujos y tablas llegan con un Open, así que las hojas cuyos comentarios o tablas lee tu código pertenecen a la selección desde el principio
¿Por qué un viaje de ida y vuelta cambia partes que nunca tocaste?
Un guardado que regenera todo reescribe bytes que nunca cambiaron. Descomprime el tema, construye un modelo de objetos, lo serializa, lo vuelve a comprimir, y el resultado difiere del original aunque nadie editara el tema. Para proyectos VBA y cachés de tabla dinámica el coste es mayor que un diff ruidoso: un proyecto VBA es un archivo compuesto binario con sus propios streams internos, y una caché de tabla dinámica guarda una instantánea de los datos de origen cuyos campos las definiciones de la tabla dinámica direccionan por posición, así que lo más seguro con cualquiera de los dos, cuando nadie lo cambió, es dejar sus bytes en paz
PreserveRawParts, que vale True por defecto, hace que SaveAs copie los bytes comprimidos de las partes sin cambios directamente del archivo fuente. Eso cubre el tema, el proyecto VBA, las conexiones, los gráficos, los medios incrustados, los ajustes de impresora, las tablas dinámicas y las definiciones y registros de caché de tabla dinámica, cada uno solo mientras el modelo dice que no fue modificado. Esas partes nunca se inflan ni se vuelven a desinflar en el camino. Poner la propiedad a False fuerza la reserialización completa de cada parte, que es el conmutador a alcanzar cuando quieres que la salida refleje solo lo que contiene el modelo de objetos
La vía de copia cruda usa la misma comprobación de archivo que LoadSheet: el fuente debe seguir existiendo con el tamaño y el timestamp vistos en el Open. Cuando no es así, SaveAs serializa esas partes con normalidad y el archivo sigue completo. Dos casos toman siempre la vía de serializar: un libro cuya fuente fue un .xlsb binario, que se convierte a XML al leer, y un guardado con StrictOOXML activo, donde los namespaces de las partes cambian
Guardar un libro cargado parcialmente exige una decisión. Para una fuente .xlsb, SaveAs se niega mientras quede alguna hoja aplazada y registra «Load every deferred binary worksheet before saving» en Diagnostics. Para un .xlsx, trata un libro cargado selectivamente como una vista de lectura: una hoja stub no tiene celdas que el escritor pueda emitir, así que o llamas a LoadSheet para cada stub primero o reabres sin selección antes de editar y guardar
Un flujo de descubrimiento que reabre a propósito
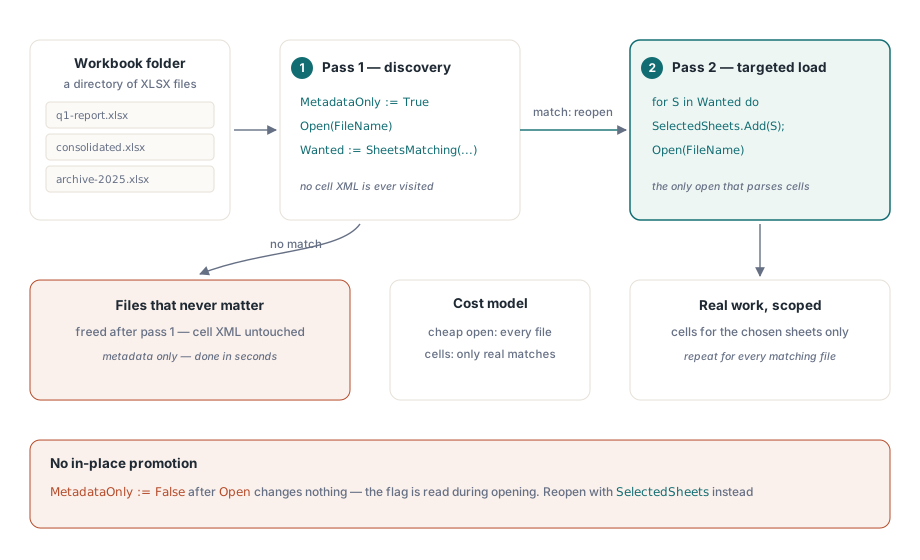
El patrón que aguanta tiene dos pasadas. La pasada uno abre cada archivo solo de metadatos y decide. La pasada dos reabre solo los archivos que encajaron, con una selección de hojas, y hace el trabajo. Reabrir parece derrochador hasta que cuentas lo que la pasada uno evitó: el segundo Open es el único que parsea celdas, y parsea solo las hojas que la pasada uno eligió
procedure ProcessInvoiceFile(const FileName: WideString);
var
  Probe, Workbook: TXLSXWorkbook;
  Wanted: TStringList;
  I: Integer;
begin
  Wanted := TStringList.Create;
  try
    // Pasada 1: descubrimiento, sin celdas
    Probe := TXLSXWorkbook.Create;
    try
      Probe.MetadataOnly := True;
      if Probe.Open(FileName) <> 1 then
        Exit;
      for I := 1 to Probe.Sheets.Count do
        if Pos('Invoice', Probe.Sheets[I].Name) > 0 then
          Wanted.Add(Probe.Sheets[I].Name);
    finally
      Probe.Free;
    end;
    if Wanted.Count = 0 then
      Exit;                               // nada de este archivo merece parseo

    // Pasada 2: celdas solo de las hojas elegidas
    Workbook := TXLSXWorkbook.Create;
    try
      Workbook.SelectedSheets.Assign(Wanted);
      if Workbook.Open(FileName) = 1 then
        PostInvoices(Workbook);           // tu propio código de procesado
    finally
      Workbook.Free;
    end;
  finally
    Wanted.Free;
  end;
end;
Limpiar MetadataOnly después del Open no convierte la sonda en un libro completo. El flag se lee mientras se abre; cambiarlo después solo afecta al siguiente Open de ese objeto. La sonda aún puede crecer una hoja cada vez vía LoadSheet, y para una o dos hojas es razonable, pero a un pipeline le sirve mejor la reapertura limpia, que además trae consigo los comentarios y tablas de cada hoja
Dónde encaja esto con las otras palancas para archivos grandes
La carga selectiva recorta lo que parseas. No hace nada por el coste de una hoja una vez cargada, y no puede ayudar cuando el trabajo necesita cada celda de cada hoja. Ese caso va de almacenamiento, cubierto en el artículo sobre el almacenamiento de celdas por bloques de filas y los estilos por rangos, y de rendimiento de parseo, cubierto en el parseo XLSX en paralelo y el asignador de memoria. Cuando la tarea es una lectura pura sin edición alguna, el lector directo con streaming se salta el modelo de objetos del libro entero y es la mejor herramienta frente a cualquier estrategia de carga que lo construya
Todo esto corre dentro de tu propio ejecutable de Delphi o C++Builder, sin instalación de Excel en el servidor que hace el escaneo. Los formatos soportados, las ediciones y las licencias están listados en la página del componente de hojas de cálculo HotXLS para Delphi