Un pipe que jamás reporta fin de archivo es un bug raro de perseguir en una funcionalidad de OCR. Un hilo de su aplicación lee la salida estándar de un programa ayudante y espera a que ReadFile falle con ERROR_BROKEN_PIPE. Otro hilo arranca tesseract.exe mediante CreateProcess con bInheritHandles puesto a True, porque así es como se le entrega a un proceso hijo un archivo para su error estándar. El extremo de escritura del pipe del ayudante era heredable, así que Tesseract ahora posee una copia, y el hilo lector se cuelga hasta que Tesseract termina su página — que, sobre un escaneo a 300 DPI con dos modelos de lenguaje cargados, no es rápido
Un reconocedor externo trae más que el cuelgue: qué puede ver el hijo, qué hacer con salida medio válida, y cómo convertir cajas de píxeles en texto PDF buscable. El motor OCR de plantillas incorporado cubre a propósito letras y dígitos ASCII impresos por máquina. Los nombres acentuados, los contratos chinos y los archivos multilingües necesitan modelos de lenguaje entrenados, y Tesseract es el candidato habitual porque es un programa de línea de comandos que puede instalarse junto a su ejecutable
Enchufar Tesseract a la capa de texto OCR de HotPDF
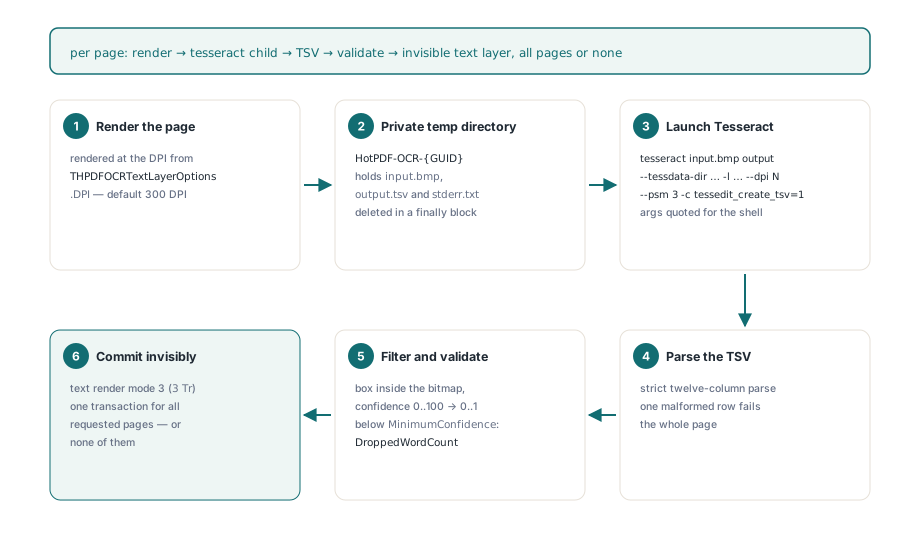
HotPDF envuelve un ejecutable Tesseract instalado localmente como un IHPDFOCREngine a través de HPDFCreateTesseractOCREngine en la unidad HPDFTesseractRecognition. Usted pasa ese motor a THotPDF.ApplyLoadedOCRTextLayer, que renderiza cada página pedida, ejecuta Tesseract una vez por página, filtra las palabras y escribe una capa de texto Unicode invisible para todas las páginas pedidas en una transacción, o para ninguna. El mapeo de coordenadas, la rotación, el filtrado por confianza y el commit son el pipeline que el motor incorporado ya usa; solo cambia el reconocimiento
La factoría lanza EArgumentException antes de tocar página alguna. El ejecutable y el directorio tessdata deben existir, el timeout debe estar entre 1 y 3.600.000 milisegundos, y el idioma solo puede contener letras ASCII, dígitos, _ y +, porque acaba en una línea de comandos: eng+chi_sim es legítimo, un valor con comillas o espacios es una inyección esperando ocurrir. Una segunda sobrecarga toma un registro THPDFTesseractOptions. Su Default da --psm 3, --oem 3, 60 segundos por página y un tope de 16.777.216 píxeles, y rechaza tpsOSDOnly y tpsAutoOnly, los dos modos que no devuelven palabras
uses
  SysUtils, HPDFTypes, HPDFDoc, HPDFTesseractRecognition;

function MakeSearchable(const SourceFile, TargetFile: string;
  Token: THPDFCancellationToken): Boolean;
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default; // psm 3, oem 3, 60 s, 16.777.216 px
  TessOptions.TimeoutMilliseconds := 120000;    // aplica a cada página
  // lanza EArgumentException por un ejecutable o carpeta tessdata ausente,
  // un identificador de idioma malo, u opciones fuera de sus rangos
  Engine := HPDFCreateTesseractOCREngine(
    'C:\OCR\Tesseract\tesseract.exe',
    'C:\OCR\Tesseract\tessdata',
    'eng+chi_sim',                              // modelos unidos con '+'
    TessOptions);
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default; // 300 DPI, MinimumConfidence 0.5
    Options.CancellationToken := Token;
    // una lista de páginas vacía significa todas; las que ya tienen texto se saltan
    Result := Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info);
    if Result then
    begin
      Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
        ' words kept, ', Info.DroppedWordCount, ' below the threshold');
      Doc.SaveLoadedDocument(TargetFile);
    end
    else
      case Info.Status of
        otlsCancelled:      Writeln('Cancelled, document unchanged');
        otlsEngineError:    Writeln('Engine: ', string(Info.Diagnostic));
        otlsBudgetExceeded: Writeln('Budget: ', string(Info.Diagnostic));
      else
        Writeln(string(Info.Diagnostic));
      end;
  finally
    Doc.Free;
  end;
end;
Haga la aritmética de píxeles una vez. Una página A4 a 300 DPI son unos 2.481 por 3.508 píxeles, aproximadamente 8,7 millones, y cabe. Una página A3 a la misma resolución son unos 3.508 por 4.961, cerca de 17,4 millones, así que falla con un diagnóstico de presupuesto de píxeles y la ejecución acaba como otlsEngineError. La sobrecarga que toma solo un timeout no aplica tope de píxeles alguno. Para un servicio que acepta archivos de fuera, conserve la sobrecarga de opciones y suba MaxPixels (hasta 67.108.864) o baje THPDFOCRTextLayerOptions.DPI deliberadamente cuando se esperen formatos grandes
Por página, el motor crea un directorio privado HotPDF-OCR-{GUID} bajo la ruta temp, guarda el bitmap como input.bmp y ejecuta tesseract input.bmp output --tessdata-dir … -l … --dpi N --psm 3 -c tessedit_create_tsv=1, añadiendo --oem cuando hay un modo de motor fijado. Las rutas se entrecomillan con las reglas de Windows para barras invertidas y comillas incrustadas, y --dpi lleva la resolución de render para que Tesseract jamás la adivine. Tesseract y sus archivos .traineddata no vienen incluidos; provisionarlos es trabajo de la aplicación. En nuestras propias máquinas de prueba Linux el reconocedor corre desde un bundle a nivel de usuario del binario, su cierre de librerías compartidas y la carpeta tessdata, porque fiarse de /usr/bin/tesseract solo funciona donde alguien instaló el paquete del sistema
¿Por qué una fila TSV rota vacía la página entera?
El adaptador Tesseract hace fallar la página entera ante la primera fila malformada, porque una lista de palabras parcialmente parseada produce una capa de texto que discrepa de la imagen, y nada en el PDF guardado dice qué palabras se perdieron. La salida debe decodificarse como UTF-8 estricto sin NUL incrustado. La primera línea debe igualar la cabecera de doce columnas de Tesseract, de level a text, una vez retirada una marca de orden de bytes opcional. Cada fila debe partirse en exactamente doce campos, y el split se para tras la undécima tabulación, así que una tabulación dentro del texto reconocido aterriza en el campo de texto en lugar de crear una décimo tercera columna, donde el check de caracteres de control de abajo la rechazaría
Solo las filas de nivel 5 son palabras; las filas de página, bloque, párrafo y línea se saltan, igual que las palabras vacías o de puros espacios en blanco. Una palabra que contenga un carácter de control (por debajo de U+0020, o de U+007F a U+009F) hace fallar la página. El resto necesita geometría entera, una confianza parseada con formato invariante para que una aplicación con locale alemán siga leyendo 93.5, una caja totalmente dentro del bitmap, y una confianza de 0 a 100. Una palabra válida seguida de una fila rota da cero palabras
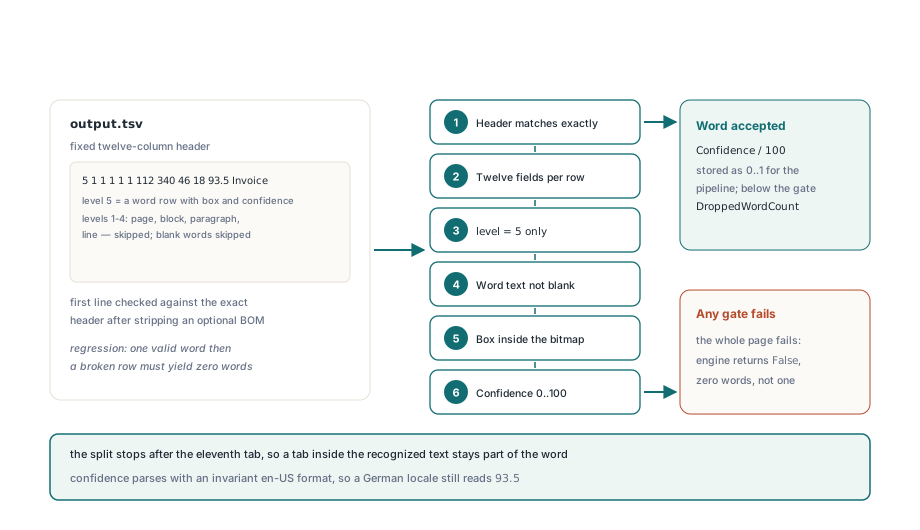
Una fila extraña hace por tanto fallar la ejecución entera y deja todas las páginas intactas. Ese es el intercambio correcto. Una reejecución es barata; un PDF buscable donde una búsqueda de número de factura falla en la única página que importa suele salir a la luz meses después, en manos de otra persona
El último paso también se encuentra con un valor por defecto que quizá no espera. Tesseract reporta confianza de 0 a 100, el pipeline divide por 100, y THPDFOCRTextLayerOptions.MinimumConfidence vale 0.5 por defecto, así que cualquier palabra por debajo de 50 aterriza en Info.DroppedWordCount en lugar de en la página. Sobre un escaneo limpio ese suelo es sensato. Sobre un fax ruidoso puede retirarse una gran parte del texto, así que compare Info.ReceivedWordCount con Info.AcceptedWordCount antes de bajarlo
Volver a correr OCR sobre un archivo que ya tiene texto
SkipPagesWithText es True por defecto, y eso caza a la gente a la segunda. Suponga que un lote se procesó con eng y ahora necesita eng+deu: cada página ya lleva texto invisible, así que Info.SkippedPageCount iguala el recuento de páginas. HotPDF marca el content stream que escribe como su propia capa OCR, y ReplaceExistingOCRTextLayer usa esa marca para reconocer esas páginas otra vez, tirando la capa vieja y conservando el contenido original de la página
Options := THPDFOCRTextLayerOptions.Default;
Options.ReplaceExistingOCRTextLayer := True;  // sustituye nuestra capa anterior
Options.UseOptionalContentGroup := True;      // capa llamada 'OCR Text Layer'
Options.CancellationToken := Token;
if Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
  Writeln(Info.ReplacedPageCount, ' replaced, ',
    Info.SkippedPageCount, ' skipped, ',
    Info.RecognizedPageCount, ' recognized')
else
  Writeln(string(Info.Diagnostic));
Un archivo OCRizado por un driver de escáner no lleva semejante marca, así que sus páginas siguen contando como páginas con texto. Apagar SkipPagesWithText apilaría una segunda capa invisible sobre la primera, y cada hit de búsqueda aparecería dos veces. Deje esos archivos en paz
¿Qué handles hereda el proceso de Tesseract?
El proceso hijo de Tesseract hereda exactamente dos handles de HotPDF: uno abierto sobre NUL para la entrada y salida estándar, y uno para stderr.txt en el directorio privado. El cuelgue del pipe de arriba viene del propio CreateProcess: bInheritHandles = True se exige para pasar los handles estándar, y por su solo pasa cada handle heredable del anfitrión, incluidos pipes, archivos y eventos abiertos por código no relacionado. HotPDF usa STARTUPINFOEX con una lista de atributos que lleva PROC_THREAD_ATTRIBUTE_HANDLE_LIST y el flag EXTENDED_STARTUPINFO_PRESENT. bInheritHandles sigue siendo True, pero solo los handles listados cruzan
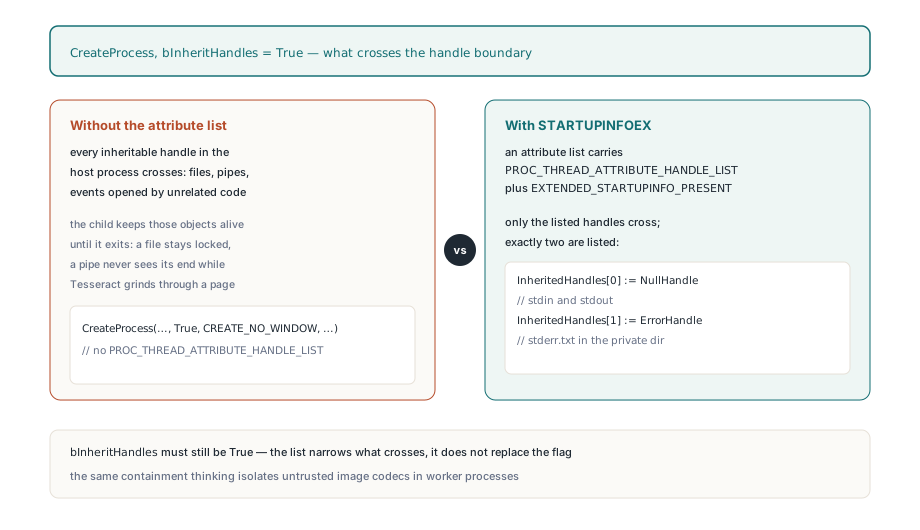
El mismo patrón pertenece a cualquier otro proceso hijo que su aplicación arranque, porque un solo lanzador que hereda todo basta para colgar a cada lector de pipe del proceso:
// Patrón para sus propias llamadas CreateProcess (fragmento: NullHandle, ErrorHandle,
// Exe, CommandLine, WorkDir y ProcessInfo están declarados en otra parte).
// Las RTL Delphi antiguas no declaran las funciones de lista de atributos; añada sus
// propias declaraciones external de kernel32 si el compilador no las encuentra
// Compruebe cada resultado BOOL en código de producción
type
  TStartupInfoExRec = record
    StartupInfo: TStartupInfo;
    AttributeList: Pointer;
  end;
const
  HANDLE_LIST_ATTRIBUTE = $00020002;   // PROC_THREAD_ATTRIBUTE_HANDLE_LIST
  EXTENDED_STARTUP_FLAG = $00080000;   // EXTENDED_STARTUPINFO_PRESENT
var
  Startup: TStartupInfoExRec;
  HandleList: array[0..1] of THandle;
  Size: NativeUInt;
begin
  FillChar(Startup, SizeOf(Startup), 0);
  HandleList[0] := NullHandle;         // creado con bInheritHandle = True
  HandleList[1] := ErrorHandle;        // igualmente
  Size := 0;
  InitializeProcThreadAttributeList(nil, 1, 0, Size);
  GetMem(Startup.AttributeList, Size);
  InitializeProcThreadAttributeList(Startup.AttributeList, 1, 0, Size);
  UpdateProcThreadAttribute(Startup.AttributeList, 0, HANDLE_LIST_ATTRIBUTE,
    @HandleList[0], SizeOf(HandleList), nil, nil);
  Startup.StartupInfo.cb := SizeOf(Startup);
  // ... fije dwFlags y hStdInput / hStdOutput / hStdError como siempre ...
  CreateProcess(PChar(Exe), PChar(CommandLine), nil, nil,
    True,                              // sigue siendo exigido con una lista de handles
    CREATE_NO_WINDOW or EXTENDED_STARTUP_FLAG,
    nil, PChar(WorkDir), Startup.StartupInfo, ProcessInfo);
  // después de que el hijo sale: DeleteProcThreadAttributeList, FreeMem, CloseHandle
end;
Los scripts puente añaden un detalle más de Windows. Un lanzador de Python puede arrancar un segundo proceso intérprete, y terminar el proceso que usted creó deja ese corriendo. Cuando al motor se le da una ruta de script, como el adaptador RapidOCR de abajo, HotPDF arranca el hijo suspendido, lo asigna a un job object con JOB_OBJECT_LIMIT_KILL_ON_JOB_CLOSE y luego lo reanuda, así que cerrar el job acaba con el árbol entero. La misma idea de contención impulsa aislar codecs de imágenes PDF en procesos worker, donde el hijo no es de confianza; aquí el hijo es de confianza, pero su proceso no es el único código que sostiene handles dentro
Cancelación, timeouts y el commit todo-o-nada
IHPDFOCREngine.Recognize devuelve un único Boolean, y False cubre tanto «Tesseract falló» como «el usuario pulsó Cancelar». El adaptador sondea el token y su timeout cada 25 milisegundos mientras Tesseract corre, y ante una cancelación limpia y devuelve False. Tomado a la letra eso se leería como otlsEngineError, así que ApplyLoadedOCRTextLayer comprueba primero el token cada vez que Recognize devuelve False. El reconocimiento y la construcción de contenido terminan para cada página pedida antes de que la transacción del documento abra, así que una cancelación en la página 40 de 50 reporta otlsCancelled y deja las 50 páginas tal como estaban cargadas. Los demás límites siguen el mismo estilo:
- El timeout corre desde el inicio de cada llamada a
Recognize, así que el valor por defecto de 60.000 ms es un límite por página - Un hijo que sigue corriendo en un timeout o una cancelación se termina y se le espera hasta 5 segundos; el directorio privado se elimina en un bloque
finally, con el borrado reintentado hasta un segundo porque los archivos de salida pueden quedarse bloqueados brevemente tras terminar el proceso output.tsvtiene un tope de 64 MiB ystderr.txtde 1 MiB, comprobados mientras el hijo corre y después de que sale- Las palabras y las unidades de código UTF-16 por página tienen tope según lo que quede de
MaxWordsPerPage,MaxTotalWordsyMaxTextCodeUnits; pasarse hace fallar la ejecución en lugar de truncar la lista - Un código de salida distinto de cero vuelve con hasta 4.096 caracteres de
stderr.txt, la manera más rápida de enterarse de que falta un archivo.traineddata
Cómo se ve la capa de texto invisible dentro de la página
HotPDF escribe las palabras con el modo de renderizado de texto 3 (ni relleno ni trazo, ISO 32000-1 §9.3.6), así que el escaneo sigue visible mientras la búsqueda y la copia trabajan sobre las palabras. El content stream abre BT con 3 Tr; cada palabra recibe una matriz Tm en su baseline, un tamaño de fuente de altura de caja en píxeles por 72 entre el DPI de render, y una escala Tz que estira la tirada hasta la anchura de la caja. Ese estiramiento mantiene un resaltado de búsqueda sobre la palabra en la imagen
El TSV tiene cajas pero no baselines, así que cada baseline se coloca a un quinto de la altura de la caja por encima del borde inferior. Entre palabras vecinas en una línea de izquierda a derecha en escrituras separadas por espacios como el latín o el cirílico, un espacio estirado llena el hueco, así que el texto copiado conserva sus saltos de palabra; el chino no recibe ninguno. Los glifos van por una fuente Type0 compartida sin incrustar con encoding Identity-H y un CMap ToUnicode generado, un CID por escalar Unicode distinto, que es cómo el chino, el latín acentuado y los caracteres del plano suplementario sobreviven a copiar y buscar. Una tirada sostiene hasta 65.535 escalares distintos, y como ISO 19005 exige fuentes incrustadas, la salida PDF/A necesita una fuente conforme incrustada aparte. Para comprobar un resultado, guarde, recargue y corra la ruta ordinaria de extraer texto de un PDF cargado en Delphi; si las palabras esperadas vuelven en las páginas esperadas, la capa es real
RapidOCR y la DLL nativa sobre el mismo contrato
Para escaneos en chino simplificado, HPDFCreateRapidOCREngine(PythonExecutable, BridgeScript, ModelDirectory, TimeoutMilliseconds) reutiliza el mismo runner de procesos y parser TSV. La ruta del script puente sigue al ejecutable de Python y el idioma queda fijo en chi_sim. HotPDF distribuye el puente como tools/OCR/rapidocr_tsv.py; necesita los paquetes rapidocr y onnxruntime, modelos ONNX locales y un archivo de fuente, rechaza las descargas automáticas, y escribe TSV con forma de Tesseract; una sobrecarga THPDFRapidOCROptions fija archivos de modelos, recuentos de hilos y un tope de píxeles. La factoría genérica detrás de ambos adaptadores, HPDFCreateLocalTSVOCREngine en HPDFLocalTSVRecognition, acepta cualquier programa que tome los argumentos estilo Tesseract y escriba el TSV de doce columnas, y hereda la lista de handles, el timeout, la cancelación y los presupuestos
HPDFCreateTesseractDLLOCREngine(LibraryPath, TessDataDirectory, Language) carga en su lugar la API C de Tesseract en proceso, reporta Tesseract (native DLL), comprueba de entrada que cada archivo .traineddata pedido existe, y mapea la cancelación y el timeout sobre el monitor de progreso del propio Tesseract. Se ahorra un arranque de proceso y un viaje de ida y vuelta de BMP por página; el ejecutable mantiene los crashes y el crecimiento de memoria del reconocedor fuera de su espacio de direcciones. Para una herramienta de escritorio que trabaja sobre los escaneos del propio usuario la DLL está bien. Para un servicio que ingiere documentos de desconocidos, el motor de línea de comandos es la elección más segura. En cualquier caso el reconocimiento corre en Windows, una página cada vez, sobre el bitmap renderizado, así que enderece y limpie los escaneos difíciles antes de que lleguen al motor
Los adaptadores OCR, el escritor de capas de texto, el renderer que los alimenta y la extracción que comprueba la salida viven todos en un componente VCL nativo para Delphi y C++Builder. Si su aplicación de captura o archivado necesita salida PDF buscable, el componente Delphi PDF de HotPDF cubre todo excepto el motor OCR que usted instala por su cuenta