Una factura rusa procesada por un reconocedor que carga el modelo cirílico pero sigue leyendo el diccionario de caracteres chinos regresa como filas de caracteres Han perfectamente válidos. Cada línea es UTF-8 bien formado, cada línea aterriza en la capa de texto buscable, y una búsqueda de cualquier palabra impresa en la página no encuentra nada. El modelo hizo su trabajo. Un reconocedor CTC jamás emite caracteres, solo números de clase, y el archivo de diccionario es lo único que mapea la clase 1.204 a un glifo
Tres fallos relacionados viven cerca, y una demo en escritura latina no muestra ninguno: líneas que pierden su último carácter, texto inglés que llega sin espaciado de palabras y cajas de texto árabes que vuelven en orden de izquierda a derecha. Cada uno se remonta a una regla de diccionario, una frontera de bucle o un orden de clasificación fáciles de dejar casi bien. Los cuatro empiezan en el mismo punto: el paso que convierte una etiqueta de idioma en un modelo y un diccionario
Presets de idioma RapidOCR en HotPDF: una etiqueta, un par fijado
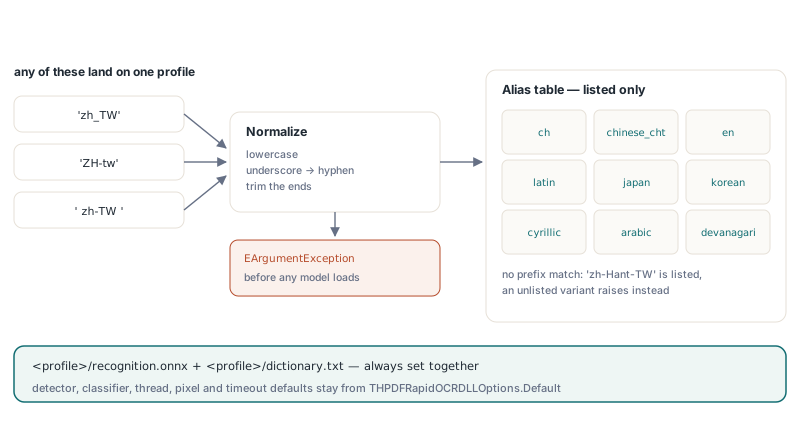
En HotPDF, THPDFRapidOCRDLLOptions.ForLanguage convierte una etiqueta de idioma en opciones que apuntan a <profile>/recognition.onnx y <profile>/dictionary.txt bajo su directorio de modelos. Todo lo demás viene de THPDFRapidOCRDLLOptions.Default: el detector compartido, el clasificador de ángulo opcional, un hilo, un presupuesto de 16.777.216 píxeles por petición y un timeout de 60 segundos. La etiqueta se pasa a minúsculas, los guiones bajos se vuelven guiones y los espacios de los extremos se recortan, así que 'zh_TW', 'ZH-tw' y ' zh-tw ' resuelven al mismo perfil
El matching corre contra una lista explícita de alias, sin match por prefijo. 'zh-Hant-TW' y 'zh-MO' se aceptan porque están listados; 'pt-AO' no, y ForLanguage lanza EArgumentException antes de abrir archivo alguno. Esa estrictez es deliberada. Una regla de prefijo enviaría silenciosamente 'zh-Hant-SG' o cualquier etiqueta futura al perfil que comparta sus dos primeras letras, y con el chino las dos primeras letras no le dicen la escritura
| Perfil | Idiomas | Etiquetas de ejemplo | Orden de cajas en una fila |
|---|---|---|---|
ch | Chino simplificado e inglés | zh, zh-CN, zh-Hans, chi_sim | De izquierda a derecha |
chinese_cht | Chino tradicional | zh-TW, zh-HK, zh-Hant, chi_tra | De izquierda a derecha |
en | Inglés | en, en-US, en-GB, eng | De izquierda a derecha |
latin | Francés, alemán, español, portugués, italiano, neerlandés, turco | fr, de, es-419, pt-BR, tr | De izquierda a derecha |
japan | Japonés | ja, ja-JP, jpn | De izquierda a derecha |
korean | Coreano | ko, ko-KR, kor | De izquierda a derecha |
cyrillic | Ruso, ucraniano, búlgaro, bielorruso | ru, ru-RU, uk, bg | De izquierda a derecha |
arabic | Árabe, persa, urdu | ar, ar-SA, fa, ur | De derecha a izquierda |
devanagari | Hindi, maratí, nepalí | hi, mr, ne | De izquierda a derecha |
El adaptador jamás descarga nada. Los archivos de modelos se provisionan una vez con el ayudante incluido, por ejemplo tools/Install-RapidOCRModels.ps1 -Destination C:/OCR/models -Language ch,chinese_cht,cyrillic, o -Language All para los nueve perfiles. El ayudante coloca el detector y el clasificador compartidos en los nombres de archivo de raíz que Default espera, y cada perfil en su propia carpeta. La creación del motor, la frontera de la DLL y el threading están cubiertos en el artículo sobre la DLL RapidOCR en proceso; con los archivos en su sitio, un escaneo en chino simplificado se vuelve buscable así
uses
  SysUtils, HPDFDoc, HPDFRapidOCRRecognition;

procedure MakeChineseScanSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Models: THPDFRapidOCRDLLOptions;
  Layer: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // ch/recognition.onnx + ch/dictionary.txt, detector y clasificador compartidos
  Models := THPDFRapidOCRDLLOptions.ForLanguage('zh-CN');
  // los modelos se cargan aquí; reutilice el motor entre documentos
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Layer := THPDFOCRTextLayerOptions.Default;  // 300 DPI, MinimumConfidence 0.5
    // una lista de páginas vacía significa todas; las que ya tienen texto se saltan
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Layer, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' lines, ', Info.UniqueScalarCount, ' distinct characters');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
Dos números de esa salida hay que leerlos con cuidado. El pipeline nativo informa un resultado por línea de texto detectada, así que AcceptedWordCount cuenta líneas aquí, y MinimumConfidence se compara contra la confianza media de caracteres de la línea entera: una línea que promedia 0.45 se descarta como unidad. UniqueScalarCount es el número de escalares Unicode distintos que la capa de texto tuvo que mapear a su fuente y a su tabla ToUnicode. Una página de texto chino de cuerpo debería empujar esa cifra muy por encima de las pocas docenas de escalares que necesita una página latina; un recuento en territorio latino sobre un escaneo chino suele significar que hay cargado el perfil equivocado
¿Por qué cambiar solo el modelo de reconocimiento produce basura?
Porque el modelo y el diccionario son dos mitades de una misma tabla de búsqueda, y solo el diccionario sabe qué significan los índices. Apunte RecognitionModel a cyrillic/recognition.onnx mientras CharacterDictionary sigue nombrando el archivo chino, y el modelo emitirá encantado índices cirílicos válidos que el diccionario viejo traduce a caracteres Han al azar. ForLanguage fija siempre ambos campos juntos. Las opciones construidas a mano deben seguir la misma regla: jamás cambie uno sin el otro
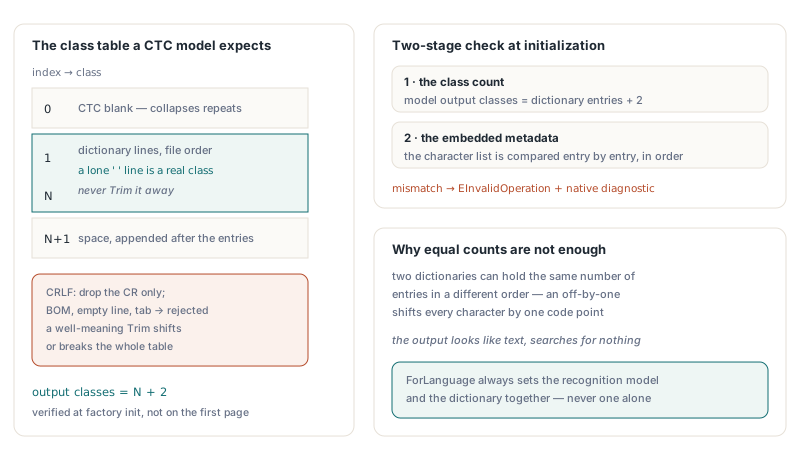
El check de seguridad obvio, comparar el tamaño del diccionario con el ancho de salida del modelo, es necesario pero no suficiente. Dos diccionarios pueden tener el mismo número de entradas en orden distinto, y un off-by-one desplaza cada carácter una posición. La DLL RapidOCR de HotPDF comprueba por eso dos veces mientras la factoría inicializa el reconocedor. El recuento de clases de salida del modelo debe igualar las entradas del diccionario más dos. Después, si el archivo ONNX incrusta una lista de metadatos character, cada línea del diccionario se coteja con ella en orden. Cualquiera de los dos desajustes hace que HPDFCreateRapidOCRDLLOCREngine lance EInvalidOperation con el diagnóstico nativo, de modo que el error sale en el arranque y no en el archivo de un cliente
El "más dos" viene de la disposición de clases. La clase 0 es el blank CTC, las clases 1 a N son las líneas del diccionario en orden de archivo, y la clase final es un espacio. Algunos diccionarios llevan además su propia entrada de un solo espacio, y esa línea debe conservarse exactamente como está. Aquí es donde un Trim bienintencionado hace daño de verdad: convierte la entrada de espacio en una cadena vacía y desplaza o rompe la tabla. La DLL retira un retorno de carro final para que los archivos CRLF carguen, y rechaza una marca de orden de bytes UTF-8, una línea vacía, o una entrada que contenga un tabulador o un retorno de carro suelto
Si usted mantiene sus propios diccionarios, un check previo en su script de build o despliegue caza estos problemas antes de que lo haga el motor. La función de abajo es código suyo, escrito para reflejar las reglas de arriba
// Su propio ayudante, no una API de HotPDF: construye la tabla de clases que un
// reconocedor CTC espera y rechaza los defectos de diccionario que la DLL rechaza
uses
  SysUtils, IOUtils;

function BuildCTCClassTable(const FileName: string): TArray<string>;
var
  Text, Entry: string;
  Lines: TArray<string>;
  I, Last: Integer;
begin
  Text := TEncoding.UTF8.GetString(TFile.ReadAllBytes(FileName));
  if (Text <> '') and (Text[1] = #$FEFF) then
    raise EArgumentException.Create('Dictionary must be UTF-8 without a BOM');
  Lines := Text.Split([#10]);
  Last := High(Lines);
  if (Last >= 0) and (Lines[Last] = '') then
    Dec(Last);                                   // salto de línea al final del archivo
  if Last < 0 then
    raise EArgumentException.Create('Dictionary is empty');
  SetLength(Result, Last + 3);
  Result[0] := '';                               // clase 0: blank CTC
  for I := 0 to Last do
  begin
    Entry := Lines[I];
    if (Entry <> '') and (Entry[Length(Entry)] = #13) then
      SetLength(Entry, Length(Entry) - 1);       // CRLF: retire solo el CR
    if (Entry = '') or (Pos(#9, Entry) > 0) or (Pos(#13, Entry) > 0) then
      raise EArgumentException.CreateFmt('Invalid dictionary line %d', [I + 1]);
    Result[I + 1] := Entry;                      // nunca Trim: ' ' es una clase
  end;
  Result[Last + 2] := ' ';                       // clase final: espacio
  // Length(Result) debe igualar el recuento de clases de salida del modelo
end;
Decodificación CTC greedy y sus tres trampas de frontera
La decodificación CTC greedy escoge la clase de mayor puntuación en cada time step, colapsa las repeticiones consecutivas en un carácter y descarta el blank; el blank es lo que permite que una letra genuinamente doblada sobreviva. Un modelo de reconocimiento lee una línea de texto como una secuencia de rebanadas verticales estrechas, y para cada rebanada emite una probabilidad por cada clase. Una línea con AA中 podría producir la secuencia argmax A A blank A 中 space: los dos primeros pasos A colapsan en uno, el blank lo separa de la siguiente A, y el resultado es AA中 con el espacio final intacto. Sin la regla del blank, book y bok decodificarían idéntico
Un decodificador que se queda corto invita a errores off-by-one, y cada error produce su propio síntoma reconocible. Detenga el bucle argmax interno una clase antes y la clase espacio jamás puede ganar, así que cada línea inglesa o latina vuelve como una sola palabra larga y la búsqueda de frases deja de funcionar. Detenga el bucle externo un time step antes y el último carácter de cada línea desaparece, lo que en una etiqueta de dos caracteres es la mitad del texto. Olvide dejar que un blank reinicie la guardia de repetición y los caracteres doblados colapsan: el ll de hello, o la reduplicación 谢谢. Si usted escribe un decodificador para un pipeline a medida, estos tres casos forman un conjunto de pruebas compacto. El decodificador de HotPDF cubre la última clase y el último paso, conserva las repeticiones separadas por blank, y rechaza puntuaciones que no sean finitas o caigan fuera de 0 a 1, además de cualquier recuento de clases que no case con el diccionario
// Ilustración para su propio pipeline, no una API de HotPDF: CTC greedy
// con fronteras correctas. Scores guarda Steps * Classes
// probabilidades, una fila por time step
function GreedyCTCDecode(const Scores: array of Single;
  Steps, Classes: Integer; const Characters: array of string): string;
var
  Step, C, Best, Previous: Integer;
  BestScore: Single;
begin
  if (Classes < 3) or (Length(Characters) <> Classes) or
    (Length(Scores) <> Steps * Classes) then
    raise EArgumentException.Create('Model output does not match the dictionary');
  Result := '';
  Previous := 0;                            // la clase 0 es el blank CTC
  for Step := 0 to Steps - 1 do             // incluya el último time step
  begin
    Best := 0;
    BestScore := Scores[Step * Classes];
    for C := 1 to Classes - 1 do            // incluya la última clase (espacio)
      if Scores[Step * Classes + C] > BestScore then
      begin
        Best := C;
        BestScore := Scores[Step * Classes + C];
      end;
    if (Best <> 0) and (Best <> Previous) then
      Result := Result + Characters[Best];
    Previous := Best;                       // un blank reinicia la guardia de repetición
  end;
end;
El beam search con un modelo de lenguaje puede resolver alguna rebanada ambigua que la decodificación greedy falla, a un coste real de velocidad y de un segundo conjunto de archivos que versionar. Para documentos impresos renderizados a 300 DPI, la decodificación greedy es el valor por defecto correcto, y el decodificador es el sitio equivocado para compensar lo que el modelo no puede ver. Lo mismo aplica a las tablas de sustitución de caracteres. Si un modelo lee una letra acentuada como su letra base, parchear la salida con una tabla de reemplazo arregla un idioma y rompe otro. Un carácter equivocado en una capa buscable es peor que uno ausente, porque la búsqueda encuentra el documento equivocado en lugar de ninguno, así que el texto reconocido va al PDF exactamente como el modelo lo produjo
¿Cómo se ordenan las líneas de texto para el árabe de derecha a izquierda?
La DLL ordena las cajas de texto detectadas de arriba abajo, agrupa cajas en una fila cuando se solapan verticalmente al menos la mitad de la altura de la caja menor, y ordena cada fila de izquierda a derecha, o de derecha a izquierda cuando RightToLeft está activo. Los caracteres dentro de una línea reconocida jamás se invierten. El agrupamiento por filas importa porque un detector parte a menudo una línea visual en varias cajas, por ejemplo una etiqueta y un valor separados por un hueco ancho, y una ordenación pura por coordenada superior los entrelazaría con la línea siguiente cada vez que sus bordes superiores difieran un píxel o dos
El perfil árabe es el único donde ForLanguage fija RightToLeft := True, lo que hace que la DLL ordene cada fila por los bordes derechos de las cajas, empezando por el margen derecho. Ese es el efecto entero. El texto que el modelo devuelve para una línea ya está en orden lógico Unicode, el orden en que un lector árabe lo lee y lo teclea, y ese es también el orden que la extracción de texto PDF y la búsqueda esperan. Invertir la cadena para que "parezca bien" en el depurador de Delphi rompería la búsqueda, el copiar y pegar y los lectores de pantalla. La visualización bidireccional y el shaping de glifos son trabajo del visor PDF
Un motor sirve un perfil de idioma, y no hay detección automática de escritura. Un documento que mezcle escrituras necesita un motor por perfil, cada uno aplicado a sus propias páginas. ApplyLoadedOCRTextLayer toma una lista de páginas explícita y compromete cada llamada como su propia transacción, así que un fallo en las páginas árabes revierte esa llamada sin tocar la capa china ya escrita
uses
  SysUtils, HPDFDoc, HPDFRapidOCRRecognition;

function CreateRapidEngine(const Tag: string): IHPDFOCREngine;
var
  Models: THPDFRapidOCRDLLOptions;
begin
  // lanza EArgumentException para una etiqueta desconocida, antes de cargar modelo alguno
  Models := THPDFRapidOCRDLLOptions.ForLanguage(Tag);
  Models.MaxPixels := 33554432;          // espacio para páginas A3 a 300 DPI
  Result := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
end;

procedure OCRMixedArchive(Doc: THotPDF);
var
  Chinese, Arabic: IHPDFOCREngine;
  Layer: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  Chinese := CreateRapidEngine('zh-TW');  // perfil chinese_cht
  Arabic := CreateRapidEngine('ar-SA');   // perfil arabic, RightToLeft = True
  Layer := THPDFOCRTextLayerOptions.Default;
  if not Doc.ApplyLoadedOCRTextLayer([0, 1, 2], Chinese, Layer, Info) then
    raise Exception.Create(string(Info.Diagnostic));
  if not Doc.ApplyLoadedOCRTextLayer([3], Arabic, Layer, Info) then
    raise Exception.Create(string(Info.Diagnostic));
end;
La línea de MaxPixels está ahí por algo. El presupuesto por defecto de 16.777.216 píxeles por petición cubre A4 y US Letter a 300 DPI de sobra. Una hoja A3 a 300 DPI sale a unos 3508 por 4961 píxeles, aproximadamente 17,4 millones, así que esa petición se rechaza y Info.Diagnostic informa de una petición o presupuesto de píxeles inválido. Suba MaxPixels hasta el techo de 67.108.864, o baje THPDFOCRTextLayerOptions.DPI para formatos grandes. La ordenación de derecha a izquierda pasa por el export de la DLL HPDFRapidOCRSetReadingDirection, que el adaptador solo busca cuando RightToLeft está fijado; una build de la DLL sin ese export sigue sirviendo los perfiles de izquierda a derecha, y crear un motor árabe con ella lanza una EArgumentException que nombra el export ausente
Packs de modelos fijados y lo que un par a medida debe pasar
La DLL RapidOCR de HotPDF enlaza un ONNX Runtime construido estáticamente, así que lee las versiones del formato de archivo ONNX que ese runtime entiende y nada más nuevo. Las exportaciones de modelos recientes pueden apuntar a un formato más nuevo; semejante archivo se rechaza en la creación del motor con un diagnóstico nativo. Ese emparejamiento es la razón por la que cada pack de idioma apunta a un reconocedor y un diccionario concretos que cargan y pasan los checks de clases bajo el runtime incluido, y por la que los packs jamás son "el último"
Install-RapidOCRModels.ps1 hace cumplir el emparejamiento en disco. Cada archivo de su manifiesto lleva un hash SHA256. Un archivo existente con un hash distinto detiene la instalación y se deja en su sitio para que usted lo mueva o lo elimine, y cada descarga se escribe bajo un nombre temporal y solo se mueve a su posición cuando su hash casa. Eso bloquea la versión silenciosa del problema del diccionario: alguien copia a mano un recognition.onnx más nuevo en una carpeta de perfil, el recuento de clases casualmente casa, y la primera señal de problemas es un cliente diciendo que la búsqueda no encuentra palabras que se ven a simple vista. Si usted instala con -SkipClassifier, fije UseAngleClassifier := False en las opciones, porque Default espera el archivo del clasificador y la creación del motor comprueba que exista
El reconocedor también comprueba la forma de entrada del modelo al cargar. Acepta entrada float NCHW con altura fija de 32 o 48 píxeles, o altura dinámica, que ejecuta a 48. Un modelo exportado con cualquier otra altura fija falla la creación del motor con "Unsupported recognition model input or output shape"
Para una escritura que ninguno de los nueve perfiles cubre, RecognitionModel y CharacterDictionary pueden apuntar a sus propios archivos, y todos los checks de arriba siguen aplicando. Un par mal emparejado falla en la creación del motor, en su ejecución de pruebas. Para páginas donde ningún perfil RapidOCR encaje, el adaptador Tesseract para PDF buscable se enchufa a la misma llamada ApplyLoadedOCRTextLayer, y para formularios ASCII impresos por máquina el motor OCR de plantillas incorporado no necesita archivos de modelos para nada
Los presets de idioma, el adaptador RapidOCR nativo y la capa de texto OCR vienen todos incluidos en el HotPDF Delphi PDF Component para proyectos Delphi, C++Builder y FPC/Lazarus para Windows