Las capas de texto OCR, las cotas de códigos de barras y los recuadros de censura de caras se desfasan en páginas PDF recortadas cuando los píxeles del bitmap se mapean de vuelta a través del MediaBox en lugar de la caja que el renderer rasterizó de verdad: el CropBox recortado al MediaBox (ISO 32000-1 §14.11.2). HotPDF mapea los resultados de ApplyLoadedOCRTextLayer, DecodeLoadedPageBarcodes y DetectLoadedRedactionFindings a través de esa caja visible, y cualquier motor o detector a medida que escriba tiene que hacer lo mismo
El síntoma es fácil de reconocer una vez visto. Un archivo de contratos escaneados pasa por un pipeline de OCR, la salida es buscable, y el resultado de búsqueda de un número de cláusula se resalta media pulgada más abajo y a la izquierda del número impreso. La mayoría de los archivos del lote van bien. Los que se desfasan vienen todos de una estación de escaneo que escribe un /CropBox para recortar el margen de la bandeja. Ese único detalle separa la imagen que vio el motor OCR del marco donde se colocó la capa de texto, y el mismo desajuste mueve las cotas de códigos de barras y, más grave aún, los recuadros de censura de caras
¿Por qué la capa de texto OCR se aleja de las palabras escaneadas?
La capa de texto se desfía cuando dos mitades del pipeline discrepan sobre qué rectángulo cubre el bitmap. El renderizado de HotPDF, la exportación SVG, el visor y la impresión honran todos el CropBox: una página se muestra a través de su CropBox recortado a su MediaBox, que es lo que prescribe ISO 32000-1 §14.11.2, y GetLoadedPageVisibleBox devuelve esa caja visible. Una transformada dispositivo-a-página construida desde GetLoadedPageBox(PageIndex, pbMediaBox, ...) asume en cambio que el raster cubre el MediaBox, así que el raster y la transformada describen rectángulos distintos y cada posición reconocida vuelve desplazada por la brecha entre ambos
Hacer esto bien significa mantener tres cosas en concordancia para cada función de reconocimiento: la transformada, la estimación del presupuesto de píxeles y la caja de página entregada a un motor a medida en el registro de petición. HotPDF deriva las tres de la caja visible, lo que también significa que el reconocimiento solo ve contenido que los visores muestran de verdad
Algunos casos son inmunes al desajuste:
- Las páginas sin
/CropBox, o cuyo CropBox iguala al MediaBox, mapean igual por cualquiera de las dos cajas DecodeLoadedPageBarcodesconHasRegionactivo renderiza exactamente la región que usted pasa y mapea por esa misma región; la comprobación de que la región cae dentro de la página usa el MediaBox- Los hallazgos de censura por patrones (correos, números de tarjeta y demás) salen de la extracción de texto en user space, no de un raster, así que solo los hallazgos de detección de caras dependen del mapeo del raster
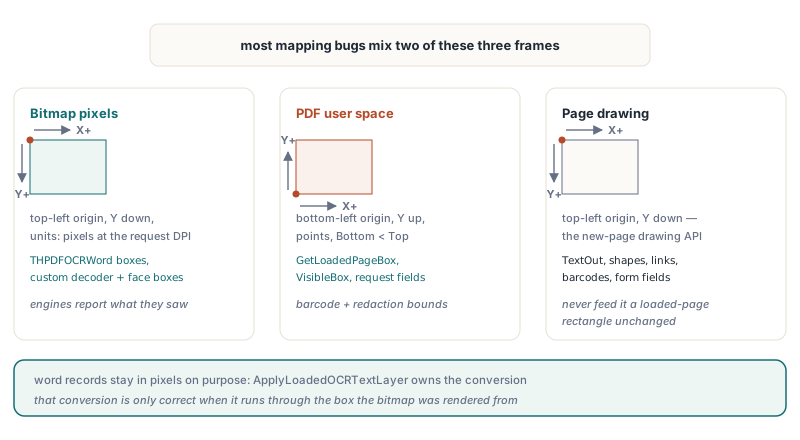
Tres marcos de coordenadas, y qué APIs de HotPDF usan cada uno
El código que toca el reconocimiento de HotPDF lidiará con tres marcos, y la mayoría de los errores de mapeo salen de mezclar dos de ellos
- Píxeles de bitmap: origen arriba a la izquierda, Y crece hacia abajo, las unidades son píxeles al DPI de la petición.
THPDFOCRWord.Left,Top,RightyBottomviven en este marco, igual que los puntos de baseline opcionales, los resultados que devuelve unIHPDFBarcodeDecodera medida y las cajas de unIHPDFFaceDetectora medida - User space PDF de una página cargada: origen abajo a la izquierda, Y crece hacia arriba, unidades en puntos, con
Bottom < Top.GetLoadedPageBoxyGetLoadedPageVisibleBoxdevuelven Left, Bottom, Right, Top en este marco, y también los camposPageLeft,PageBottom,PageRightyPageTopdeTHPDFOCRRequest, las cotas deTHPDFDecodedBarcodey los rectángulos deTHPDFRedactionFinding - Coordenadas de dibujo de página de HotPDF: la API que usted usa para construir páginas nuevas (salida de texto, formas, códigos de barras, enlaces, campos de formulario) trabaja con origen arriba a la izquierda e Y creciendo hacia abajo. Ese marco pertenece a la generación de documentos y no tiene nada que ver con las APIs de documentos cargados de arriba, así que jamás alimente con un rectángulo de user space de página cargada sin convertir
El registro de palabra OCR es deliberadamente basado en píxeles: un motor reporta lo que vio en la imagen, y ApplyLoadedOCRTextLayer es dueño de la conversión. Esa división solo funciona cuando la conversión usa la caja correcta, y por eso HotPDF la construye desde la caja visible
La transformada dispositivo-a-página detrás de OCR, códigos de barras y caras
HotPDF mapea los píxeles del bitmap a la página con una única matriz afín construida de cinco entradas: la rotación, la escala DPI / 72, la altura del bitmap, y el Left, Bottom, Right y Top de la caja renderizada. OCR, decodificación de códigos de barras y detección de caras comparten una sola rutina para ello, así que la caja de entrada decide la precisión de los tres a la vez. Para una página sin rotar, la matriz página-a-dispositivo [A B C D E F] es:
A = ScaleyD = -Scale, dondeScale = DPI / 72; laDnegativa voltea el user space (Y arriba) a espacio de bitmap (Y abajo)B = C = 0, porque una página sin rotar no tiene shear ni intercambio entre ejesE = -Left * Scale, que lleva el borde izquierdo de la caja a la columna de píxel 0F = BitmapHeight + Bottom * Scale, que mapea el borde inferior de la caja a y = BitmapHeight, el borde bajo del bitmap, así que el borde superior aterriza en la fila 0
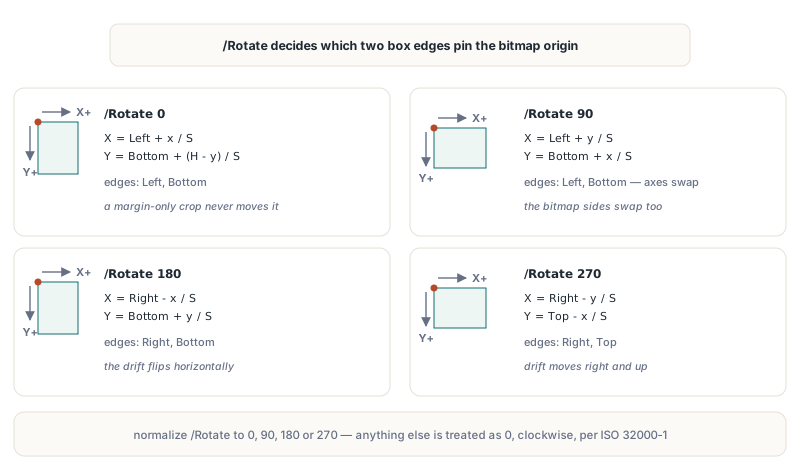
Los píxeles vuelven a la página por la inversa de esa matriz. Request.PageRotation lleva el /Rotate de la página normalizado a 0, 90, 180 o 270 (cualquier valor que no sea múltiplo de 90 se trata como 0), y el renderer gira la página en sentido horario como exige ISO 32000-1 §7.7.3.3. Bajo rotación los ejes se intercambian y un par distinto de bordes de caja queda anclado al origen del bitmap. Escrito como fórmulas inversas, con S = DPI / 72, x e y en píxeles y H la altura del bitmap:
| /Rotate | Página X | Página Y | Bordes de caja de los que depende el mapeo |
|---|---|---|---|
| 0 | Left + x / S | Bottom + (H - y) / S | Left, Bottom |
| 90 | Left + y / S | Bottom + x / S | Left, Bottom |
| 180 | Right - x / S | Bottom + y / S | Right, Bottom |
| 270 | Right - y / S | Top - x / S | Right, Top |
La última columna explica por qué un mapeo basado en el MediaBox parece aleatorio en producción. Un CropBox que recorta solo la parte superior de la página deja Left y Bottom intactos, así que las páginas rectas salen perfectas y solo se desfían las que llevan /Rotate 270. La rotación además intercambia las dimensiones del bitmap: a 90 y 270 el bitmap mide (Top - Bottom) * S píxeles de ancho y (Right - Left) * S píxeles de alto
¿Qué falla con MediaBox [0 0 612 792] y CropBox [36 36 576 756]?
Con un recorte de media pulgada por cada lado, la capa de texto de una página sin rotar aterriza exactamente 36 puntos a la izquierda y 36 puntos por debajo de las palabras escaneadas cuando se usa el MediaBox. Tome una página US Letter cuyo CropBox recorta 36 puntos (0.5 pulgada) por cada borde. La caja visible es de 540 por 720 puntos, así que a la resolución OCR por defecto de 300 DPI la escala es 300 / 72 ≈ 4.1667 y el bitmap es de 2250 por 3000 píxeles
Suponga que el motor reporta una palabra con caja de píxeles Left 450, Top 600, Right 900, Bottom 660 y sin baseline. HotPDF coloca entonces la baseline un 20 por ciento de la altura de palabra por encima del borde inferior, en la fila de píxel 648, y mapea el punto inicial (450, 648):
- Por la caja visible: x = 36 + 450 / 4.1667 = 144.0 e y = 36 + (3000 - 648) / 4.1667 = 600.48, que es donde está impresa la palabra
- Por el MediaBox: x = 0 + 108.0 = 108.0 e y = 0 + 564.48 = 564.48, un desplazamiento uniforme de (-36, -36) puntos
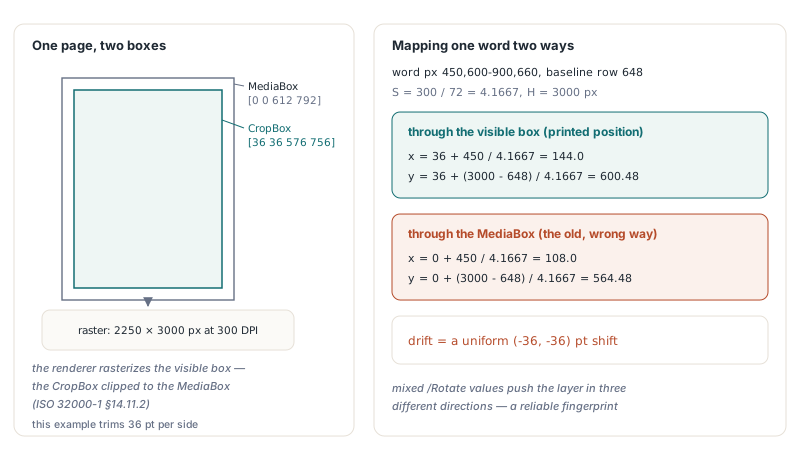
Rothe la misma página y la dirección del error cambia, porque hay bordes distintos en juego. A /Rotate 180 el término X usa Right, y 612 en lugar de 576 empuja la capa 36 puntos a la derecha mientras Bottom sigue tirándola 36 puntos abajo. A /Rotate 270 Right y Top son ambos demasiado grandes, así que la capa se mueve 36 puntos a la derecha y 36 arriba. Un documento con orientaciones mezcladas puede mostrar el desfase en tres direcciones, una huella fiable de este error. El código escrito a mano que derive la escala desde la caja, como Bitmap.Width / (Right - Left), estira además cada coordenada por 612 / 540, alrededor de un 13 por ciento, por encima del desplazamiento
¿Qué páginas PDF necesitan un mapeo consciente del CropBox?
Un documento PDF necesita atención cuando al menos una página tiene una caja visible que difiere de su MediaBox, y HotPDF puede decírselo en unas líneas. Compare GetLoadedPageBox con pbMediaBox contra GetLoadedPageVisibleBox para cada página, e imprima GetLoadedPageRotation al lado para poder predecir la dirección del desfase desde la tabla de arriba. THPDFPageBoundary ofrece además pbCropBox, pbBleedBox, pbTrimBox y pbArtBox, pero GetLoadedPageBox(pbCropBox) recae en el MediaBox cuando no existe crop box y no recorta, así que la caja visible es lo correcto contra lo que comparar
uses
  System.SysUtils, HPDFDoc;

procedure ReportCroppedPages(const FileName: string);
var
  Pdf: THotPDF;
  I: Integer;
  ML, MB, MR, MT, VL, VB, VR, VT, Tmp: Single;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile(FileName) < 1 then
      raise Exception.Create('Cannot load ' + FileName);
    for I := 0 to Pdf.LoadedPageCount - 1 do
    begin
      if not Pdf.GetLoadedPageBox(I, pbMediaBox, ML, MB, MR, MT) then
        Continue;
      // el array guardado puede listar sus esquinas en cualquier orden
      if MR < ML then begin Tmp := ML; ML := MR; MR := Tmp; end;
      if MT < MB then begin Tmp := MB; MB := MT; MT := Tmp; end;
      // ya viene normalizada y recortada al MediaBox
      if not Pdf.GetLoadedPageVisibleBox(I, VL, VB, VR, VT) then
        Continue;
      if (Abs(VL - ML) > 0.01) or (Abs(VB - MB) > 0.01) or
         (Abs(VR - MR) > 0.01) or (Abs(VT - MT) > 0.01) then
        Writeln(Format('Page %d  MediaBox [%g %g %g %g]  visible [%g %g %g %g]  /Rotate %d',
          [I + 1, ML, MB, MR, MT, VL, VB, VR, VT,
           Pdf.GetLoadedPageRotation(I)]));
    end;
  finally
    Pdf.Free;
  end;
end;
Dos detalles de GetLoadedPageVisibleBox importan para scripts como este. La función deja sus parámetros de salida intactos cuando falla, así que preasignar un tamaño de página por defecto antes de la llamada es un patrón seguro. Y cuando un CropBox malformado no interseca en absoluto al MediaBox, la función devuelve el MediaBox en lugar de un rectángulo vacío. Si el informe lista páginas que un pipeline anterior procesó con OCR mediante un mapeo basado en el MediaBox, recuerde que la capa de texto comprometida permanece en el archivo guardado: la opción SkipPagesWithText por defecto saltará esas páginas en una segunda pasada salvo que la apague o retire primero la capa vieja
¿Cómo debería mapear píxeles a espacio PDF un IHPDFOCREngine a medida?
Un IHPDFOCREngine a medida debería devolver cajas de palabra en píxeles de bitmap y dejar que HotPDF haga el mapeo; convierta a user space solo para sus propias decisiones, y entonces use la caja de la petición, jamás el MediaBox. Los PageLeft, PageBottom, PageRight y PageTop de la petición describen la caja visible renderizada, así que casan exactamente con Request.Bitmap. El ayudante de abajo es la inversa de la transformada de la biblioteca, incluido su uso de la altura real del bitmap para páginas rectas, así que concuerda con HotPDF al píxel
uses
  System.SysUtils, System.Math, Vcl.Graphics, HPDFDoc;

// Píxel de bitmap (origen arriba a la izquierda, Y hacia abajo) a user space
// PDF (origen abajo a la izquierda, Y arriba), por la caja desde la que se renderizó
procedure HotPixelToPage(Rotation, DPI, BitmapHeight: Integer;
  Left, Bottom, Right, Top: Single; X, Y: Double;
  out PageX, PageY: Double);
var
  S: Double;
begin
  S := DPI / 72.0;
  case Rotation of
    90:  begin PageX := Left + Y / S;  PageY := Bottom + X / S; end;
    180: begin PageX := Right - X / S; PageY := Bottom + Y / S; end;
    270: begin PageX := Right - Y / S; PageY := Top - X / S; end;
  else
    PageX := Left + X / S;
    PageY := Bottom + (BitmapHeight - Y) / S;
  end;
end;
Una razón realista para necesitar user space dentro de un motor es una regla de zonas: facturas cuyo membrete usted no quiere buscable jamás, o un área de sello que confunde al reconocedor. El motor de abajo, escrito con TInterfacedObject para que el recuento de referencias maneje su vida, filtra palabras por dónde caen sus centros sobre la página, y luego devuelve a los supervivientes intactos en coordenadas de píxel. RunRecognizer hace de llamada a su reconocedor
type
  TZoneFilterOCREngine = class(TInterfacedObject, IHPDFOCREngine)
  private
    FSkipLeft, FSkipBottom, FSkipRight, FSkipTop: Single;  // user space
    function RunRecognizer(Bitmap: TBitmap; MaxWords: Integer;
      out Words: THPDFOCRWords): boolean;  // su reconocedor, cajas de píxel
  public
    constructor Create(SkipLeft, SkipBottom, SkipRight, SkipTop: Single);
    function GetName: AnsiString;
    function Recognize(const Request: THPDFOCRRequest;
      out Words: THPDFOCRWords; out Diagnostic: AnsiString): boolean;
  end;

function TZoneFilterOCREngine.Recognize(const Request: THPDFOCRRequest;
  out Words: THPDFOCRWords; out Diagnostic: AnsiString): boolean;
var
  Raw: THPDFOCRWords;
  I, Count: Integer;
  CX, CY: Double;
begin
  Diagnostic := '';
  SetLength(Words, 0);
  if not RunRecognizer(Request.Bitmap, Request.MaxWords, Raw) then
  begin
    Diagnostic := 'recognizer failed';
    Exit(False);
  end;
  SetLength(Words, Length(Raw));
  Count := 0;
  for I := 0 to High(Raw) do
  begin
    HotPixelToPage(Request.PageRotation, Request.DPI,
      Request.Bitmap.Height, Request.PageLeft, Request.PageBottom,
      Request.PageRight, Request.PageTop,
      (Raw[I].Left + Raw[I].Right) / 2, (Raw[I].Top + Raw[I].Bottom) / 2,
      CX, CY);
    if (CX >= FSkipLeft) and (CX <= FSkipRight) and
       (CY >= FSkipBottom) and (CY <= FSkipTop) then
      Continue;
    Words[Count] := Raw[I];  // siguen siendo píxeles: HotPDF los mapea él mismo
    Inc(Count);
  end;
  SetLength(Words, Count);
  Result := True;
end;
Entregue el motor a ApplyLoadedOCRTextLayer(PageIndices, Engine, Options, Info) como con cualquier otro motor. La biblioteca valida lo que vuelve antes de fiarse de ello: una palabra se descarta y se cuenta en Info.DroppedWordCount cuando su caja sale del bitmap, cuando Right <= Left o Bottom <= Top, o cuando Confidence está fuera de 0..1 o por debajo de MinimumConfidence. Devolver más palabras que MaxWordsPerPage, o empujar el total acumulado más allá de MaxTotalWords, hace fallar la llamada entera con un error de presupuesto, así que honre Request.MaxWords en el motor. No convierta las cajas de palabra a user space antes de devolverlas; HotPDF trataría los valores de punto como píxeles y la capa colapsaría hacia el origen del bitmap
Mapear la salida de su propio detector
El mismo ayudante sirve para un pipeline casero construido sobre RenderLoadedPageToBitmap, que renderiza la caja visible y aplica /Rotate igual que lo hacen las funciones de reconocimiento. Lea la caja con GetLoadedPageVisibleBox, normalice la rotación igual que hace HotPDF, y mapee dos esquinas opuestas de cada caja de píxeles. El eje Y se voltea y, a 90 y 270 grados, los ejes se intercambian, así que las esquinas mapeadas salen sin orden fijo; quédese con el mínimo y el máximo de los puntos mapeados, que es también cómo construye HotPDF las cotas de códigos de barras
const
  DPI = 200;
var
  Pdf: THotPDF;
  Bmp: TBitmap;
  VL, VB, VR, VT: Single;
  Rotation: Integer;
  PxL, PxT, PxR, PxB, X1, Y1, X2, Y2: Double;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('scanned-ids.pdf');
    if not Pdf.GetLoadedPageVisibleBox(0, VL, VB, VR, VT) then Exit;
    Rotation := Pdf.GetLoadedPageRotation(0) mod 360;
    if Rotation < 0 then Inc(Rotation, 360);
    if (Rotation <> 90) and (Rotation <> 180) and (Rotation <> 270) then
      Rotation := 0;
    Bmp := Pdf.RenderLoadedPageToBitmap(0, DPI);
    if Bmp = nil then Exit;
    try
      MyDetector(Bmp, PxL, PxT, PxR, PxB);  // su código, caja de píxel
      HotPixelToPage(Rotation, DPI, Bmp.Height, VL, VB, VR, VT,
        PxL, PxT, X1, Y1);
      HotPixelToPage(Rotation, DPI, Bmp.Height, VL, VB, VR, VT,
        PxR, PxB, X2, Y2);
      Writeln(Format('User-space box [%.2f %.2f %.2f %.2f]',
        [Min(X1, X2), Min(Y1, Y2), Max(X1, X2), Max(Y1, Y2)]));
    finally
      Bmp.Free;
    end;
  finally
    Pdf.Free;
  end;
end;
El comportamiento de rotación está cubierto con más profundidad en aplanar la rotación de página sin romper las cajas de página, y el pipeline de decodificación de códigos de barras que consume la misma transformada en decodificar códigos QR rotados desde páginas PDF. Si su motor envuelve un reconocedor externo, el adaptador OCR Tesseract para PDF buscable muestra el lado de aislamiento de proceso y cancelación de la misma interfaz
Referencia rápida: mapeo de coordenadas a salvo del CropBox
- El renderer rasteriza la caja visible, el CropBox recortado al MediaBox (ISO 32000-1 §14.11.2); todo mapeo de píxel a página debe usar esa caja, leída con
GetLoadedPageVisibleBox ApplyLoadedOCRTextLayer,DecodeLoadedPageBarcodesde página entera y los hallazgos de caras deDetectLoadedRedactionFindingsmapean todos por la caja visible, y cualquier motor o detector a medida debe hacer lo mismo- Las cajas de
THPDFOCRWordson píxeles de bitmap con origen arriba a la izquierda;GetLoadedPageBoxyGetLoadedPageVisibleBoxdevuelven user space PDF con origen abajo a la izquierda yBottom < Top - La escala es
DPI / 72; derívela del DPI, nunca de una caja de página dividida entre el ancho del bitmap - /Rotate decide qué bordes importan: Left y Bottom a 0 y 90, Right y Bottom a 180, Right y Top a 270
- Devuelva palabras OCR en píxeles y deje que HotPDF las mapee; convierta solo para su propia lógica de filtrado
- Cuando vuelva a correr OCR sobre páginas que ya llevan una capa de texto, recuerde que
SkipPagesWithTextlas salta salvo que la apague o retire primero la capa vieja
Las funciones de reconocimiento, las consultas de page box y el renderizado de documentos cargados usados aquí vienen todos en el componente HotPDF para Delphi y C++Builder; licencias, descargas de prueba y la lista completa de características están en la página del componente Delphi PDF de HotPDF