PDF Library for Delphi escribe rangos de etiquetas de página con AddPageLabels, y desde la v3.539.10 esa llamada también funciona en archivos cargados cuyo árbol numérico /PageLabels está partido en nodos /Kids: la raíz se aplana en una única hoja /Nums antes de que entre el rango nuevo, de modo que la etiqueta aparece de verdad en el visor en vez de ignorarse en silencio. La víctima típica es un PDF estilo libro salido de una herramienta de maquetación, con números romanos en el preliminar, numeración arábiga en el cuerpo y un apéndice etiquetado A-1, A-2, donde usted solo quería rerrotular el apéndice y no cambió nada
¿Qué son las etiquetas de página PDF y cómo se almacenan?
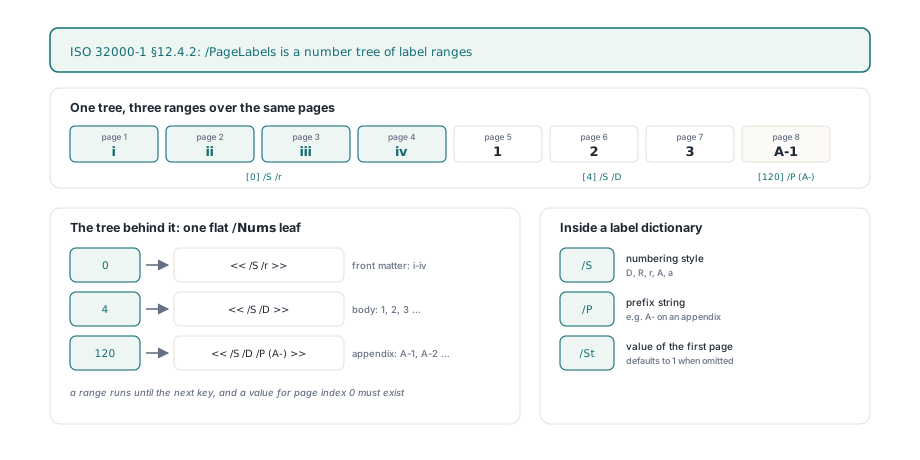
Las etiquetas de página son las cadenas que un visor muestra en su caja de página en lugar del índice físico de página, e ISO 32000-1 §12.4.2 las guarda como un árbol numérico bajo la clave de catálogo /PageLabels. Cada clave es un índice de página 0-based que arranca un rango de etiquetado, y cada valor es un diccionario de etiqueta de página con hasta tres entradas: /S para el estilo de numeración (D, R, r, A o a), /P para una cadena de prefijo, y /St para el valor numérico de la primera página del rango, que por defecto es 1. Un rango corre hasta la siguiente clave, y la especificación exige que el árbol contenga un valor para el índice de página 0, así que cada página queda cubierta por algún rango
var
  Lib: TPDFlib;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('handbook.pdf', '') <> 1 then
      Exit;
    // Páginas 1-4: i, ii, iii, iv (romanos en minúscula)
    Lib.AddPageLabels(1, 3, 1, '');
    // Páginas 5-120: 1, 2, 3 ... (decimal)
    Lib.AddPageLabels(5, 1, 1, '');
    // Páginas 121 en adelante: A-1, A-2 ... (decimal con prefijo)
    Lib.AddPageLabels(121, 1, 1, 'A-');
    WriteLn(Lib.GetPageLabel(5));    // 1
    WriteLn(Lib.GetPageLabel(122));  // A-2
    Lib.SaveToFile('handbook-labeled.pdf');
  finally
    Lib.Free;
  end;
end;
TPDFlib.AddPageLabels(Start, Style, Offset, Prefix) mapea sus argumentos sobre ese diccionario sin sorpresas una vez que conoce tres reglas. Start es 1-based como cualquier otro argumento de página de la librería y se escribe en el árbol como Start - 1. Style va de 0 a 5, donde 0 significa solo prefijo y 1 a 5 se convierten en valores /S D, R, r, A y a; cualquier cosa fuera de ese rango devuelve 0 y no toca nada. Offset se convierte en /St solo cuando es mayor que cero, así que pasar 0 simplemente omite la clave y el visor cae al valor por defecto de 1. Como las etiquetas de página llegaron con PDF 1.3, la llamada también ejecuta EnsureMinVersion('1.3', '/PageLabels'), que sube la versión de salida de un archivo más viejo salvo que haya bloqueado explícitamente la versión de guardado
¿Por qué desaparecen las etiquetas de página nuevas cuando el árbol tiene /Kids?
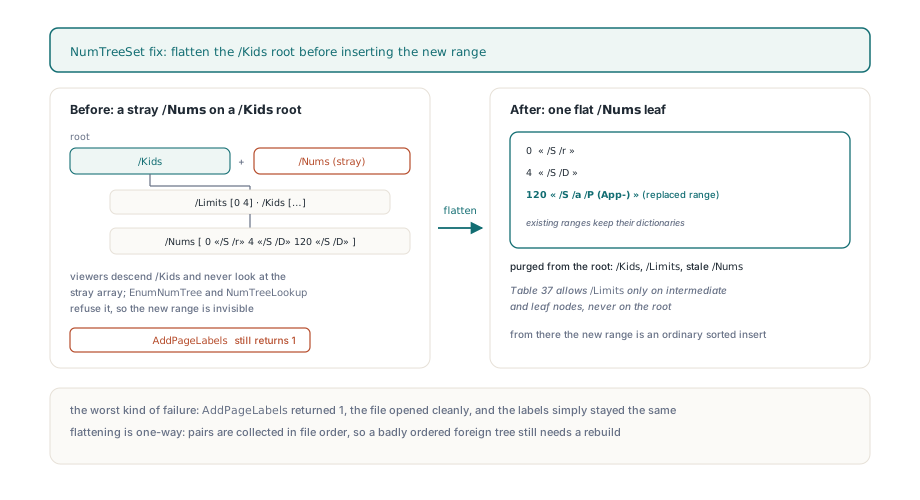
Las etiquetas nuevas desaparecen porque ISO 32000-1 §7.9.7 (Tabla 37) obliga a que la raíz de un árbol numérico lleve o /Kids o /Nums, nunca ambas, y el viejo helper NumTreeSet solo sabía buscar /Nums. Los producers que emiten documentos largos suelen partir el árbol en nodos intermedios, cada uno con su par /Limits, y colgarlos de una raíz que solo tiene /Kids. El código viejo no encontraba /Nums en esa raíz, creaba uno nuevo al lado del /Kids existente, e insertaba ahí el rango nuevo. El resultado era una raíz con dos puntos de entrada mutuamente excluyentes. Los visores descienden por /Kids y nunca miran el array suelto, el propio EnumNumTree de la librería también comprueba /Kids primero, y NumTreeLookup rechaza un nodo donde HasKids xor HasNums es false. AddPageLabels seguía devolviendo 1 y el archivo guardado seguía abriendo limpio, que es el peor tipo de fallo: nada se queja, las etiquetas simplemente se quedan igual
El fix en NumTreeSet convierte la raíz en hoja antes de insertar nada. Cuando la raíz lleva /Kids, EnumNumTree recorre cada hoja en orden y recolecta cada par clave y valor, se construye un array /Nums plano nuevo a partir de esa lista, y /Kids, /Limits y cualquier /Nums obsoleto se purgan de la raíz antes de colgar el array plano. Tirar /Limits no es un detalle cosmético, porque la Tabla 37 permite esa entrada solo en nodos intermedios y hojas, nunca en la raíz. A partir de ahí la inserción es un insert ordenado ordinario en un solo array, y los rangos existentes sobreviven con sus diccionarios de etiqueta originales. El trade-off es deliberado: el árbol no se reconstruye después en nodos /Kids balanceados. Para etiquetas de página eso no cuesta nada, porque hasta un manual de referencia grande rara vez pasa de unas docenas de rangos, y una sola hoja es lo que la mayoría de producers escribe de todos modos
// Rerrotular el apéndice en un archivo cuya raíz /PageLabels usa /Kids
if Lib.LoadFromFile('vendor-manual.pdf', '') = 1 then
begin
  WriteLn('Before: ', Lib.GetPageLabel(121));  // e.g. A-1
  // Sustituir el rango que empieza en la página 121: App-a, App-b ...
  if Lib.AddPageLabels(121, 5, 1, 'App-') = 1 then
    Lib.SaveToFile('vendor-manual-relabeled.pdf');
  // Los rangos romano y decimal existentes siguen en la hoja aplanada
  WriteLn('After: ', Lib.GetPageLabel(121));   // App-a
  WriteLn('Front: ', Lib.GetPageLabel(2));     // ii, sin cambios
end;
¿Cómo puede leerse un array /Nums por error como claves?
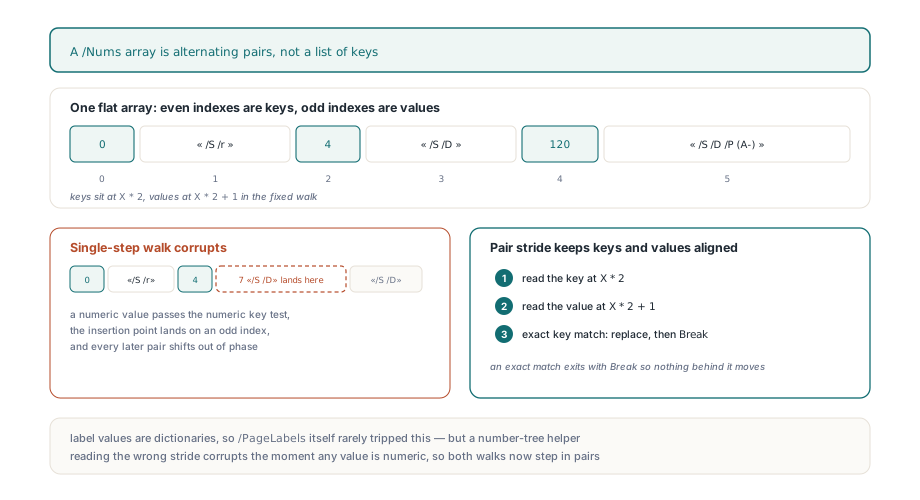
Un array /Nums se mallee cuando el código lo recorre de uno en uno, porque el array es una tira plana de pares alternantes, [key0 value0 key1 value1 ...], y solo las posiciones pares son claves. El viejo bucle de NumTreeSet probaba el tipo numérico de cada elemento, así que un valor que resultaba ser número se comparaba como si fuera clave; un hit de menor-que podía fijar el punto de inserción en un índice impar y soltar el par nuevo en medio de uno existente, desfasando todos los pares posteriores. EnumNumTree tenía el mismo paseo de uno en uno. Ambos ahora iteran pares con paso dos, leyendo la clave en X * 2 y el valor en X * 2 + 1, y una coincidencia exacta de clave sustituye el valor y sale con Break. Siendo justos, los valores de etiqueta de página son diccionarios, así que este segundo bug rara vez se disparaba en /PageLabels en sí, pero un helper de árbol numérico que lee el paso equivocado está corrupto en el momento en que cualquier valor es numérico, y se arregló en la misma pasada
Leer las etiquetas de vuelta y hacerlas ida y vuelta
TPDFlib.GetPageLabel(Page) devuelve la etiqueta de una página 1-based y tiene dos fallbacks que conviene conocer. Sin ninguna entrada /PageLabels devuelve el número de página decimal, así que quien llama puede usarla incondicionalmente. Con árbol presente pero ningún rango que cubra la página devuelve una cadena vacía, que es justo lo que pasa cuando un archivo se salta la entrada obligatoria del índice 0; la documentación de referencia dice que debe existir un rango que empiece en la página 1 para que las etiquetas se muestren correctamente, y el código hace visible ese requisito. Los estilos de letra siguen la especificación y no las columnas de hoja de cálculo: después de Z viene AA, luego BB, repitiendo la letra en lugar de acarrear
var
  P: Integer;
  Data: WideString;
begin
  // Auditoría rápida de lo que un visor mostrará en su caja de página
  for P := 1 to Lib.PageCount do
    WriteLn(P, ' -> ', Lib.GetPageLabel(P));

  // El valor de opción 4 exporta solo rangos de etiquetas como registros PageLabelBegin
  Data := Lib.ExportDocumentData(4);
  // La importación los reejecuta vía ClearPageLabels + AddPageLabels
  Lib.ImportDocumentData(Data, 0);
end;
Para ediciones en bloque, ExportDocumentData con valor de opción 4 escribe cada rango como un bloque PageLabelBegin con líneas PageLabelNewIndex, PageLabelStart, PageLabelPrefix y PageLabelNumStyle, y ImportDocumentData trata el primer registro de etiqueta que ve como un reemplazo completo: llama a ClearPageLabels una vez y después pasa cada registro a AddPageLabels. Eso hace que un round trip de texto sea determinista incluso cuando el archivo original usaba un árbol /Kids, porque la limpieza elimina la entrada completa del catálogo y el árbol reconstruido es una sola hoja desde el principio
¿Qué sigue sin garantizar el fix?
El aplanado es de un solo sentido y confía en el orden que encuentra. EnumNumTree recolecta pares en orden de archivo, y GetPageLabel aplica el último rango cuya clave es menor o igual que el índice de página, así que un archivo ajeno cuyas hojas están desordenadas, cosa que §7.9.7 prohíbe pero que circula, puede seguir dando etiquetas equivocadas hasta que reconstruya los rangos con ClearPageLabels y llamadas frescas a AddPageLabels. Las etiquetas también van ligadas a índices de página, no a objetos de página, así que cualquier operación que cambie el número o el orden de páginas deja los rangos donde estaban. Un intercambio in situ como reemplazar páginas conservando los números de objeto mantiene el conteo y por tanto las etiquetas alineadas, mientras que una fusión como intercalar escaneos dúplex entrelazados produce una secuencia de páginas nueva que merece un conjunto de rangos recién escrito
Las llamadas de etiquetas de página, el manejo del árbol numérico y el export e import de datos de documento descritos aquí llegan todos en PDF Library for Delphi para Delphi, C++Builder y Lazarus, con la entrada de referencia de AddPageLabels documentando los valores de estilo y los códigos de retorno