PDFlibPas, la PDF Library de losLab para Delphi, recorre los name trees y number trees de PDF con una pila explícita y un conjunto de visitados desde v3.539.45, de modo que un /Kids cíclico, hijos compartidos y árboles de miles de niveles ya no agotan la pila de llamadas ni duplican entradas. Desde v3.539.51 un par /Limits ausente, malformado o invertido jamás esconde una rama que contiene la clave. Named destinations, page labels, adjuntos y JavaScript a nivel de documento leen todos a través de estos dos caminos de código, lo que los convierte en parte de la superficie de ataque de cualquier PDF que usted no haya producido
El detonante rara vez es exótico. Un fuzzer, una subida hostil o un incremental save con bugs escribe una entrada /Kids que apunta de vuelta a un ancestro, y un caminante recursivo muere con un stack overflow en un archivo de dos kilobytes. El fallo más silencioso es una búsqueda que se fía de un array /Limits roto y reporta "no encontrado" para un destino que está claramente ahí
¿Dónde aparecen los name trees y los number trees en un PDF?
Los name trees y number trees aparecen dondequiera que un PDF mapea un gran conjunto de claves a objetos, y PDFlibPas lee al menos cuatro de ellos por APIs públicas. ISO 32000-1 §7.9.6 define el name tree (claves de tipo string, tabla 36) y §7.9.7 el number tree (claves enteras, tabla 37). Ambos son árboles más o menos equilibrados cuyos nodos raíz e intermedios llevan /Kids, cuyas hojas llevan los pares clave/valor ordenados en /Names o /Nums, y cuyos nodos no raíz llevan un array /Limits de dos elementos con la clave menor y la mayor por debajo
| Árbol | Dónde vive | Especificación | API de lectura de PDFlibPas |
|---|---|---|---|
| Named destinations | /Dests en el diccionario de nombres | §12.3.2.3 | GetNamedDestination, luego GetDestPage / GetDestType |
| Page labels | /PageLabels en el catálogo (number tree) | §12.4.2 | GetPageLabel |
| Adjuntos | /EmbeddedFiles en el diccionario de nombres | §7.7.4, §7.11.4 | EmbeddedFileCount, GetEmbeddedFileStrProperty |
| JavaScript a nivel de documento | /JavaScript en el diccionario de nombres | §7.7.4 | GlobalJavaScriptCount, GlobalJavaScriptPackageName |
Dos detalles de esa tabla se pasan por alto con facilidad. Las named destinations tienen además una forma antigua de PDF 1.1, un diccionario /Dests plano en el catálogo indexado por objetos de nombre, y GetNamedDestination comprueba ese diccionario primero antes de descender por el name tree de PDF 1.2. Y GetDocJavaScript no es un lector de name trees en absoluto: devuelve los scripts colgados de los triggers de documento en el diccionario /AA del catálogo (WS, DS, WP, DP, DC), mientras que los paquetes de scripts con nombre que corren al abrir un documento viven en el name tree /JavaScript
Cada byte de esas estructuras viene del archivo. La especificación dice lo que un escritor debe producir; no puede impedir que un lector reciba otra cosa, que es la misma lección de endurecer un parser PDF Pascal frente a archivos maliciosos, aplicada aquí a la forma del árbol en lugar de a los tamaños de buffer
¿Por qué un array /Kids cíclico tumba un caminante de árbol recursivo?
Un array /Kids cíclico tumba un caminante recursivo porque nada en la recursión se apercibe de que ya ha visto un nodo, así que un hijo que referencia a su propio ancestro convierte un archivo finito en un descenso infinito. Antes de v3.539.45, NameTreeLookup, NumTreeLookup, EnumNumTree y el TPDFNameTree.ProcessNode interno se llamaban a sí mismos una vez por hijo. Una única autorreferencia bastaba para acabar con el proceso, y un árbol legítimo pero muy profundo podía lograr lo mismo sin ningún ciclo
Una variante más leve corrompe resultados en lugar de colgarse. Cuando dos entradas /Kids referencian la misma hoja, una enumeración ingenua la visita dos veces, y un recuento de adjuntos o una lista de paquetes de scripts reporta entradas que no existen
El arreglo sustituye la recursión por una pila explícita de último en entrar, primero en salir sobre el heap y un conjunto de visitados indexado por identidad de diccionario. Un nodo se marca cuando se saca, no cuando se mete, así que una referencia cíclica puede pasar un momento en la pila pero se descarta en cuanto vuelve a subir. Cada nodo distinto expande a sus hijos exactamente una vez, lo que acota el trabajo total por el número de diccionarios distintos más la longitud total de sus arrays /Kids. La profundidad deja de importar: una cadena de 4.096 niveles son 4.096 iteraciones de un bucle y 4.096 entradas en un hash set
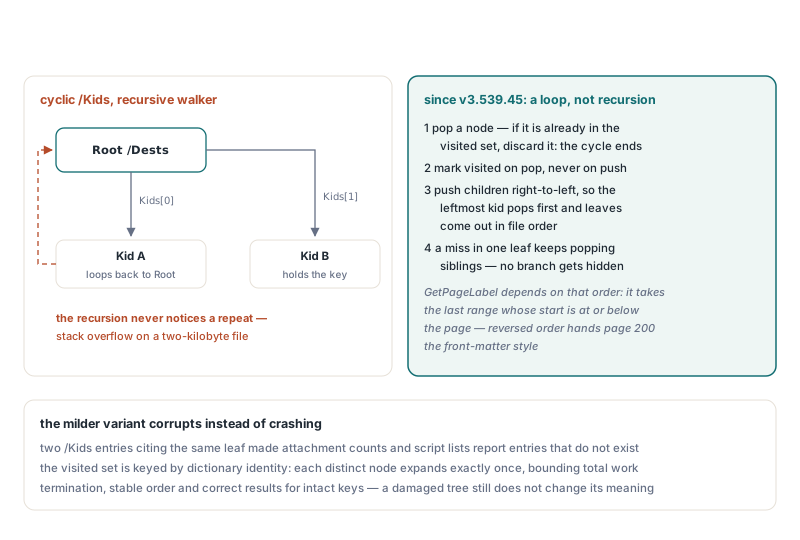
El orden sigue importando, eso sí, y a la pila hay que alimentarla al revés para conservarlo. Los hijos se meten desde el último índice hasta el primero, así que el hijo más a la izquierda sale primero y las hojas aparecen en el mismo orden de izquierda a derecha que escribió el productor. GetPageLabel depende de ello: recorre todos los rangos enumerados y aplica el último cuyo índice de inicio esté en la página o por debajo, así que invertir la enumeración entregaría en silencio a la página 200 el estilo de la portada interior. El esqueleto de abajo muestra el patrón sobre un tipo de nodo abstracto, independiente de cualquier modelo de objetos PDF
uses
  System.Generics.Collections;

type
  TTreeNode = class
  public
    Kids: TArray<TTreeNode>;   // vacío en una hoja
    Keys: TArray<string>;      // claves de hoja, ordenadas por un productor bien educado
    Values: TArray<Integer>;   // paralelo a Keys
    HasLimits: Boolean;
    LoKey, HiKey: string;
  end;

// /Limits es una pista: solo un par bien formado y ordenado puede podar una rama
function LimitsExclude(Node: TTreeNode; const Key: string): Boolean;
begin
  Result := Node.HasLimits and (Node.LoKey <= Node.HiKey) and
    ((Key < Node.LoKey) or (Key > Node.HiKey));
end;

function FindValue(Root: TTreeNode; const Key: string;
  out Value: Integer): Boolean;
var
  Pending: TList<TTreeNode>;
  Visited: TDictionary<TTreeNode, Byte>;
  Node: TTreeNode;
  I: Integer;
begin
  Result := False;
  Value := 0;
  if Root = nil then
    Exit;
  Pending := TList<TTreeNode>.Create;
  Visited := TDictionary<TTreeNode, Byte>.Create;
  try
    Pending.Add(Root);
    while Pending.Count > 0 do
    begin
      Node := Pending[Pending.Count - 1];
      Pending.Delete(Pending.Count - 1);
      if Visited.ContainsKey(Node) then
        Continue;                      // ciclo o hijo compartido: ya visto
      Visited.Add(Node, 0);
      if Length(Node.Kids) > 0 then
      begin
        // Mete de derecha a izquierda para que el hijo más a la izquierda salga primero
        for I := High(Node.Kids) downto 0 do
          if (Node.Kids[I] <> nil) and not LimitsExclude(Node.Kids[I], Key) then
            Pending.Add(Node.Kids[I]);
      end
      else
        for I := 0 to High(Node.Keys) do
          if (Node.Keys[I] = Key) and (I <= High(Node.Values)) then
          begin
            Value := Node.Values[I];
            Exit(True);
          end;
      // Un fallo en esta hoja no es un veredicto: siga sacando hermanos
    end;
  finally
    Visited.Free;
    Pending.Free;
  end;
end;
¿Por qué una búsqueda no puede detenerse en la primera rama que casa?
Una búsqueda no puede detenerse en la primera rama cuyo rango casa, porque los rangos /Limits en un archivo real pueden solaparse o mentir, y la rama que reclama la clave no es necesariamente la que la sostiene. Las búsquedas anteriores a v3.539.45 ponían un flag Found en el primer hijo cuyo /Limits cubría la clave, descendían por él y jamás miraban a otro hermano. Si ese hijo resultaba vacío, caducado o ser un bucle a la raíz, la respuesta era nil, incluso cuando el hermano siguiente contenía la clave
El FindTreeValue reescrito, que ahora sostiene tanto a NameTreeLookup como a NumTreeLookup, mete cada hijo cuyo rango no excluye la clave y sigue sacando hasta encontrar una coincidencia o vaciar la pila. Un fallo dentro de una hoja es solo eso, un fallo dentro de una hoja. En un árbol bien formado no cuesta nada extra; en uno dañado cuesta unas visitas de nodo más y devuelve la respuesta correcta
La búsqueda en la hoja sigue la misma filosofía. ISO 32000-1 exige que las claves de un array /Names estén ordenadas por valor de byte, así que la hoja se busca primero con una búsqueda binaria. Si falla, PDFlibPas recae en un barrido lineal de los pares, porque una hoja desordenada volvería invisible una clave presente. La ordenación es un camino rápido, no un filtro
La búsqueda además rehúsa adivinar ante una contradicción estructural. La tabla 36 deja que un nodo lleve /Kids o /Names, nunca ambos, y el camino de búsqueda trata un nodo que lleva ambos como malformado y lo salta en lugar de escoger una interpretación. Los caminos de enumeración como EnumNumTree son más tolerantes y siguen /Kids cuando ambos están presentes
¿En qué puede fiarse un lector de /Limits?
Un lector puede fiarse de /Limits solo para saltarse trabajo, nunca para decidir que una clave está ausente, y solo cuando el par está bien formado. La tabla 36 dice que los nodos intermedios y las hojas deben llevar /Limits como array de dos elementos con la clave menor y la mayor, pero en la práctica la entrada desaparece tras ediciones a mano, contiene números en un name tree, o llega con sus cotas intercambiadas. PDFlibPas v3.539.45 y v3.539.51 resuelven cada caso igual: si el rango no puede leerse como un par ordenado del tipo correcto, el hijo sigue siendo buscable
/Limitsausente: el antiguo check de rango devolvía False y el hijo se saltaba sin más, así que un productor que olvidara la entrada dejaba todo su subárbol inalcanzable. Desde v3.539.45 el hijo se busca- Tipo equivocado o longitud equivocada, como números en un name tree o un array de un elemento: se trata exactamente como una entrada ausente desde v3.539.45
- Cotas invertidas como
[(Z) (A)]o[9 0]: v3.539.45 aún las usaba, y ninguna clave puede cumplirLo <= Key <= HicuandoLo > Hi, así que la rama quedaba excluida para toda búsqueda. Desde v3.539.51 un rango se usa para podar solo cuando su cota inferior no supera a su cota superior - Bien formado, ordenado y correcto: se usa para saltar la rama, que es el propósito entero de la entrada
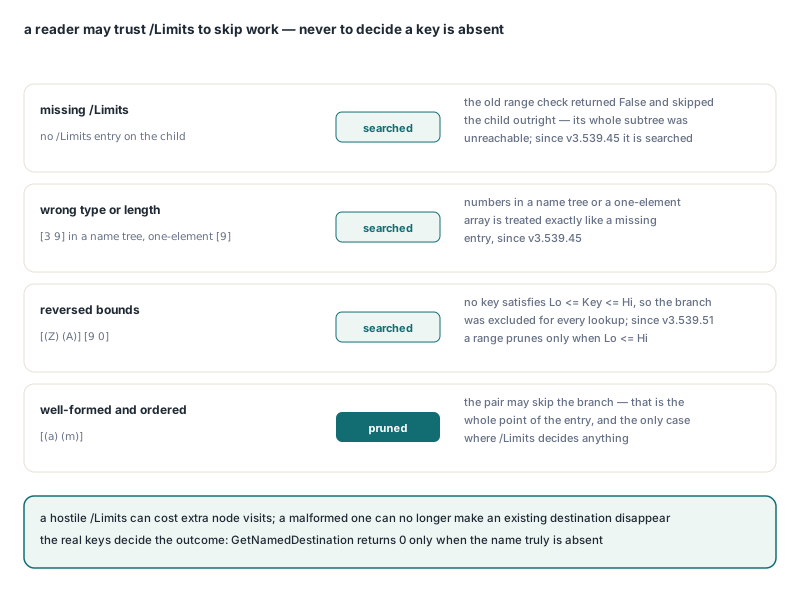
Las claves reales deciden el desenlace en todos los casos. Un /Limits hostil puede hacer que PDFlibPas visite más nodos de los necesarios, pero uno malformado ya no puede hacer desaparecer un destino existente. Desde el lado de quien llama nada cambia: GetNamedDestination devuelve 0 cuando el nombre de verdad no está y un ID de destino en caso contrario, y las funciones de destino toman el relevo desde ahí
uses
  PDFlibrary;

procedure LookUpDestination(const FileName, DestName: string);
var
  Lib: TPDFlib;
  DestID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
    begin
      WriteLn('Load failed, error ', Lib.LastErrorCode);
      Exit;
    end;
    // Primero /Dests del catálogo (PDF 1.1), luego el name tree /Dests
    DestID := Lib.GetNamedDestination(DestName);
    if DestID = 0 then
      WriteLn('No destination named ', DestName)
    else if Lib.GetDestPage(DestID) = 0 then
      WriteLn(DestName, ' exists but does not resolve to a page')
    else
      WriteLn(DestName, ' -> page ', Lib.GetDestPage(DestID),
        ', view type ', Lib.GetDestType(DestID));  // 1 = XYZ, 2 = Fit ...
  finally
    Lib.Free;
  end;
end;
Ejecutado contra un archivo escrito a mano cuyo raíz /Dests tiene un hijo que vuelve en bucle a la raíz bajo un rango [(a) (z)] y un segundo hijo que sostiene la entrada real bajo límites invertidos [(z) (a)], este procedimiento resuelve el destino a la página 2 con tipo de vista 2 (Fit). Antes de v3.539.45 la misma búsqueda devolvía 0, porque el hijo en bucle reclamaba la clave primero y la búsqueda jamás llegaba a su hermano; solo v3.539.45 seguía devolviendo 0, porque el rango invertido excluía la hoja real. Si después lee el outline que apunta a estos destinos, el artículo compañero sobre leer acciones de marcadores y anotaciones PDF en Delphi cubre el lado de las acciones
¿Cómo rompió una hoja con 32.769 nombres a TPDFNameTree?
Una hoja con 32.769 pares nombre/valor rompía TPDFNameTree porque su FindIndex interno empaquetaba dos números en un solo Integer de 32 bits: la posición de la hoja en la lista interna de arrays en los 16 bits altos y el offset de la entrada dentro del array /Names de esa hoja en los 16 bits bajos. Cada par ocupa dos posiciones de array, así que el par 32.769, el de índice 32.768, empieza en el offset 65.536, que es $10000. Ese valor arrastra a la mitad alta, y el decodificador lo leía de vuelta como offset 0 en la hoja siguiente
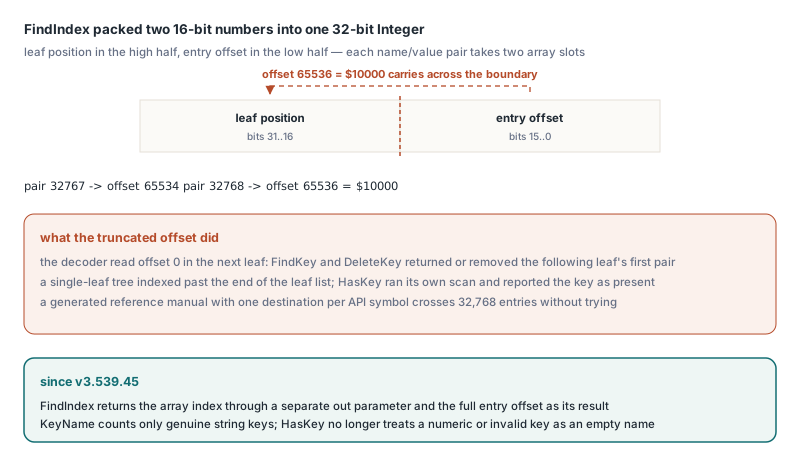
TPDFNameTree es la clase tras los adjuntos, los paquetes globales de JavaScript y las escrituras de named destinations, lo que hace las consecuencias muy concretas. En un árbol de una sola hoja no hay hoja siguiente, así que FindKey y DeleteKey indexaban más allá del final de la lista de hojas; en un árbol multihija devolvían o borraban el primer par de la hoja siguiente en lugar del solicitado. Mientras tanto HasKey hacía su propio barrido y reportaba la clave como presente, de modo que la clase se contradecía a sí misma. Un manual de referencia generado con una named destination por símbolo de API cruza las 32.768 entradas sin esfuerzo, y algunos productores los escriben todos en una única hoja plana
Desde v3.539.45, FindIndex devuelve el índice de array por un parámetro out separado y el offset completo de la entrada como resultado, así que ningún valor se trunca. La misma versión apretó dos vecinos. KeyName cuenta y devuelve ahora solo claves de tipo string genuinas y devuelve una cadena vacía para un índice de 0 o menos, donde antes hacía un cast de cualquier objeto que siguiera a una clave inválida. HasKey ya no trata una clave numérica o inválida como un nombre vacío. Para una hoja como [(Valid) 42 123 456], HasKey('') es ahora False y KeyName(2) devuelve una cadena vacía
procedure AuditTrees(const FileName: string);
var
  Lib: TPDFlib;
  I: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
      Exit;
    // number tree /PageLabels; los archivos sin él devuelven números de página planos
    for I := 1 to Lib.PageCount do
      WriteLn('Page ', I, ' label: ', Lib.GetPageLabel(I));
    // name tree /EmbeddedFiles; índices 1-based, claves no string saltadas
    for I := 1 to Lib.EmbeddedFileCount do
      WriteLn('Attachment ', I, ': ', Lib.GetEmbeddedFileStrProperty(I, 1),
        ' (', Lib.GetEmbeddedFileStrProperty(I, 2), ')');  // nombre, tipo MIME
    // name tree /JavaScript: liste nombres de paquetes, no ejecute nada
    for I := 1 to Lib.GlobalJavaScriptCount do
      WriteLn('Script package: ', Lib.GlobalJavaScriptPackageName(I));
  finally
    Lib.Free;
  end;
end;
Sobre el mismo archivo escrito a mano, cuyo raíz /PageLabels lista una hoja dos veces y se referencia a sí mismo, esta auditoría imprime i y A-1 para las dos páginas, cada rango una vez, y el único paquete de scripts de un árbol /JavaScript que también apunta a su propia raíz. El lado de escritura de los page labels tiene su propia historia con raíces /Kids, cubierta en arreglar los page labels PDF guardados en number trees /Kids; AddPageLabels aplana semejante raíz antes de insertar, y se apoya en la misma enumeración EnumNumTree descrita aquí
¿Qué sigue sin garantizar este endurecimiento?
El endurecimiento garantiza terminación, orden estable y resultados correctos para árboles cuyas claves reales están intactas; no hace que un árbol dañado signifique lo que su autor pretendía. Conviene conocer varios límites antes de construir sobre él
- El conjunto de visitados funciona por identidad de objeto. Dos diccionarios distintos con contenido idéntico son dos nodos, así que un productor que copie una hoja en lugar de referenciarla seguirá produciendo entradas duplicadas
- Un
/Limitsbien formado, ordenado pero equivocado sigue podando. Un lector que usa los rangos como optimización no puede ser inmune también a un rango que mienta de forma plausible; la única alternativa es ignorar/Limitspor completo y barrer cada hoja - La enumeración preserva el orden del archivo pero no ordena.
GetPageLabelaplica el último rango enumerado en la página o por debajo, así que un productor que escriba rangos desordenados recibe semántica de orden de archivo - La memoria crece con el número de nodos y entradas distintos. El recorrido añade una lista y un hash set, nada más, pero un name tree de 100 MB sigue siendo un name tree de 100 MB tras el parseo
- Las claves duplicadas dentro de una hoja no se reportan. La búsqueda binaria devuelve el primer par coincidente que pisa; el fallback lineal conserva el último que barre
Referencia rápida: leer árboles PDF de archivos no fiables
- Actualice a v3.539.45 o posterior para un recorrido de name trees y number trees a salvo de ciclos y de stack overflow, y a v3.539.51 o posterior para que los
/Limitsinvertidos ya no escondan claves - Trate un
GetNamedDestinationque devuelve 0 como "ausente", y unGetDestPageque devuelve 0 como "presente pero inservible" - Use
GlobalJavaScriptCountyGlobalJavaScriptPackageNamepara el name tree/JavaScript;GetDocJavaScriptlee los triggers/AAdel catálogo en su lugar - Indexe adjuntos y paquetes de scripts de 1 al recuento que la biblioteca reporta; las claves inválidas no se cuentan
- En su propio código de árboles, marque los nodos como visitados al sacarlos, meta los hijos en orden inverso y deje que
/Limitspode solo cuando sea un par bien tipado y ordenado
Las herramientas de preflight, los archivadores y los visores leen estos árboles antes de que se renderice cualquier página, así que tienen que sobrevivir a lo que llegue en una cola de subidas. Los lectores de árboles descritos arriba vienen con PDFlibPas, la PDF Library para Delphi, que compila tanto con Delphi como con Free Pascal