Este es el fallo que un lector JBIG2 escrito a mano comete con el primer fichero raro que se encuentra. Parsea la cabecera del fichero, parsea la primera cabecera de segmento, lee la longitud de datos de cuatro bytes y toma esos bytes como cuerpo del segmento. En la mayoría de ficheros .jb2 eso es exactamente correcto. En un fichero cuyo byte de flags tiene el bit 0 a cero, esos bytes de "cuerpo" son en realidad las cabeceras del segundo, tercer y cuarto segmento, y el decodificador aritmético los convierte en un bitmap de ruido o se sale del final del búfer. El fichero no está roto. Usa la organización de acceso aleatorio del Anexo D.2 de ITU-T T.88, donde todas las cabeceras de segmento van primero y todos los datos de segmento van después, en el mismo orden
Los ficheros de acceso aleatorio son raros. Salen de sistemas de archivo y de imagen documental que quieren que un lector vea cada página y cada dependencia de diccionario antes de tocar un byte comprimido. Si un trabajo de conversión mezcla ficheros de semejante origen con escaneos ordinarios, un fichero de acceso aleatorio puede quedar en mitad de un lote que por lo demás es todo secuencial. El decodificador que los lee es el mismo decodificador Pascal nativo que se encarga de las tablas Huffman personalizadas y códigos de prefijo canónicos de JBIG2, así que la parte de codificación no cambia; solo difiere el orden en que se encuentran los segmentos
Tres disposiciones de fichero detrás de un byte de flags
PDF Library for Delphi lee ficheros JBIG2 independientes a través de TPLJBIG2Decoder en la unidad PDFlibJBIG2, y el decodificador averigua la disposición por su cuenta a partir de la cabecera del fichero. El Anexo D de T.88 permite ordenar los mismos segmentos de tres formas: secuencial (D.1) coloca cada cabecera justo delante de sus datos, acceso aleatorio (D.2) pone todas las cabeceras primero y todos los datos después, y embebido (D.3) es la forma sin cabecera que se usa dentro de otros contenedores. Un fichero independiente empieza con el identificador de ocho bytes 97 4A 42 32 0D 0A 1A 0A, luego un byte de flags y después un contador de páginas de cuatro bytes, salvo que los flags digan que el contador es desconocido
El bit 0 de ese byte de flags elige la organización: 1 significa secuencial, 0 significa acceso aleatorio. El bit 1 a uno significa que el número de páginas es desconocido y el contador de cuatro bytes está ausente, así que la primera cabecera de segmento empieza en el byte 9 en lugar del byte 13. Los bits 2 a 7 están reservados; el decodificador acepta los ficheros que los activan en lugar de rechazarlos, porque un bit reservado perdido no dice nada sobre si los segmentos en sí son legibles
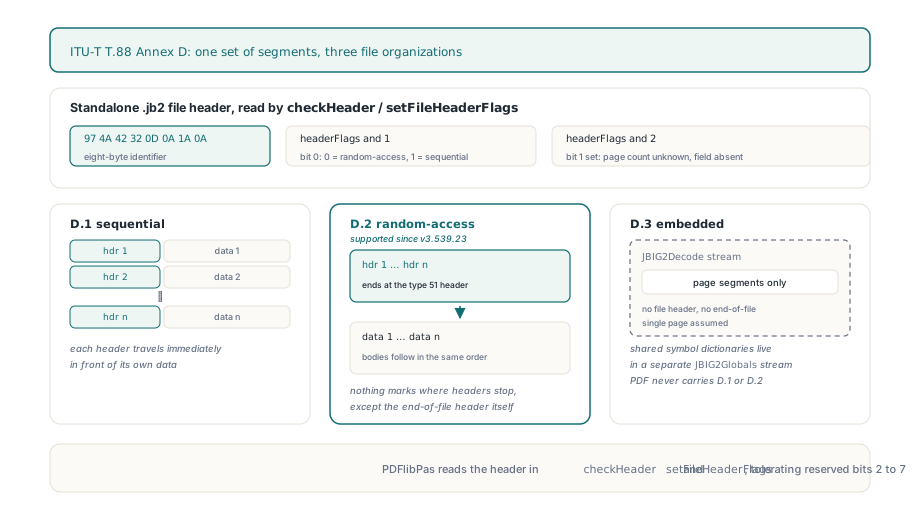
El PDF en sí nunca lleva la disposición de acceso aleatorio. Un stream de imagen JBIG2Decode, descrito en ISO 32000-1 §7.4.7, solo contiene segmentos de página en forma embebida, con los diccionarios de símbolos compartidos movidos a un stream JBIG2Globals aparte y sin cabecera de fichero ni segmentos de fin de página o de fin de fichero. Cuando el decodificador no encuentra el identificador de ocho bytes, trata la entrada exactamente como ese tipo de stream: secuencial, una página. En el otro sentido, cuando PDF Library for Delphi exporta una imagen JBIG2Decode como fichero .jb2 nativo, escribe el byte de flags $03 (secuencial, contador de páginas desconocido) y añade una cabecera de segmento de fin de fichero. Así que el acceso aleatorio solo llega desde fuera, como fichero independiente entregado directamente a TPLJBIG2Decoder, normalmente de camino a convertirse o recomprimirse para PDF con los backends de codificación JBIG2 de PDFlibPas
¿Por qué no se puede leer un fichero de acceso aleatorio en orden de fichero?
Porque nada en el stream de bytes marca dónde termina el bloque de cabeceras y empieza el bloque de datos, salvo la propia cabecera del segmento de fin de fichero (tipo 51). Las cabeceras de segmento JBIG2 no tienen tamaño fijo. El conteo de segmentos referidos es una forma corta de tres bits o una forma larga seguida de un bitmap de retención; cada número de segmento referido ocupa uno, dos o cuatro bytes según lo grande que sea el número del propio segmento actual; el campo de asociación de página es de un byte o de cuatro. Un lector tiene que parsear cada campo de una cabecera solo para saber dónde empieza la siguiente
Un lector secuencial que recorre el fichero en orden acierta con la primera cabecera y falla con todo lo demás. Peor aún: puede no enterarse durante un rato, porque un decodificador de región genérica alimentado con bytes de cabecera produce píxeles, no un error, hasta que alguna comprobación posterior de longitud o de referencia tropieza por fin. Nuestra opinión es que un decodificador que no indexa las cabeceras primero debería rechazar los ficheros de acceso aleatorio sin más. Un rechazo claro cuesta un fichero en un lote; un bitmap con aspecto plausible pero equivocado puede acabar en un archivo y quedarse ahí
Indexar cada cabecera antes del primer cuerpo
Cuando el byte de flags dice acceso aleatorio, PDF Library for Delphi hace una pasada sobre el bloque de cabeceras antes de decodificar nada. Cada cabecera se parsea por completo y luego se tira; lo único que se conserva es su offset de byte en el fichero. Los datos comprimidos nunca se copian a un segundo búfer reordenado, lo cual importa en escaneos de archivo grandes donde el bloque de datos puede ser la mayor parte del fichero. La pasada se detiene en la primera cabecera de fin de fichero, y en ese momento la posición de lectura está sobre el primer byte de los datos del primer segmento
Un fichero de acceso aleatorio tiene menos redundancia que uno secuencial, así que el preescaneo es estricto. Rechaza el fichero cuando:
- una cabecera queda cortada por el final del búfer, reportado como
JBIG2 truncated random-access header at byte Ncon el offset donde empezaba esa cabecera - los números de segmento no crecen estrictamente (comparados como valores sin signo), porque dos cabeceras que reclamen el mismo número dejan ambigua la lista de referidos de una región posterior
- una longitud de datos tiene el bit superior a uno, lo que incluye el marcador
0xFFFFFFFFde "longitud desconocida"; en esta disposición no hay otra forma de encontrar dónde empieza el siguiente cuerpo, así que el decodificador lo rechaza de inmediato en lugar de escanear buscando un marcador de fin - la cabecera de fin de fichero declara datos, o no aparece nunca (
JBIG2 random-access file is missing its end-of-file header) - las longitudes declaradas suman más que los bytes que quedan, o menos
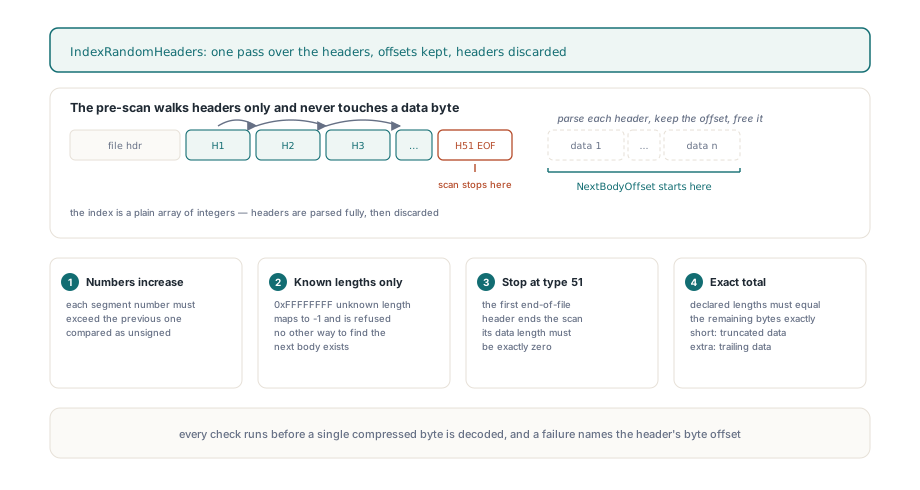
La última regla es la que la gente tropieza. Un solo byte de más tras el cuerpo final falla con JBIG2 trailing random-access data. Junto al camino secuencial, donde la decodificación simplemente se detiene en el segmento de fin de fichero y todo lo que venga después se ignora, parece severo. La asimetría tiene su motivo. En la disposición secuencial cada cabecera está justo al lado de sus propios datos, así que la basura del final no puede haber desplazado nada. En la disposición de acceso aleatorio las cabeceras son el único mapa del bloque de datos, y si las longitudes no cuadran, el decodificador no puede distinguir un relleno inofensivo de un byte perdido o añadido mucho antes que haya desplazado todos los cuerpos posteriores
¿Por qué un bucle que cuenta bytes pierde el último segmento de fin de página?
Un bucle que corre "mientras queden bytes" termina demasiado pronto en un fichero de acceso aleatorio, porque los datos se agotan antes que el índice de cabeceras. Los segmentos de fin de página (tipo 49) y de fin de fichero llevan cero bytes de datos y normalmente van al final. Una vez consumido el último cuerpo de región, la posición de lectura está exactamente al final del búfer; un bucle contado por bytes sale ahí, y el segmento de fin de página de longitud cero nunca se despacha, lo que deja la página sin terminar
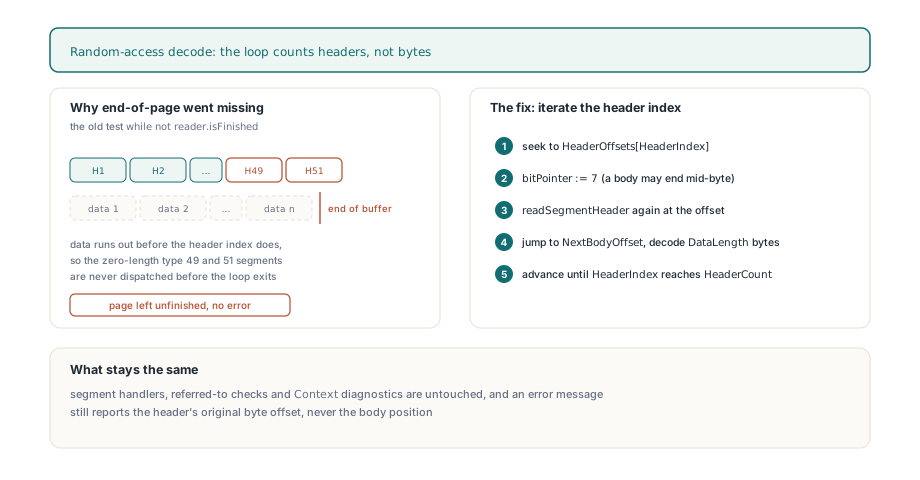
Así que para los ficheros de acceso aleatorio el decodificador cuenta cabeceras, no bytes. Cada paso salta a la siguiente cabecera indexada, se realinea a un límite de byte (un cuerpo codificado aritméticamente puede terminar en mitad de un byte), parsea la cabecera de nuevo, y luego salta hacia adelante a donde empieza el siguiente cuerpo y lo avanza según la longitud declarada. Un cuerpo cuyo decodificador termina antes se salta hasta su final declarado; uno que lee más allá se rechaza. Desde ahí el segmento pasa por los mismos manejadores y comprobaciones de referencia que en un fichero secuencial. Los errores elevados mientras se decodifica un cuerpo llevan la posición original de la cabecera, con la forma JBIG2 segment N (type T) at byte B: ..., así que el offset en LastError apunta a algo que puedes encontrar en un editor hexadecimal
Cargar un fichero .jb2 de acceso aleatorio en Delphi
El código de aplicación no cambia con la organización. TPLJBIG2Decoder.LoadFromByteArray detecta la cabecera del fichero y la disposición, devuelve False ante cualquier entrada rechazada con el motivo en LastError, y expone la página decodificada a través de Width, Height y GetScanline, que llena un byte por píxel con 1 para negro
uses
  SysUtils, Classes, PDFlibJBIG2;

function ReadJb2(const FileName: string): TJBIG2ByteArray;
var
  FS: TFileStream;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    SetLength(Result, FS.Size);
    if Length(Result) > 0 then
      FS.ReadBuffer(Result[0], Length(Result));
  finally
    FS.Free;
  end;
end;

function CountBlackPixels(const FileName: string): Integer;
var
  Decoder: TPLJBIG2Decoder;
  Row: TJBIG2ByteArray;
  X, Y: Integer;
begin
  Result := 0;
  Decoder := TPLJBIG2Decoder.Create;
  try
    // Los archivos independientes secuenciales y de acceso aleatorio usan la misma llamada
    if not Decoder.LoadFromByteArray(ReadJb2(FileName)) then
      raise Exception.Create('JBIG2 rejected: ' + Decoder.LastError);
    for Y := 0 to Decoder.Height - 1 do
      if Decoder.GetScanline(Y, Row) then
        for X := 0 to Decoder.Width - 1 do
          if Row[X] = 1 then
            Inc(Result);
  finally
    Decoder.Free;
  end;
end;
Si quieres saber qué disposición usa un fichero, para registrarla o para ordenar un corpus antes de una pasada de conversión, lee el byte de flags tú mismo. La biblioteca no expone la organización que detectó, y nueve bytes son todo lo que hace falta. La función auxiliar de abajo es para añadirla a tu propio código; se limita a reproducir las reglas de cabecera de T.88:
type
  TJb2Layout = (jlNoFileHeader, jlSequential, jlRandomAccess);

// Función auxiliar tuya, no forma parte de PDFlibJBIG2: clasifica un búfer por su cabecera de fichero T.88
function DetectJb2Layout(const Data: TJBIG2ByteArray;
  out PageCountKnown: Boolean): TJb2Layout;
const
  Signature: array[0..7] of Byte = ($97, $4A, $42, $32, $0D, $0A, $1A, $0A);
var
  I: Integer;
begin
  Result := jlNoFileHeader;          // p. ej. un stream embebido extraído de un PDF
  PageCountKnown := False;
  if Length(Data) < 9 then
    Exit;
  for I := 0 to 7 do
    if Data[I] <> Signature[I] then
      Exit;
  PageCountKnown := (Data[8] and 2) = 0;   // bit 1 a uno: sin contador de páginas de cuatro bytes
  if (Data[8] and 1) = 0 then
    Result := jlRandomAccess
  else
    Result := jlSequential;
end;
Trabajos por lotes: búferes con relleno y ficheros rechazados
La regla de datos finales es donde el código por lotes suele fallar, y cuando un fichero que abre en otros sitios se rechaza por este motivo, mira el búfer antes que el fichero. Un .jb2 sacado de una columna BLOB de base de datos, de una lectura de red de tamaño fijo o de un formato contenedor con relleno de alineación puede llegar con unos pocos bytes cero tras el final real. Un fichero secuencial se encoge de hombros. Un fichero de acceso aleatorio con el mismo relleno falla con JBIG2 trailing random-access data, y también falla un búfer cortado unos bytes, que falla como truncado. Pasa exactamente los bytes del fichero, dimensionados por la longitud real del origen, nunca por un tamaño de chunk ni una capacidad
Un fichero rechazado tampoco deja nada atrás. LoadFromByteArray reinicia Width, Height y las scanlines antes de empezar a decodificar, de modo que una llamada fallida reporta dimensiones cero en lugar de la página del fichero anterior, y la misma instancia del decodificador puede seguir directamente con el siguiente fichero:
procedure DecodeBatch(const Files, Log, Quarantine: TStrings);
var
  Decoder: TPLJBIG2Decoder;
  I: Integer;
begin
  Decoder := TPLJBIG2Decoder.Create;
  try
    for I := 0 to Files.Count - 1 do
      if Decoder.LoadFromByteArray(ReadJb2(Files[I])) then
        Log.Add(Format('%s: %d x %d', [Files[I], Decoder.Width, Decoder.Height]))
      else
      begin
        // Width y Height valen 0 aquí; nada del fichero anterior sobrevive
        Log.Add(Files[I] + ': ' + Decoder.LastError);
        if Pos('trailing random-access data', Decoder.LastError) > 0 then
          Quarantine.Add(Files[I]);   // comprueba cómo se almacenaron los bytes antes de culpar al fichero
      end;
  finally
    Decoder.Free;
  end;
end;
Comprobar esto en tu propio pipeline no necesita ficheros de muestra raros. Reorganiza un .jb2 secuencial a disposición de acceso aleatorio, conservando cada cabecera y cada byte comprimido, mueve las cabeceras de fin de página y de fin de fichero al final del bloque de cabeceras, y los píxeles decodificados deben coincidir exactamente con el original secuencial, tanto con como sin el campo de contador de páginas. Luego dale cada prefijo truncado, un número de segmento duplicado, un byte final de más y una longitud 0xFFFFFFFF; cada uno debe devolver False con Width y Height a cero
Qué devuelve el decodificador y qué espera
El acceso aleatorio aquí es una propiedad de la disposición del fichero. TPLJBIG2Decoder devuelve el bitmap de la primera página use la organización que use el fichero, y Width y Height describen esa página. Cada segmento debe declarar su longitud de datos; T.88 permite que una región genérica inmediata use el marcador 0xFFFFFFFF, y el decodificador rechaza ese marcador en cualquiera de las dos disposiciones con unknown or oversized segment length is not supported. Las longitudes de prefijo Huffman personalizadas y los conteos de entradas de tabla se limitan igual que en los ficheros secuenciales
Decodificar JBIG2 es una etapa de un camino de imagen más largo que cubre también extracción de imágenes PDF, recompresión y codificación JBIG2; la página de producto de PDF Library for Delphi cubre el resto de ese pipeline y los formatos de imagen soportados