Vuelque un segmento JBIG2 Tables (tipo 53) byte a byte y la primera sorpresa es lo que deja fuera: los propios códigos Huffman. Usted recibe un byte de flags, dos cotas y una tanda de números pequeños, y esos números son longitudes de código. Encoder y decoder reconstruyen ambos los patrones de bits reales a partir de las longitudes con el procedimiento del Anexo B.3 de ITU-T T.88. Reconstrúyalos en un orden ligeramente distinto y seguirá teniendo un código prefijo válido, cada patrón seguirá decodificando, y cada valor saldrá asociado al patrón equivocado
En una página codificada con IDs de símbolo Huffman y tablas suministradas por el encoder, ese desajuste parece un escaneo malo: glifos desplazados unos píxeles, caracteres construidos con los símbolos equivocados, o números plausibles hasta que un ancho se sale de rango varios segmentos más tarde. La mayoría del JBIG2 en archivos PDF va codificado aritméticamente, y la mayor parte del JBIG2 codificado con Huffman se atiene a las tablas estándar B.1 a B.15. Los archivos que envían sus propias tablas son raros, y tienden a ejercitar a la vez el parser de tablas, el refinement codificado con Huffman y los collective bitmaps sin comprimir
¿Qué contiene realmente un segmento Tables de JBIG2?
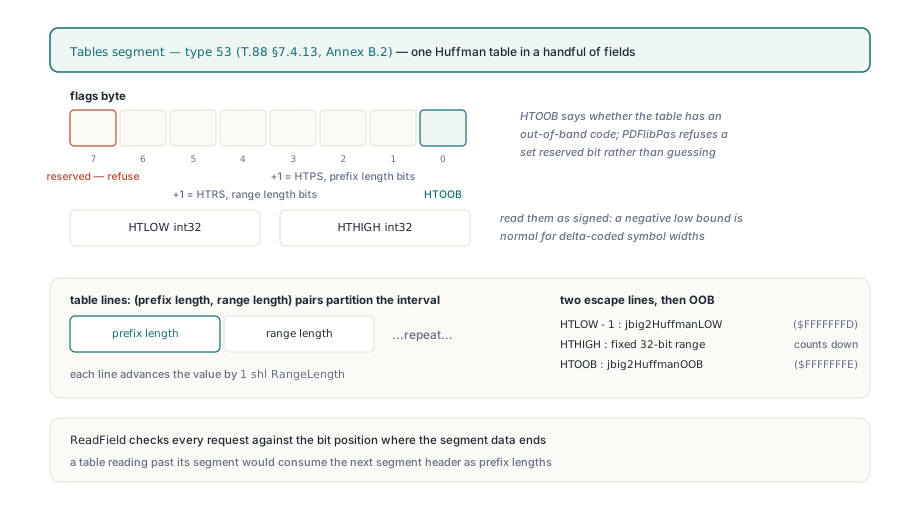
Un segmento Tables describe exactamente una tabla Huffman. T.88 §7.4.13 y el Anexo B.2 lo disponen como un byte de flags, un HTLOW de 32 bits con signo, un HTHIGH de 32 bits con signo, y luego pares (longitud de prefijo, longitud de rango) que teselan el intervalo desde HTLOW hasta HTHIGH. El bit 0 de los flags es HTOOB, que dice si la tabla tiene un código out-of-band. Los bits 1 a 3 más uno dan HTPS, el ancho de cada campo de longitud de prefijo. Los bits 4 a 6 más uno dan HTRS, el ancho de cada campo de longitud de rango. El bit 7 está reservado
Las cotas son donde un parser escrito a mano suele tropezar primero. Lea HTLOW como unsigned y una tabla que empieza en -2, algo ordinario para anchos y alturas de símbolo delta-codificados, de repente afirma empezar justo por debajo de 4.300 millones. PDF Library for Delphi lee ambas cotas como valores con signo, rechaza una tabla cuyo HTLOW no esté por debajo de HTHIGH o cuya longitud de rango exceda 32, y comprueba cada lectura de campo contra el bit donde termina el dato declarado del segmento. Ese último check importa más de lo que suena: una tabla que lee más allá de su segmento consume la cabecera del siguiente segmento como longitudes de prefijo y parsea hasta el sinsentido completo. Un bit 7 a uno falla con reserved custom Huffman table flag. Preferimos ese rechazo a una adivinanza, porque una tabla adivinada produce píxeles equivocados que nadie puede remontar hasta su causa
Tras las líneas regulares vienen las líneas de escape del Anexo B.2. La línea de rango inferior arranca en HTLOW menos uno y cuenta hacia abajo con un offset de 32 bits, la línea de rango superior arranca en HTHIGH con un rango de 32 bits, y la línea out-of-band existe solo cuando HTOOB está a uno. Estas líneas llevan los mismos marcadores que usan las tablas estándar integradas, así que una tabla personalizada y la tabla B.6 pasan por un único bucle de decodificación. Una tabla personalizada puede contener hasta 65.536 líneas
¿Por qué hay que asignar los códigos prefijo en el orden de las líneas de la tabla?
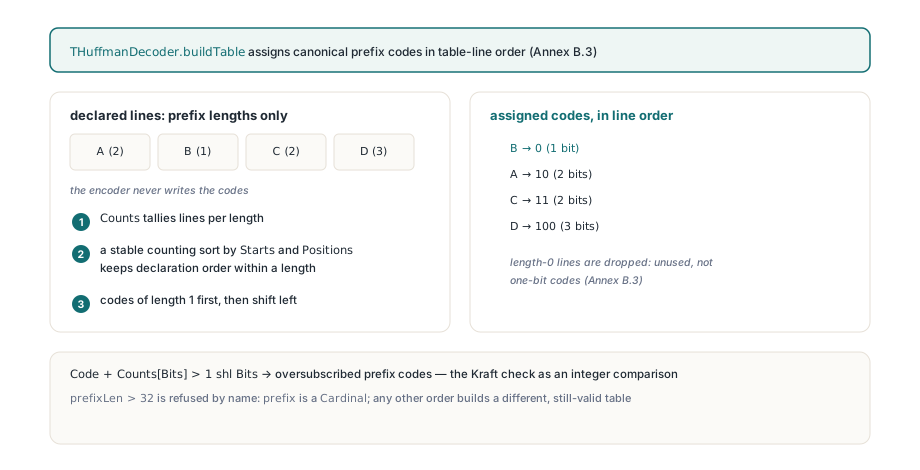
Porque el orden de declaración es lo único que ata un patrón de bits a un rango de valores. El Anexo B.3 cuenta cuántas líneas usan cada longitud de prefijo, reparte primero los códigos de longitud 1, desplaza a la izquierda para pasar a longitud 2, y así sucesivamente; dentro de una misma longitud, los códigos van a las líneas en el orden en que aparecen en el segmento. Una tabla pequeña lo hace concreto. Seis líneas, etiquetadas A a F en orden de archivo, con estas longitudes de prefijo:
| Línea | Longitud de prefijo | Código (orden de archivo conservado) | Código si B y D se intercambian |
|---|---|---|---|
| A | 2 | 00 | 00 |
| B | 3 | 100 | 101 |
| C | 2 | 01 | 01 |
| D | 3 | 101 | 100 |
| E | 3 | 110 | 110 |
| F | 0 | sin uso | sin uso |
Ambas columnas son códigos prefijo válidos. Solo la izquierda es lo que el encoder quiso decir: con B y D intercambiadas, el patrón 100 produce el rango de valores de D y el decoder sigue con un número del intervalo equivocado. La línea F tiene longitud 0, que B.3 define como sin uso; dele un código de un bit y toda asignación posterior se desplaza
La manera fácil de obtener la columna de la derecha es un sort de propósito general por longitud de prefijo. El TArray.Sort y el TList<T>.Sort de Delphi no son estables, así que las longitudes iguales pueden volver en cualquier orden. Para códigos canónicos en su propia herramienta, recorra las líneas en orden de archivo una vez por longitud:
uses
  System.SysUtils;

type
  TCodeLine = record
    PrefixLen: Integer;   // tal como se lee del segmento Tables
    Code: Cardinal;       // asignado abajo
  end;

// Asignación canónica del Anexo B.3, escrita para su propia herramienta.
// Las longitudes iguales conservan su orden de archivo; la longitud 0 no recibe código.
procedure AssignCanonicalCodes(var Lines: array of TCodeLine);
var
  LenCount: array[0..32] of UInt64;
  FirstCode: array[0..32] of UInt64;
  NextCode: UInt64;
  CurLen, I: Integer;
begin
  FillChar(LenCount, SizeOf(LenCount), 0);
  for I := 0 to High(Lines) do
  begin
    if (Lines[I].PrefixLen < 0) or (Lines[I].PrefixLen > 32) then
      raise Exception.Create('prefix length out of range');
    Inc(LenCount[Lines[I].PrefixLen]);
  end;
  LenCount[0] := 0;
  FirstCode[0] := 0;
  for CurLen := 1 to 32 do
  begin
    FirstCode[CurLen] := (FirstCode[CurLen - 1] + LenCount[CurLen - 1]) shl 1;
    // Check de Kraft: más códigos de los que esta longitud puede sostener
    if FirstCode[CurLen] + LenCount[CurLen] > (UInt64(1) shl CurLen) then
      raise Exception.Create('oversubscribed prefix lengths');
    NextCode := FirstCode[CurLen];
    for I := 0 to High(Lines) do       // el orden de archivo es el desempate
      if Lines[I].PrefixLen = CurLen then
      begin
        Lines[I].Code := Cardinal(NextCode);
        Inc(NextCode);
      end;
  end;
end;
Alimente con las seis líneas de arriba y A recibe 00, C recibe 01, B recibe 100, D recibe 101 y E recibe 110; F se queda sin código. PDF Library for Delphi hace el mismo trabajo con una pasada de conteo, que es estable por construcción y evita reescanear la tabla 32 veces, y aplica las mismas dos guardias. Las longitudes sobreasignadas fallan con oversubscribed Huffman prefix codes; déjelas pasar y un patrón puede casar con dos líneas. Los prefijos de más de 32 bits también fallan por su nombre, aunque T.88 los permite sobre el papel. Creemos que ese techo es el intercambio correcto: cada código cabe en una palabra de máquina, y un archivo que necesita más tiene muchas más probabilidades de estar dañado que de ser ingenioso
Los valores necesitan el mismo cuidado. La línea de rango inferior decodifica como HTLOW menos uno menos un offset unsigned de 32 bits, y con un intermediario Integer de 32 bits esa resta puede hacer wrap hacia un ancho positivo de aspecto ordinario. El decoder lo hace en 64 bits y lanza Huffman value exceeds signed integer range cuando el resultado verdadero no cabe
Orden de selectores, y dos trampas que se tapan la una a la otra
Una text region o un symbol dictionary no nombran sus tablas. Lleva selectores de dos bits, y cada selector puesto a personalizada toma el siguiente segmento Tables de la lista de referidos, en orden de referencia. T.88 §7.4.3.1.2 ordena los selectores de text region como FS, DS, DT, RDW, RDH, RDX, RDY y RSIZE; §7.4.2.1.1 ordena los selectores de symbol dictionary como DH, DW, BMSIZE y AGGINST. Los valores 0 y 1 escogen tablas estándar, 3 escoge una personalizada, y 2 está reservado en campos con solo dos tablas estándar. PDF Library for Delphi rechaza los valores de selector reservados, y falla con missing custom Huffman table reference cuando los selectores quieren más tablas personalizadas de las que la región refiere
Si usted escribe su propio decoder, aquí son fáciles dos errores, y cada uno tapa al otro. El primero muerde en Delphi, o en FPC en modo Delphi (el modo objfpc rechaza el código como identificador duplicado): un setter de flags cuyo parámetro tiene el mismo nombre que el campo. El parámetro ensombrece al campo, Flags := Flags asigna el campo a sí mismo, y el campo se queda a cero. Cada selector lee entonces cero, una text region usa las tablas estándar B.6, B.8 y B.11 para FS, DS y DT sin importar lo que pidiera el archivo, y el camino personalizado jamás corre
La segunda se sienta en el symbol dictionary. Un diccionario Huffman puede almacenar sus símbolos como un collective bitmap sin comprimir (BMSIZE de cero), donde cada fila termina en un byte parcial. El valor de padding es el número de bits válidos en ese byte, y es tentador leerlo como la posición del bit válido más bajo:
// Último byte de una fila de collective bitmap, bits leídos MSB primero.
// Padding := TotalWidth mod 8  -> número de bits VÁLIDOS en este byte

// Mal: trata Padding como el índice del bit más bajo a copiar
for BitPos := 7 downto Padding do
  CopyPixel((LastByte shr BitPos) and 1);

// Bien: el índice del bit válido más bajo es 8 - Padding (0 cuando Padding = 0)
for BitPos := 7 downto ((8 - Padding) and 7) do
  CopyPixel((LastByte shr BitPos) and 1);

// CopyPixel representa lo que sea que escriba el píxel en su propio decoder
Compruebe los anchos de frontera. Una fila de 63 píxeles tiene un padding de 7: el bucle malo copia un bit del último byte, el bueno siete. Una fila de 9 píxeles tiene un padding de 1: el bucle malo copia siete, el bueno copia uno. A 64 píxeles ambos copian los ocho, así que los múltiplos de 8 jamás lo exponen. Collective bitmaps sintéticos de 7 y 9 píxeles de ancho fijan ambos lados de la frontera del byte. Y el daño viaja, porque el refinement usa estos símbolos como referencias
Si su propio decoder tiene ambas trampas, depurarlo se vuelve miserable. Corrija solo el setter y el camino personalizado por fin corre, directo contra collective bitmaps rotos, así que la página sigue viéndose mal. Corrija solo el padding y nada visible cambia, porque el camino personalizado sigue inalcanzable. Pruebe ambos con entradas sintéticas antes de fiarse de cualquier cambio. Un detalle relacionado: un symbol dictionary Huffman cuyos símbolos de entrada y nuevos suman uno obtiene una longitud de código de símbolo de 0 de la fórmula de log2, y sin embargo la variante Huffman escribe cada ID de símbolo con al menos un bit. PDF Library for Delphi sube esa longitud a 1 en modo Huffman
¿De dónde lee su tamaño de bitmap el refinement Huffman?
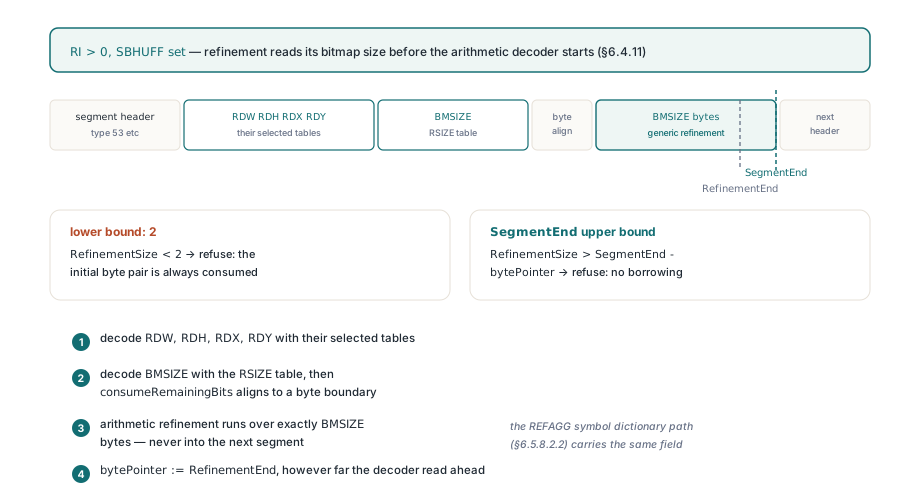
De un campo BMSIZE que solo existe en modo Huffman, decodificado por delante de los datos de refinement aritmético. Cuando una instancia de text region lleva refinement (RI distinto de cero) y SBHUFF está activo, T.88 §6.4.11 hace que el decoder lea RDW, RDH, RDX y RDY con sus tablas seleccionadas, luego BMSIZE con la tabla RSIZE, luego salte a una frontera de byte, y solo entonces ejecute la decodificación de refinement genérica sobre exactamente BMSIZE bytes. Las text regions en modo aritmético no tienen ese campo, así que un decoder que comparte un solo camino de código entre los modos se lo salta, arranca el decoder aritmético antes de tiempo, y refina cada símbolo contra ruido. El camino del symbol dictionary con REFAGG y una única instancia de refinement (§6.5.8.2.2) tiene el mismo campo
PDF Library for Delphi acota BMSIZE por ambos lados. El mínimo es 2, el par de bytes inicial que el decoder aritmético consume siempre. El máximo es lo que queda del segmento actual, deliberadamente no del stream entero: un BMSIZE que solo quepa pidiendo bytes prestados del siguiente segmento está malformado, y un check contra la longitud del stream dejaría al decoder aritmético leer dentro de la siguiente cabecera. Los tamaños fuera de rango fallan con invalid refinement bitmap size. Después el lector Huffman se reanuda exactamente BMSIZE bytes más allá del campo, sin importar cuánto haya leído por delante el decoder aritmético
La longitud declarada del segmento es la frontera
Cada cabecera de segmento declara cuántos bytes de dato siguen, y el decoder mantiene el segmento dentro de ese número en ambas direcciones: leer más allá del final es un error, terminar antes es normal, y la siguiente cabecera siempre se lee desde donde el archivo dijo que empieza. Reglas menores se siguen de ahí. La longitud de dato desconocida de T.88 §7.2.7 se rechaza de entrada en lugar de escanear en busca de un terminador. Los segmentos referidos deben llevar números menores que el actual y deben existir ya. END_OF_PAGE y END_OF_FILE deben declarar cero bytes de dato. Un segmento Profiles (tipo 52) debe ser exactamente 4 más 4 veces su recuento de identificadores; se salta pero se conserva, así que segmentos posteriores pueden seguir refiriéndose a él, y un identificador de perfil desconocido no detiene la decodificación
El caso clásico para terminar antes es MMR. Un decoder MMR sabe que ha terminado en cuanto produce el último píxel de la última fila, lo que puede ocurrir antes del terminador EOFB que T.88 §6.2.5.7 coloca al final del dato. Un lector que asume que ahora está en la siguiente cabecera parsea los bytes EOFB sobrantes como un número de segmento y falla unos bytes más tarde, lejos de la causa real. Saltar al final declarado evita la pregunta. El mismo hábito recorre cómo PDF Library for Delphi parsea estructuras PDF no confiables en general
Decodificar un stream de imagen JBIG2 desde Delphi
El decoder vive en la unidad PDFlibJBIG2 como TPLJBIG2Decoder. LoadFromByteArray toma los datos JBIG2 incrustados de una imagen /JBIG2Decode y, opcionalmente, los datos de su stream /JBIG2Globals, que es donde suelen vivir las tablas personalizadas y los symbol dictionaries compartidos. Devuelve False ante cualquier rechazo y deja la razón en LastError; la salida de una llamada anterior se limpia al principio de cada llamada, así que una decodificación fallida jamás deja píxeles viejos para que el llamador los confunda con un resultado
uses
  System.SysUtils, PDFlibJBIG2;

// ImageBytes: los datos del stream de imagen con cualquier filtro previo a
//   JBIG2Decode ya retirado
// GlobalBytes: los datos del stream /JBIG2Globals, o un array vacío
function DecodeAndCountBlack(const ImageBytes, GlobalBytes: TJBIG2ByteArray;
  out BlackPixels: Int64): Boolean;
var
  Decoder: TPLJBIG2Decoder;
  Line: TJBIG2ByteArray;
  Row, Col: Integer;
begin
  BlackPixels := 0;
  Decoder := TPLJBIG2Decoder.Create;
  try
    Result := Decoder.LoadFromByteArray(ImageBytes, GlobalBytes);
    if not Result then
    begin
      // Formato: 'JBIG2 segment <n> (type <t>) at byte <offset>: <reason>'
      Writeln('JBIG2 refused: ', Decoder.LastError);
      Exit;
    end;
    for Row := 0 to Decoder.Height - 1 do
    begin
      Decoder.GetScanline(Row, Line);   // un byte por píxel, 0 o 1
      for Col := 0 to Decoder.Width - 1 do
        Inc(BlackPixels, Line[Col]);    // 1 = negro en JBIG2
    end;
  finally
    Decoder.Free;
  end;
end;
El recuento de píxeles negros es un check suyo, una huella digital barata para comparar contra un segundo renderer. Los fallos a nivel de segmento llegan precedidos del número de segmento, el tipo y el offset de byte, así que un (type 53) delante de oversubscribed Huffman prefix codes apunta directo a un segmento Tables. Mantenga separados los dos canales de error: TPLJBIG2Decoder.LastError es el texto diagnóstico de este decoder, mientras que TPDFlib.LastErrorCode es el código numérico de la API a nivel de biblioteca. La selección de página sigue el stream: el decoder devuelve el bitmap del primer segmento page-information que encuentra y no busca la asociación de página 0, porque el JBIG2 incrustado en PDF lleva una página y los encoders la numeran rutinariamente como 1
Comparar renderers sobre estos archivos exige cierta humildad, porque los decoders JBIG2 independientes no siempre concuerdan en archivos con tablas personalizadas y refinement Huffman. Dos decoders en desacuerdo no zanja nada. Los campos del formato sí: qué tablas escogieron los selectores, qué declaró el BMSIZE, dónde termina cada segmento
La codificación está cubierta en el artículo sobre backends de encoder JBIG2 y cómo se enlazan. El camino de lectura tiene que aceptar lo que el encoder de otro emitiera, y comparte sus reglas con el decoder TIFF integrado y sus checks de BigTIFF y layout teselado: rechazar por su nombre, jamás pedir bytes prestados a través de una frontera declarada, mantener la aritmética intermedia ancha. Si una carpeta de PDFs escaneados sigue tumbando a otros toolkits, compruebe si las imágenes son JBIG2 codificado con Huffman y tablas personalizadas, y pruébelas contra el camino de lectura nativo Delphi y C++Builder descrito en la página de producto de PDF Library for Delphi