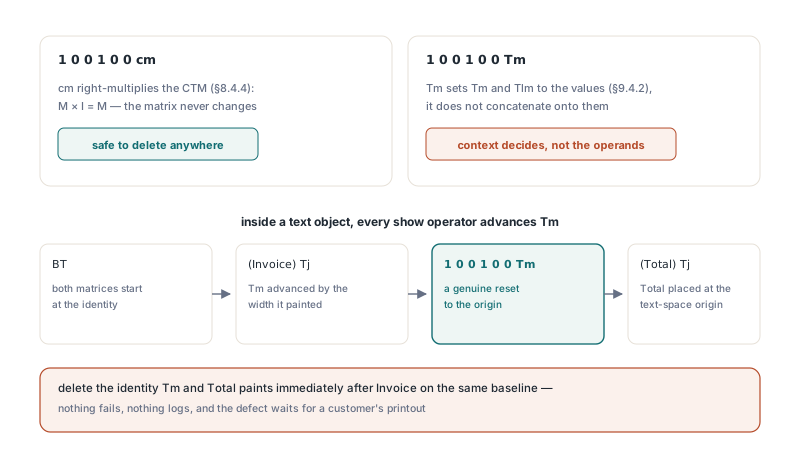
Toma un content stream que podría escribir un generador de informes, BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET, y quita el 1 0 0 1 0 0 Tm porque sus seis números deletrean la matriz identidad. Renderiza el resultado y "Total" ya no empieza en el origen del espacio de texto. Empieza donde terminó "Invoice", sobre la misma línea base. Un Tm identidad es redundante solo mientras la matriz de texto y la matriz de línea de texto ya sostienen la identidad: directamente tras BT, o directamente tras otro Tm identidad
El borrado tienta porque los mismos seis números son realmente peso muerto delante de un cm. Un optimizador de content streams que trate los dos operadores por igual encogerá montones de streams correctamente. Hasta que encuentra un generador que usa un Tm identidad como retorno de carro, y el texto se mueve
¿Por qué 1 0 0 1 0 0 Tm no es siempre un no-op?
Los dos operadores hacen aritmética distinta. ISO 32000-1 §8.4.4 define cm como concatenar su operando con la matriz de transformación actual; multiplica cualquier matriz por la identidad y recuperas la misma matriz, así que 1 0 0 1 0 0 cm se puede borrar dondequiera que aparezca. Tm es una asignación. Bajo la §9.4.2 fija la matriz de texto y la matriz de línea de texto con sus operandos y tira lo que sostuvieran, así que si cambia algo depende por completo de los operadores delante de él
La §9.4.1 dice que BT arranca ambas matrices en la identidad. Desde ahí, casi todo lo de dentro de un objeto de texto mueve al menos una de las dos. Td, TD, T* y un Tm no identidad reposicionan la matriz de línea de texto. Cada operador que muestra texto (Tj, TJ, ' y ") avanza la matriz de texto el ancho de los glifos que acaba de pintar, y los dos últimos empiezan además una línea nueva. Una vez que cualquiera de esos ha corrido, un Tm identidad es un salto genuino de vuelta al origen. El stream de factura de arriba depende de ese salto
Trazar un stream a mano lo zanja rápido. Pasa el ejemplo de la factura por el rastreador de estado de CTM y matriz de texto de content streams y el registro muestra cm concatenándose sobre la CTM mientras Tm sobreescribe ambas matrices de texto — dos reglas de actualización distintas escondidas tras operandos idénticos
Cómo decide PDF Library for Delphi qué Tm identidad soltar
PDF Library for Delphi suelta cada cm identidad durante su pasada peephole, y suelta un Tm identidad solo cuando un escaneo hacia atrás desde ese operador alcanza un BT u otro Tm identidad antes de encontrar nada que pudiera haber movido las matrices de texto. El test de "identidad" es numérico: el operador necesita exactamente seis operandos numéricos iguales a 1, 0, 0, 1, 0, 0, así que 1.0 0 0 1.0 0 0 Tm también cualifica. Caminando hacia atrás, el escaneo mete cada operador que encuentra en uno de dos grupos:
- Parar y conservar el Tm:
Td,TD,T*, unTmno identidad,Tj,TJ,',",ET, cualquier operador que el parser no reconozca, o el inicio del stream - Pasar por encima y seguir escaneando: operadores que nunca tocan la matriz de texto ni la de línea de texto, como
Tf,Tc, los que fijan color,gs, los operadores de marked-content,Doycm
Un Tm identidad anterior termina el escaneo en favor del borrado tanto si el optimizador lo está conservando como si ya lo tiene programado para eliminarse. En cualquier caso dejó ambas matrices en la identidad, que es el mismo estado que deja BT. Por eso una racha de tres operadores Tm identidad justo tras BT colapsa a nada
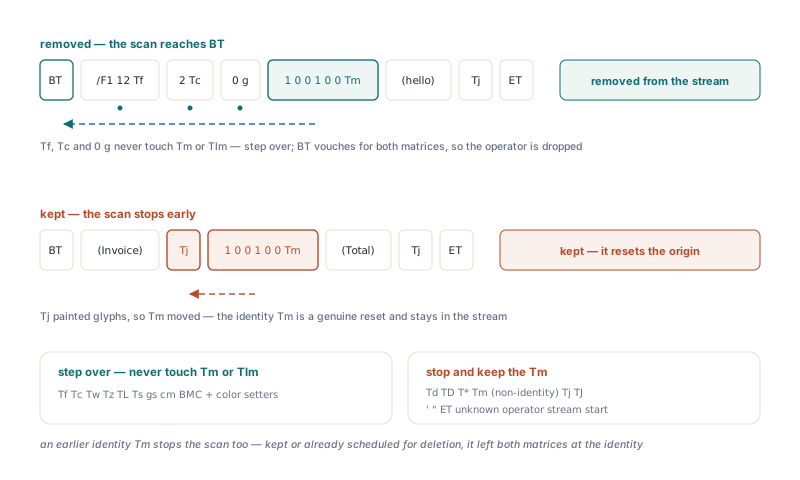
Las paradas conservadoras son deliberadas. Un operador desconocido podría ser una extensión de proveedor que haga cualquier cosa, así que el escaneo se niega a razonar más allá de él. Tras ET no hay ningún objeto de texto abierto, y un Tm identidad sentado ahí no tiene ningún BT que avale los valores de la matriz. El escaneo además mira un content stream cada vez. Eso importa para las páginas cuyo /Contents es un array: PDF deja que un objeto de texto empiece en un stream y continúe en el siguiente, así que una capa que abre en medio de un objeto de texto, sin BT propio, conserva su Tm identidad incluso cuando la capa anterior lo habría vuelto redundante
Nos parece el lado equivocado correcto. Rastrear matrices a través de fronteras de stream, o simular operadores desconocidos, recuperaría quizá catorce bytes de texto sin comprimir por archivo raro. Equivocarse mueve un glifo en una factura impresa. El coste y el riesgo no están en la misma liga
Un efecto derivado merece conocerse porque cambia lo que ves en la salida. La misma pasada también elimina los objetos de texto sin nada dentro, así que BT 1 0 0 1 0 0 Tm ET desaparece por completo: el Tm identidad se va primero, y el par BT/ET que deja atrás queda vacío
Ejecutar el optimizador sobre un fragmento de content stream
El optimizador trabaja sobre el mismo modelo TPDFContentProgram parseado que usarías para editar el texto de página al nivel de instrucción, como en el paseo por el mapeo de carácter a byte de contenido. Eso hace fácil probar la regla sobre una cadena antes de fiarle un documento entero. El helper de abajo parsea un stream decodificado, ejecuta TPDFContentPeepholeOptimizer, y emite el resultado una instrucción por línea. Fijar CanonicalNumbers antes de Parse refleja la pasada de guardado, que reescribe cada número a una precisión fija
uses
  PDFlibContentModel, PDFlibContentOptimize;

function OptimizeSnippet(const Source: AnsiString): AnsiString;
var
  Prog: TPDFContentProgram;
  Optimizer: TPDFContentPeepholeOptimizer;
begin
  Result := Source;
  Prog := TPDFContentProgram.Create;
  try
    Prog.CanonicalNumbers := True; // el mismo manejo de números que la pasada de guardado
    if not Prog.Parse(Source) then
      Exit; // daño estructural grave: deja los bytes tranquilos
    Optimizer := TPDFContentPeepholeOptimizer.Create(Prog);
    try
      Optimizer.Run; // devuelve el número de instrucciones eliminadas
    finally
      Optimizer.Free;
    end;
    Result := Prog.Emit; // una instrucción por línea, separadas por #10
  finally
    Prog.Free;
  end;
end;

// Eliminado: Tm directamente tras BT, el segundo de dos Tm identidad seguidos
//   OptimizeSnippet('BT /F1 12 Tf 1 0 0 1 0 0 Tm (hello) Tj ET')
// Conservado: Tm tras Td, tras Tj, tras un Tm no identidad, o fuera de BT
//   OptimizeSnippet('BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET')
Pasa el stream de factura por él y el Tm identidad sobrevive, porque el escaneo hacia atrás encuentra un Tj mucho antes de llegar al BT. Pon /F1 12 Tf, 2 Tc y 0 g entre el BT y el Tm identidad y aún así se va, porque ninguno de esos toca las matrices de texto. El caso interesante es BT 10 20 Td 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm. Pierde exactamente un operador. El primer Tm identidad deshace el movimiento que hizo el Td, y solo el segundo es redundante
Parse devuelve False solo ante daño grave como una cadena o diccionario sin terminar. Los operadores desconocidos parsean bien y se quedan en el programa, donde actúan como paradas duras para el escaneo
¿Cuándo se ejecuta de verdad el optimizador peephole?
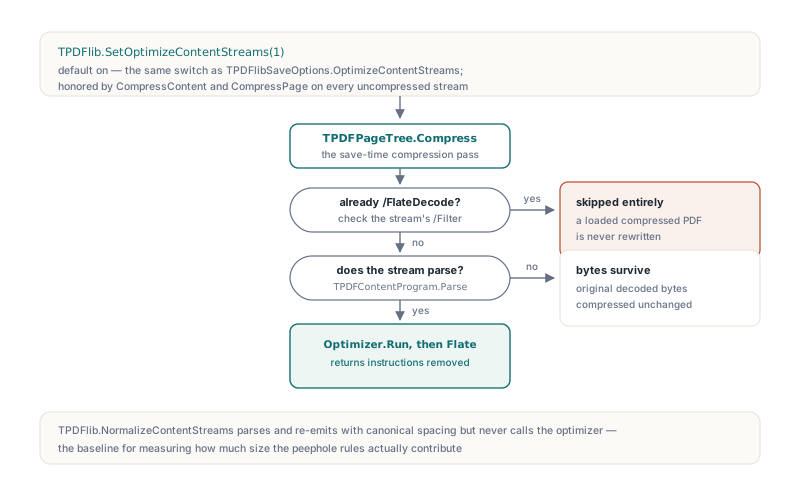
El optimizador corre solo dentro de la pasada de compresión, y solo sobre streams de contenido de página que no estén ya comprimidos con Flate. TPDFlib.SetOptimizeContentStreams(1) es el valor por defecto, y el mismo interruptor aparece como el campo OptimizeContentStreams de TPDFlibSaveOptions; CompressContent y CompressPage lo honran ambos. Un stream cuyo /Filter ya es /FlateDecode se salta por completo, así que cargar un PDF comprimido típico y guardarlo otra vez deja sus operadores exactamente como estaban. Los streams almacenados sin comprimir se decodifican, optimizan y luego comprimen con Flate. Si un stream falla al parsear, sus bytes decodificados originales se comprimen sin cambios
var
  Lib: TPDFlib;
  Options: TPDFlibSaveOptions;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('report.pdf', '') <> 1 then
      Exit;
    // Los streams de página sin comprimir pasan por las reglas peephole, luego Flate
    Lib.SetOptimizeContentStreams(1);
    Lib.CompressContent;
    Lib.SaveToFile('report-optimized.pdf');

    // La misma elección por las opciones de guardado incluidas; False renuncia
    Options.CompressContent := True;
    Options.CompressFonts := True;
    Options.CompressImages := True;
    Options.Linearize := False;
    Options.KeepModDate := False;
    Options.OptimizeContentStreams := False;
    Options.GarbageCollect := False;
    Options.PackObjectStreams := True;
    Lib.SaveToFileOptions('report-plain.pdf', Options);
  finally
    Lib.Free;
  end;
end;
Deja el valor por defecto activado. Cada transformación de la pasada es equivalente en salida, y la regla de la matriz identidad va tras un patrón que muchos generadores emiten, abriendo cada objeto de texto con BT 1 0 0 1 0 0 Tm. Apagarlo tiene sentido sobre todo cuando quieres comparar tu propia salida sin comprimir contra lo que escribiste, o cuando necesitas una línea base. Para esa línea base, TPDFlib.NormalizeContentStreams parsea y re-emite el contenido con espaciado y números canónicos pero nunca llama al optimizador, así que el hueco de tamaño entre un guardado normalizado y uno optimizado es lo que aportaron las reglas peephole. Espera que sea modesto junto a las ganancias mayores descritas en optimización de tamaño de archivos PDF con subsetting de fuentes
Un test que cubre una forma no define la regla
Un test que alimenta BT 1 0 0 1 0 0 Tm (hello) Tj ET a un optimizador y asevera que no queda ningún Tm fija una sola forma: un Tm identidad directamente tras BT se elimina. No dice nada sobre un Tm identidad tras un Td o tras texto mostrado. Leer esa única aserción como "el Tm identidad siempre es eliminable" es un error fácil, y caro, porque la muestra pasa de cualquier forma. Los tests de cualquier regla como esta necesitan las formas conservadas escritas al lado de las eliminables
El helper de abajo cuenta los operadores Tm que sobreviven, y luego comprueba una tabla de entradas. Sustituye ExpectTm por la aserción de tu framework de tests; no forma parte de la biblioteca
uses
  SysUtils, PDFlibContentModel, PDFlibContentOps, PDFlibContentOptimize;

function TmCountAfterOptimize(const Source: AnsiString): Integer;
var
  Prog: TPDFContentProgram;
  Optimizer: TPDFContentPeepholeOptimizer;
  I: Integer;
begin
  Result := -1; // -1 señala un fallo de parseo
  Prog := TPDFContentProgram.Create;
  try
    if not Prog.Parse(Source) then
      Exit;
    Optimizer := TPDFContentPeepholeOptimizer.Create(Prog);
    try
      Optimizer.Run;
    finally
      Optimizer.Free;
    end;
    Result := 0;
    for I := 0 to Prog.Count - 1 do
      if Prog[I].Op = coTextMatrix then
        Inc(Result);
  finally
    Prog.Free;
  end;
end;

// Tu propio helper de comprobación, sugerido aquí; sustitúyelo por una aserción real
procedure ExpectTm(const Source: AnsiString; Expected: Integer);
var
  Actual: Integer;
begin
  Actual := TmCountAfterOptimize(Source);
  if Actual <> Expected then
    raise Exception.CreateFmt('%s: expected %d Tm, got %d',
      [string(Source), Expected, Actual]);
end;

procedure CheckIdentityTmRule;
begin
  // Formas eliminables
  ExpectTm('BT /F1 12 Tf 1 0 0 1 0 0 Tm (hello) Tj ET', 0);
  ExpectTm('BT 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm (a) Tj ET', 0);
  ExpectTm('BT /F1 12 Tf 2 Tc 0 g 1 0 0 1 0 0 Tm (a) Tj ET', 0);
  // Formas que deben conservar el Tm identidad
  ExpectTm('BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET', 1);
  ExpectTm('BT 10 20 Td 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm (a) Tj ET', 1);
  ExpectTm('BT 2 0 0 2 5 5 Tm (a) Tj 1 0 0 1 0 0 Tm (b) Tj ET', 2);
  ExpectTm('1 0 0 1 0 0 Tm (a) Tj', 1);    // sin BT envolvente
  ExpectTm('BT ET 1 0 0 1 0 0 Tm', 1);     // tras ET
end;
Las dos últimas filas parecen tonterías hasta que recuerdas que los arrays /Contents en capas producen exactamente esos fragmentos. Un stream que empieza a mitad de objeto de texto no tiene BT, y un Tm identidad tras ET no pertenece a ningún objeto de texto. Ambos se quedan. El par BT ET vacío de la última fila lo elimina la regla del objeto de texto vacío, razón por la que el recuento comprueba operadores Tm en lugar de comparar cadenas enteras
Lo que la regla renuncia es al Tm identidad ocasional en medio de un objeto de texto, unos bytes por página antes de que Flate los vea siquiera. Lo que compra es una garantía sobre la que descansa el diseño del optimizador: ninguna transformación de la pasada cambia la página visible. Un optimizador de tamaño que mueve texto es un bug de renderizado con una buena razón de compresión
Si generas o postprocesas contenido PDF en Delphi o C++Builder, la PDF Library for Delphi and C++Builder trae el parser de content streams, esta pasada peephole y las opciones de guardado mostradas arriba, junto a NormalizeContentStreams para producir una línea base limpia y sin optimizar con la que comparar