Una búsqueda de "two-x" en un PDF recién generado puede volver con cero resultados mientras la página muestra claramente esos cinco caracteres. Dumper el string extraído como code points y la razón está ahí mismo: el guion volvió como U+00AD SOFT HYPHEN, y el espacio después de él como U+00A0 NO-BREAK SPACE. Ambos se ven idénticos en pantalla. La diferencia vive en el CMap ToUnicode, la tabla que un lector consulta para convertir los códigos de carácter de vuelta a Unicode, y viene de que un glifo de la fuente es compartido por dos code points
Las herramientas de string corrientes empeoran el desajuste. Un export CSV parte la línea de otra forma, una herramienta de diff marca dos líneas que se leen igual en todos los visores, y un corrector ortográfico trata "two-x" con un soft hyphen como palabra desconocida. La normalización Unicode solo lo rescata a medias: NFKC pliega U+00A0 en un espacio ordinario porque NBSP lleva una descomposición de compatibilidad, pero U+00AD no tiene descomposición alguna, así que el soft hyphen sobrevive a todas las formas de normalización
¿Por qué los espacios extraídos vuelven como U+00A0?
Los espacios extraídos se convierten en U+00A0 cuando el CMap ToUnicode está indexado por glifo y un glifo se puede alcanzar desde dos code points. En Arial, el glifo 3 sirve tanto a U+0020 como a U+00A0, y el glifo del guion sirve tanto a U+002D como a U+00AD. Un CMap construido desde el lado del glifo tiene que decir algo sobre el CID 0003, y el generador de PDFium en FPDFText_LoadFont acaba diciendo dos cosas: una entrada bfchar que lo mapea a U+0020, y un bfrange en forma de arreglo que mapea el mismo CID a U+00A0
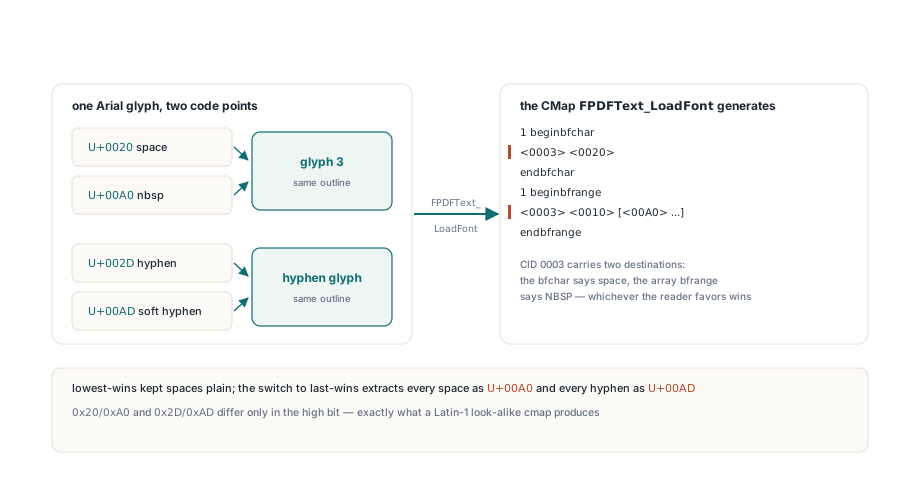
1 beginbfchar
<0003> <0020>
endbfchar
1 beginbfrange
<0003> <0010> [<00A0> ...]
endbfrange
ISO 32000-1 §9.10.3 describe cómo bfchar y bfrange mapean códigos a Unicode, pero no dice qué entrada gana cuando dos de ellas reclaman el mismo CID. Los lectores eligen una regla de precedencia propia. Un lector que conserva el mapeo más bajo o el primero extrae un espacio simple; el lector de PDFium conserva el último, y como el rango en arreglo va después del bloque bfchar, cada espacio escrito a través de un CMap indexado por glifo se extrae como NBSP y cada guion como soft hyphen. El mismo texto puede, por lo tanto, extraerse distinto en dos visores del mismo archivo
Los pares siguen un patrón. 0x20/0xA0 y 0x2D/0xAD difieren solo en el bit alto, que es lo que produce una fuente cuando su cmap manda los pareados de Latin-1 al outline ya usado para el carácter ASCII. La Omega mayúscula griega (U+03A9) y el signo Ohm (U+2126) también comparten un glifo en Arial. Si su código de extracción pasaba y ahora falla con caracteres que no puede ver, imprima los code points en lugar de confiar en la vista de string del debugger; lo básico de leer texto de una página está en extraer texto de documentos PDF con PDFium en Delphi
Cómo PDFium Component indexa fuentes del sistema por code point
PDFium Component nunca le pide al motor que genere ese CMap para fuentes del sistema que traen un cmap Unicode. Cuando TPdf.AddText necesita una fuente, el componente lee la tabla cmap sfnt de la propia fuente, prefiriendo una subtabla formato 12 y cayendo al formato 4. Los code points vuelven ordenados y sin duplicados, y al k-ésimo code point se le asigna el CID k+1, dejando el CID 0 como .notdef. Un CIDToGIDMap explícito manda cada CID a su glifo. U+0020 y U+00A0 reciben así dos CIDs distintos que dibujan el mismo outline, y el CMap ToUnicode que el componente escribe mapea cada CID a exactamente un code point
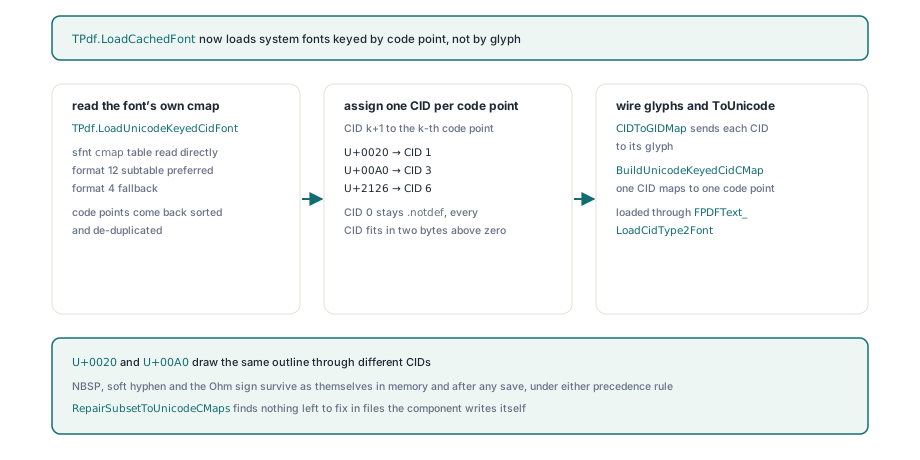
La fuente se carga por FPDFText_LoadCidType2Font, el mismo punto de entrada detrás de la escritura a nivel de glifo en la incrustación de fuentes CID Type 2 con mapas CID-to-GID explícitos. Cuando FPDFText_SetText escribe luego un string, el lookup inverso aterriza en un único CID por carácter. Nada de eso depende de la regla de precedencia del lector, porque no hay un segundo mapeo entre el que la regla pueda elegir. El archivo guardado también lleva el stream ToUnicode del propio componente, así que la extracción tras recargar ve la misma tabla uno a uno que usó el documento vivo
El costo es un CIDToGIDMap más grande: dos bytes por code point que cubra la fuente. Suponga una fuente que mapea unos 3,000 code points. El mapa entonces ronda los 6 KB, entregados al motor con cada fuente. Ese intercambio vale la pena siempre. Unos cuantos kilobytes compran una extracción que se lee igual en PDFium, en los visores que conservan el primer mapeo, y en el indexador que su cliente ponga a correr el año que viene
El round trip de abajo escribe un string que contiene todos los pares problemáticos, lo extrae del documento sin guardar, guarda, recarga y extrae de nuevo. Ambos strings deben coincidir exactamente con la entrada; el helper CodePoints está ahí solo para que un desajuste se pueda leer:
uses
  SysUtils, PDFium;

const
  // Espacio/U+00A0 y guion/U+00AD comparten un glifo de Arial, igual que
  // Omega griega (U+03A9) y el signo Ohm (U+2126)
  Sample: WString = 'two-x'#$00A0'y'#$00AD'z '#$03A9#$2126;

function CodePoints(const S: WString): string;
var
  I: Integer;
begin
  Result := '';
  for I := 1 to Length(S) do
    Result := Result + 'U+' + IntToHex(Ord(S[I]), 4) + ' ';
end;

var
  Pdf: TPdf;
  Live, Reloaded: WString;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.CreateDocument;
    Pdf.AddPage(1, 595, 842);
    Pdf.AddText(Sample, 'Arial', 12, 72, 770);
    Live := Pdf.Text;                  // documento vivo, sin guardar
    Pdf.SaveAs('codepoints.pdf');
  finally
    Pdf.Free;
  end;

  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'codepoints.pdf';
    Pdf.Active := True;
    Pdf.PageNumber := 1;
    Reloaded := Pdf.Text;              // tras un guardado completo y recarga
  finally
    Pdf.Free;
  end;

  if (Live <> Sample) or (Reloaded <> Sample) then
    Writeln('Mismatch: ', CodePoints(Live), '/ ', CodePoints(Reloaded));
end.
Deje el NBSP y el soft hyphen en el string de muestra aun cuando sus documentos rara vez los contengan. Una prueba que escribe solo ASCII pasa también contra un CMap indexado por glifo, porque nada en ella le pide al lector elegir entre dos mapeos
¿Por qué una entrada bfrange puede borrar un bloque entero?
Un solo bfrange cuya corrida de CIDs cruza una frontera xxFF hace que PDFium descarte el bloque entero donde vive. ISO 32000-1 §9.10.3 solo permite que el último byte del destino varíe dentro de un rango, y el lado CID tiene una trampa espejo en el parser de PDFium: deriva el CID alto como (low and $FFFFFF00) or (high and $FF). Una corrida del CID 00FE a 0101 se lee como 00FE a 0001, bajo mayor que alto, y el bloque entero queda marcado inválido. SetText tiene éxito, la página renderiza correctamente, y la extracción devuelve U+0000 para cada carácter de ese bloque
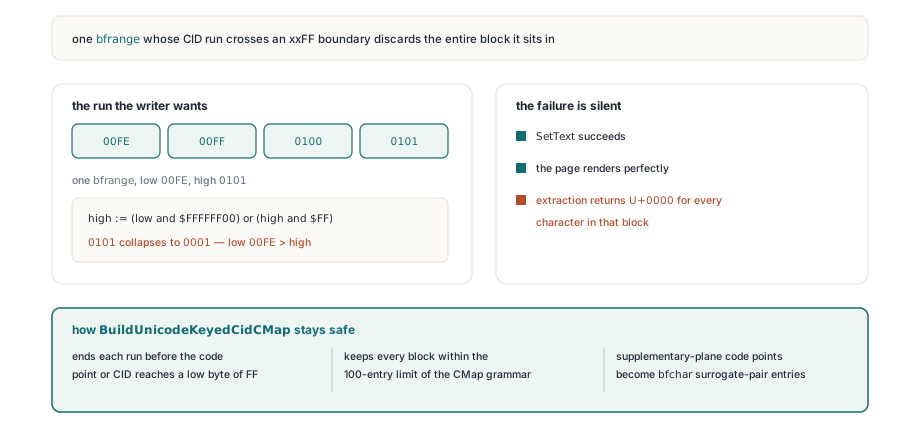
Una fuente indexada por code point es justo donde esto muerde. Los CIDs son densos y secuenciales, así que cualquier fuente con más de 255 code points produce corridas de CIDs que cruzarían 00FF, 01FF y demás si el escritor simplemente fusionara entradas consecutivas. El CMap que PDFium Component escribe termina una corrida antes de que el code point o el CID alcancen un byte bajo de FF, y divide las entradas en bloques de a lo sumo 100, el límite que la gramática CMap impone a cada sección beginbfrange y beginbfchar
Los code points por encima de U+FFFF reciben entradas bfchar individuales cuyos destinos son pares surrogate UTF-16, ya que incrementar un par surrogate dentro de un rango no tiene significado definido. El lado surrogate de la historia está en el manejo de emoji, CJK y pares surrogate en Delphi. Un CMap solo-bfchar esquivaría el problema de frontera por completo, a cambio de varias veces el tamaño, y por eso los rangos siguen siendo la forma principal y las reglas de división cargan con el peso
Reparar conflictos ToUnicode en archivos de otras herramientas
RepairSubsetToUnicodeCMaps en la unidad FPdfCompress arregla el conflicto indexado por glifo en archivos que el componente no escribió. TPdf.SaveAs lo corre en cada guardado completo no incremental, y usted puede llamarlo directamente sobre cualquier stream. Para cada CID que lleva dos destinos, gana la entrada bfchar. Sin bfchar para el CID, un par que difiere solo en el bit alto se resuelve al code point base-Latín menor. Cualquier otro conflicto conserva su primer mapeo
La reparación edita los valores hex en conflicto in situ, con reemplazos de igual longitud. El layout de bloques, la cobertura de CIDs y cualquier otro byte del stream quedan como estaban, así que el CMap permanece en la forma que el lector de PDFium ya aceptó. Un CMap reconstruido limpiamente se vería más ordenado en un hex dump. También cambiaría la estructura de un stream que un lector estricto ya aceptó, y esa es una apuesta sin lado positivo cuando solo unos cuantos valores de destino están mal
uses
  Classes, FPdfCompress;

var
  Source, Dest: TFileStream;
begin
  Source := TFileStream.Create('from-other-tool.pdf',
    fmOpenRead or fmShareDenyWrite);
  try
    Dest := TFileStream.Create('repaired.pdf', fmCreate);
    try
      // Solo ediciones de igual longitud; los archivos sin un conflicto reparable,
      // y los archivos con cross-reference-stream u object-stream, se copian tal cual
      RepairSubsetToUnicodeCMaps(Source, Dest);
    finally
      Dest.Free;
    end;
  finally
    Source.Free;
  end;
end.
La rutina reconstruye una tabla de referencias cruzadas clásica, así que los documentos que usan cross-reference streams, referencias híbridas u object streams pasan byte a byte. Los guardados incrementales (saIncremental) se saltan la reparación a propósito, porque una revisión incremental debe seguir siendo append-only. Para el texto que el componente escribe por sí mismo, ninguno de los dos casos importa: sus fuentes indexadas por code point nunca producen un conflicto que la reparación pueda encontrar
Dónde aplica el camino indexado por code point
El camino indexado por code point cubre toda fuente que exponga una subtabla cmap Unicode, y la carga indexada por glifo de PDFium maneja el resto. Detalles que vale conocer antes de confiar en esto:
- Las fuentes Symbol que solo traen un cmap (3,0), y cualquier fuente que el camino CID no pueda cargar, pasan por
FPDFText_LoadFont, donde un glifo compartido por dos code points queda sujeto a la regla de precedencia del lector - Con solo una subtabla formato 4 el mapa cubre el Basic Multilingual Plane; una subtabla formato 12 en la plataforma (3,10) o la plataforma Unicode agrega los code points de planos suplementarios
- El glifo 0 y los code points surrogate se quedan fuera, y el conteo de entradas se tapa en 65535 para que cada CID quepa en dos bytes por encima de cero
- Las TrueType Collections requieren cuidado extra: el
GetFontDatade GDI devuelve el .ttc entero, yFPDFText_LoadCidType2Fontno tiene parámetro de índice de face, así que pasar la colección tal cual incrustaría la face 0, SimSun, cuando usted pidió NSimSun desde simsun.ttc. El componente empareja el nombre de familia contra la tabla name de la fuente (nameID 1 y 16) y entrega la face pedida como un sfnt independiente; una colección que no pueda parsear pasa entera y usa la face 0 - Si ninguna fuente del sistema con el nombre pedido se puede leer,
AddTextle pasa el nombre de la fuente aFPDFPageObj_NewTextObj, que la busca entre las fuentes estándar de PDFium
Pliegue los caracteres invisibles en el índice, consérvelos en el texto
Cuando la extracción devuelve los code points reales, surge otra pregunta: ¿qué debe hacer un índice de búsqueda con un NBSP o un soft hyphen genuino que el autor escribió a propósito? Plieguelos en la capa de indexación y deje TPdf.Text tranquilo. El string extraído es el registro de lo que dice el documento; un índice es una vista con pérdida construida para matchear, y las reglas de plegado le pertenecen a él
El helper de abajo es una función que usted agrega a su propio código. Mapea el NBSP a un espacio y descarta el soft hyphen, que según el Unicode Standard solo marca un lugar donde la línea puede romperse. Deja U+2126 intacto a propósito. La normalización NFC convertiría el signo Ohm en Omega, porque U+2126 tiene una descomposición singleton canónica a U+03A9, y si una búsqueda de datasheets debería matchear esos dos es una decisión de producto, no de extracción:
uses
  SysUtils, Classes, PDFium;

// Su propio helper para un índice de búsqueda; no forma parte de PDFium Component
function FoldForIndex(const S: string): string;
begin
  Result := StringReplace(S, #$00A0, ' ', [rfReplaceAll]);
  Result := StringReplace(Result, #$00AD, '', [rfReplaceAll]);
end;

procedure IndexDocument(const FileName: string; Lines: TStrings);
var
  Pdf: TPdf;
  P: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    for P := 1 to Pdf.PageCount do
    begin
      Pdf.PageNumber := P;
      Lines.Add(FoldForIndex(Pdf.Text));   // el texto exacto se queda en Pdf.Text
    end;
  finally
    Pdf.Free;
  end;
end;
Corra IndexDocument sobre el archivo codepoints.pdf del primer ejemplo y la línea indexada debe leerse "two-x yz ΩΩ", once caracteres con un signo Ohm como el último, mientras Pdf.Text sigue devolviendo los doce caracteres originales, NBSP y soft hyphen incluidos
Las fuentes indexadas por code point, la reparación del CMap y la extracción de texto comparten el mismo modelo de página en Delphi, C++Builder y Lazarus; la API de fuentes y texto está cubierta por completo en la página de producto de PDFium Component para Delphi